Chặn GPTBot, ClaudeBot hay Google-Extended thì website mất gì?
Mỗi hãng AI có nhiều bot làm việc khác nhau, nên chặn bot huấn luyện thường không chặn khỏi tìm kiếm AI, trừ Google-Extended với Gemini Apps. Bài so sánh bot của OpenAI, Anthropic, Google, Perplexity, Apple và đưa 3 mẫu robots.txt đã kiểm bằng 2 bộ phân tích.
Một công ty nội thất thấy nhật ký máy chủ có các dòng lạ như GPTBot và ClaudeBot. Chủ muốn chặn hết, còn bộ phận marketing muốn khách hỏi ChatGPT vẫn thấy tên công ty. Đây là tình huống minh họa.
Bài dựa trên tài liệu của OpenAI, Anthropic, Google, Perplexity, Apple, Microsoft, RFC 9309 và bản nháp IETF, đối chiếu đến ngày 04/11/2026.
Kết luận ngắn: mỗi hãng có nhiều bot làm việc khác nhau, nên chặn bot huấn luyện thường không chặn khỏi tìm kiếm AI của hãng đó. Riêng Google-Extended, chặn nó còn làm trang mất chỗ hiện trong Gemini Apps. Bài có 3 mẫu robots.txt đã kiểm và khung 5 bước chọn phương án.
Điểm chính
- OpenAI và Anthropic đều có bot huấn luyện, bot tìm kiếm và bot chạy khi người dùng nhờ AI đọc 1 trang, mỗi bot có tên riêng trong
robots.txt; Perplexity có 2 loại, Google thêm token Google-Extended. - Theo OpenAI, GPTBot và OAI-SearchBot được thiết lập độc lập. Chặn OAI-SearchBot thì trang không hiện trong câu trả lời tìm kiếm của ChatGPT.
- Google-Extended chỉ là token điều khiển, không phải bot, và không ảnh hưởng Google Search. Google nói trang cho phép rõ ràng nó đủ điều kiện hiện trong Gemini Apps; chặn nó thì nội dung không được dùng làm căn cứ trả lời ở đó.
robots.txtlà lời đề nghị, không phải khóa. OpenAI, Perplexity và Google nói bot do người dùng kích hoạt có thể bỏ qua nó; Anthropic nói bot của họ tôn trọng.- Ngày 30/10/2026 Google và Microsoft công bố sẽ hỗ trợ token chung
__usage_ai-training, hiện là bản nháp IETF.
Một hãng AI có mấy loại bot
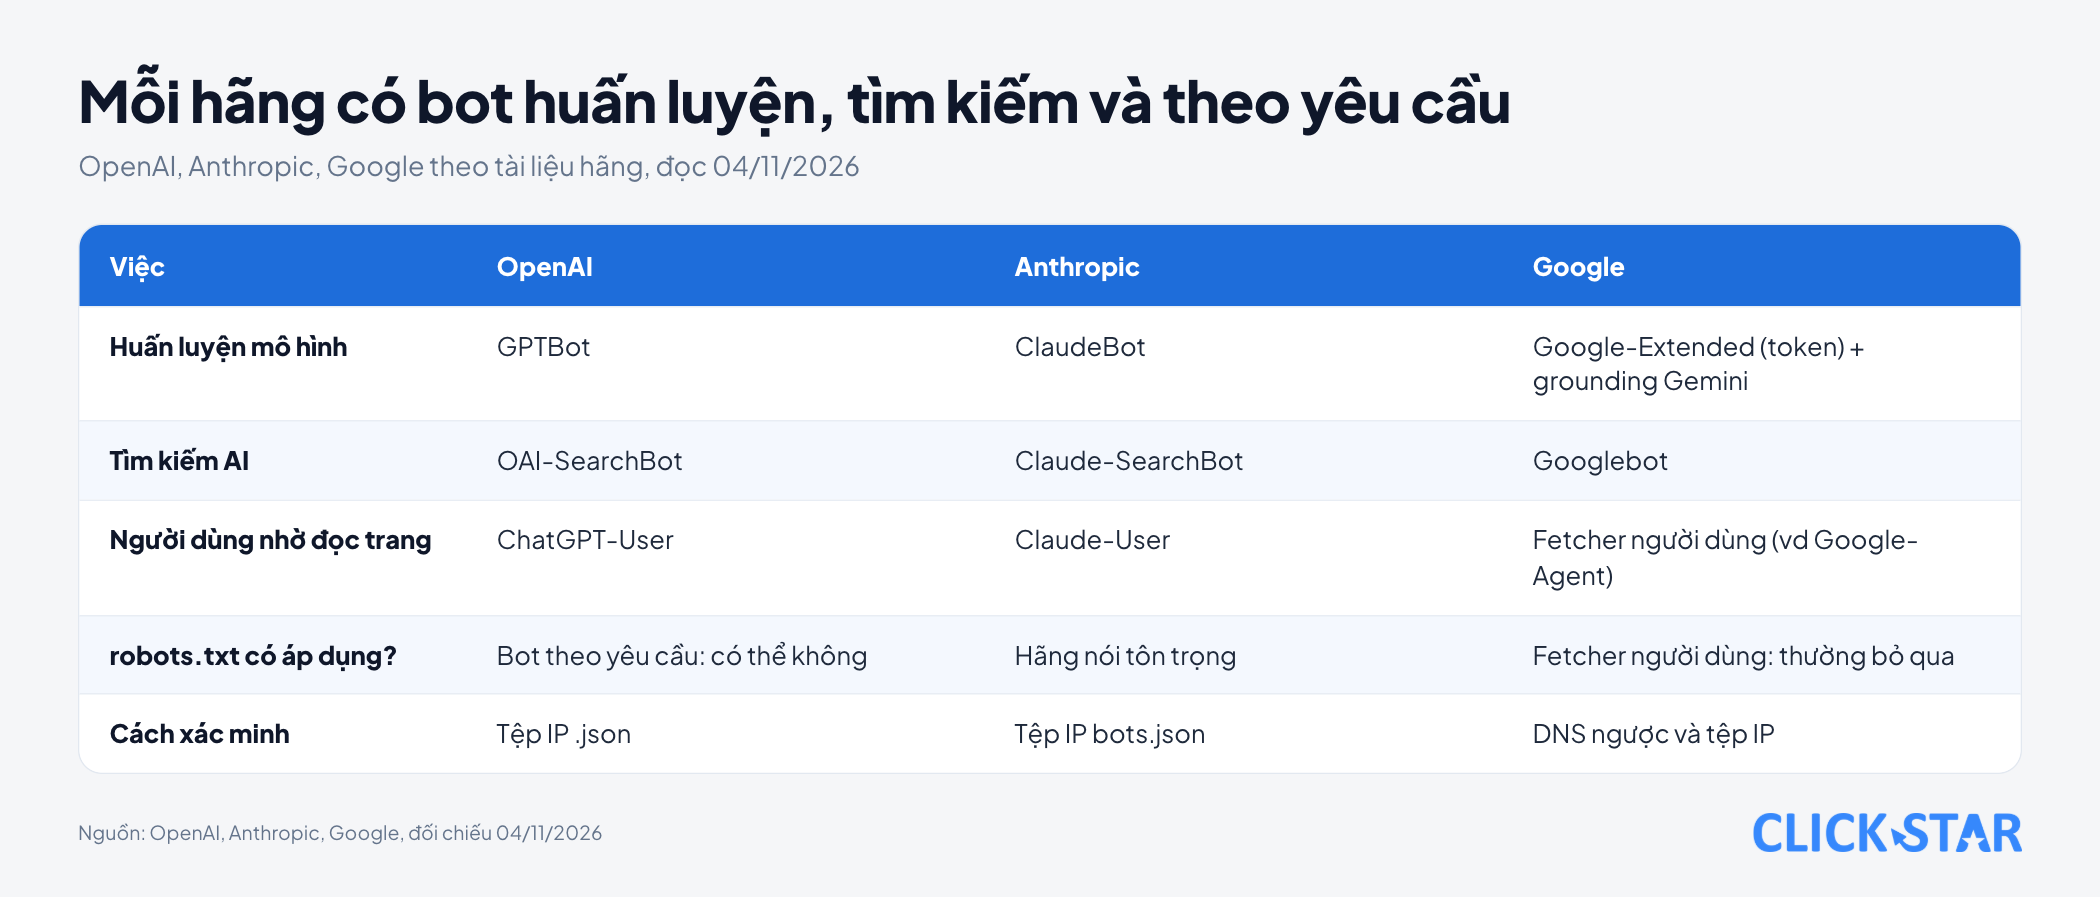
OpenAI và Anthropic chia việc cho 3 loại bot (cách Click Star tóm tắt từ tài liệu của 2 hãng).
Bot huấn luyện thu nội dung có thể dùng để huấn luyện mô hình AI. Bot tìm kiếm lập chỉ mục để hiện trang trong câu trả lời. Bot theo yêu cầu chạy khi có người hỏi AI và AI mở đúng trang đó.
Bot của từng hãng làm gì và có theo robots.txt không
OpenAI
Theo trang "Overview of OpenAI Crawlers" (không ghi ngày), GPTBot thu nội dung có thể dùng huấn luyện; chặn nó là tín hiệu rằng nội dung không nên dùng cho việc đó. OAI-SearchBot đưa trang vào tìm kiếm của ChatGPT.
Trang chặn OAI-SearchBot không hiện trong câu trả lời tìm kiếm của ChatGPT, dù vẫn có thể hiện dạng liên kết điều hướng.
ChatGPT-User chạy khi người dùng nhờ ChatGPT mở trang. OpenAI viết rằng vì người dùng khởi tạo hành động, robots.txt có thể không áp dụng.
Anthropic
Bài "Does Anthropic crawl data from the web, and how can site owners block the crawler?" (cập nhật 07/04/2026) nêu 3 bot. ClaudeBot thu nội dung có thể dùng huấn luyện, Claude-User truy cập khi người dùng hỏi Claude, Claude-SearchBot cải thiện kết quả tìm kiếm.
Anthropic nói các bot tôn trọng tín hiệu "không thu thập" trong robots.txt. Chặn Claude-User hoặc Claude-SearchBot có thể giảm mức hiện diện trong tìm kiếm của Claude.
Theo trang "List of Google's common crawlers" (cập nhật 30/10/2026), Google-Extended không có chuỗi user agent riêng, chỉ là token điều khiển.
Token này quản lý việc nội dung có được dùng huấn luyện Gemini và làm căn cứ trả lời (grounding, tức đưa nội dung từ chỉ mục Search cho mô hình lúc trả lời) trong Gemini Apps hay không.
Google viết nó không ảnh hưởng việc có mặt trong Search. Bài của Google ngày 30/10/2026 nói trang cho phép rõ ràng Google-Extended đủ điều kiện hiện trong câu trả lời và nhận lượt nhấp qua grounding trong Gemini Apps.
Với AI Overviews và AI Mode, trang "AI features and your website" (cập nhật 10/12/2025) nói trang chỉ cần được lập chỉ mục và đủ điều kiện hiện đoạn trích. Điều khiển là robots.txt cho Googlebot, cùng giới hạn đoạn trích và noindex.
Theo "List of Google user-triggered fetchers" (cập nhật 19/08/2026), fetcher do người dùng kích hoạt như Google-Agent nhìn chung bỏ qua robots.txt.
Perplexity và Apple
Trang "Perplexity Crawlers" (không ghi ngày) nói PerplexityBot phục vụ tìm kiếm, không dùng thu nội dung huấn luyện mô hình nền tảng. Perplexity-User nhìn chung bỏ qua robots.txt.
Trang "About Applebot" (đăng 04/09/2026) nói dữ liệu Applebot phục vụ tìm kiếm của Apple và có thể dùng huấn luyện mô hình của Apple. Muốn từ chối huấn luyện, chặn Applebot-Extended (token không thu thập trang).
Cách xác minh bot thật và đếm trong nhật ký
Chuỗi user agent trong nhật ký có thể bị giả, nên hãy đối chiếu IP với dải hãng công bố và tải lại tệp định kỳ.
- OpenAI và Perplexity: tệp dải IP riêng cho từng bot, như
gptbot.json,perplexitybot.json. Anthropic: 1 tệp chung cho mọi bot của hãng,claude.com/crawling/bots.json. - Google: reverse DNS (tên máy tra ngược từ IP)
crawl-***.googlebot.comhoặc tệpcommon-crawlers.json, theo trang "Verify requests from Google crawlers and fetchers" (cập nhật 20/03/2026). - Apple: reverse DNS
*.applebot.apple.com. Bing: tệpbingbot.json(sửa lần cuối 01/11/2026; chưa đối chiếu được với trang hướng dẫn của Bing).
Đoạn Python kiểm 1 IPv4 có thuộc tệp dải IP không:
import ipaddress, json
ds = json.load(open("gptbot.json"))["prefixes"]
ip = ipaddress.ip_address("20.171.206.77")
print(any(ip in ipaddress.ip_network(p["ipv4Prefix"]) for p in ds if "ipv4Prefix" in p))
Đếm lượt từng bot bằng grep -c "GPTBot" access.log. Click Star chạy thử với tệp IP tải ngày 04/11/2026 và nhật ký giả 5 dòng: lệnh đếm cho GPTBot 2 dòng. IP 20.171.206.77 với gptbot.json trả True, 8.8.8.8 trả False.
3 mẫu robots.txt cho 3 mục tiêu
Mẫu A mở hết: không thêm nhóm riêng nào, chỉ giữ User-agent: * với Disallow: /admin/. Mẫu B chặn 4 token huấn luyện, giữ bot tìm kiếm. Các dòng User-agent liên tiếp dùng chung 1 nhóm luật:
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
Disallow: /

User-agent: *
Disallow: /admin/
Mẫu B giữ bot tìm kiếm của OpenAI, Anthropic, Perplexity và Google Search. Nhưng Google-Extended còn điều khiển grounding trong Gemini Apps, nên mẫu B làm trang mất chỗ hiện và lượt nhấp từ grounding ở đó (suy luận của Click Star từ 2 trang Google).
Mẫu C là mẫu B, thêm 6 dòng User-agent vào nhóm đầu (OAI-SearchBot, ChatGPT-User, Claude-SearchBot, Claude-User, PerplexityBot, Perplexity-User) để chặn đủ 10 token AI, vẫn để Googlebot, Bingbot và Applebot.
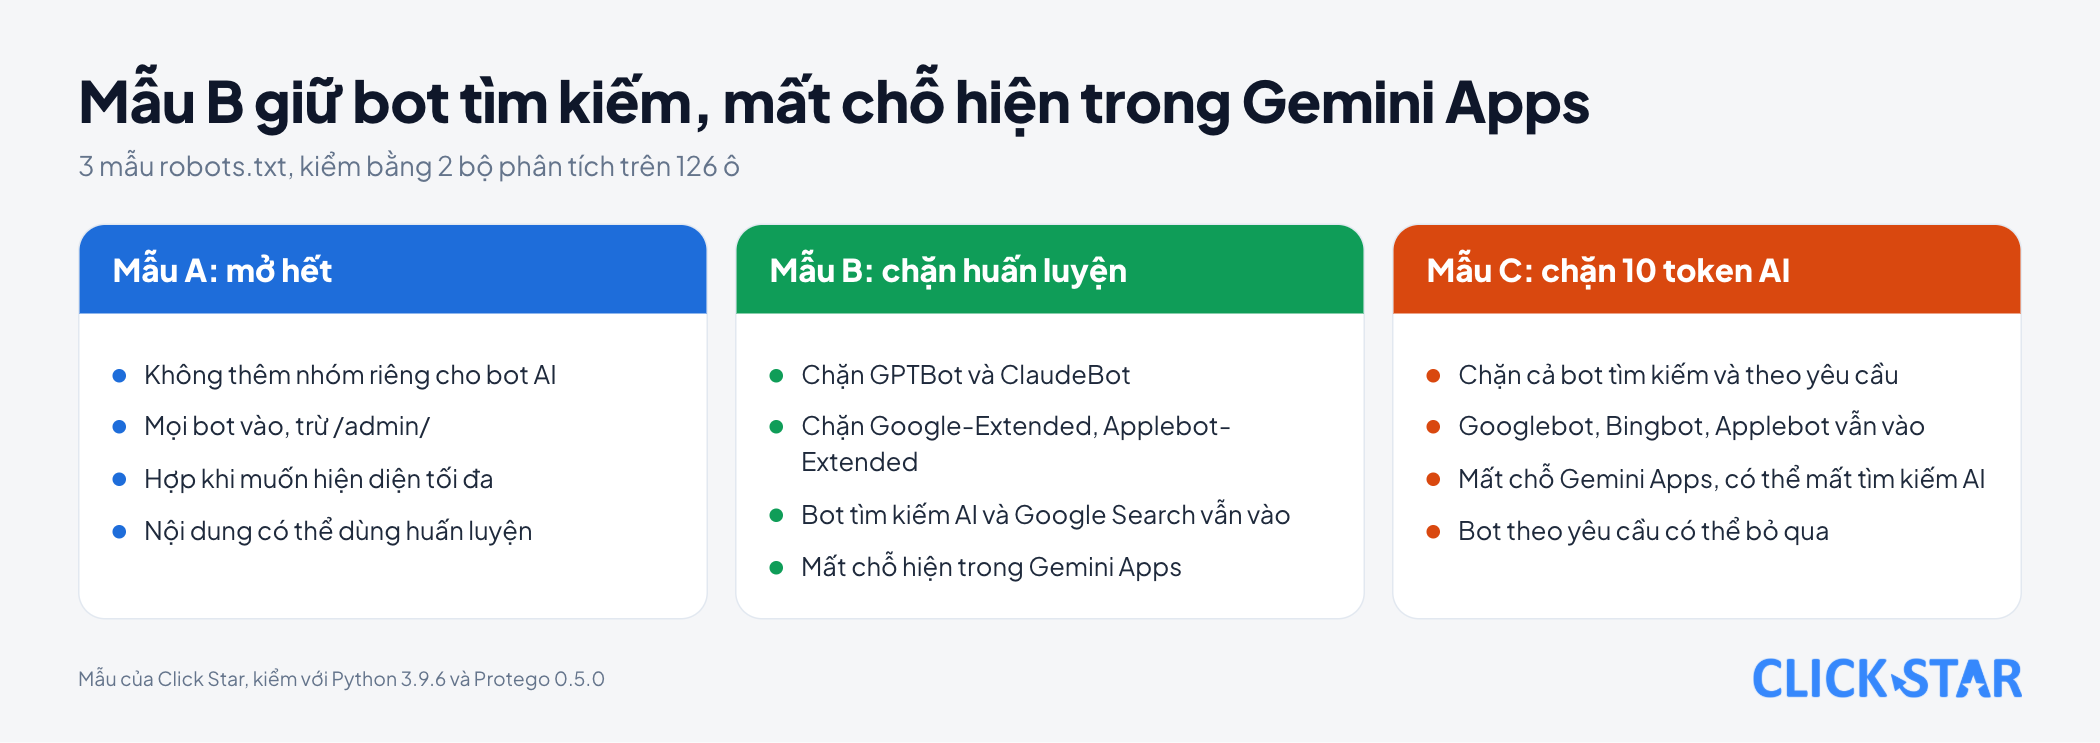
Click Star kiểm 3 mẫu trên 14 user agent và 3 đường dẫn (/, /blog/bai-1, /admin/x) bằng urllib.robotparser của Python 3.9.6 và Protego 0.5.0. 2 bộ cho kết quả giống nhau ở cả 126 ô: mẫu B chặn 4 token ở mọi đường dẫn, mẫu C chặn 10 token.
Click Star thử thêm 2 trường hợp lệch. Thứ nhất, nhóm riêng không gộp với nhóm *: tệp có User-agent: * chặn /admin/ và nhóm OAI-SearchBot chỉ có Allow: / thì OAI-SearchBot đọc được /admin/x ở cả 2 bộ.
Thứ hai, thứ tự dòng. Nhóm GPTBot gồm Disallow: / rồi Allow: /blog/ thì Protego cho đọc /blog/bai-1, còn urllib.robotparser chặn. Đặt Allow lên trước thì cả 2 cùng cho đọc. RFC 9309 và Google dùng luật cụ thể nhất (đường dẫn dài nhất), nên đừng chỉ tin 1 bộ phân tích.
Giới hạn của robots.txt
RFC 9309 (Robots Exclusion Protocol, IETF, tháng 9/2022) viết các luật này không phải cơ chế cấp quyền truy cập.
Muốn giữ riêng tư, cần đăng nhập, phân quyền hoặc không đưa nội dung lên web.
Tín hiệu chung mới công bố ngày 30/10/2026
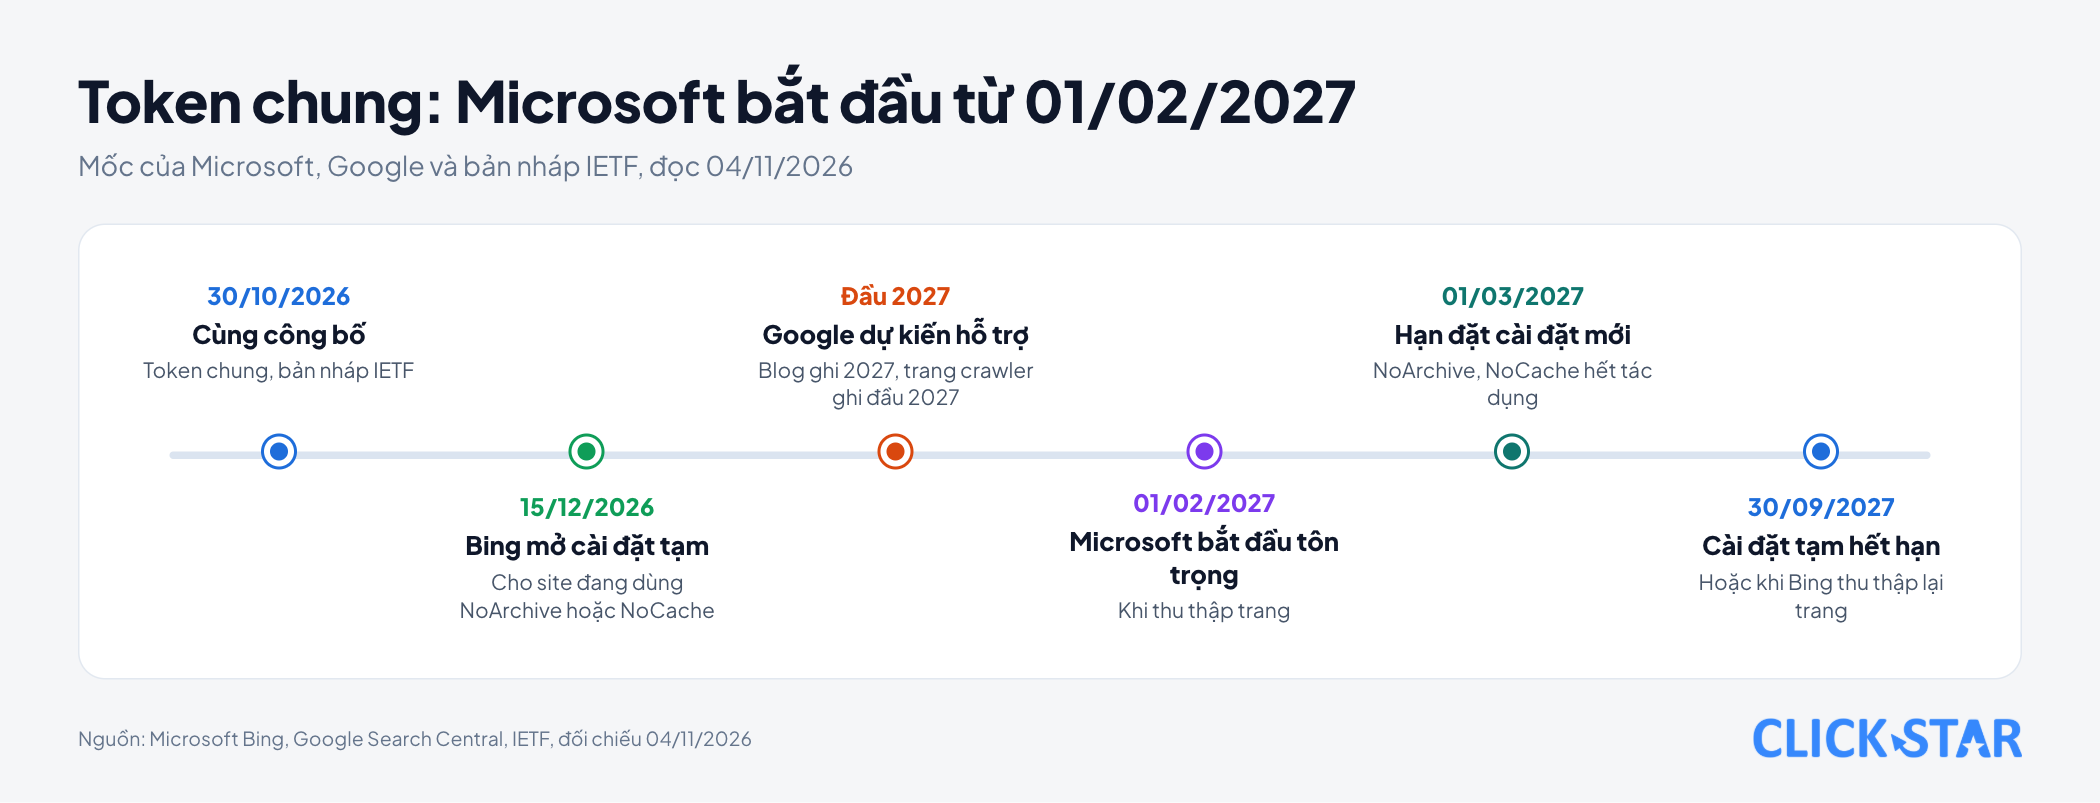
Ngày 30/10/2026, Google và Microsoft công bố kế hoạch dùng 1 token chung thay cho việc liệt kê từng bot.
Bản nháp IETF "Machine-Readable Training Preference Signal" (30/10/2026, hết hạn 03/05/2027, tác giả ghi Anthropic) định nghĩa token __usage_ai-training, viết như 1 User-agent: User-agent: __usage_ai-training rồi Disallow: /. IETF chưa thông qua bản nháp này.
Theo bản nháp, nhóm User-agent: * không được coi là khớp token này. Nhưng với tệp chỉ có User-agent: * chặn /, cả urllib.robotparser và Protego vẫn chặn token trong thử nghiệm của Click Star, nên đừng kiểm token chung bằng bộ phân tích hiện có.
Bài "Supporting a shared AI training control for websites" của Google (30/10/2026) nói nếu trang từ chối huấn luyện bằng token chung mà không nêu Google-Extended, Google dự định coi như đã chặn Google-Extended, và nhắm hỗ trợ trong năm 2027 cùng các nhà cung cấp AI khác (trang crawler của Google ghi đầu 2027).
Bài của Microsoft Bing cùng ngày tách 2 lựa chọn. "AI Training" đặt trong robots.txt hoặc từng trang. "AI Grounding" chỉ đặt từng trang, ví dụ <meta name="Bingbot" content="ai-grounding:disallow">. Mặc định cả hai là cho phép.
Microsoft nói chặn grounding sẽ giảm mức hiện diện thương hiệu trong trải nghiệm AI, không ảnh hưởng kết quả Bing.
Điều này có nghĩa gì với doanh nghiệp Việt Nam
Click Star chưa thấy số đo công khai về lượng bot AI đến website Việt Nam, nên hãy đếm nhật ký của chính bạn.
Đánh giá của Click Star. Với doanh nghiệp muốn khách tìm thấy mình, mẫu B thường hợp lý: từ chối huấn luyện, giữ tìm kiếm của OpenAI, Anthropic, Perplexity và Google Search, nhưng mất chỗ hiện trong Gemini Apps vì dòng Google-Extended. Đây là nhận định của Click Star, vì các hãng chưa công bố số đo tác động lên lượt trích dẫn.
Google-Extended gộp huấn luyện và grounding, nên chặn nó là mất chỗ hiện trong Gemini Apps. Muốn giữ chỗ đó, bỏ dòng Google-Extended khỏi mẫu B, tức chấp nhận huấn luyện Gemini. Mẫu C chỉ nên chọn khi nội dung là tài sản bán trực tiếp.
Click Star có dịch vụ thiết kế website chuẩn SEO tải nhanh và tích hợp AI, nên có lợi ích liên quan đến chủ đề này.
Việc nên làm: khung 5 bước chọn phương án
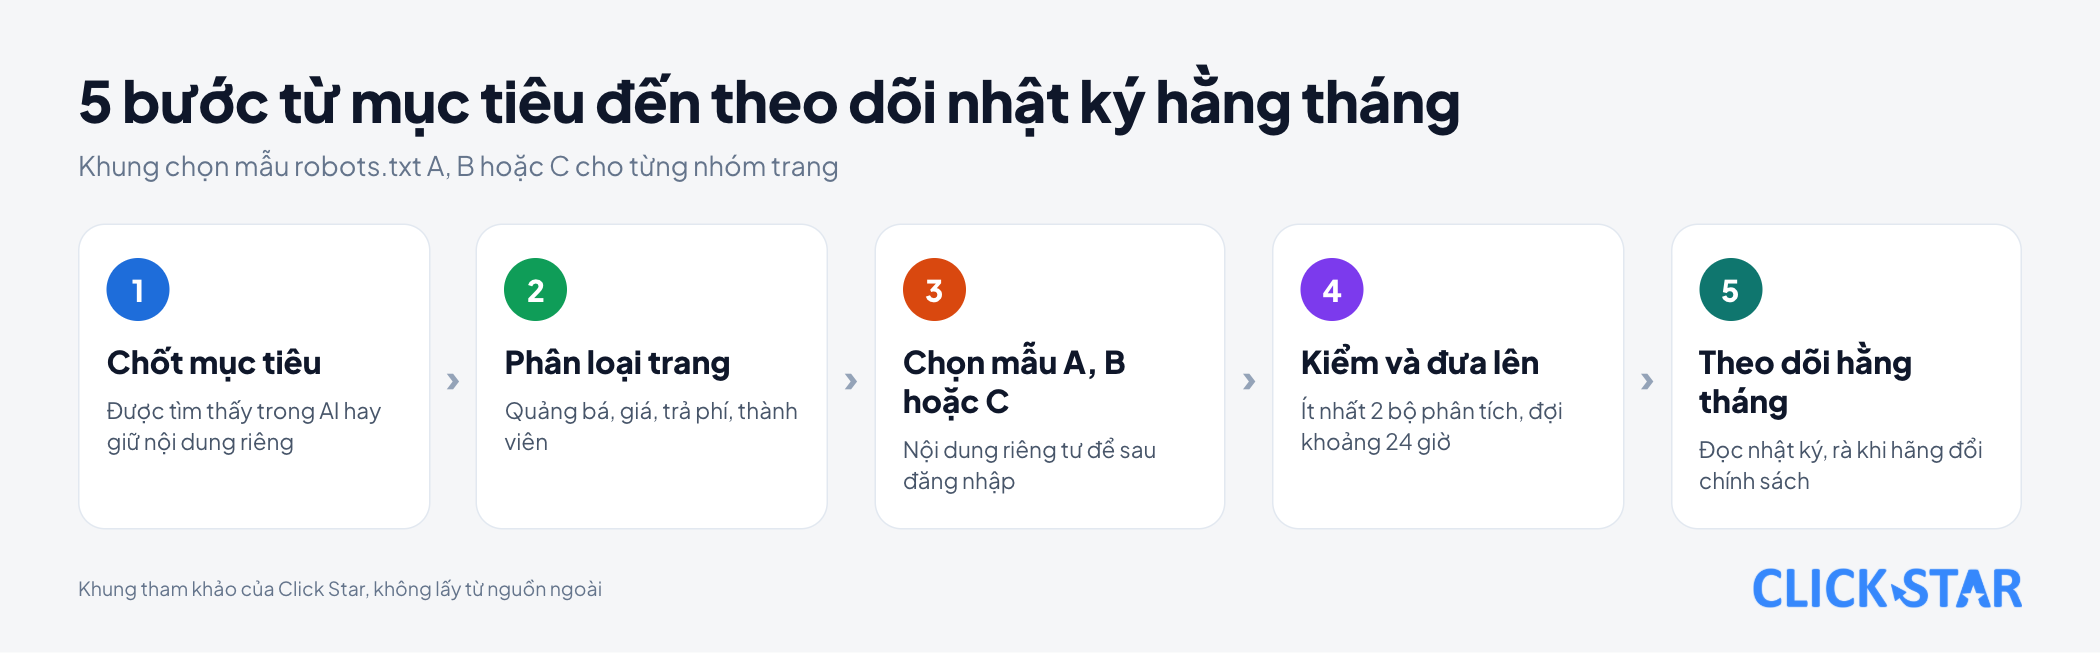
Khung tham khảo của Click Star, không lấy từ nguồn ngoài.
Bước 1. Chốt mục tiêu: cần khách tìm thấy trong AI hay cần giữ nội dung riêng. Bước 2. Phân loại trang: trang quảng bá, trang giá, tài liệu trả phí, khu thành viên.
Bước 3. Chọn mẫu A, B hoặc C cho từng nhóm, nội dung riêng tư để sau đăng nhập.
Bước 4. Viết, kiểm bằng ít nhất 2 bộ phân tích trên 3 đường dẫn trở lên, đưa lên và đợi (OpenAI và Perplexity nêu khoảng 24 giờ). Bước 5. Theo dõi nhật ký mỗi tháng và rà lại khi hãng đổi, nhất là mốc 01/02/2027 của Microsoft.
Những sai lầm thường gặp
- Chặn GPTBot rồi tin rằng ChatGPT sẽ không nhắc website, dù tìm kiếm của ChatGPT dùng OAI-SearchBot.
- Chặn bot tìm kiếm mà không biết sẽ giảm khả năng hiện trong tìm kiếm của hãng đó.
- Thêm nhóm riêng cho 1 bot và quên nhóm đó không gộp với nhóm
*. - Đặt
DisallowtrướcAllowrồi tin mọi bộ phân tích đọc giống nhau. - Tin user agent trong nhật ký mà không đối chiếu IP.
- Dùng
robots.txtthay cho đăng nhập, hoặc chặn IP của bot khiến bot không đọc đượcrobots.txt.
Điều chưa biết
Chưa có số đo công khai cho Việt Nam về lượng bot AI hay tỷ lệ doanh nghiệp chặn. Chưa hãng nào công bố số đo việc chặn từng bot làm đổi lượt trích dẫn bao nhiêu, chỉ nói trang bị chặn mất hoặc có thể mất hiện diện.
Bài chỉ nêu tuyên bố tuân thủ robots.txt của chính hãng, chưa đo thực tế. Bài của OpenAI về tín hiệu chung bị chặn công cụ nên chưa xác nhận lập trường của OpenAI.
Chưa rõ khi nào OpenAI và Anthropic đọc token chung: Google nhắm 2027 cùng các nhà cung cấp AI khác nhưng không nêu tên, Microsoft từ 01/02/2027. Google cũng không nói trang chưa có quy tắc nào về Google-Extended được coi ra sao ở Gemini Apps.
Các mẫu chưa thử với bot thật. Click Star chưa đọc luật Việt Nam về dùng nội dung web cho AI, nên bài không tư vấn pháp lý.
Bài liên quan



Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.