A/B test cho landing page và email: thiết kế thử nghiệm, cỡ mẫu và những lỗi làm kết quả sai
Cách thiết kế A/B test đáng tin cho landing page và email: giả thuyết, cỡ mẫu tính bằng Python, thời gian chạy và lỗi xem kết quả sớm. Dựa trên Optimizely, GrowthBook, Evan Miller và Mailchimp.
Nhiều doanh nghiệp chạy A/B test cho landing page hoặc email theo cách quen thuộc: đổi tiêu đề, chờ vài ngày rồi chọn bản đang dẫn đầu. Cách này dễ cho kết luận sai vì cỡ mẫu nhỏ, xem kết quả quá sớm, đo quá nhiều chỉ số hoặc chia khách không đều mà không ai kiểm tra.
Bài dựa trên tài liệu của Optimizely, VWO, Statsig, GrowthBook, Mailchimp và Apple, bài của Evan Miller và nghiên cứu của Kohavi và Vermeer, đối chiếu đến ngày 22/10/2026. Phép tính do Click Star tự chạy bằng Python; dữ liệu là minh họa, không phải kết quả của khách hàng nào.
Điểm chính
- Phép tính của Click Star với nền 3%, mức tăng tương đối nhỏ nhất 20%, tin cậy 95%, power 80%: 13.914 người mỗi nhánh. Cần 28 ngày nếu mỗi ngày có 1.000 người mới vào thử nghiệm, 140 ngày nếu chỉ có 200.
- Dừng ngay khi thấy "có ý nghĩa" làm dương tính giả tăng mạnh: 26,1% trong ví dụ của Evan Miller, khoảng 22% trong mô phỏng của Click Star (xem mỗi ngày), thay vì 5%.
- Kiểm tra tỷ lệ chia khách (SRM) trước khi đọc kết quả; GrowthBook nói kết quả kèm cảnh báo SRM không đáng tin.
- Website ít khách có thể thử thay đổi lớn, đo trước sau kèm nhận xét hạn chế hoặc phỏng vấn người dùng. Với email, chọn tỷ lệ nhấp thay vì tỷ lệ mở.
A/B test là gì và khi nào nên làm
A/B test là thử nghiệm đối chứng có ngẫu nhiên: khách được chia ngẫu nhiên thành các nhóm, mỗi nhóm thấy 1 phiên bản, rồi so cùng 1 chỉ số. Theo nhóm Kohavi (bài KDD 2014, đọc ngày 22/10/2026), 1 người nhận cùng 1 trải nghiệm qua nhiều lần truy cập.
Ngẫu nhiên hóa là cơ chế tạo giá trị: 2 nhóm cùng chịu mùa vụ, quảng cáo và biến động theo tuần, nên chênh lệch còn lại gắn với thay đổi đang thử.
Giả thuyết, chỉ số chính và chỉ số bảo vệ
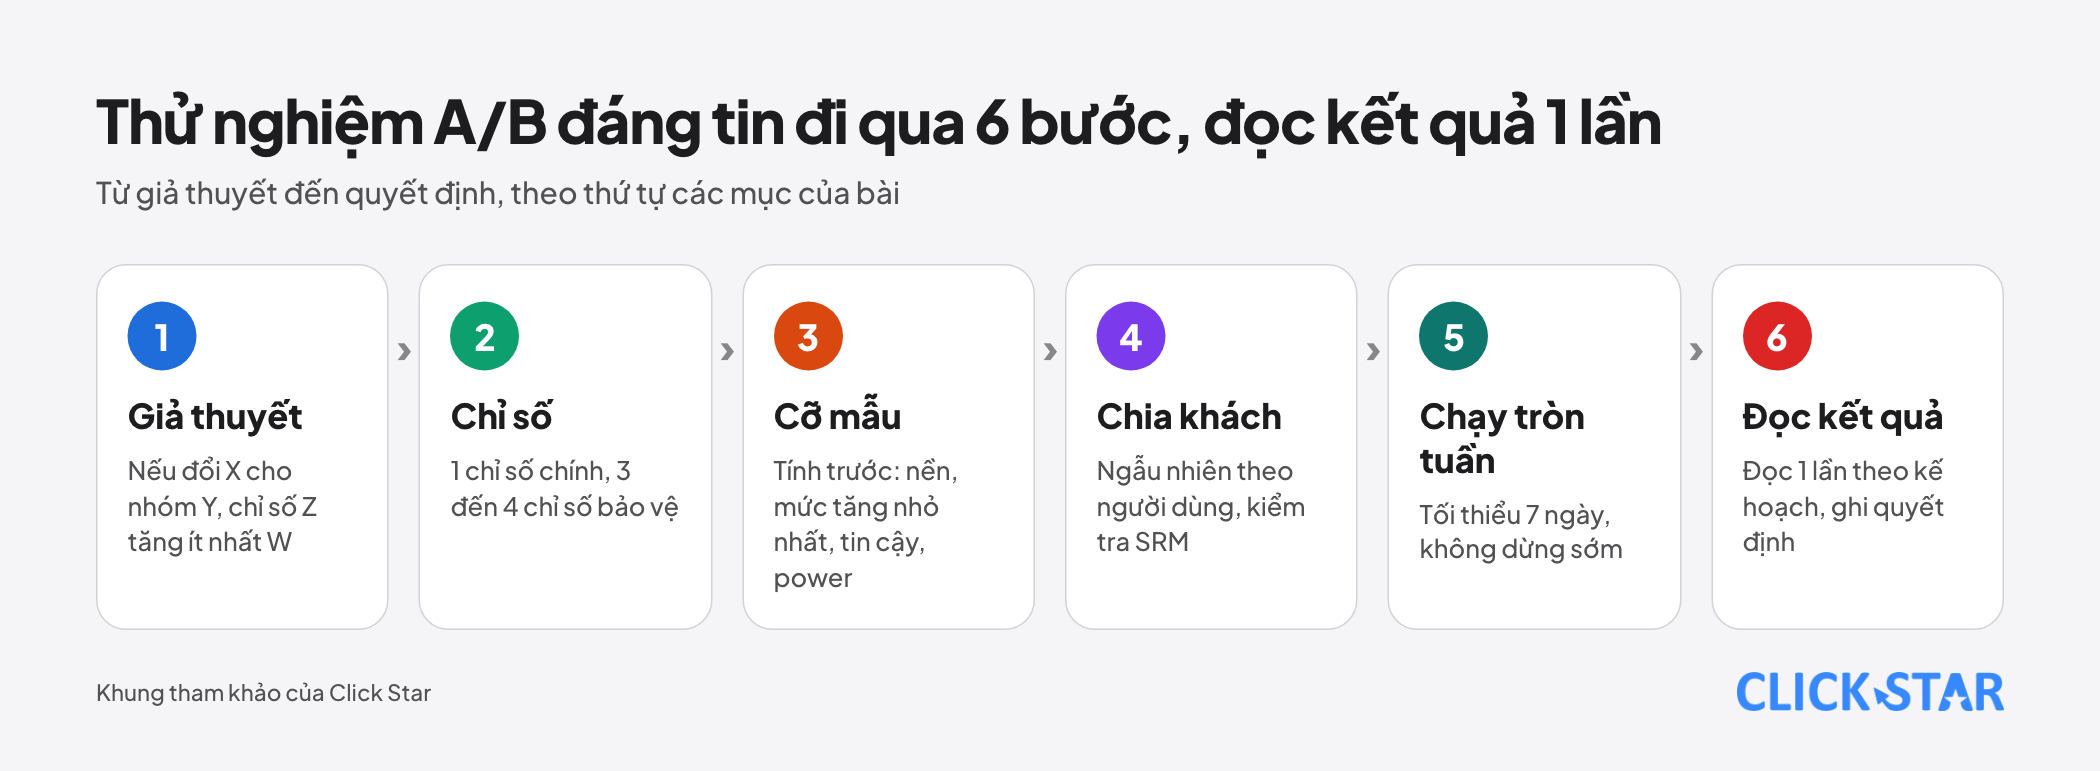
Thử nghiệm bắt đầu từ 1 giả thuyết viết trên 1 dòng. Mẫu của Click Star (khung tham khảo, không lấy từ nguồn ngoài): "Nếu đổi X cho nhóm khách Y, chỉ số Z tăng ít nhất W vì lý do R." W là mức tăng nhỏ nhất đáng phát hiện và quyết định cỡ mẫu.
Chỉ số chính chỉ nên có 1, tính theo người dùng chứ không theo lượt xem, ví dụ số người gửi biểu mẫu chia cho số người truy cập duy nhất.
Chỉ số bảo vệ là chỉ số không được xấu đi khi chỉ số chính tốt lên. Khung tham khảo của Click Star gợi ý 3 đến 4 chỉ số: tốc độ tải trang, chất lượng khách tiềm năng (tỷ lệ được CRM xác nhận), và với email là tỷ lệ hủy đăng ký cùng khiếu nại thư rác.
Cỡ mẫu: công thức và phép tính thật
Theo Optimizely (chế độ cỡ mẫu cố định, không ghi ngày), cỡ mẫu phụ thuộc giá trị nền, mức thay đổi tương đối nhỏ nhất cần phát hiện (MDE), mức ý nghĩa và độ biến thiên; công thức của họ còn có power, tức xác suất phát hiện hiệu ứng khi nó có thật.
Với tỷ lệ chuyển đổi, Click Star dùng công thức kiểm định 2 tỷ lệ: n mỗi nhánh = (z1 × √(2 × p̄ × (1 - p̄)) + z2 × √(p1 × (1 - p1) + p2 × (1 - p2)))² / (p2 - p1)². Trong đó p1 là tỷ lệ nền, p2 là tỷ lệ mong đợi, p̄ là trung bình của p1 và p2.
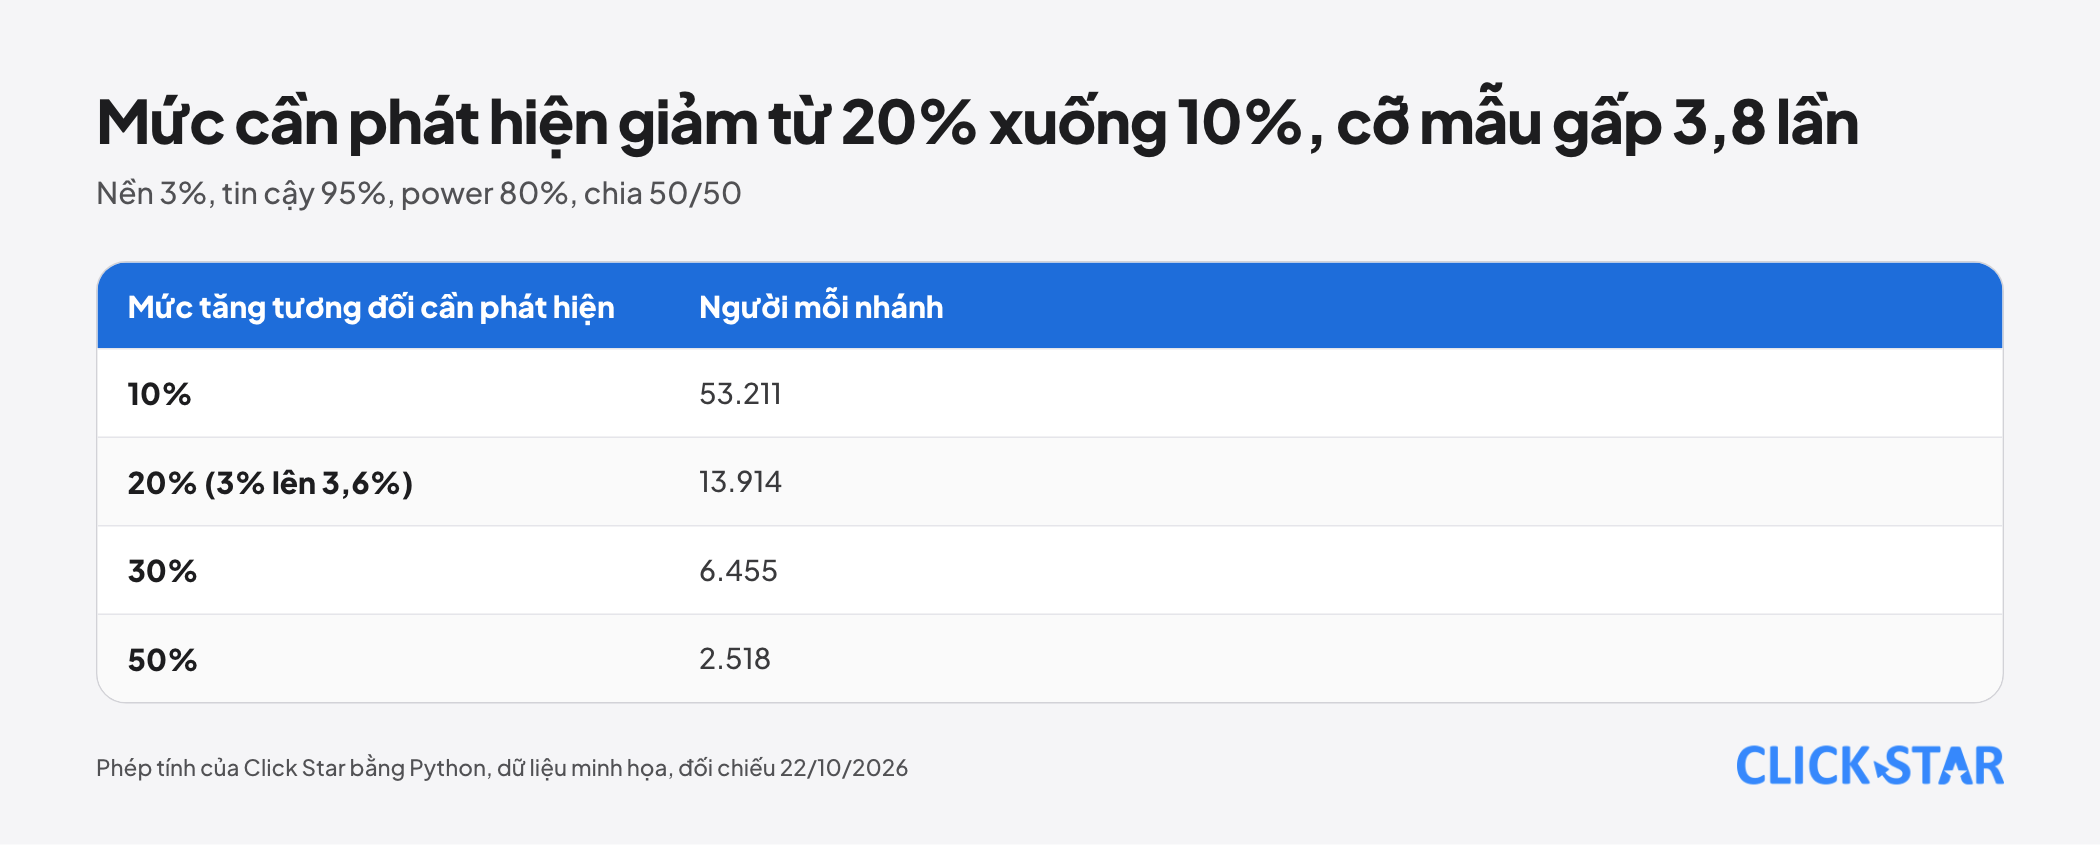
Giả định (dữ liệu minh họa): nền 3%; mức tăng tương đối nhỏ nhất 20% (3% lên 3,6%); 2 phía, tin cậy 95% (z1 = 1,95996); power 80% (z2 = 0,84162); chia 50/50. Python cho 13.914 người mỗi nhánh, tổng 27.828 (làm tròn z thành 1,96 và 0,84 thì ra 13.898).
Cùng nền 3%: mức tăng 10% cần 53.211 mỗi nhánh, 30% cần 6.455 và 50% cần 2.518. Power 90% cần 18.626; tin cậy 90% cần 10.960. Mức cần phát hiện giảm từ 20% xuống 10% thì cỡ mẫu gấp 3,8 lần.
Thời gian chạy bằng tổng cỡ mẫu chia cho số người mới vào thử nghiệm mỗi ngày (người truy cập duy nhất, không phải lượt): 27.828 người cần 28 ngày ở 1.000 người mỗi ngày, 56 ngày ở 500 và 140 ngày ở 200. Khách quay lại chỉ tính 1 lần nên số người mới thường thấp hơn số lượt, thời gian chạy dài hơn.
Loại chỉ số cũng đổi cỡ mẫu tối thiểu. Nhóm Kohavi (2014) nêu quy tắc 355 × độ lệch² để trung bình xấp xỉ phân phối chuẩn; với dữ liệu Bing, doanh thu mỗi người dùng (độ lệch 17,9) cần khoảng 114.000 người mỗi biến thể, bản giới hạn trần (độ lệch 5,2) khoảng 9.700.
Đó không phải cỡ mẫu để phát hiện mức tăng doanh thu: khi chia đều 50/50, chính bài nói quy tắc không cho cận dưới hữu ích, hãy dùng phép tính power. Website nhỏ nên ưu tiên tỷ lệ chuyển đổi (nhận định của Click Star).
Chia khách ngẫu nhiên và kiểm tra tỷ lệ chia (SRM)
Hãy chia theo người dùng, không theo lượt xem trang. Theo GrowthBook (tài liệu sticky bucketing), chỉ dùng cookie thì cùng 1 người có thể thấy 2 phiên bản trên 2 thiết bị.
SRM là khi tỷ lệ chia khách thực tế lệch so với dự kiến. Theo GrowthBook (đọc ngày 22/10/2026), nếu kỳ vọng 50/50 mà thấy kiểu 46/54, công cụ kiểm tra bằng phép thử chi bình phương và chỉ cảnh báo khi p nhỏ hơn 0,001, nên còn tùy cỡ mẫu. Kết quả kèm cảnh báo không nên tin; cần tìm lỗi rồi chạy lại.
Ví dụ Click Star tính (minh họa): chia 50/50, 10.000 người. Thấy 5.000 và 5.200 thì p = 0,048, chưa vượt ngưỡng; thấy 4.800 và 5.200 thì p khoảng 0,00006, đủ để coi là có vấn đề.
Nguyên nhân phổ biến và nghiêm trọng nhất theo GrowthBook là ghi nhận lượt phơi bày tách khỏi lúc chia khách. Hãy chạy A/A test (2 nhóm cùng thấy 1 trang) để kiểm tra việc chia và đo. Nếu kết quả đẹp bất thường, nghi lỗi đo trước: nhóm Kohavi (2014) nhắc quy tắc Twyman, số liệu trông thú vị bất thường thường là sai.
Chạy bao lâu: tròn tuần và hiệu ứng mới lạ
Chạy đến khi đủ cỡ mẫu và ít nhất 7 ngày, làm tròn lên theo tuần. Optimizely khuyên tối thiểu 1 chu kỳ kinh doanh (7 ngày) vì khách cuối tuần và ngày thường khác nhau; VWO (trang cập nhật 24/9/2026) cũng nêu 7 ngày, kéo dài khi có mùa vụ hoặc thay đổi lớn.
Nhóm Kohavi (2014) khuyên chạy 2 tuần để bắt hiệu ứng mới lạ, dù nói hiệu ứng này ít gặp. Tránh giai đoạn bất thường: Mailchimp nêu tuần Black Friday không điển hình, Tết ở Việt Nam tương tự (suy luận của Click Star).
Xem kết quả sớm làm tăng dương tính giả
Dương tính giả là kết luận "có khác biệt" khi thực tế không có. Theo Evan Miller (bài ngày 18/4/2010, cập nhật 5/2013), dừng ngay khi thấy ý nghĩa 5% làm mức ý nghĩa báo cáo mất giá trị. Trong ví dụ của ông (nền 50%, thay đổi vô tác dụng, dừng khi đạt 5% hoặc sau 150 quan sát), tỷ lệ dương tính giả là 26,1%.
Ông gọi đây là trường hợp xấu nhất. Để giữ mức thực sự 5%, xem giữa chừng 1 lần (cộng lần đọc cuối) phải đặt ngưỡng 2,9%, 2 lần là 2,2%, 3 lần là 1,8%, 5 lần là 1,4% và 10 lần là 1,0%. Cách đếm lần đọc cuối là suy luận của Click Star từ mô phỏng các lần xem cách đều.
Mô phỏng của Click Star: 1.000.000 lần chạy A/A (2 nhánh giống hệt), nền 3%, mỗi nhánh 993 người mỗi ngày trong 14 ngày (tổng 13.902). Mỗi ngày xem kết quả 1 lần (14 lần), kiểm định z hai tỷ lệ hai phía, dừng ngay khi p dưới 0,05.
Dù không có khác biệt, khoảng 22% số lần kết luận "có khác biệt"; chỉ đọc 1 lần ở ngày cuối thì khoảng 5,0%. Đây là mô hình đơn giản, không phải số đo thật.
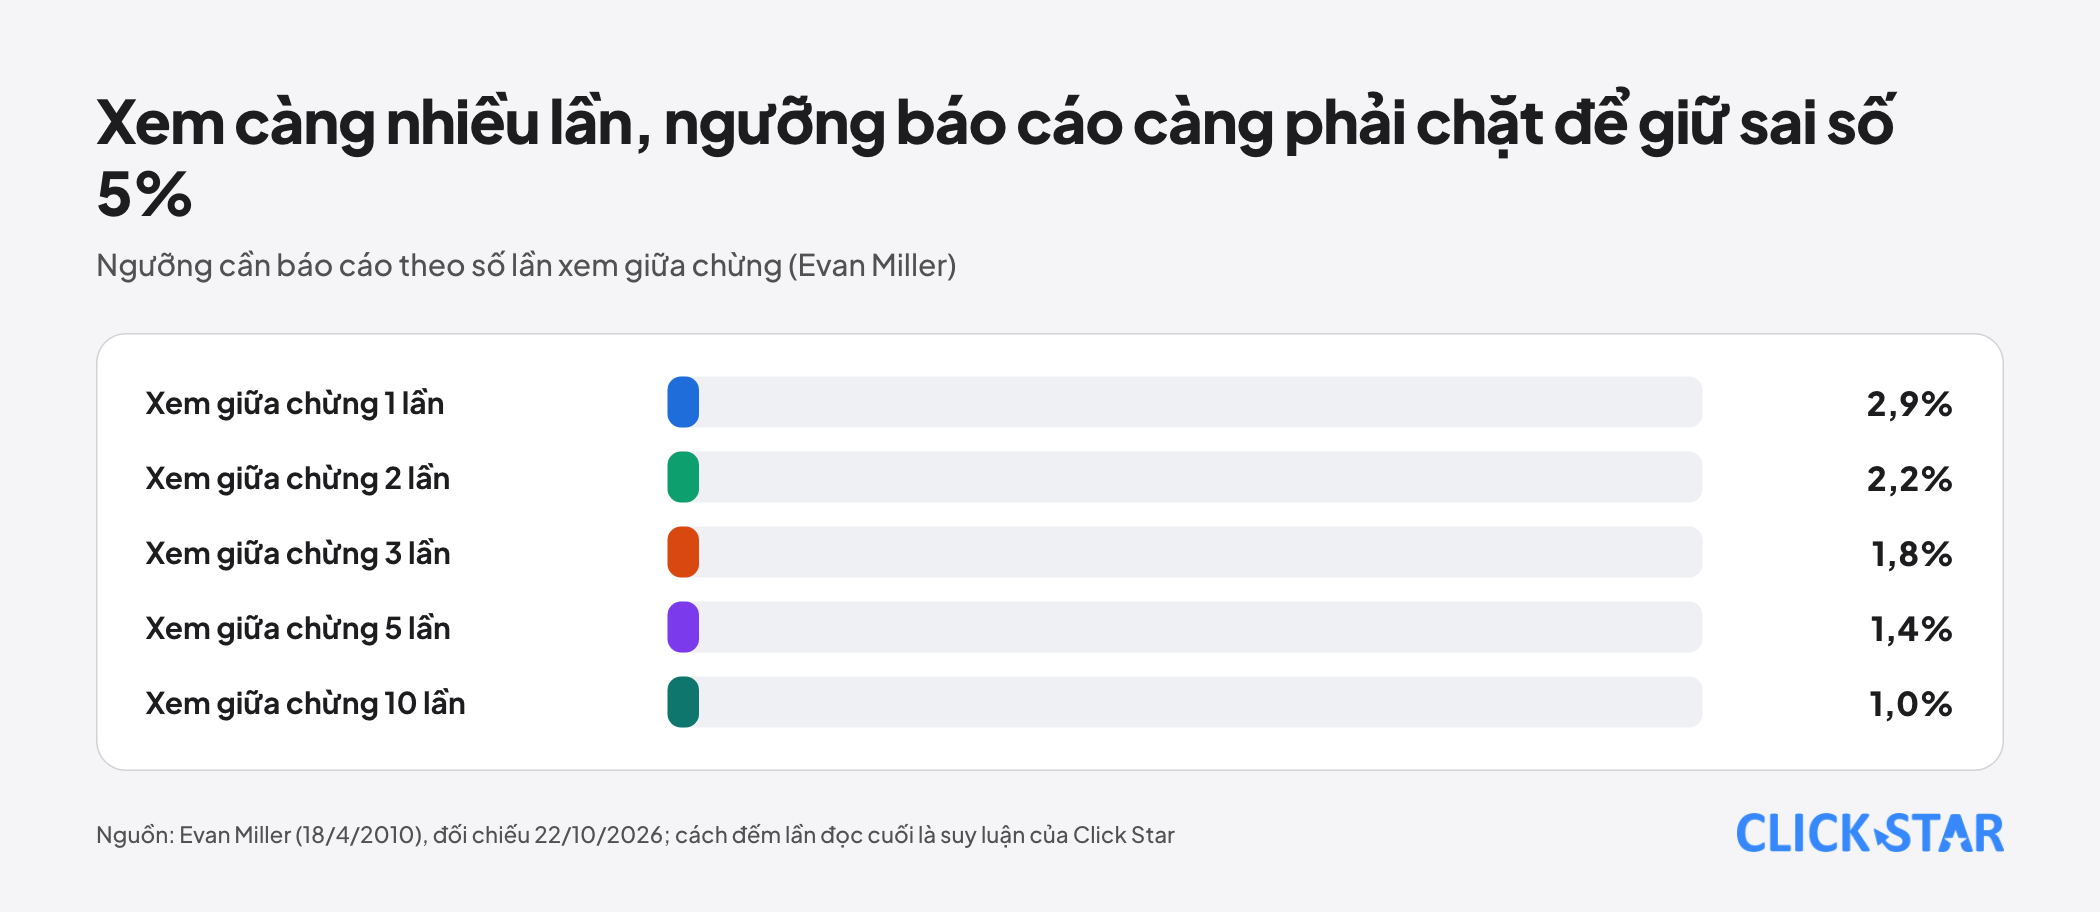
Có 2 cách xử lý. Cách 1: cố định cỡ mẫu và đọc 1 lần, như chế độ cỡ mẫu cố định của Optimizely. Cách 2: dùng phương pháp tuần tự; Statsig mô tả sequential testing điều chỉnh p-value để đọc sớm mà không tăng dương tính giả, chỉ đúng khi dùng đúng công cụ đó.
Nhiều biến thể và nhiều chỉ số làm tăng sai số
Mỗi phép so sánh thêm vào là thêm 1 cơ hội dương tính giả. Theo GrowthBook, 10 thử nghiệm, mỗi thử nghiệm 2 biến thể và 10 chỉ số là 100 phép thử, làm xác suất dương tính giả vượt mức α đã chọn.
Click Star tính: với 20 phép thử độc lập, mỗi phép ở mức 5% và không có hiệu ứng thật, xác suất có ít nhất 1 kết quả "có ý nghĩa" là 64,2%. Chia ngưỡng cho số phép thử (cách Bonferroni) cho 0,25% mỗi phép; giả định độc lập là đơn giản hóa.
Website ít khách: nên làm gì thay thế
Với 200 người mới mỗi ngày và nền 3%, phát hiện mức tăng 20% cần 140 ngày. Website vừa và nhỏ có thể rơi vào vùng này; Click Star không có số đo lưu lượng điển hình ở Việt Nam.
Thử nghiệm yếu còn có hại. Theo Lukas Vermeer và cộng sự (KDD 2026, cập nhật 2/9/2026), nhiều ước lượng cũ có thể đến từ thử nghiệm power dưới 50%, vốn phóng đại hiệu ứng. Khi họ chạy lại 8 thử nghiệm (trung vị 2,4 triệu người), hiệu ứng nhỏ hơn đáng kể so với công bố trước; chỉ 2 trong 8 có ý nghĩa theo hướng mong đợi và 1 theo hướng ngược lại.
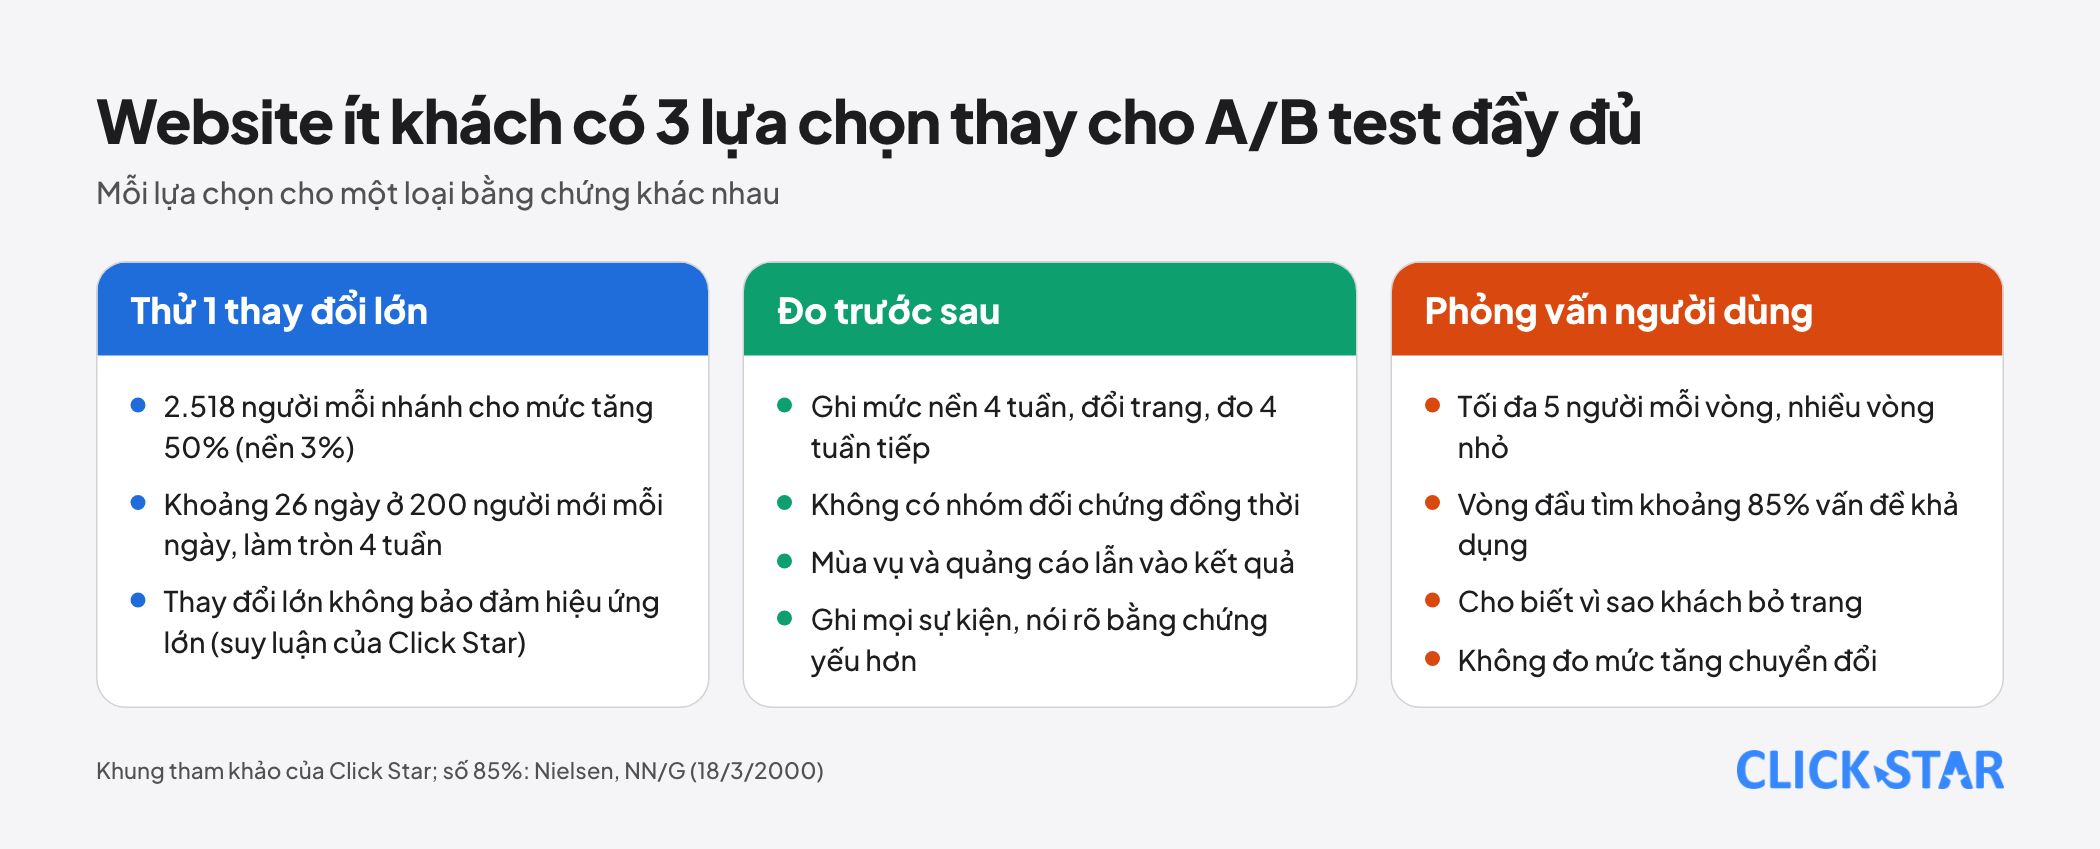
3 phương án dưới đây là khung tham khảo của Click Star. Trước hết hãy sửa lỗi hiển nhiên như tốc độ và biểu mẫu hỏng.
Phương án 1: thử 1 thay đổi lớn. Nền 3% và mức tăng 50% cần 2.518 người mỗi nhánh, khoảng 26 ngày ở 200 người mỗi ngày, làm tròn 4 tuần. Nhóm Kohavi (2014) lưu ý ở Bing phần lớn thử nghiệm thất bại, còn thành công cải thiện chỉ số chính 0,1% đến 1,0% (tính trên toàn bộ chỉ số, sau khi pha loãng).
Theo suy luận của Click Star, thay đổi lớn không bảo đảm hiệu ứng lớn: mức 50% chỉ là mức cần có để thấy được trong 26 ngày, nhiều thử nghiệm sẽ không đạt.
Phương án 2: đo trước sau kèm nhận xét hạn chế. Ghi mức nền 4 tuần, đổi trang, đo 4 tuần tiếp theo. Không có nhóm đối chứng đồng thời nên mùa vụ và quảng cáo lẫn vào; hãy ghi mọi sự kiện và nói rõ đây là bằng chứng yếu hơn A/B test.
Phương án 3: phỏng vấn và quan sát người dùng. Theo Jakob Nielsen (NN/G, 18/3/2000), thử với tối đa 5 người, nhiều vòng nhỏ; vòng đầu tìm được khoảng 85% vấn đề khả dụng.
A/B test cho email
Email chia ngẫu nhiên sẵn và cho kết quả nhanh, nhưng thư phải vào được hộp thư: Click Star đã có bài riêng về SPF, DKIM và DMARC.
Theo hướng dẫn của Mailchimp (không ghi ngày), bài thử gửi cho ít nhất 10% người nhận; hãng khuyên mỗi phiên bản có ít nhất 5.000 liên hệ. Với thử nội dung, hãng khuyên chọn bản thắng theo tỷ lệ nhấp vì lượt mở xảy ra trước khi người nhận xem nội dung.
Theo Apple, Protect Mail Activity tải nội dung từ xa ở nền theo mặc định, bất kể người dùng có tương tác không; Mailchimp nói A/B theo tỷ lệ mở có thể không chính xác.
Với danh sách nhỏ, Click Star tính (tỷ lệ nhấp nền 2%, power 80%, tin cậy 95%): 5.000 người mỗi nhánh chỉ phát hiện mức tăng tương đối khoảng 43%, còn 1.000 người cần khoảng 108%. Hãy thử khác biệt lớn, mỗi lần 1 yếu tố.
Ý nghĩa với doanh nghiệp Việt Nam
Đánh giá của Click Star. Với đa số website vừa và nhỏ, hãy đo đúng chuyển đổi, nối với CRM, sửa lỗi hiển nhiên rồi mới thử nghiệm; khi lưu lượng chưa đủ, đo trước sau và phỏng vấn khách trung thực hơn thử nghiệm yếu. Click Star bán dịch vụ website, digital marketing, CRM và dashboard nên có lợi ích khi khuyên đầu tư đo lường.
Lộ trình 6 tuần cho thử nghiệm đầu tiên
Khung tham khảo của Click Star, giả định khoảng 1.000 người mới vào thử nghiệm mỗi ngày và nền 3%, không lấy từ nguồn ngoài:
- Tuần 1: viết giả thuyết, chọn chỉ số chính và chỉ số bảo vệ, tính cỡ mẫu, chạy A/A hoặc kiểm tra theo dõi.
- Tuần 2: bắt đầu vào đầu tuần, kiểm tra SRM sau 1 đến 2 ngày, chưa đọc chỉ số chính.
- Tuần 3: tiếp tục chạy, ghi mọi thay đổi quảng cáo hoặc sự kiện, kiểm tra lại SRM.
- Tuần 4: tiếp tục chạy, không dừng sớm.
- Tuần 5: chạy hết 28 ngày và cỡ mẫu đã tính, rồi dừng.
- Tuần 6: đọc kết quả 1 lần, kiểm tra chỉ số bảo vệ, ghi quyết định.
Những sai lầm thường gặp
- Dừng ngay khi công cụ báo "có ý nghĩa", không chờ cỡ mẫu đã tính.
- Không tính cỡ mẫu nên không biết mức tăng nhỏ nhất mình phát hiện được.
- Chạy dưới 7 ngày hoặc kết thúc giữa tuần.
- Đọc kết quả khi tỷ lệ chia khách lệch mà không tìm nguyên nhân.
- Đo nhiều chỉ số và nhóm khách rồi chọn cái "thắng".
- Chọn bản thắng email theo tỷ lệ mở.
Điều chưa biết
Click Star không có số đo cho Việt Nam về lưu lượng website, tỷ lệ chuyển đổi nền, mức dùng A/B test hay tỷ lệ người dùng bật Apple Mail Privacy Protection.
Bài KDD 2014 được đọc qua văn bản trích từ tệp PDF, nên bảng số liệu Bing cần đối chiếu bản gốc. Optimizely ghi chế độ cỡ mẫu cố định đang ở bản beta.
Bài liên quan



Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.