Bộ lọc sản phẩm sinh vô số địa chỉ trùng: Google xử lý ra sao?
Bộ lọc sản phẩm có thể tạo ra vô số địa chỉ gần giống nhau. Bài tổng hợp hướng dẫn của Google về chặn thu thập, canonical, phân trang và nút tải thêm.
Một cửa hàng giày trực tuyến (tình huống minh họa, không phải khách hàng thật) có trang "Giày nam" kèm bộ lọc size, màu, giá. Mỗi lần khách bấm lọc, thanh địa chỉ đổi sang một đường dẫn mới. Chủ cửa hàng mở Search Console và thấy rất nhiều trang bị xếp vào nhóm trùng lặp.
Bài này dựa trên tài liệu của Google Search Central và Trợ giúp Search Console, đối chiếu ngày 26/10/2026. Click Star đã có bài riêng về robots.txt, noindex, chuyển hướng và canonical, nên bài này không lặp lại.
Điểm chính
- Bộ lọc dùng tham số trên URL (địa chỉ trang) có thể tạo không gian địa chỉ vô hạn. Theo Google, hậu quả là thu thập quá mức và trang mới được tìm thấy chậm hơn.
- Có 2 hướng. Không cần địa chỉ lọc trên Google thì chặn thu thập (Google nêu robots.txt đầu tiên). Cần thì làm địa chỉ sạch theo hướng dẫn của Google.
rel="canonical"là gợi ý, không phải lệnh, và kém hiệu quả lâu dài hơn chặn thu thập. Đừng vừa chặn bằng robots.txt vừa đặtnoindex, vì Google không thấynoindex.- Phân trang: mỗi trang có địa chỉ riêng, nối nhau bằng thẻ
<a href>, không đặt canonical về trang 1. - Google không bấm nút "tải thêm". Danh sách tải dần cần địa chỉ phân trang để bot đi tới.
- Kiểm tra bằng Page indexing, URL Inspection, Crawl Stats và nhật ký máy chủ.
Bộ lọc biến 1 trang danh mục thành bao nhiêu địa chỉ?
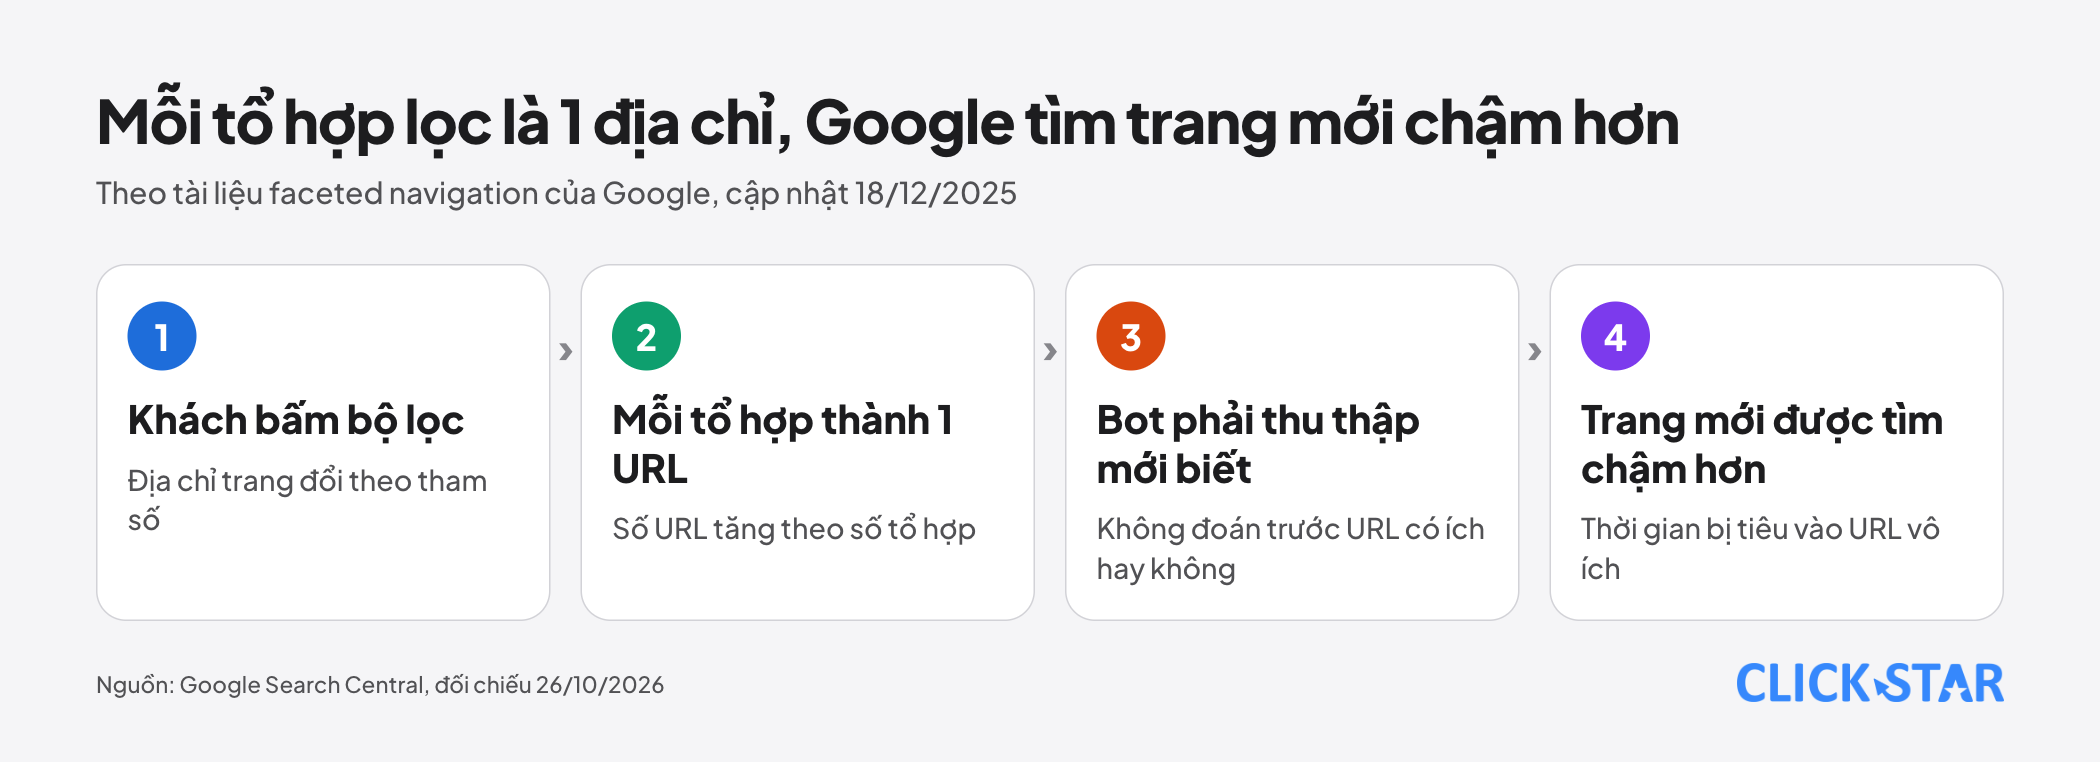
Rất nhiều, vì mỗi tổ hợp lựa chọn có thể là 1 địa chỉ riêng. Bộ lọc theo thuộc tính (faceted navigation) thường gắn tham số vào địa chỉ, như ví dụ của Google: https://example.com/items.shtm?products=fish&color=radioactive_green&size=tiny.
Phép tính minh họa của Click Star, không phải số đo: 3 bộ lọc, mỗi bộ 5 lựa chọn và được bỏ trống, cho 6 × 6 × 6 − 1 = 215 địa chỉ lọc mỗi danh mục, chưa tính sắp xếp và phân trang.
Google nói gì về hậu quả?
Thời gian thu thập của Google bị tiêu vào địa chỉ vô ích. Theo tài liệu về faceted navigation của Google (cập nhật ngày 18/12/2025), bot chỉ biết một địa chỉ lọc có ích hay không sau khi thu thập, nên thường thu thập rất nhiều địa chỉ trước khi kết luận.
Hệ quả thứ hai là khám phá chậm hơn: bot có ít thời gian hơn cho địa chỉ mới và hữu ích.
Tài liệu về ngân sách thu thập (crawl budget, cập nhật ngày 22/7/2026) nói nhiều địa chỉ trùng nhau làm Google phí thời gian, và đây là yếu tố chủ website kiểm soát được nhiều nhất.
Giới hạn: trang đó nhắm tới 3 nhóm: website từ 1 triệu trang đổi mỗi tuần, website từ 10.000 trang đổi hằng ngày, và website có nhiều địa chỉ ở trạng thái "Discovered - currently not indexed". Google nói số liệu là ước lượng, không phải ngưỡng.
Với website không thuộc các nhóm trên, Google nói giữ sitemap cập nhật và xem báo cáo Page indexing đều đặn là đủ.
Trang không được lập chỉ mục chưa chắc là lỗi. Trợ giúp Search Console (không ghi ngày, đọc ngày 26/10/2026) nói bản sao do lọc hoặc sắp xếp được gắn nhãn "duplicate" hoặc "alternate", và Google không lập chỉ mục bản sao.
Tổ hợp nào đáng có trang riêng?
Câu hỏi đầu tiên mang tính kinh doanh: khách có tìm tổ hợp này trên Google không? Khung dưới đây là khung tham khảo của Click Star, không lấy từ nguồn ngoài; Google không đưa danh sách tổ hợp nên giữ.
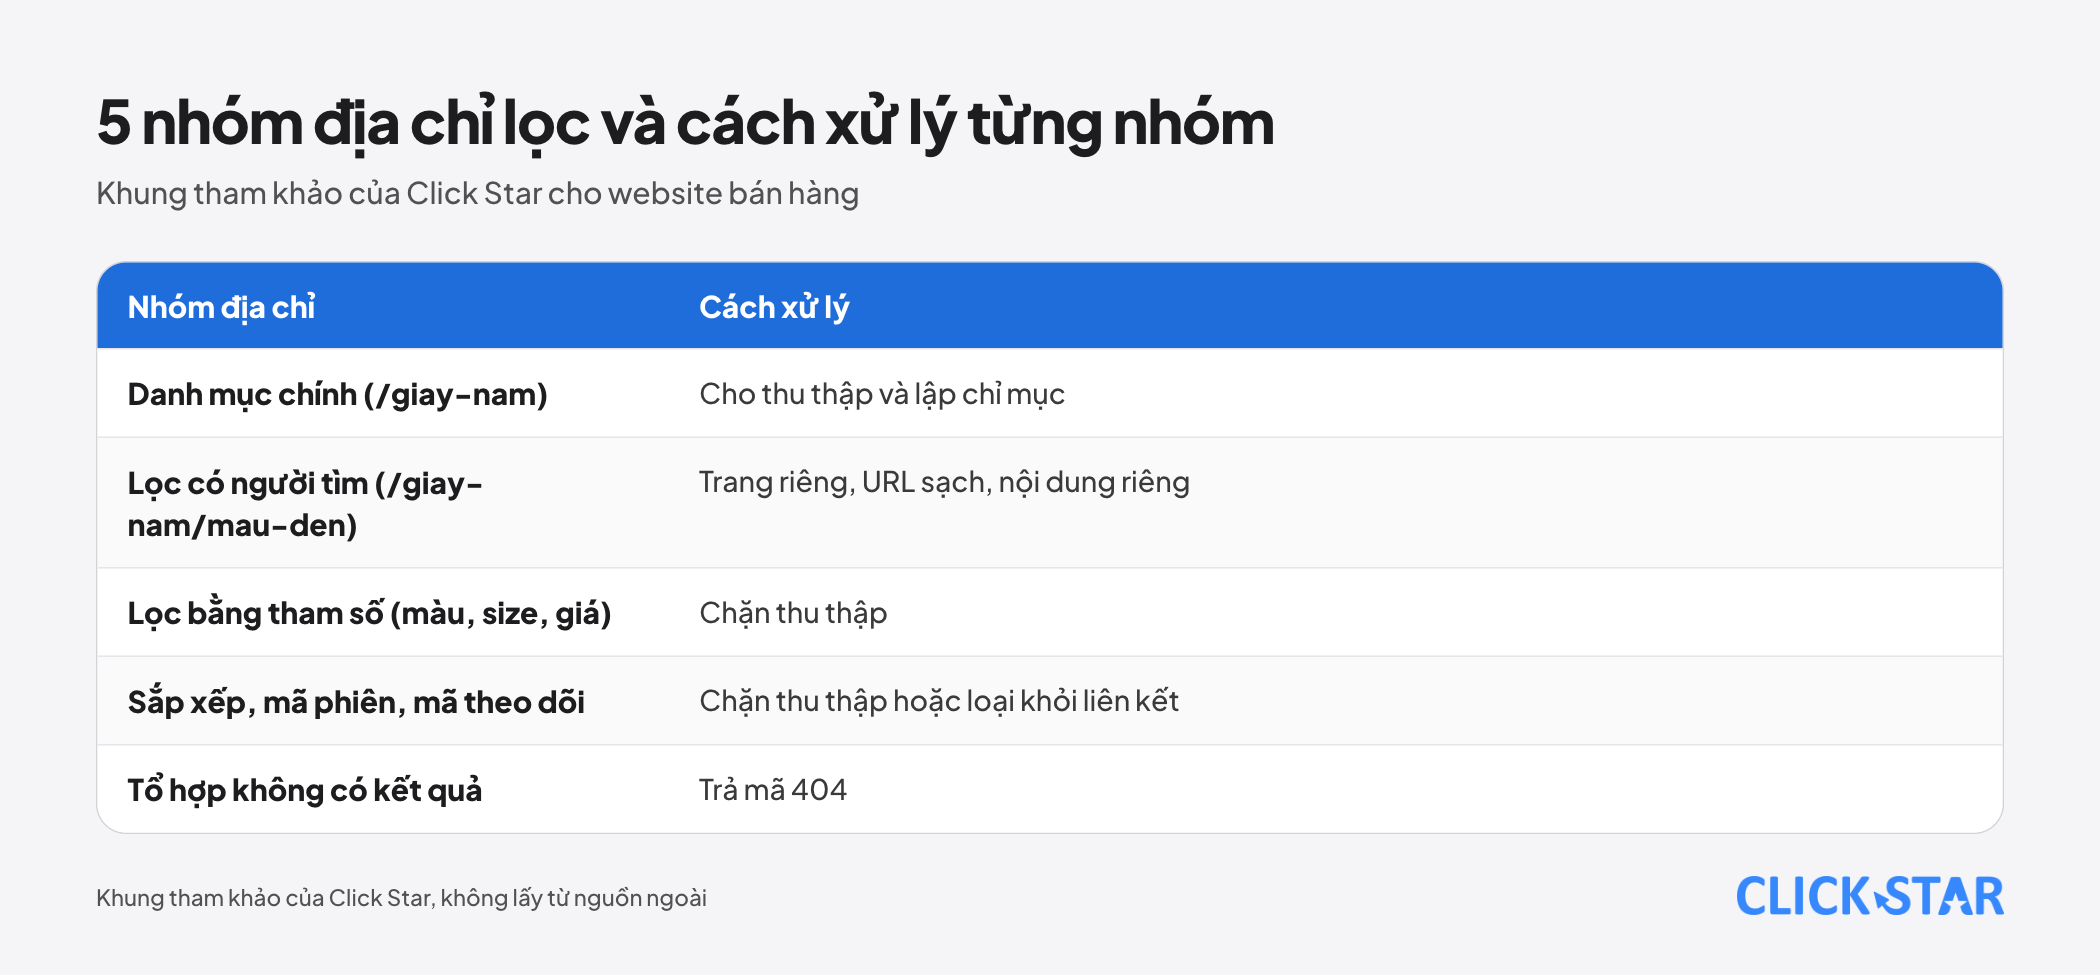
- Danh mục chính (ví dụ
/giay-nam): cho thu thập và lập chỉ mục. - Lọc có người tìm thật (ví dụ
/giay-nam/mau-den): làm trang riêng, địa chỉ sạch, nội dung riêng, tự trỏ canonical về chính nó. - Lọc bằng tham số (màu, size, giá): chặn thu thập.
- Sắp xếp, mã phiên, mã theo dõi: chặn thu thập hoặc loại khỏi liên kết.
- Tổ hợp không có kết quả: trả mã 404.
Nhóm thứ hai cần nội dung riêng vì Google gom các trang có nội dung chính rất giống nhau thành 1 cụm và chỉ chọn 1 bản đại diện (tài liệu canonicalization, cập nhật ngày 20/8/2026).
Nếu không cần lập chỉ mục: chặn thu thập
Theo tài liệu faceted, thường không có lý do tốt để cho thu thập trang đã lọc, vì tốn tài nguyên mà lợi ích rất nhỏ. Nên cho thu thập từng trang sản phẩm và 1 trang danh sách không lọc.
Ví dụ chỉnh từ mẫu của Google, với tên tham số giả. Mẫu gốc /*?*color= khớp cả bgcolor=, còn /*?*size= khớp cả pagesize=, nên mỗi tham số dùng 2 dòng, ? và &:
user-agent: *
disallow: /*?color=
disallow: /*&color=
disallow: /*?size=
disallow: /*&size=
disallow: /*?sort=
disallow: /*&sort=
Mẫu này chặn mọi địa chỉ chứa các tham số đó, kể cả lọc 1 tiêu chí như ?color=den. Bộ lọc có người tìm nên dùng đường dẫn sạch.
Theo tài liệu về cách Google hiểu robots.txt (cập nhật ngày 23/10/2026), * thay cho 0 hoặc nhiều ký tự bất kỳ. Khi quy tắc xung đột, Google dùng quy tắc có đường dẫn dài hơn, và nếu vẫn xung đột thì dùng quy tắc ít hạn chế hơn.
Giới hạn: địa chỉ bị chặn vẫn có thể được lập chỉ mục nếu nơi khác trỏ tới, thường không có mô tả (giới thiệu robots.txt, cập nhật ngày 10/12/2025). Theo tài liệu crawl budget, chặn cũng không tự chuyển thời gian dư sang trang khác, trừ khi Google đang chạm giới hạn.
Cách khác theo tài liệu faceted: đặt bộ lọc sau dấu #. Google nhìn chung không hỗ trợ phần này, nên bộ lọc không ảnh hưởng tới thu thập và thường không có trang lọc riêng trong chỉ mục.
Nếu cần lập chỉ mục: làm sạch địa chỉ
Tài liệu faceted nêu các việc sau cho địa chỉ lọc muốn xuất hiện trên Google.
- Dùng
&làm dấu ngăn tham số. Dấu phẩy, chấm phẩy và ngoặc vuông khó được bot nhận ra là dấu ngăn (dấu phẩy chỉ hợp để liệt kê nhiều giá trị của 1 tham số). - Bộ lọc nằm trong đường dẫn (như
/giay-nam/den/size-42) thì thứ tự bộ lọc phải cố định và không được lặp. - Tổ hợp không có kết quả thì trả mã 404 ngay tại địa chỉ đó, không chuyển về trang lỗi chung. Quy tắc này cũng áp cho bộ lọc lặp và trang phân trang không tồn tại.
Tài liệu cấu trúc URL của Google (cập nhật ngày 21/10/2026) bổ sung: chỉ giữ tham số làm đổi nội dung, dùng dấu gạch ngang thay gạch dưới, và nhớ rằng địa chỉ phân biệt chữ hoa chữ thường. Với tiếng Việt, Click Star khuyên chọn 1 kiểu (có dấu hoặc không dấu) cho cả website; chưa có nguồn nói kiểu nào xếp hạng tốt hơn.
Theo hướng dẫn khai báo canonical của Google (cập nhật ngày 10/7/2026), mọi địa chỉ trong sitemap được coi là đề xuất canonical, nên chỉ đưa bản canonical vào. Liên kết nội bộ cũng nên trỏ tới bản canonical.
Canonical, robots.txt và noindex: mỗi công cụ một việc
- Canonical là gợi ý: Google có thể chọn trang khác. Tài liệu faceted nói canonical có thể dần giảm thu thập bản không canonical, nhưng nhìn chung kém hiệu quả lâu dài hơn chặn thu thập.
- Noindex vẫn buộc Google thu thập để thấy nó. Tài liệu crawl budget khuyên không dùng noindex để tiết kiệm thu thập.
- Trộn robots.txt với noindex trên cùng địa chỉ là lỗi hay gặp: tài liệu noindex nói nếu trang bị chặn, bot không bao giờ thấy quy tắc này.
Phân trang: mỗi trang 1 địa chỉ riêng
Theo tài liệu phân trang của Google (cập nhật ngày 10/12/2025):
- Mỗi trang có 1 địa chỉ riêng, ví dụ
?page=2. - Nối trang này sang trang kế bằng thẻ
<a href>. Nên cân nhắc thêm liên kết từ mọi trang về trang đầu. - Không dùng trang đầu làm canonical cho cả chuỗi. Mỗi trang có canonical riêng.
- Không dùng phần sau dấu
#cho số trang, vì Google bỏ qua nó và có thể không đi theo liên kết. - Google không còn dùng
rel="next"vàrel="prev".
Địa chỉ phân trang vượt quá số trang thật nên trả mã 404 (tài liệu faceted).
"Tải thêm" và cuộn vô hạn: bot không bấm, không cuộn
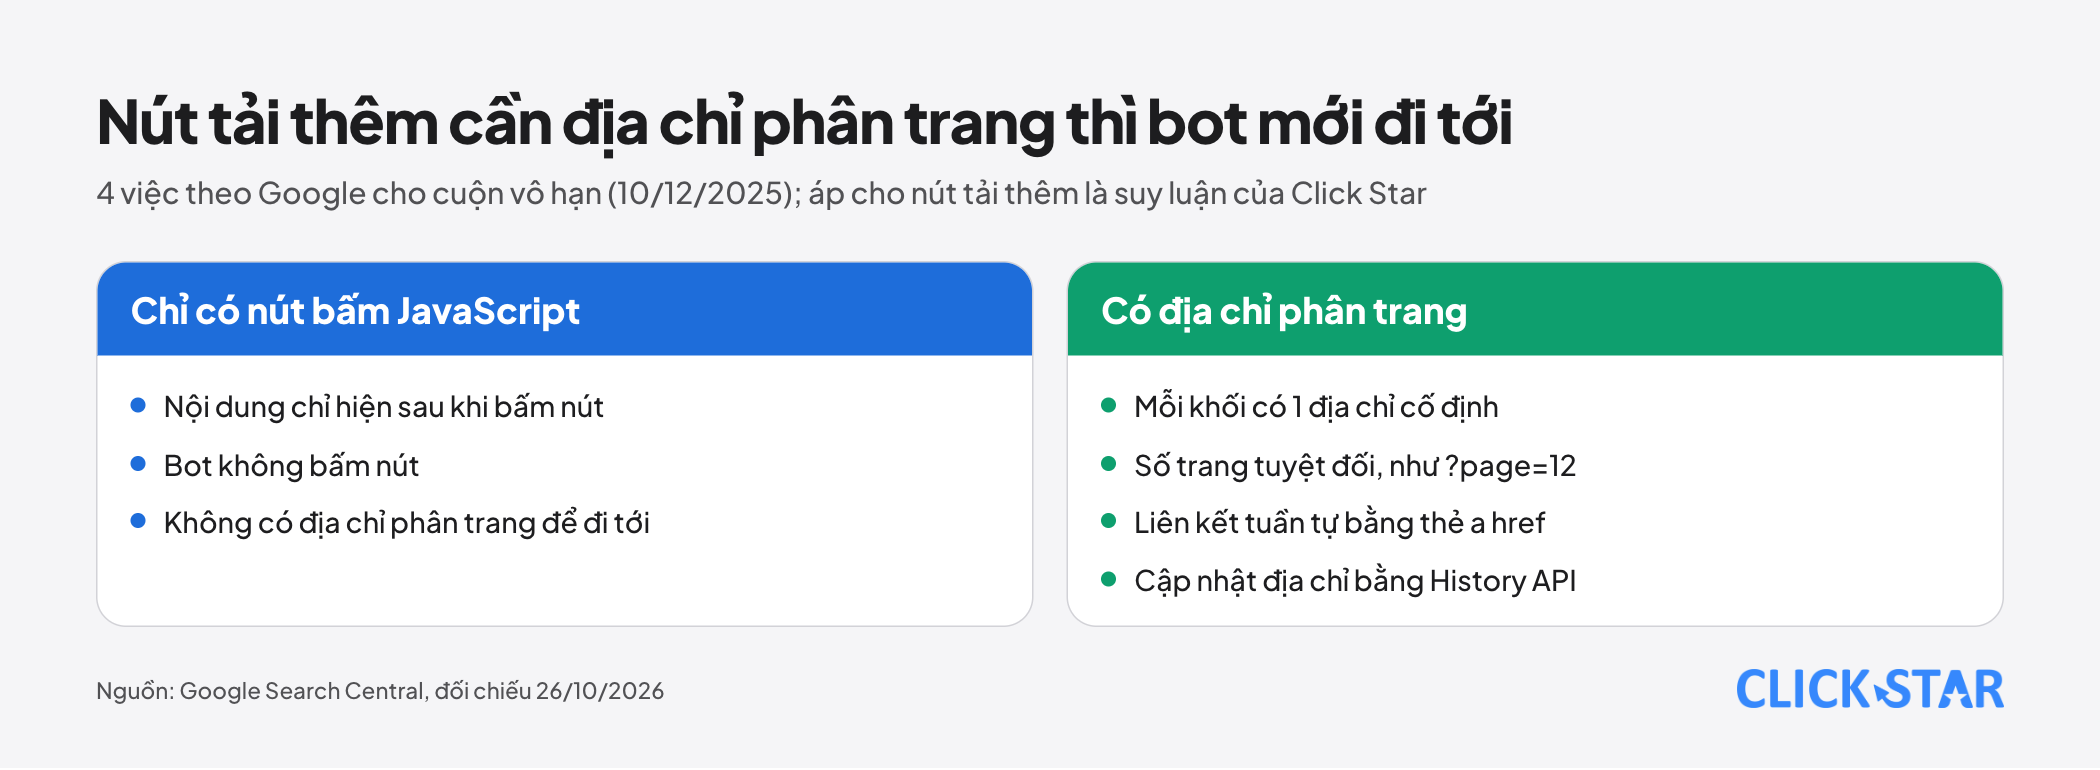
Google thường thu thập địa chỉ nằm trong href của thẻ <a>. Theo tài liệu phân trang, bot không "bấm" nút và thường không chạy hàm JavaScript cần thao tác của người dùng.
Muốn cuộn vô hạn được lập chỉ mục, tài liệu về nội dung tải lười (cập nhật ngày 10/12/2025) nêu 4 việc:
- Mỗi khối nội dung có 1 địa chỉ cố định, nội dung không đổi giữa các lần tải. Dùng số trang tuyệt đối như
?page=12, tránh tham số tương đối như?date=yesterday. - Liên kết tuần tự tới các địa chỉ đó.
- Khi khối mới trở thành phần hiển thị chính, cập nhật địa chỉ bằng History API.
- Kiểm tra bằng URL Inspection xem nội dung có trong HTML đã dựng hay không.
Tài liệu này chỉ viết về cuộn vô hạn. Áp 4 việc đó cho nút "tải thêm" là suy luận của Click Star.
Cách kiểm tra
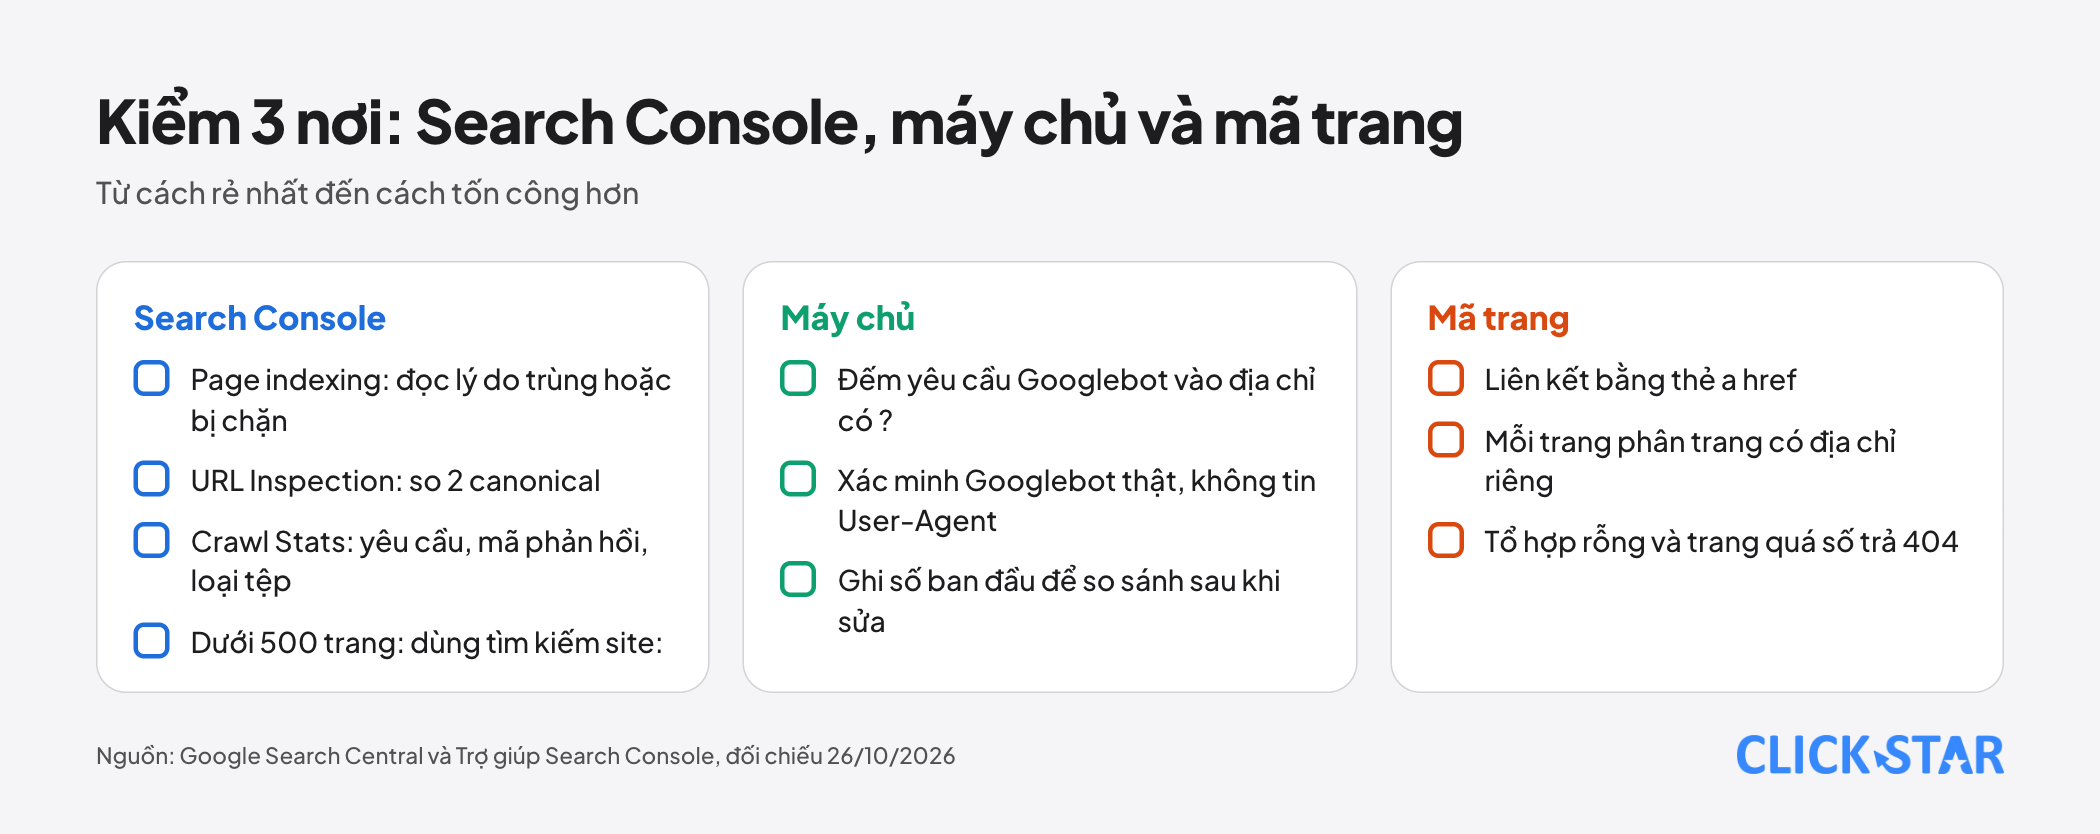
Kiểm tra theo 4 lớp, từ rẻ đến tốn công. Với website dưới 500 trang, Trợ giúp Search Console nói có thể không cần báo cáo Page indexing, mà dùng tìm kiếm site:ten-mien.vn.
- Page indexing: cho thấy lý do từng địa chỉ không được lập chỉ mục. Đáng xem: "Duplicate without user-selected canonical", "Duplicate, Google chose different canonical than user", "Indexed, though blocked by robots.txt".
- URL Inspection: so canonical bạn khai báo với canonical Google chọn. Địa chỉ bị chặn bởi robots.txt luôn hiện "Indexing allowed?" là "Yes", vì Google không thấy noindex.
- Crawl Stats: số yêu cầu, mã phản hồi, loại tệp. Google nói website dưới 1.000 trang thường không cần báo cáo này.
- Nhật ký máy chủ: đếm yêu cầu của Googlebot vào địa chỉ có dấu
?. Chữ trong User-Agent có thể bị giả mạo, nên hãy xác minh Googlebot thật theo hướng dẫn của Google (cập nhật ngày 20/3/2026).
Với doanh nghiệp Việt Nam, điều này nghĩa là gì?
Click Star không có số đo về tỷ lệ website Việt Nam gặp lỗi bộ lọc.
Cửa hàng trực tuyến, bất động sản, tuyển dụng và danh bạ (suy luận của Click Star) hay gặp tình huống này. Cách chắc nhất là mở website thật, bấm thử các bộ lọc và xem địa chỉ đổi thế nào. Với website vài chục sản phẩm, hãy ưu tiên liên kết sạch, 404 đúng và phân trang có địa chỉ riêng.
Công khai lợi ích: Click Star làm dịch vụ thiết kế website chuẩn SEO tải nhanh, nên có lợi ích liên quan.
Đánh giá của Click Star. Với phần lớn website doanh nghiệp, thứ tự hợp lý là giữ danh mục chính thật sạch, chặn sắp xếp và lọc bằng tham số (kể cả nhiều tiêu chí) bằng robots.txt, chỉ mở trang riêng cho vài tổ hợp có người tìm. Canonical vẫn nên đặt, nhưng như lớp phụ.
Click Star ngại nhất việc chặn nhầm: 1 dòng disallow sai mẫu có thể chặn cả danh mục chính. Đây là nhận định kỹ thuật, không phải số đo.
Lộ trình 5 ngày
Khung tham khảo của Click Star, không lấy từ nguồn ngoài.
- Ngày 1: liệt kê mọi tham số và dạng đường dẫn lọc đang có, từ menu, Search Console và nhật ký.
- Ngày 2: xếp địa chỉ vào 5 nhóm ở trên và quyết định nhóm nào được lập chỉ mục.
- Ngày 3: sửa mã: liên kết
<a href>, dùng&, 404 cho tổ hợp rỗng và trang quá số, địa chỉ riêng cho từng trang phân trang. - Ngày 4: soạn robots.txt, thử trên địa chỉ mẫu ở môi trường thử rồi triển khai.
- Ngày 5: kiểm 5 đến 10 địa chỉ mẫu bằng URL Inspection, ghi lại số ban đầu của Page indexing và Crawl Stats.
Sau đó theo dõi hằng tuần, vì Googlebot có thể mất nhiều tháng mới quay lại một trang ít quan trọng (tài liệu noindex).
Những sai lầm thường gặp
- Đặt canonical của mọi trang phân trang về trang 1.
- Chặn bằng robots.txt rồi đặt thêm
noindexcho cùng địa chỉ. - Dùng dấu
#cho số trang hoặc cho bộ lọc muốn được lập chỉ mục. - Làm nút "tải thêm" chỉ bằng JavaScript, không có địa chỉ phân trang.
- Chuyển tổ hợp không có kết quả về trang lỗi chung thay vì trả 404.
- Đưa địa chỉ lọc vào sitemap trong khi cố chặn chúng (suy luận của Click Star).
- Viết robots.txt xong không thử, rồi chặn nhầm danh mục chính.
Điều chưa biết
Google không nêu số địa chỉ lọc "an toàn" hay ngưỡng bắt đầu gây hại. Chưa có số đo về website Việt Nam. Google không công bố mức giảm thu thập của từng cách.
Trợ giúp Search Console không hiển thị ngày cập nhật, và Click Star chưa kiểm bản dịch tiếng Việt của giao diện. Bài chỉ nói về Google, chưa kiểm Bing và công cụ khác.
Bài liên quan



Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.