Cơ sở dữ liệu vector là gì và khi nào doanh nghiệp cần: pgvector hay dịch vụ riêng, tìm kiếm lai và chi phí vận hành
Embedding, độ đo tương đồng, chỉ mục HNSW và IVFFlat, tìm kiếm lai, pgvector so với dịch vụ riêng và chi phí, dựa trên tài liệu chính thức.
Nhiều doanh nghiệp nghe nói "phải có cơ sở dữ liệu vector" khi làm tìm kiếm thông minh hoặc trợ lý AI, rồi mua dịch vụ riêng trước khi biết mình cần tìm gì. Có nơi lại giữ ô tìm kiếm khớp từ khóa dù khách hỏi bằng câu tự nhiên.
Bài này giải thích embedding, độ đo tương đồng, chỉ mục HNSW và IVFFlat, tìm kiếm lai, rồi so pgvector với dịch vụ riêng. Nguồn chính là tài liệu của pgvector, Supabase, PostgreSQL, OpenAI, Google, Pinecone, Qdrant, Weaviate và trang giá chính thức, đối chiếu đến ngày 21/10/2026.
Click Star đã có bài về cơ sở dữ liệu trong vận hành online và bài Supabase Select 2026; RAG có bài riêng. Click Star làm dịch vụ tích hợp AI và dashboard dữ liệu, tức có lợi ích liên quan; bài không xếp hạng sản phẩm.
Điểm chính
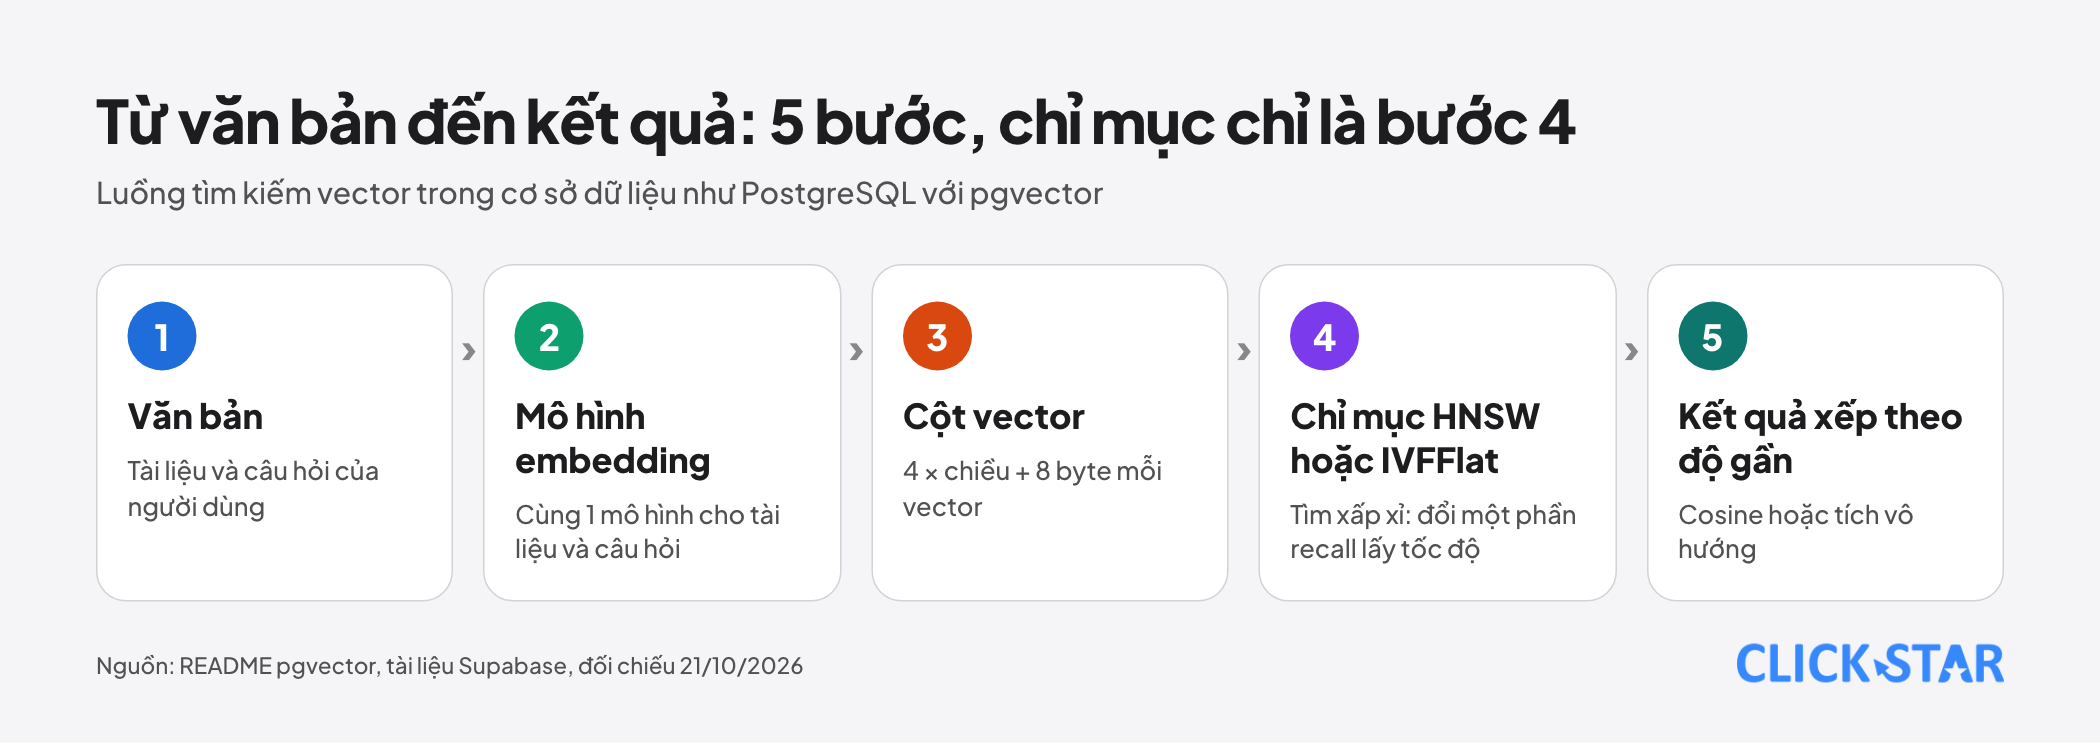
- Cơ sở dữ liệu vector lưu embedding (dãy số biểu diễn nghĩa của văn bản) và tìm bản ghi gần câu hỏi nhất. Theo README của pgvector, mặc định nó tìm chính xác; chỉ mục HNSW hoặc IVFFlat đổi một phần recall lấy tốc độ.
- Vector đã chuẩn hóa độ dài 1 (như của OpenAI) cho thứ hạng cosine và tích vô hướng giống nhau. Chưa rõ thì Supabase khuyên dùng cosine.
- Tìm kiếm lai chạy từ khóa và vector riêng rồi trộn danh sách. Pinecone nói mỗi phương pháp bỏ sót điều phương pháp kia bắt được, nên mã sản phẩm và tên riêng vẫn cần lớp từ khóa.
- Chưa cần khi kho nhỏ, câu hỏi chủ yếu là mã hoặc tên chính xác, hoặc tìm kiếm toàn văn PostgreSQL đã đủ.
- pgvector giữ vector cạnh dữ liệu nghiệp vụ; dịch vụ riêng thêm tính năng chuyên biệt nhưng cũng thêm một hệ thống phải đồng bộ, bảo mật và trả tiền.
- Đổi mô hình embedding là nhúng lại cả kho: Google ghi 2 mô hình Gemini có không gian embedding không tương thích.
Embedding và độ đo tương đồng
Embedding biến văn bản thành dãy số sao cho văn bản gần nghĩa nằm gần nhau. Theo trang khái niệm của Supabase (đọc ngày 21/10/2026), mô hình gte-small cho ra 384 chiều, rồi độ tương đồng tính bằng phép toán vector như khoảng cách cosine.
Tài liệu OpenAI (đọc ngày 21/10/2026) ghi text-embedding-3-small có 1536 chiều và text-embedding-3-large có 3072 chiều. Tham số dimensions rút ngắn vector: trên bộ đo MTEB, bản large rút còn 256 chiều vẫn vượt ada-002 nguyên bản 1536 chiều, theo OpenAI.
pgvector hỗ trợ khoảng cách L2 (<->), tích vô hướng âm (<#>), cosine (<=>) và vài độ đo khác. OpenAI khuyên dùng cosine; vì vector của họ đã chuẩn hóa độ dài 1, cosine tính bằng tích vô hướng và cho thứ hạng giống khoảng cách Euclid.
Chỉ mục xấp xỉ: HNSW, IVFFlat và đánh đổi độ chính xác với tốc độ
README pgvector viết rằng mặc định pgvector tìm lân cận chính xác, recall hoàn hảo. Thêm chỉ mục xấp xỉ thì đổi một phần recall lấy tốc độ, và kết quả có thể khác lúc chưa có chỉ mục.
HNSW là đồ thị nhiều tầng (Malkov và Yashunin, arXiv 1603.09320, bản 14/8/2018), độ phức tạp tăng theo hàm logarit. README nói HNSW đánh đổi tốt hơn IVFFlat nhưng build chậm và tốn bộ nhớ hơn. Mặc định m = 16, ef_construction = 64, ef_search = 40; tăng ef_search thì recall cao hơn nhưng chậm hơn.
IVFFlat chia vector thành các danh sách (lists) và chỉ quét vài danh sách gần câu hỏi. Nó build nhanh và nhẹ hơn HNSW nhưng đánh đổi kém hơn. README nêu 3 điều kiện: tạo chỉ mục sau khi có dữ liệu, lists khoảng rows/1000 (đến 1 triệu dòng), probes khoảng căn bậc hai của lists. Probes mặc định chỉ là 1.
Supabase khuyên HNSW vì độ bền khi dữ liệu đổi, và nói không cần chỉ mục nếu kho nhỏ, ít truy vấn hoặc cần chính xác 100%.
Bẫy với bộ lọc: README giải thích chỉ mục xấp xỉ lọc sau khi quét. Nếu điều kiện khớp 10% dòng và ef_search là 40, trung bình chỉ còn khoảng 4 dòng. Từ phiên bản 0.8.0 có quét lặp (iterative scan) để quét thêm cho đủ kết quả.
Về số đo, benchmark của Supabase (trang chọn gói tính toán, đọc ngày 21/10/2026) dùng HNSW, độ chính xác 0,99, embedding OpenAI 1536 chiều: gói Micro (RAM 1 GB) chạy 15.000 vector ở 480 QPS, Medium (4 GB) 100.000 vector ở 240 QPS, 2XL (32 GB) 1.000.000 vector ở 560 QPS. Đó là số của Supabase trên bộ dữ liệu dbpedia, đã chỉnh tham số theo từng gói.
Tìm kiếm lai: từ khóa, vector và cách trộn
Vector bắt nghĩa nhưng có thể hụt khi người dùng gõ mã sản phẩm, tên riêng hay dòng lỗi. Pinecone (đọc ngày 21/10/2026) nói từ khóa khớp token cụ thể, vector đặc khớp theo nghĩa, và mỗi phương pháp bỏ sót điều phương pháp kia bắt được.
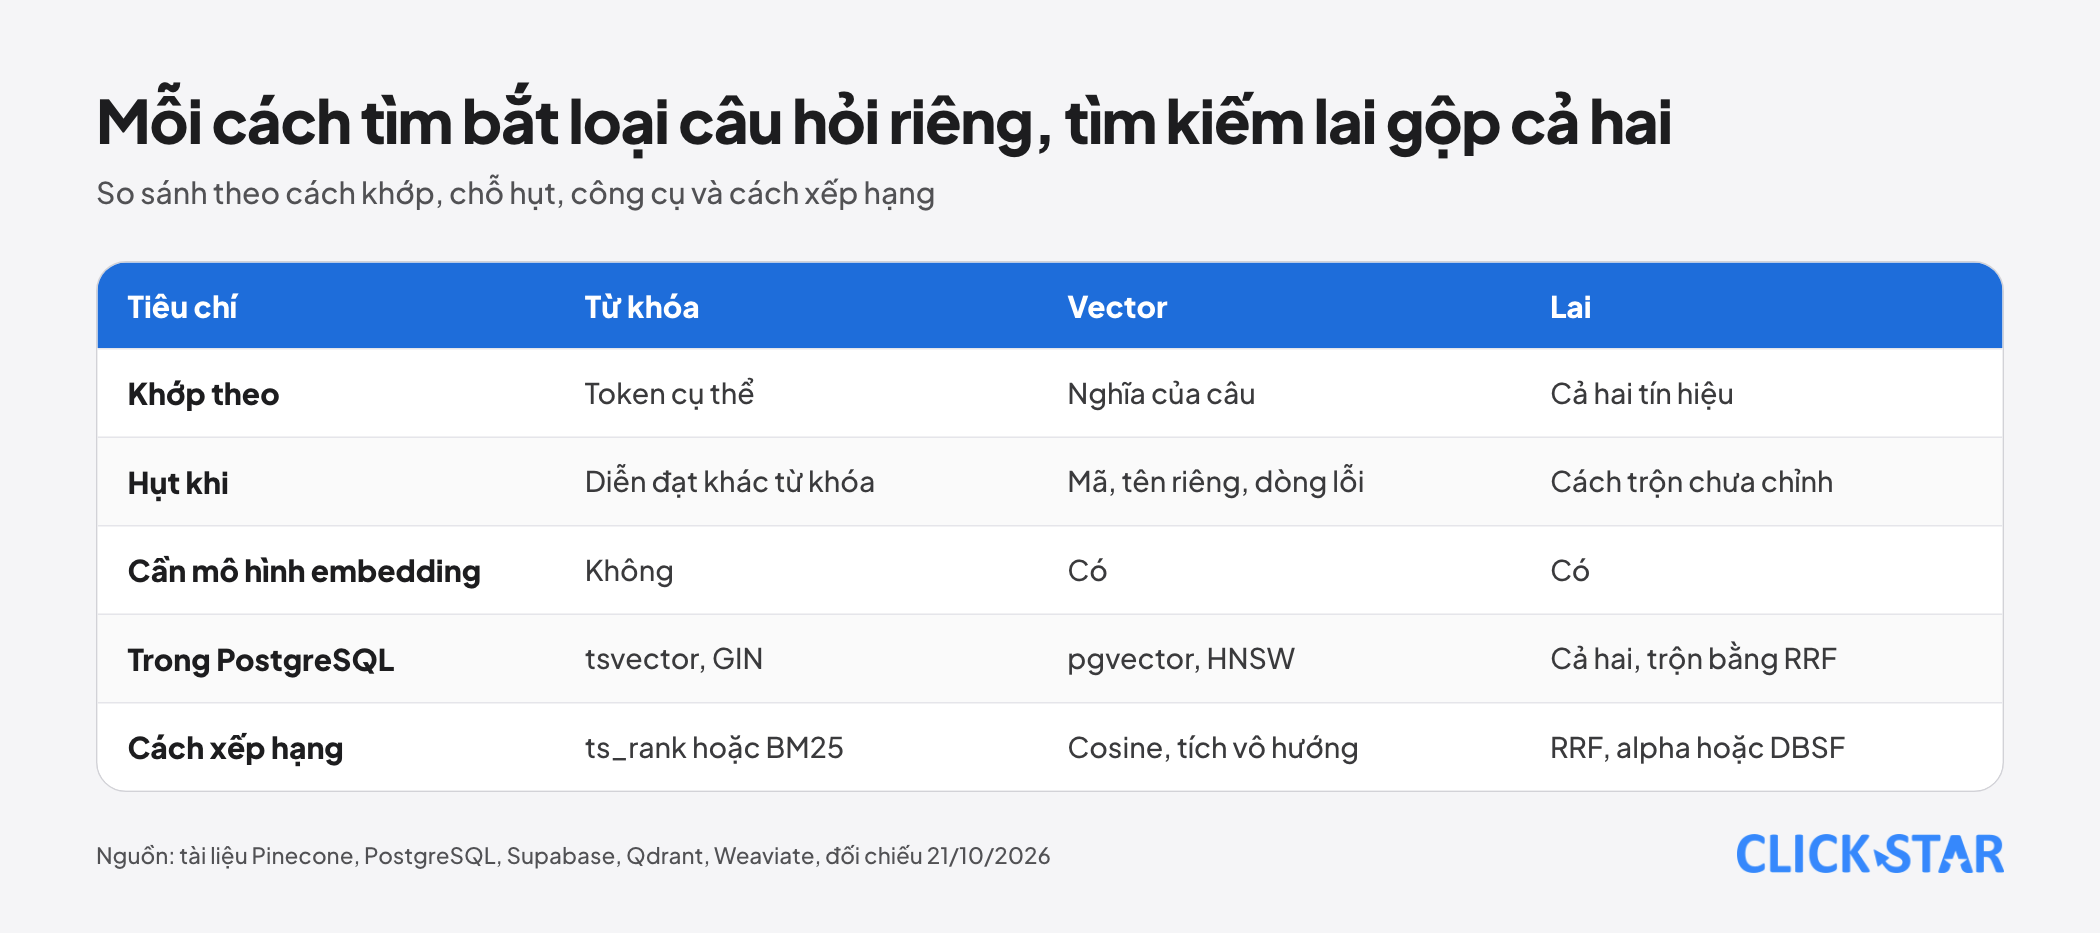
PostgreSQL có sẵn tìm kiếm toàn văn (tsvector, tsquery). Tài liệu PostgreSQL (đọc ngày 21/10/2026) nói LIKE không có xếp hạng và chậm vì thiếu chỉ mục, còn GIN là chỉ mục ưu tiên cho văn bản.
Hàm ts_rank xếp theo tần suất từ khớp và, theo tài liệu, không dùng thông tin toàn cục; Click Star nhận định (không phải số đo) rằng nó khác BM25 của Weaviate và Pinecone, nên hãy thử trên dữ liệu thật.
Cách trộn có nhiều biến thể. Supabase dùng Reciprocal Rank Fusion (RRF): điểm là tổng 1/(k + thứ hạng) ở mỗi danh sách, k mặc định 50, trọng số mặc định là 1. Qdrant có RRF và DBSF, coi RRF là mặc định an toàn khi chưa có bộ đánh giá. Weaviate dùng tham số alpha (1 là vector thuần, 0 là từ khóa thuần).
Pinecone lưu ý "tìm kiếm lai" không phải phương pháp cố định và RRF chỉ là một cách trộn, nên hãy hỏi nhà cung cấp tín hiệu nào, trộn thế nào.
Về bằng chứng, Anthropic (19/9/2024) viết embedding kết hợp BM25 tốt hơn embedding đơn lẻ; bản có ngữ cảnh hóa giảm truy xuất thất bại ở top 20 từ 5,7% xuống 2,9%. Đây là thử nghiệm của một hãng, nên không suy ra số cho tiếng Việt.
Với tiếng Việt, ví dụ lai của Supabase dùng cấu hình to_tsvector('english', ...), và các trang PostgreSQL đã đọc không nhắc tiếng Việt. Mô-đun unaccent bỏ dấu được; hãy thử bằng câu hỏi thật của khách.
Khi nào chưa cần cơ sở dữ liệu vector
Chưa cần trong 3 tình huống thường gặp.
- Kho nhỏ: Anthropic viết (2024) rằng kho dưới 200.000 token (khoảng 500 trang) có thể đưa thẳng vào câu lệnh. Giới hạn ngữ cảnh và giá đã đổi từ đó, nên hãy kiểm tra thông số hiện tại.
- Câu hỏi chủ yếu là mã, tên, số hợp đồng: từ khóa hoặc toàn văn đủ dùng và dễ giải thích.
- Chưa có bộ câu hỏi mẫu: không có thì không biết vector có hơn từ khóa không.
pgvector hay dịch vụ vector riêng
README ghi pgvector giữ vector cạnh phần còn lại của dữ liệu, có ACID, khôi phục tại thời điểm và JOIN. Mỗi vector 1536 chiều tốn 4 × chiều + 8 byte (6.152 byte); bảng không phân vùng tối đa 32 TB. Chỉ mục hỗ trợ đến 2.000 chiều cho vector và 4.000 cho halfvec.
Dịch vụ riêng mô tả điều họ thêm. Qdrant có HNSW lọc theo payload và truy vấn nhiều giai đoạn. Pinecone có namespace cho nhiều khách thuê.
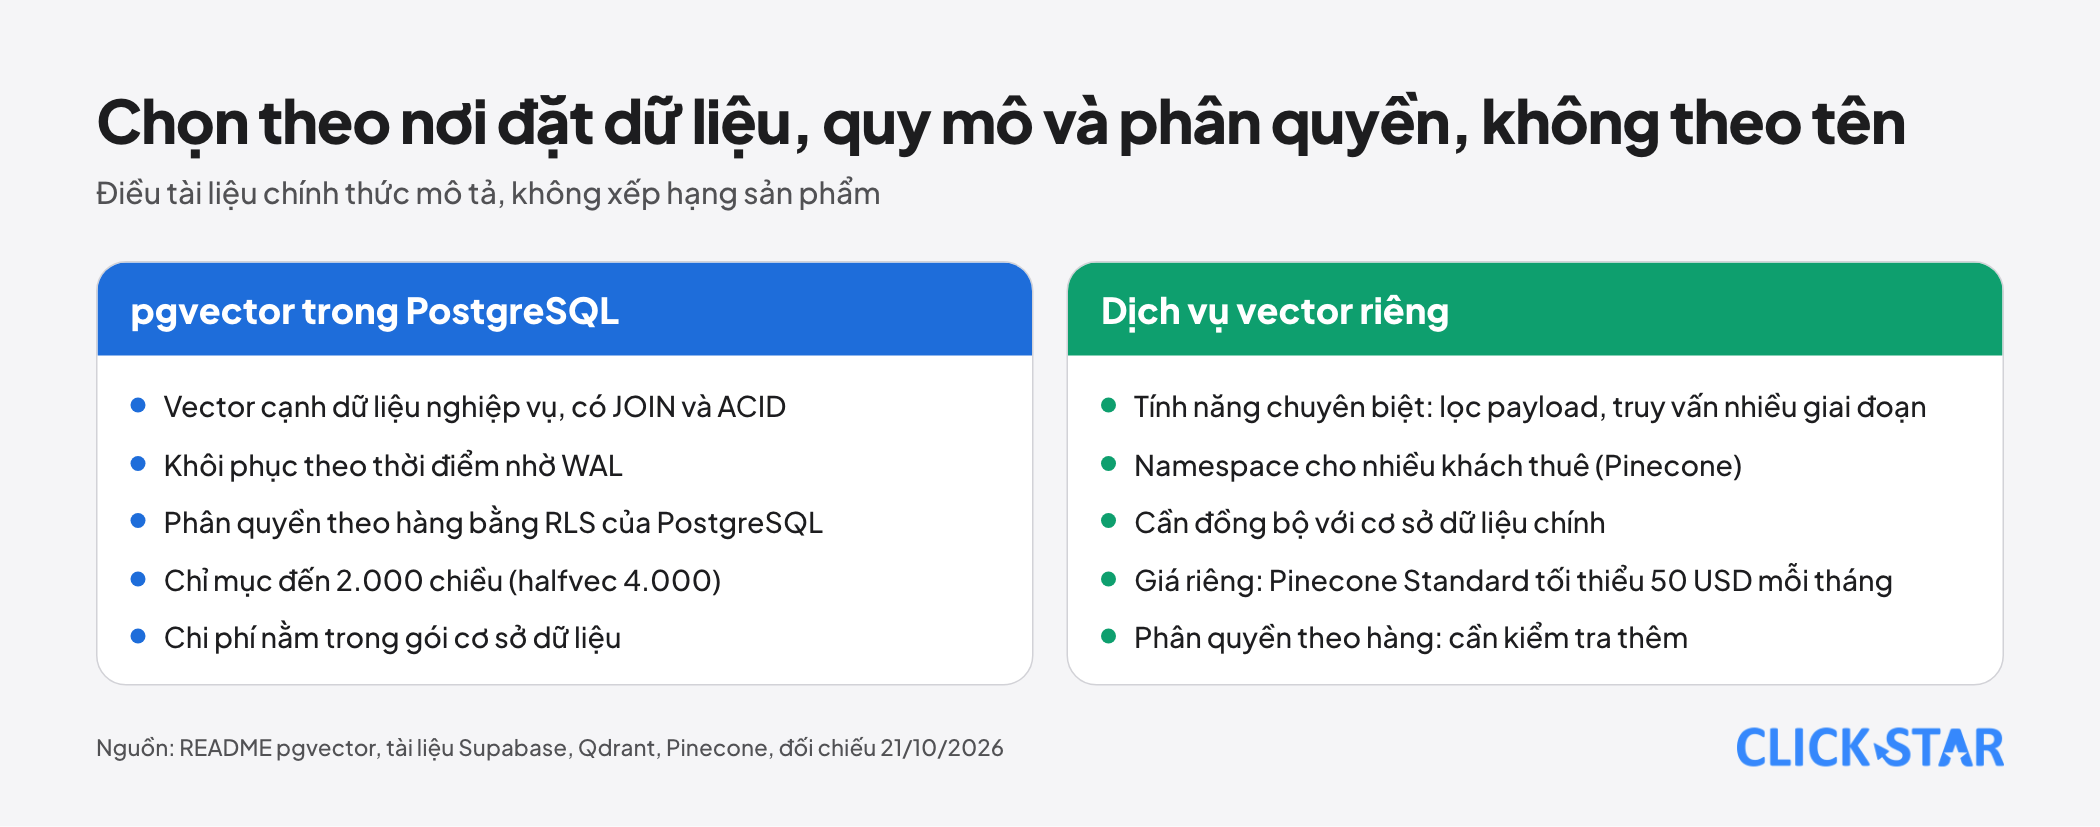
Khác biệt thực tế là nơi dữ liệu sống. Với pgvector, dòng nghiệp vụ và vector cùng cơ sở dữ liệu nên xóa khách hàng cùng vector làm trong 1 giao dịch (suy luận của Click Star từ ACID). Dịch vụ riêng cần quy trình đồng bộ, và lỗi đồng bộ khó thấy.
Đánh giá của Click Star. Nếu dữ liệu đã ở PostgreSQL và quy mô còn từ chục nghìn đến vài trăm nghìn vector, pgvector thường là điểm bắt đầu hợp lý: ít hệ thống hơn, 1 lớp phân quyền, 1 lịch sao lưu. Dịch vụ riêng đáng xem khi vector là sản phẩm chính, tải vượt 1 máy PostgreSQL, hoặc cần tính năng chuyên biệt.
Chi phí lấy từ trang giá chính thức
Giá dưới đây đọc ngày 21/10/2026 từ trang giá của từng hãng; mỗi hãng tính theo cách khác nên không so thẳng được.
- Supabase: Free 0 USD với 500 MB dữ liệu, dự án tạm dừng sau 1 tuần không hoạt động. Pro từ 25 USD mỗi tháng, gồm 8 GB đĩa, vượt thì 0,125 USD mỗi GB, kèm 10 USD tín dụng tính toán.
- Tính toán Supabase mỗi tháng: Micro 10 USD, Small 15 USD, Medium 60 USD, 2XL 410 USD.
- Pinecone: Starter miễn phí, Builder 20 USD cố định, Standard tối thiểu 50 USD, lưu trữ 0,33 USD mỗi GB mỗi tháng, cộng đơn vị đọc và ghi.
- Embedding: OpenAI ghi text-embedding-3-small khoảng 62.500 trang mỗi USD (800 token mỗi trang).
Dung lượng hay bị bỏ sót. Click Star tính từ công thức pgvector (chưa gồm chỉ mục): 100.000 vector 1536 chiều khoảng 615 MB, 1.000.000 vector khoảng 6,15 GB; như vậy 100.000 vector đã vượt 500 MB của gói Free Supabase. Dùng halfvec (2 × chiều + 8 byte) còn khoảng 3,08 GB.
Vận hành: nhúng lại, kích thước, sao lưu, phân quyền
Đổi mô hình là nhúng lại. Tài liệu Gemini API (đọc ngày 21/10/2026) viết không gian embedding của gemini-embedding-001 và gemini-embedding-2 không tương thích, nên nâng cấp cần nhúng lại toàn bộ. Supabase cũng viết so sánh embedding của các mô hình khác nhau cho kết quả vô nghĩa.
README pgvector cho cách giữ nhiều mô hình: kiểu vector không khai báo chiều, cột model_id và chỉ mục một phần cho từng mô hình, để nhúng song song rồi chuyển truy vấn. Rút số chiều giảm dung lượng, nhưng nếu rút thủ công, OpenAI nói phải chuẩn hóa lại độ dài.
Dữ liệu đổi thì vector phải đổi. Hướng dẫn embedding tự động của Supabase nêu rõ embedding có thể tạm lệch nội dung cho đến khi bản mới được tạo.
Sao lưu. README nói pgvector dùng WAL nên khôi phục tại thời điểm dùng được. Theo Supabase, Pro giữ 7 ngày sao lưu hằng ngày, Team 14 ngày, Enterprise đến 30 ngày; Free không có. PITR là add-on, 7 ngày khoảng 100 USD mỗi tháng, cần ít nhất gói Small.
Phân quyền theo hàng. Supabase yêu cầu bật RLS cho mọi bảng ở schema được mở ra, nên áp cả cho bảng vector. README cảnh báo dùng chung chỉ mục giữa nhiều khách có thể ảnh hưởng recall của nhau; hãy tách bằng phân vùng hoặc bảng riêng.
Việc nên làm: lộ trình 30 ngày
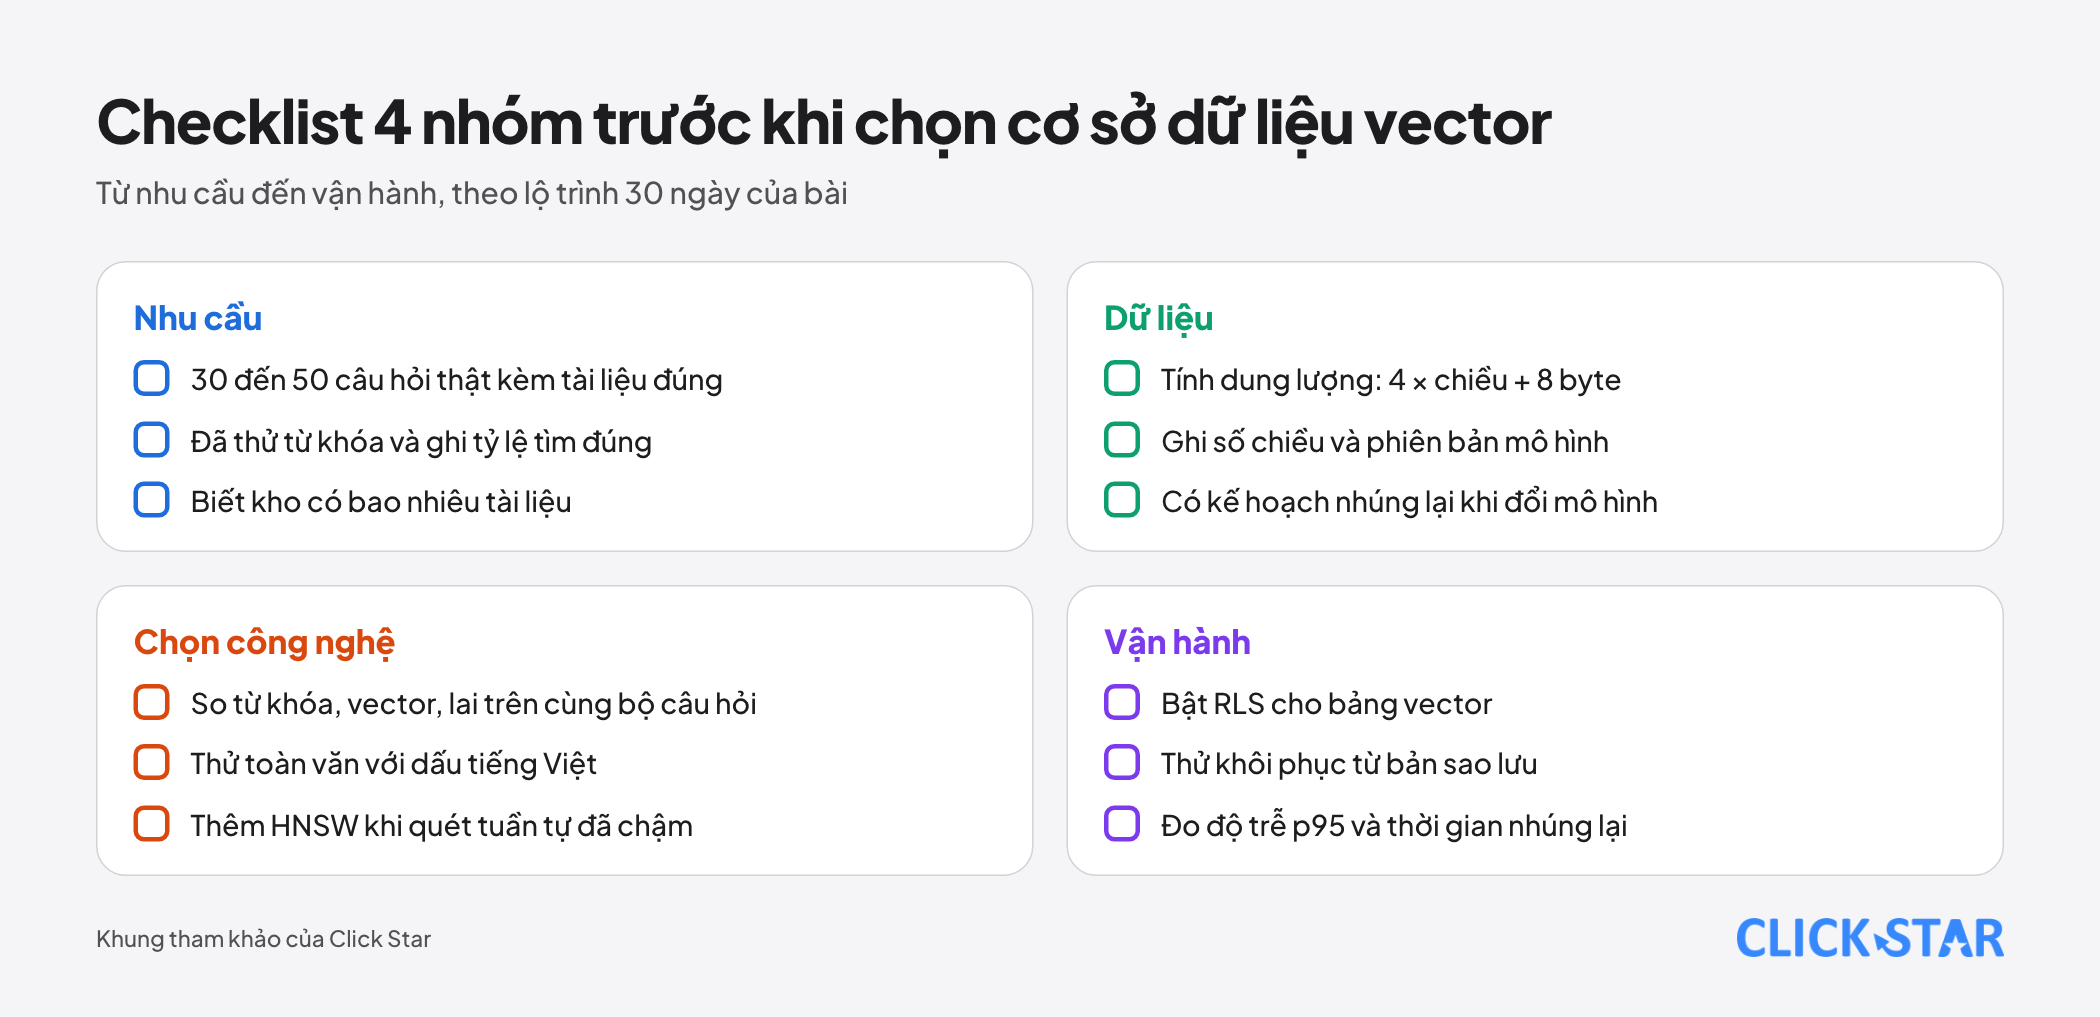
- Ngày 1 đến 5: viết 30 đến 50 câu hỏi thật, ghi tài liệu đúng cho từng câu.
- Ngày 6 đến 12: thử toàn văn PostgreSQL trên dữ liệu thật (có xử lý dấu), ghi tỷ lệ tìm đúng.
- Ngày 13 đến 20: bật pgvector trên bảng nhỏ với 1 mô hình embedding; ghi số chiều và phiên bản mô hình.
- Ngày 21 đến 25: thử tìm kiếm lai bằng RRF, so với từng phương pháp riêng; chỉ thêm HNSW khi quét tuần tự đã chậm.
- Ngày 26 đến 30: tính dung lượng, kiểm tra RLS, thử khôi phục sao lưu, rồi quyết định.
Cách đo: tỷ lệ câu hỏi mẫu tìm đúng ở top 5, độ trễ p95, dung lượng bảng và chỉ mục, thời gian nhúng lại cả kho.
Những sai lầm thường gặp
- Mua dịch vụ riêng trước khi có bộ câu hỏi mẫu chứng minh từ khóa không đủ.
- Bỏ lớp từ khóa nên không tìm ra mã sản phẩm hay tên riêng.
- Tạo IVFFlat khi bảng còn trống hoặc để probes mặc định 1.
- Lọc sau chỉ mục xấp xỉ mà không kiểm số kết quả trả về.
- Trộn embedding của 2 mô hình trong cùng chỉ mục.
- Không tính dung lượng vector rồi vượt giới hạn đĩa của gói.
- Để bảng vector ngoài RLS vì "chỉ là dữ liệu số".
Điều chưa biết
Click Star chưa tìm thấy số đo độc lập về chất lượng tìm kiếm vector tiếng Việt cho doanh nghiệp Việt Nam, và chưa có nguồn đã mở về cấu hình toàn văn PostgreSQL cho tiếng Việt. Mô hình embedding nào hợp cần thử bằng câu hỏi thật.
Click Star chưa chạy lại benchmark của Supabase và chưa có số so pgvector với từng dịch vụ riêng trên cùng tải. Số của Anthropic là của một hãng, năm 2024, chủ yếu tiếng Anh.
Click Star không thấy cơ chế tương đương RLS ở các dịch vụ riêng đã mở (Pinecone mô tả namespace và lọc metadata); phân quyền của Pinecone, Qdrant, Weaviate chưa được đọc kỹ, nên hãy kiểm tra trước khi chuyển dữ liệu nhạy cảm.
Bài liên quan



Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.