Dùng model AI đắt cho mọi việc? Cách định tuyến theo độ khó
Chia việc cho model AI theo độ khó có rẻ hơn thật không, chia bằng tín hiệu nào và đo ra sao. Bài dựa trên tài liệu chính thức của Anthropic và 1 bài nghiên cứu trên arXiv.
Một cửa hàng online dùng cùng 1 model AI cao cấp để trả lời mọi tin nhắn, từ câu "còn hàng không" đến khiếu nại hoàn tiền. Hóa đơn tăng dần, trong khi phần lớn tin nhắn chỉ cần câu trả lời ngắn. Đây là tình huống minh họa, không phải số đo thật.
Bài này dựa trên tài liệu của Anthropic, bài kỹ thuật "Building effective AI agents" và 1 bài nghiên cứu trên arXiv, đối chiếu đến ngày 04/11/2026. Mọi số về model là của Claude; bài chưa đối chiếu tài liệu của OpenAI hay Google.
Bài trả lời: chia việc theo độ khó có rẻ hơn thật không, chia bằng tín hiệu nào, và đo thế nào.
Điểm chính
- Định tuyến model là phân loại từng yêu cầu rồi gửi đến model phù hợp: việc dễ đi model nhỏ, việc khó đi model mạnh hơn.
- Giá đầu ra mỗi triệu token, đọc ngày 04/11/2026: Fable 5.1 là 50 USD, Opus 5.5 là 20 USD, Sonnet 5.5 là 10 USD, Haiku 5.5 là 0,50 USD (prompt đến 100.000 token).
- Nên so chi phí mỗi việc xong, không so theo token. Trong đo nội bộ của Anthropic, Opus 5.5 mức effort
lowtốn 0,12 USD mỗi việc giải xong, gần Sonnet 5.5 mặc định (0,11 USD). - Anthropic nói chỉnh effort thường là đòn bẩy tốt hơn đổi model. Thử rẻ rồi chạy lại phần hỏng chỉ hợp khi có cách kiểm kết quả.
- Số của Anthropic là đo nội bộ, chỉ mang tính định hướng. Chưa có số đo công khai cho tiếng Việt, nên cần bộ câu hỏi thử của chính doanh nghiệp.
- Model có ngày hết hạn và giá có thể đổi, nên tên model nằm trong cấu hình, không viết cứng trong mã.
Định tuyến model là gì và khi nào đáng làm
Định tuyến model (model routing) là bước phân loại mỗi yêu cầu trước khi chọn model xử lý. Tin nhắn hỏi giá đi model nhỏ, khiếu nại phức tạp đi model lớn.
Theo bài "Building effective AI agents" của Anthropic (đăng 19/12/2024, đọc 04/11/2026), routing hợp khi các nhóm việc tách bạch và việc phân loại làm chính xác được, bằng model hoặc thuật toán phân loại truyền thống. Ví dụ trong bài dùng Haiku 4.5 và Sonnet 4.5, đều không thuộc 4 model hiện hành.
RouteLLM (arXiv, 26/06/2024) huấn luyện bộ định tuyến chọn giữa model mạnh và yếu, báo giảm chi phí hơn 2 lần trong một số trường hợp mà không giảm chất lượng.
Tóm tắt không nêu model được thử và Click Star chỉ đọc phần tóm tắt, nên đây là hướng đi, không phải số để áp dụng.
Nhận định của Click Star: định tuyến đáng làm khi lưu lượng đủ lớn hoặc có 1 nhóm việc rất lặp; với vài chục yêu cầu mỗi ngày, công xây và bảo trì có thể lớn hơn tiền tiết kiệm.
4 model hiện hành: hãng mô tả việc gì và giá bao nhiêu
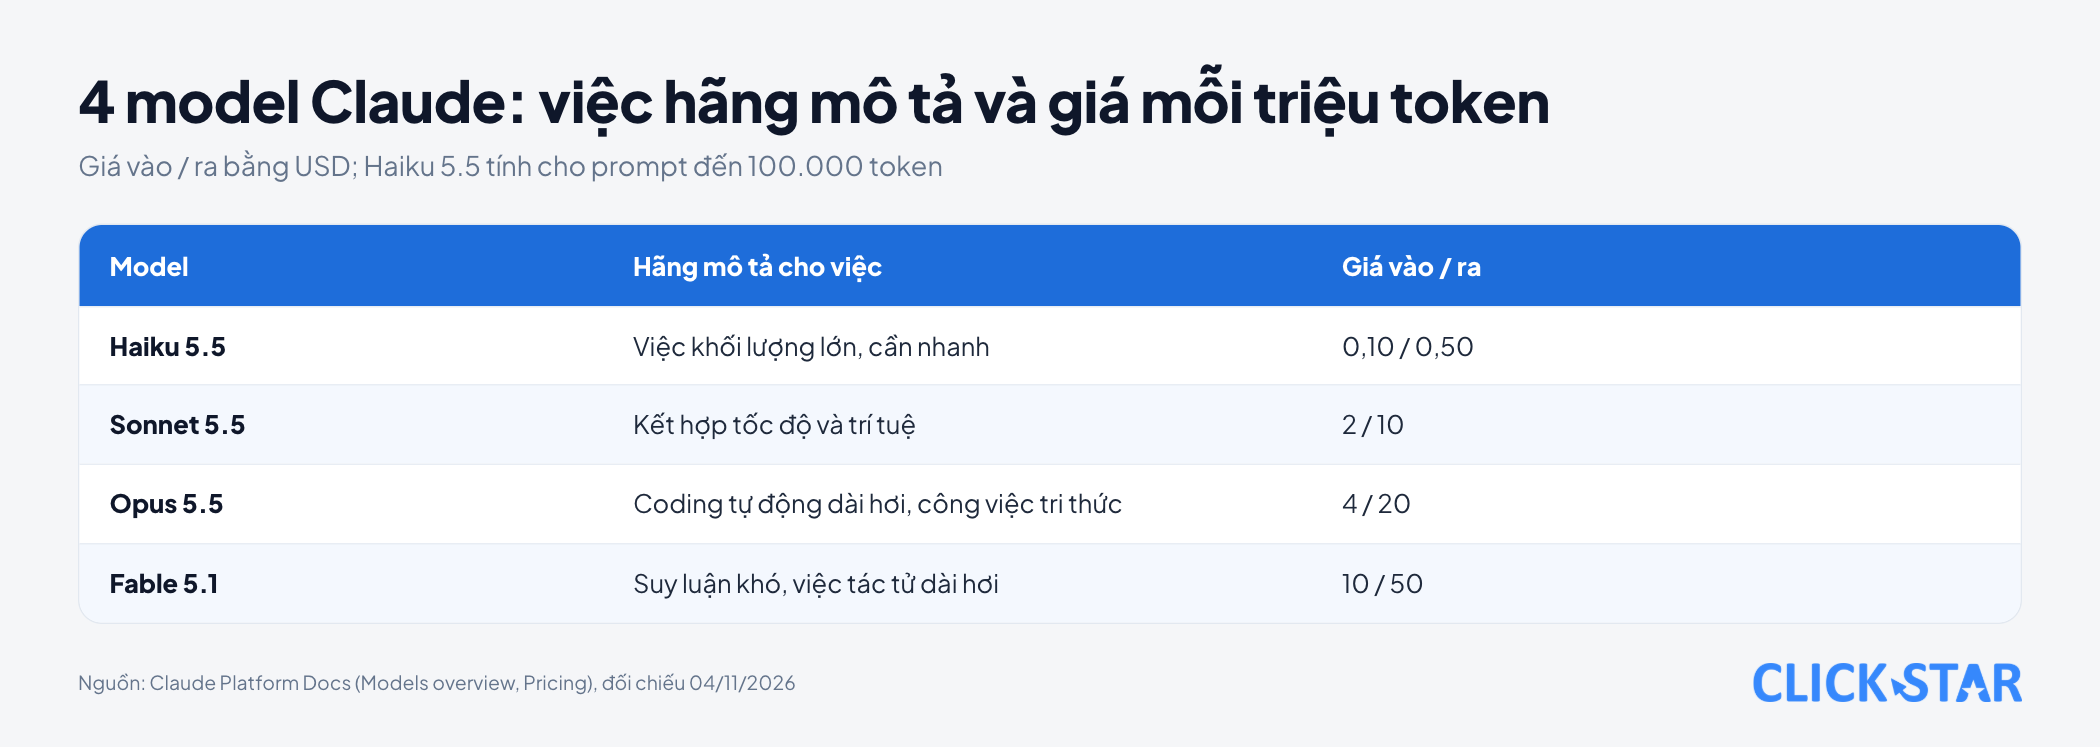
Theo trang "Models overview" (không ghi ngày, đọc 04/11/2026), cả 4 model đều có cửa sổ ngữ cảnh 1 triệu token. Mô tả của hãng, xếp từ rẻ đến đắt, giá mỗi triệu token:
- Haiku 5.5: việc khối lượng lớn, cần nhanh như phân loại, trích xuất, định tuyến; độ trễ thấp nhất. Giá 0,10 USD vào, 0,50 USD ra với prompt đến 100.000 token; prompt dài hơn tính 0,50 và 2,50 USD.
- Sonnet 5.5: kết hợp tốc độ và trí tuệ. Giá 2 USD vào, 10 USD ra.
- Opus 5.5: coding tự động dài hơi, công việc tri thức. Giá 4 USD vào, 20 USD ra.
- Fable 5.1: suy luận khó, việc tác tử (agentic) dài hơi, chậm hơn. Giá 10 USD vào, 50 USD ra.
Giá lấy từ trang "Pricing" (không ghi ngày, đọc 04/11/2026), trên Claude API. Token là đơn vị chữ mà model đọc và viết. Batch API giảm 50% cho việc không cần kết quả ngay; đọc bộ nhớ đệm bằng 10% giá vào (5% với Opus 5.5 và Sonnet 5.5, 2,5% với Fable 5.1).
Theo phép chia của Click Star, giá đầu ra của Fable 5.1 gấp 100 lần Haiku 5.5 ở prompt ngắn. Ví dụ minh họa, không phải số đo: 10.000 tin, mỗi tin 1.000 token vào và 300 token ra, hết 250 USD qua Fable 5.1 và 2,50 USD qua Haiku 5.5, chưa tính suy nghĩ, cache và chất lượng.
Giá theo token khác giá theo việc xong
Anthropic khuyên so chi phí trên mỗi việc hoàn thành, không so theo token. Các số dưới đây lấy từ trang "Optimizing for cost and intelligence" (không ghi ngày, đọc 04/11/2026), là đo nội bộ của Anthropic.
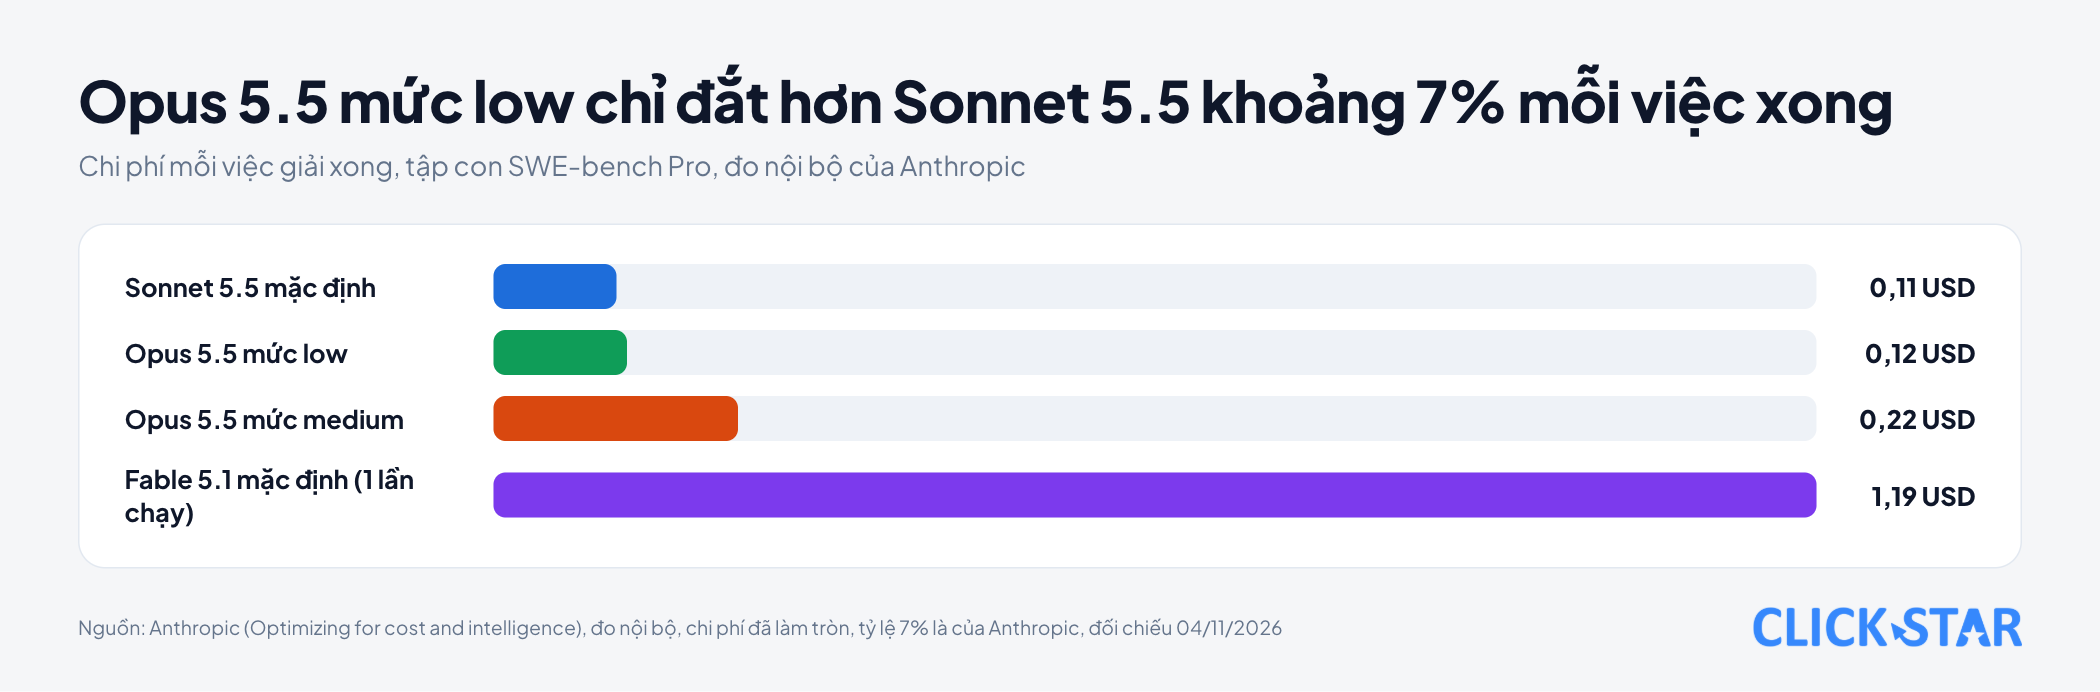
Trên tập con SWE-bench Pro (bộ bài kỹ thuật phần mềm; điểm không so được với bảng xếp hạng công khai), Sonnet 5.5 mặc định giải 87,6% việc với 0,11 USD mỗi việc giải xong. Opus 5.5 mức low giải 87,4% với 0,12 USD, mức medium giải 92,8% với 0,22 USD.
Fable 5.1 mặc định giải 92,3% (1 lần chạy) với 1,19 USD.
Opus 5.5 đắt gấp đôi Sonnet 5.5 trên mỗi token, nhưng ở mức low chỉ đắt hơn khoảng 7% mỗi việc giải xong, vì làm ít việc hơn cho mỗi tác vụ. Con số 7% là của Anthropic; chia 0,12 cho 0,11 ra khoảng 9%, có thể do chi phí hiển thị đã làm tròn.
Model nhỏ không luôn thua nhiều. Trên GPQA Diamond (câu hỏi khoa học bậc cao học), Haiku 5.5 đạt 85% so với 91% của Opus 5.5 và Sonnet 5.5, với chi phí mỗi câu đúng khoảng 1/20 của Opus 5.5 và 1/10 của Sonnet 5.5.
Model đắt hơn mua được bao nhiêu thì tùy việc. Ở nghiên cứu sâu DeepResearch Bench II (45 tác vụ), Opus 5.5 hơn Sonnet 5.5 2,6 điểm với 1,5 lần chi phí, Fable 5.1 hơn 6,0 điểm với 5,8 lần; tính cả 50 tác vụ, Anthropic nói cả hai chưa hơn Sonnet 5.5 một cách đo được.
Chia việc theo độ khó: khung 3 tầng của Click Star
Trang "Choosing the right model" (không ghi ngày, đọc 04/11/2026) nêu 2 cách khởi đầu. Cách thứ nhất bắt đầu từ Haiku 5.5 và chỉ nâng khi thiếu, hợp việc khối lượng lớn, đơn giản.
Cách thứ hai bắt đầu từ Opus 5.5 rồi hạ dần; còn thiếu ở xhigh hoặc max thì chuyển sang Fable 5.1.
Trang này nói phần lớn khối lượng việc nên bắt đầu từ Opus 5.5. Khung 3 tầng dưới đây khác mặc định đó. Đây là khung tham khảo của Click Star, không lấy từ nguồn ngoài và chưa chạy thử trên dữ liệu thật.
- Tầng 1, model nhỏ (Haiku 5.5): phân loại, gắn nhãn, trích trường dữ liệu, trả lời câu hỏi thường gặp từ tài liệu có sẵn.
- Tầng 2, model tầm trung (Sonnet 5.5): soạn thư trả lời, tóm tắt, phân tích vừa phải, có người duyệt trước khi gửi.
- Tầng 3, model lớn (Opus 5.5, Fable 5.1 khi cần): suy luận nhiều bước, việc có hệ quả cao, việc tầng dưới đã hỏng.
Tín hiệu để chia việc (cũng là khung của Click Star), ngoài loại việc:
- Kiểm được không: có quy tắc hoặc đáp án mẫu thì cho thử tầng rẻ trước.
- Hậu quả nếu sai: liên quan tiền, hoàn tiền hay cam kết pháp lý thì lên tầng cao hoặc cần người duyệt.
- Độ dài và số bước: đầu vào dài, nhiều bước thì lên tầng.
- Độ tin cậy do model tự báo: chỉ là tín hiệu yếu; Click Star chưa đọc nguồn nào chứng minh nó đủ chuẩn, nên cần hiệu chỉnh bằng bộ câu hỏi thử.
Các mẫu ghép model: định tuyến, leo thang và cố vấn
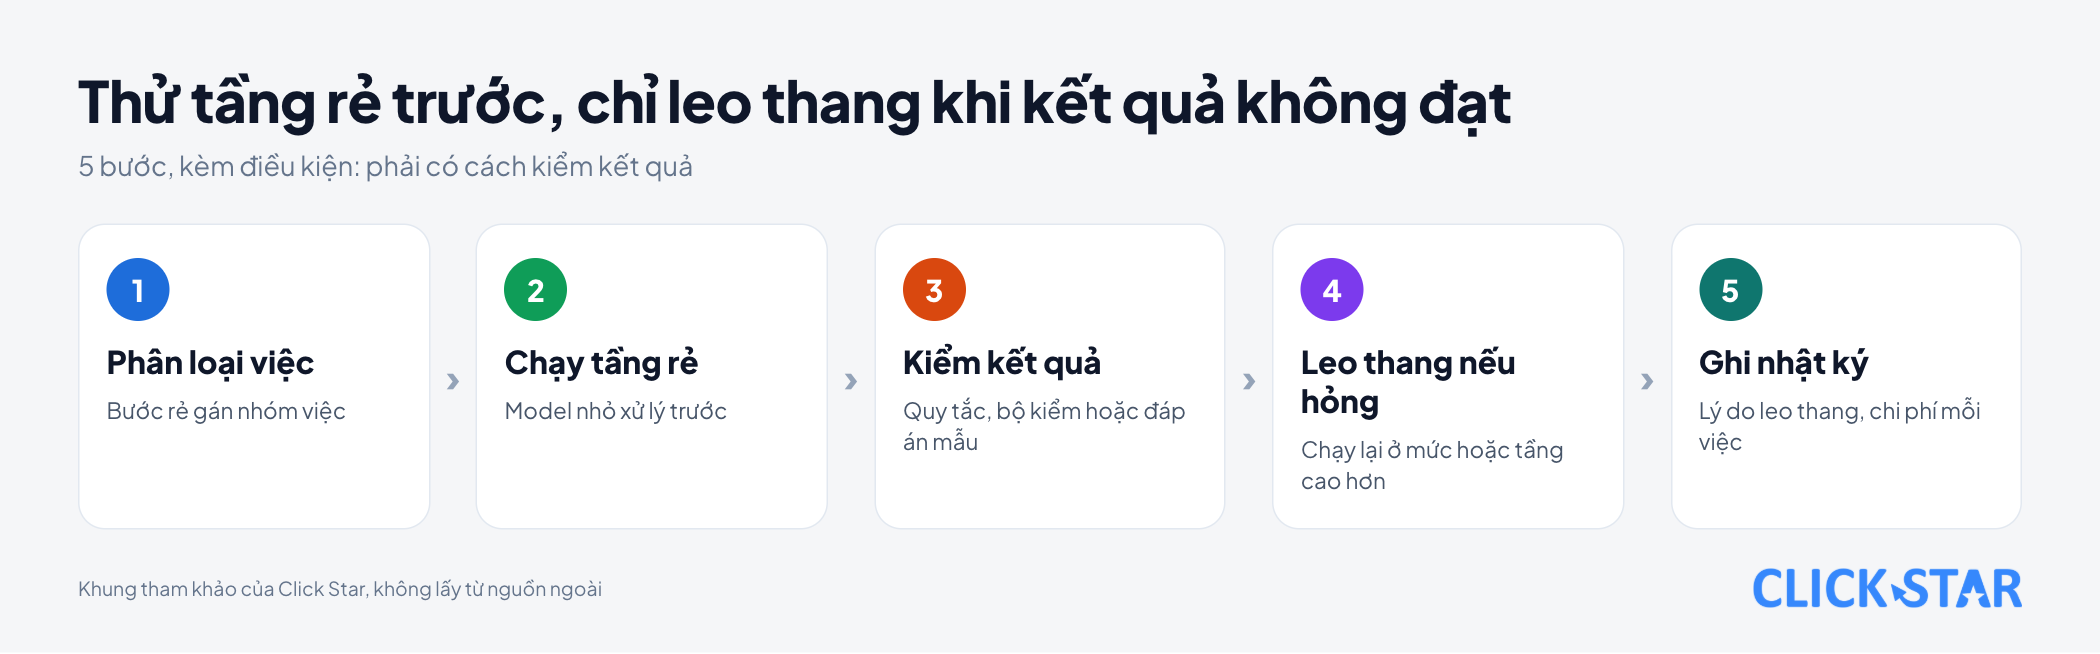
Định tuyến trước. Bước phân loại rẻ gán nhóm việc, rồi mỗi nhóm đi đúng tầng. Phân loại sai thì cả luồng sai.
Leo thang. Chạy tầng rẻ, kiểm kết quả, chỉ chạy lại phần hỏng ở mức cao hơn. Ở đây "mức" là effort, tham số điều khiển lượng token model dùng khi trả lời, gồm cả suy nghĩ và gọi công cụ (trang "Effort", không ghi ngày, đọc 04/11/2026: 5 mức từ low đến max).
Anthropic đo trên Opus 5.5 (SWE-bench Pro): chạy low giải 87,4%, tức 13% việc hỏng; chạy lại phần hỏng ở high giải khoảng 97% với khoảng 0,17 USD mỗi việc, so với 95,3% và 0,29 USD khi chạy tất cả ở high.
Điều kiện: phải có tín hiệu hỏng đáng tin (ở đây là bộ kiểm thử), và việc hỏng tốn thời gian của 2 lượt chạy. Phép đo đổi effort của cùng 1 model; áp cho 2 model khác nhau là suy luận của Click Star.
Nên thử mỗi mức trong phiên riêng. Trang "Prompt caching" (không ghi ngày, đọc 04/11/2026) nói đổi tham số effort cấp cao nhất giữa chừng làm mất bộ nhớ đệm, tức phần prompt đã xử lý được dùng lại với giá rẻ hơn.
Trang "Effort" (đọc 04/11/2026) nói tính năng beta đổi effort theo từng tin nhắn vẫn giữ bộ nhớ đệm, có trên Claude API với cả 4 model hiện hành, cần header beta.
Cố vấn. Model nhỏ làm chính và hỏi model lớn khi bí (công cụ "Advisor tool", bản beta, không ghi ngày, đọc 04/11/2026). Cố vấn chỉ có thể giúp khi model chính hỏi.
Ở GPQA Diamond, cố vấn không được hỏi lần nào trong 198 câu. Ở bộ coding được thử, cặp model chính cộng cố vấn hơn 1,7 điểm (sát mức nhiễu giữa các lần chạy) với 2,1 lần chi phí. Ở Chartography (bộ bài đọc biểu đồ), cặp đó thấp hơn model chính chạy riêng 7 điểm, ngoài mức nhiễu, và cố vấn được hỏi ở 1 trong 300 tác vụ.
Đo trước khi hạ model
Trang "Choosing the right model" nói bộ kiểm thử riêng là bước quan trọng nhất.
Phương pháp 4 bước của Anthropic trên trang "Optimizing for cost and intelligence":
- Lấy mẫu từ log thật, viết kiểm tra kết quả và ghi chi phí mỗi việc.
- Đo các tầng model ở nhiều mức effort, vẽ điểm số theo chi phí.
- Chỉ khi đường cong còn khoảng trống mới thêm chiến lược nhiều model.
- Chạy thử song song (shadow) trên 1 phần lưu lượng trước khi chuyển hẳn.
Chỉ số theo dõi (khung của Click Star): tỷ lệ qua kiểm, chi phí mỗi việc xong, tỷ lệ leo thang, thời gian của nhóm lượt chậm nhất. Mẫu thử nên có tin nhắn tiếng Việt thật (không dấu, viết tắt), đã che thông tin cá nhân.
Rủi ro: model hết hạn, giá đổi và các bẫy riêng
Theo trang "Model deprecations" (không ghi ngày, đọc 04/11/2026), Anthropic báo trước ít nhất 60 ngày khi ngừng model đã phát hành công khai. Ví dụ, ngày 30/09/2026 hãng thông báo Sonnet 4.5 ngừng trên Claude API từ 30/11/2026.
Mốc dự kiến "không sớm hơn" trên nền tảng Anthropic vận hành: Fable 5.1 ngày 01/09/2027, Opus 5.5 ngày 22/09/2027, Sonnet 5.5 ngày 28/09/2027, Haiku 5.5 ngày 07/10/2027.
Với Haiku 5.5, trang "What's new in Claude Haiku 5.5" (không ghi ngày, đọc 04/11/2026) nêu: suy nghĩ (thinking) bật mặc định và tính vào max_tokens, nên giới hạn nhỏ có thể dừng trước khi có chữ trả lời.
Điều này có nghĩa gì với doanh nghiệp Việt Nam
Đánh giá của Click Star. Với phần lớn doanh nghiệp vừa và nhỏ, bước đầu hợp lý là 2 tầng: model nhỏ cho phân loại và trích xuất kiểm được, model tầm trung cho phần còn lại, kèm người duyệt.
Tầng cao chỉ nên bật cho nhóm việc mà bộ câu hỏi thử cho thấy tầng dưới không đủ.
Click Star có dịch vụ tích hợp AI và AI automation nên có lợi ích liên quan; nhận định trên là nhận định kỹ thuật.
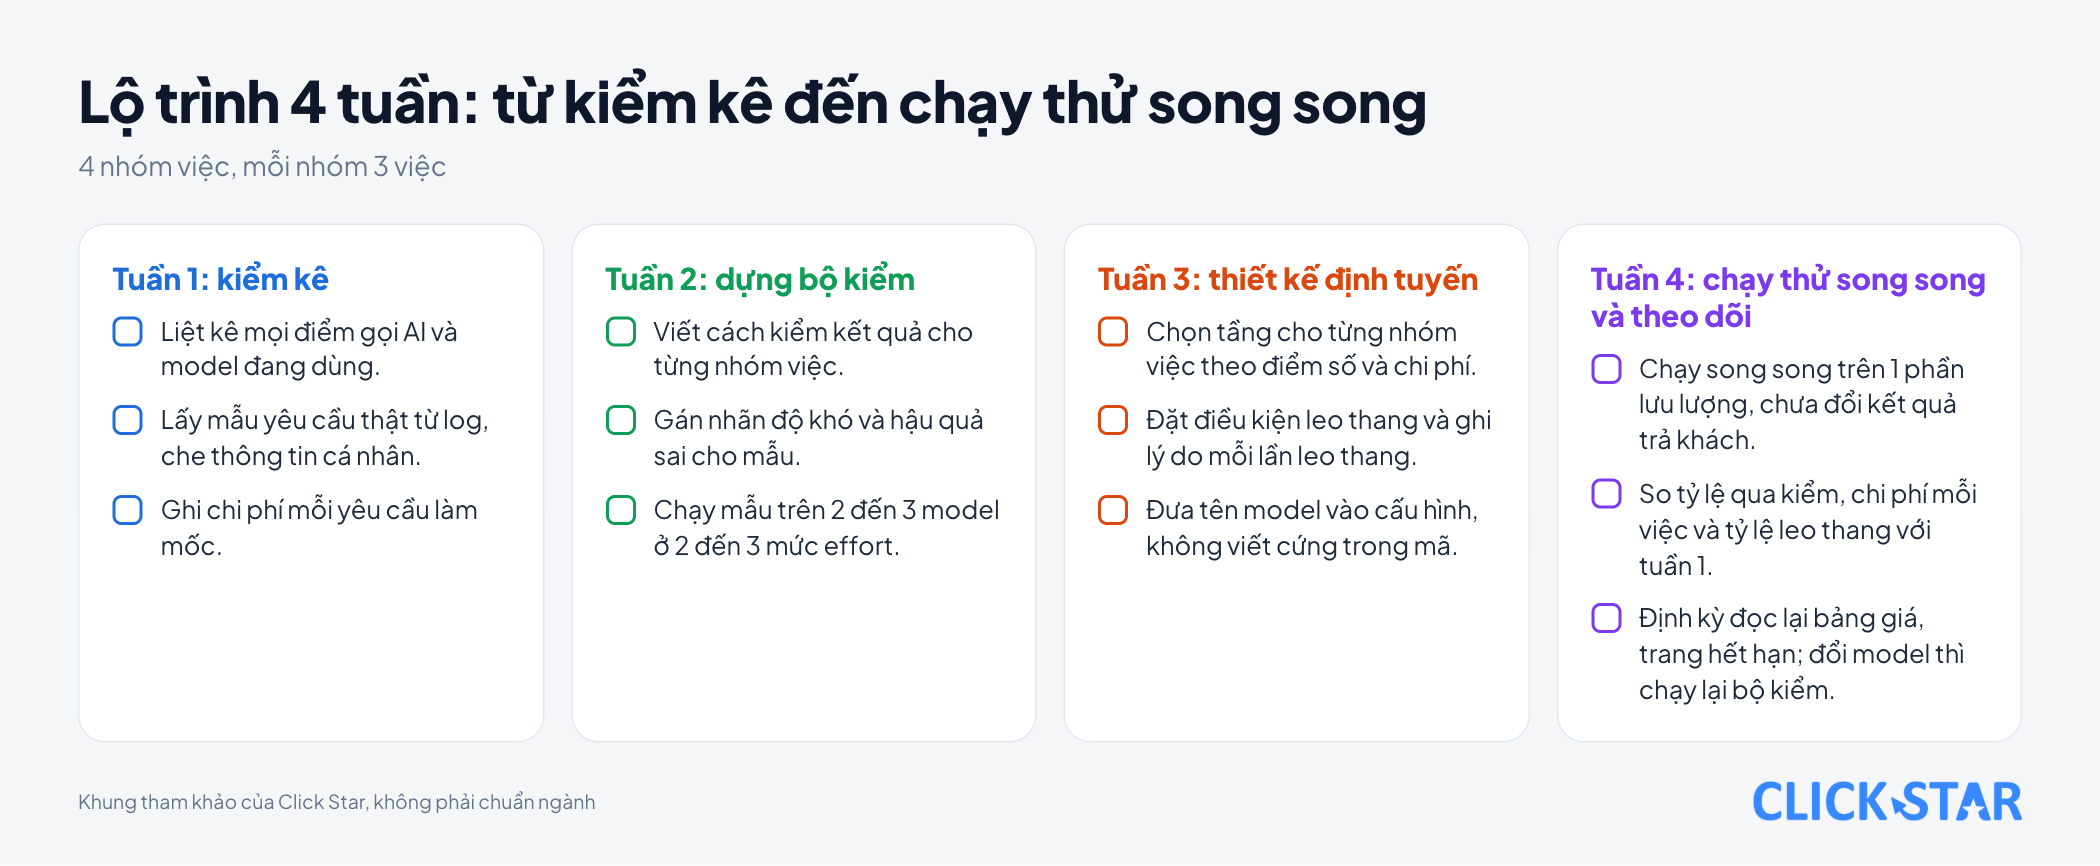
Việc nên làm: lộ trình 4 tuần
Lộ trình tham khảo của Click Star, không phải chuẩn ngành.
Tuần 1: kiểm kê
- Liệt kê mọi điểm gọi AI và model đang dùng.
- Lấy mẫu yêu cầu thật từ log, che thông tin cá nhân.
- Ghi chi phí mỗi yêu cầu làm mốc.
Tuần 2: dựng bộ kiểm
- Viết cách kiểm kết quả cho từng nhóm việc.
- Gán nhãn độ khó và hậu quả sai cho mẫu.
- Chạy mẫu trên 2 đến 3 model ở 2 đến 3 mức effort.
Tuần 3: thiết kế định tuyến
- Chọn tầng cho từng nhóm việc theo điểm số và chi phí.
- Đặt điều kiện leo thang và ghi lý do mỗi lần leo thang.
- Đưa tên model vào cấu hình, không viết cứng trong mã.
Tuần 4: chạy thử song song và theo dõi
- Chạy song song trên 1 phần lưu lượng, chưa đổi kết quả trả khách.
- So tỷ lệ qua kiểm, chi phí mỗi việc và tỷ lệ leo thang với tuần 1.
- Định kỳ đọc lại bảng giá, trang hết hạn; đổi model thì chạy lại bộ kiểm.
Những sai lầm thường gặp
- So model theo giá mỗi token, không theo chi phí mỗi việc xong.
- Hạ model mà không có bộ kiểm riêng của mình.
- Dùng độ tin cậy model tự báo làm tín hiệu leo thang duy nhất.
- Leo thang khi không có cách kiểm, nên không biết việc nào hỏng.
- Đổi tham số effort cấp cao nhất giữa chừng hội thoại đang dùng bộ nhớ đệm.
- Viết cứng tên model trong mã, quên ngày hết hạn.
- Coi số đo nội bộ của hãng là cam kết cho dữ liệu tiếng Việt.
Điều chưa biết
Chưa có số đo công khai về chất lượng từng model Claude trên tiếng Việt; các bài đo của Anthropic là nội bộ, chủ yếu về coding và nghiên cứu.
Chưa rõ leo thang giữa 2 model khớp bao nhiêu với phép đo đổi effort của cùng 1 model, và đổi model giữa chừng có dùng lại được bộ nhớ đệm không. Ví dụ 10.000 tin nhắn là minh họa; khung 3 tầng và lộ trình chưa chạy thử.
Bài liên quan



Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.