Xử lý hàng nghìn bản ghi bằng AI theo lô rẻ hơn bao nhiêu?
Gọi AI theo lô thường được tính bằng 50% giá gọi thông thường, đổi lại kết quả đến sau. Bài dựa trên tài liệu của Anthropic, OpenAI và Google, nêu việc nào hợp, giới hạn và cách thiết kế an toàn.
Một cửa hàng online có 10.000 phản hồi của khách trong quý và muốn gắn nhãn từng phản hồi: giao hàng, tư vấn, giá hay khác. Không ai cần kết quả trong vài giây, nhưng gọi AI từng bản ghi một thì vừa chậm vừa tốn.
Bài này dựa trên 6 trang tài liệu của Anthropic, trang Batch API của OpenAI và trang Batch API của Google cho Gemini, đối chiếu đến ngày 04/11/2026.
Điểm chính
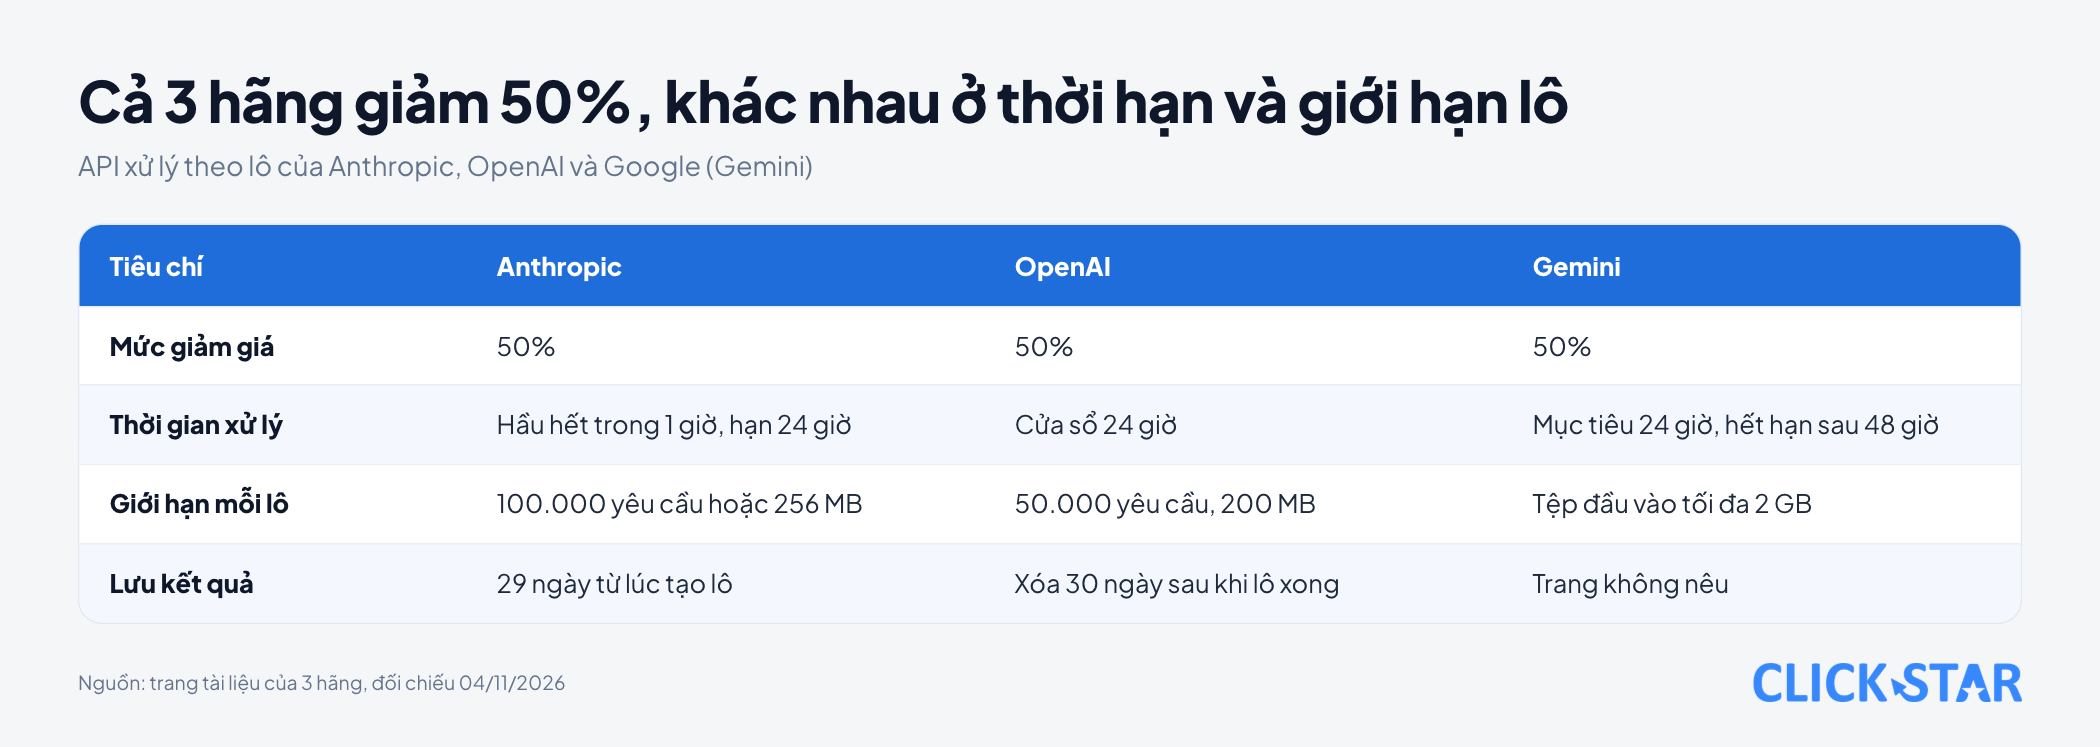
- Xử lý theo lô (batch) là gửi nhiều yêu cầu AI cùng lúc và nhận kết quả sau. Cả 3 hãng đã đọc đều nêu mức giá bằng 50% giá gọi thông thường.
- Với Anthropic, mức 50% áp cho cả token (đơn vị văn bản model dùng để tính tiền) đầu vào lẫn đầu ra (trang Pricing, đọc 04/11/2026).
- Thời gian: Anthropic nói hầu hết lô xong trong 1 giờ với hạn 24 giờ. OpenAI đặt cửa sổ 24 giờ; Google đặt mục tiêu 24 giờ và cho lô hết hạn sau 48 giờ.
- Kết quả có thể không theo thứ tự gửi nên phải ghép bằng
custom_id. Theo Anthropic, yêu cầu lỗi, bị hủy hoặc hết hạn không bị tính tiền. - Anthropic ghi dữ liệu lô được lưu tối đa 29 ngày kể từ lúc tạo lô và không thuộc diện không lưu dữ liệu, nên hãy bỏ thông tin cá nhân không cần thiết trước khi gửi.
Xử lý theo lô là gì và việc nào hợp với nó
Xử lý theo lô giống gửi 1 xấp hồ sơ cho văn thư làm trong đêm, thay vì đứng chờ từng hồ sơ ở quầy.
Anthropic nêu các việc hợp như đánh giá quy mô lớn, kiểm duyệt nội dung, phân tích dữ liệu. Click Star diễn giải thành các việc như gắn nhãn phản hồi hoặc phiếu hỗ trợ, tóm tắt hồ sơ cũ, trích dữ liệu từ hóa đơn lịch sử và chấm bộ câu hỏi thử cho chatbot.
Cách này không hợp khi khách đang chờ, như chatbot trên website. Cũng không hợp khi bước sau cần kết quả bước trước trong cùng 1 lần chạy, vì mỗi yêu cầu trong lô xử lý độc lập.
Khung 4 câu hỏi (khung tham khảo của Click Star, không lấy từ nguồn ngoài). Việc chạy theo lô được khi cả 4 câu trả lời là "có":
- Kết quả đến sau vài giờ, thậm chí gần 24 giờ, mà không ai bị chậm việc?
- Mỗi bản ghi xử lý độc lập, không cần kết quả của bản ghi khác?
- Chấp nhận việc 1 phần bản ghi lỗi hoặc hết hạn rồi chạy lại?
- Dữ liệu được phép nằm trên máy chủ nhà cung cấp đến 29 ngày (với Anthropic)?
Message Batches API của Anthropic hoạt động thế nào
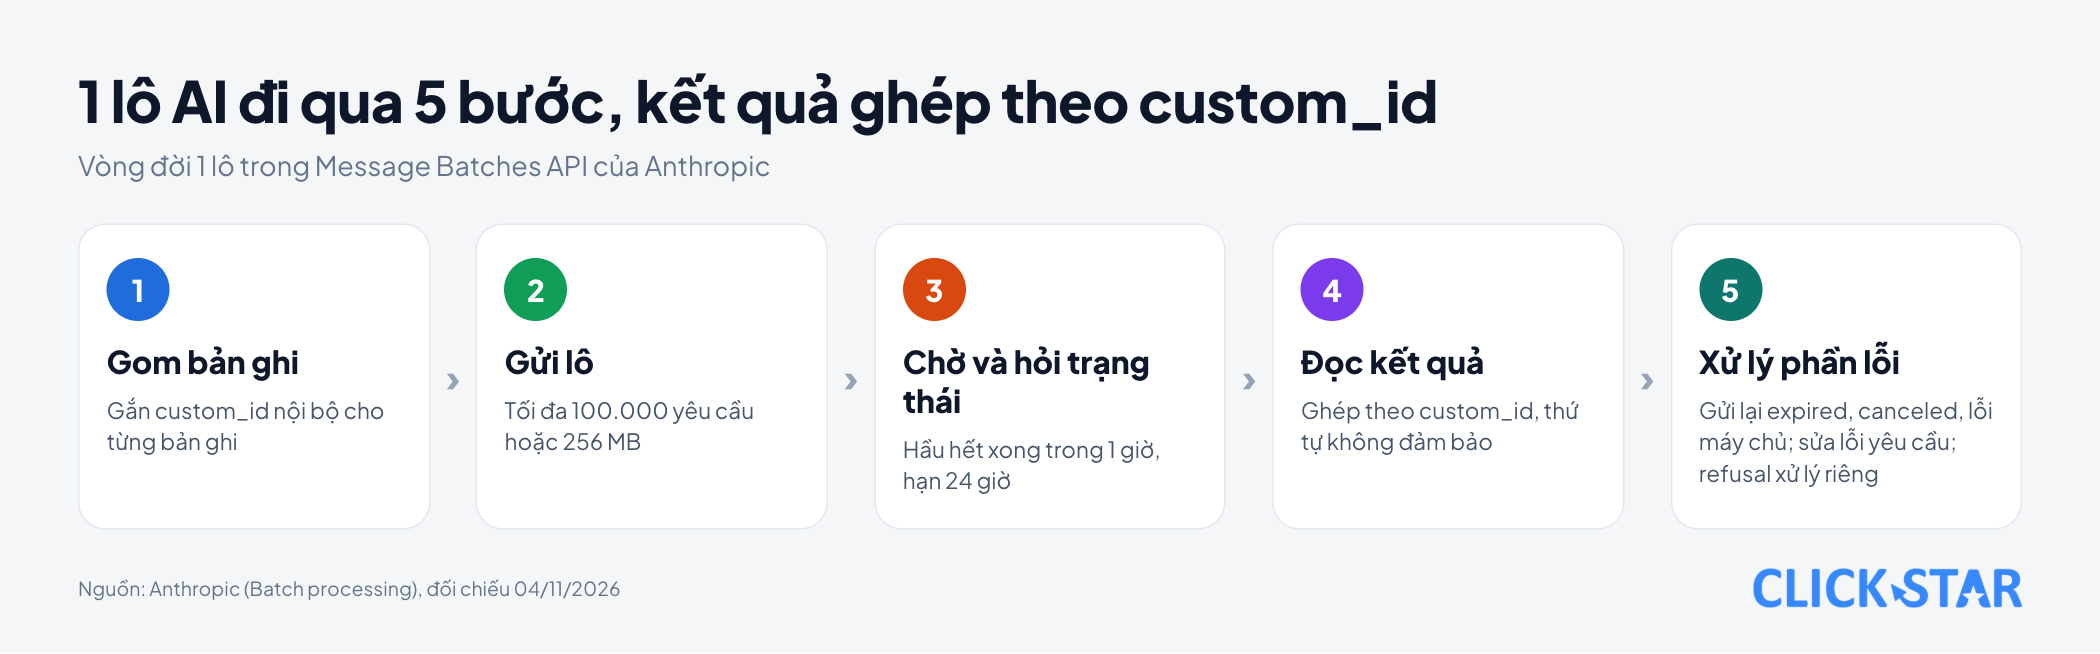
Anthropic cho gửi tối đa 100.000 yêu cầu hoặc 256 MB trong 1 lô, tùy giới hạn nào chạm trước. Theo trang Batch processing (không ghi ngày, đọc 04/11/2026), hầu hết lô xong trong 1 giờ và lô hết hạn nếu chưa xong sau 24 giờ; khi nhu cầu cao, xử lý có thể chậm hơn.
Mỗi yêu cầu gồm custom_id (mã bạn đặt, 1 đến 64 ký tự gồm chữ, số, gạch ngang, gạch dưới) và params (tham số như lệnh gọi Messages API thường). custom_id ghép kết quả về đúng bản ghi.
4 kết quả có thể xảy ra
Mỗi yêu cầu kết thúc ở 1 trong 4 trạng thái:
succeeded: có kết quả.errored: lỗi, không bị tính tiền. Lỗiinvalid_request_errorphải sửa rồi gửi lại; lỗi máy chủ thì gửi lại nguyên văn.canceled: bị hủy trước khi gửi tới model, không tính tiền.expired: hết 24 giờ trước khi gửi tới model, không tính tiền.
Có 1 điểm dễ sót: theo trang Refusals and fallback (không ghi ngày, đọc 04/11/2026), yêu cầu bị model từ chối vẫn trả về succeeded kèm stop_reason là refusal, nên phải kiểm cả hai trường.
Giới hạn cần biết trước
- Không dùng được
stream: true,speed(Fast mode),fallbacksvàmax_tokens: 0. - Lỗi tham số chỉ báo khi cả lô kết thúc. Lô đã gửi không sửa được, chỉ hủy và gửi lại.
- Hàng đợi chứa tối đa 200.000 yêu cầu ở bậc Start và 500.000 ở bậc Scale (trang Rate limits, không ghi ngày, đọc 04/11/2026).
Gọi theo lô rẻ hơn bao nhiêu
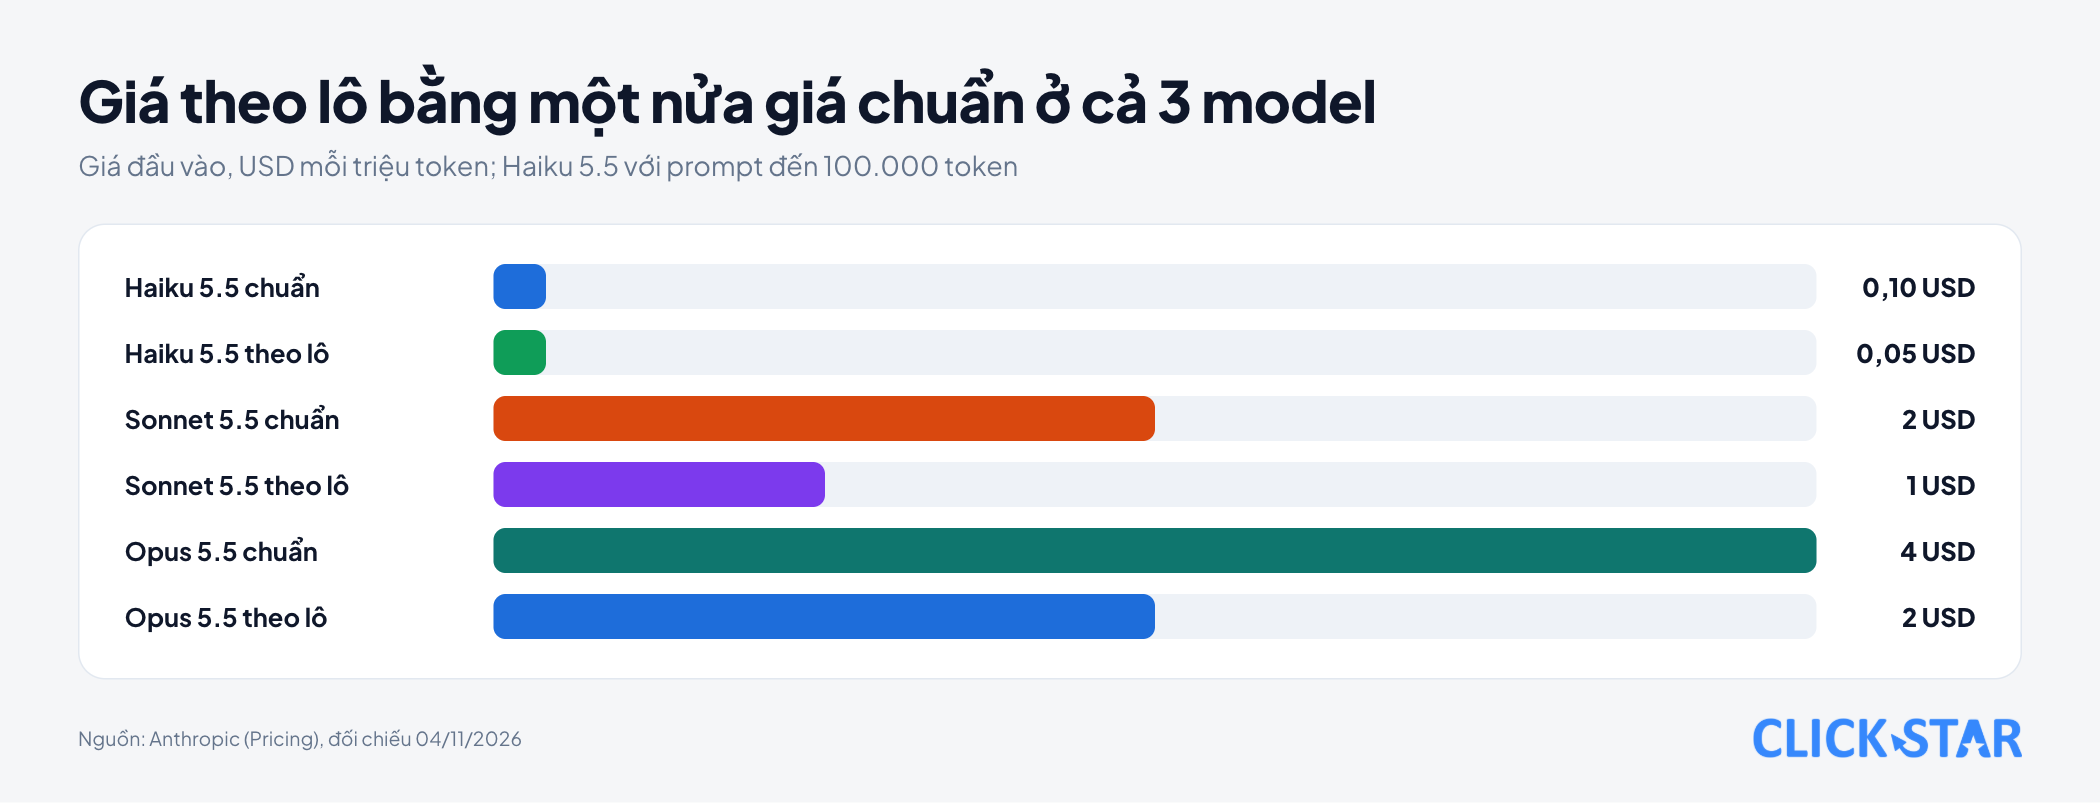
Theo trang Pricing của Anthropic (không ghi ngày, đọc 04/11/2026), lô tính 50% giá chuẩn cho cả token đầu vào và đầu ra, bằng USD mỗi triệu token, trên Claude API.
Với giá đầu vào, Haiku 5.5 (prompt, tức nội dung gửi cho model, đến 100.000 token) là 0,10 USD chuẩn và 0,05 USD theo lô. Sonnet 5.5 là 2 và 1 USD; Opus 5.5 là 4 và 2 USD.
Ví dụ minh họa, không phải số đo: với 10.000 phản hồi đó, mỗi phản hồi 300 token vào và 20 token ra, tức 3 triệu token vào và 0,2 triệu token ra. Haiku 5.5 tốn 0,40 USD gọi thường và 0,20 USD theo lô; Sonnet 5.5 tốn 8 và 4 USD; Opus 5.5 tốn 16 và 8 USD.
Click Star đã có bài riêng về các model Claude và cách chọn.
Kết hợp với prompt caching
Khi nhiều yêu cầu chung 1 phần đầu dài, prompt caching (lưu sẵn phần đầu prompt) giúp không trả đủ giá cho phần lặp. Theo trang Pricing, hệ số giá của caching cộng dồn với mức giảm của lô.
Theo trang Batch processing, lượt trúng trong lô không được đảm bảo vì yêu cầu chạy song song; người dùng thường thấy 30% đến 98%.
Trang Prompt caching (không ghi ngày, đọc 04/11/2026) mô tả cách tiết kiệm nhất: gửi trước 1 lô chỉ có 1 yêu cầu mang phần đầu chung với bộ nhớ 1 giờ, đợi xong rồi mới gửi phần còn lại. Phần đầu phải dài tối thiểu 512 token với Haiku 5.5, Sonnet 5.5 và Opus 5.5.
OpenAI và Google: cùng ý tưởng, khác chi tiết
Trang Batch API của OpenAI (không ghi ngày, đọc 04/11/2026) nêu mức giảm 50%, nhóm giới hạn tốc độ riêng và cửa sổ 24 giờ. Mỗi lô tối đa 50.000 yêu cầu và 200 MB; OpenAI xóa tệp kết quả 30 ngày sau khi lô hoàn tất.
Trang Batch API của Google cho Gemini (không ghi ngày, đọc 04/11/2026) nêu mức 50% và mục tiêu 24 giờ. Lô chờ hoặc chạy quá 48 giờ chuyển sang hết hạn và không có kết quả; tệp đầu vào tối đa 2 GB.
Google lưu ý lệnh tạo lô không idempotent: 2 lệnh sẽ thành 2 lô riêng.
Ví dụ mã: tạo lô và đọc kết quả
Ví dụ dùng Python SDK của Anthropic để gắn nhãn phản hồi, theo mẫu trong trang Batch processing.
Theo trang Prompting Claude Haiku 5.5 (không ghi ngày, đọc 04/11/2026), Haiku 5.5 bật thinking mặc định và thinking tính vào max_tokens, nên mã tắt thinking. Nếu bật, hãy nâng max_tokens và tính lại chi phí.
Click Star đã chạy đoạn đọc kết quả với kiểu dữ liệu của SDK anthropic 0.125.0 và dữ liệu giả, gồm cả kết quả không có khối văn bản.
import time
import anthropic
from anthropic.types.message_create_params import MessageCreateParamsNonStreaming
from anthropic.types.messages.batch_create_params import Request
client = anthropic.Anthropic()
SYSTEM = "Phân loại phản hồi vào đúng 1 nhãn: giao_hang, tu_van, gia, khac. Chỉ trả về nhãn."
rows = [("fb-0001", "Đơn đến trễ 3 ngày so với hẹn"), ("fb-0002", "Nhân viên tư vấn rất tận tình")]
batch = client.messages.batches.create(requests=[
    Request(custom_id=row_id, params=MessageCreateParamsNonStreaming(
        model="claude-haiku-5-5", max_tokens=20, system=SYSTEM,
        thinking={"type": "disabled"},  # Haiku 5.5 bật thinking mặc định
        messages=[{"role": "user", "content": text}]))
    for row_id, text in rows])
while client.messages.batches.retrieve(batch.id).processing_status != "ended":
    time.sleep(60)
LABELS = {"giao_hang", "tu_van", "gia", "khac"}
labels, to_retry, to_fix, to_fallback = {}, [], [], []
for item in client.messages.batches.results(batch.id):
    res = item.result
    if res.type == "succeeded":
        msg = res.message
        text = next((b.text for b in msg.content if b.type == "text"), "").strip()
        if msg.stop_reason == "refusal":
            to_fallback.append(item.custom_id)  # bị từ chối: đổi model hoặc đổi nội dung
        elif msg.stop_reason == "max_tokens" or text not in LABELS:
            to_fix.append(item.custom_id)  # đầu ra không dùng được: xem lại lệnh
        else:
            labels[item.custom_id] = text
    elif res.type == "errored" and res.error.error.type == "invalid_request_error":
        to_fix.append(item.custom_id)  # lỗi yêu cầu: sửa rồi mới gửi lại
    else:
        to_retry.append(item.custom_id)  # expired, canceled, lỗi máy chủ: gửi lại nguyên văn
print(len(labels), "xong;", len(to_retry), "gửi lại;", len(to_fix), "sửa;", len(to_fallback), "đổi model")
Thiết kế an toàn: lô nhỏ, lỗi, chạy lại và dữ liệu cá nhân
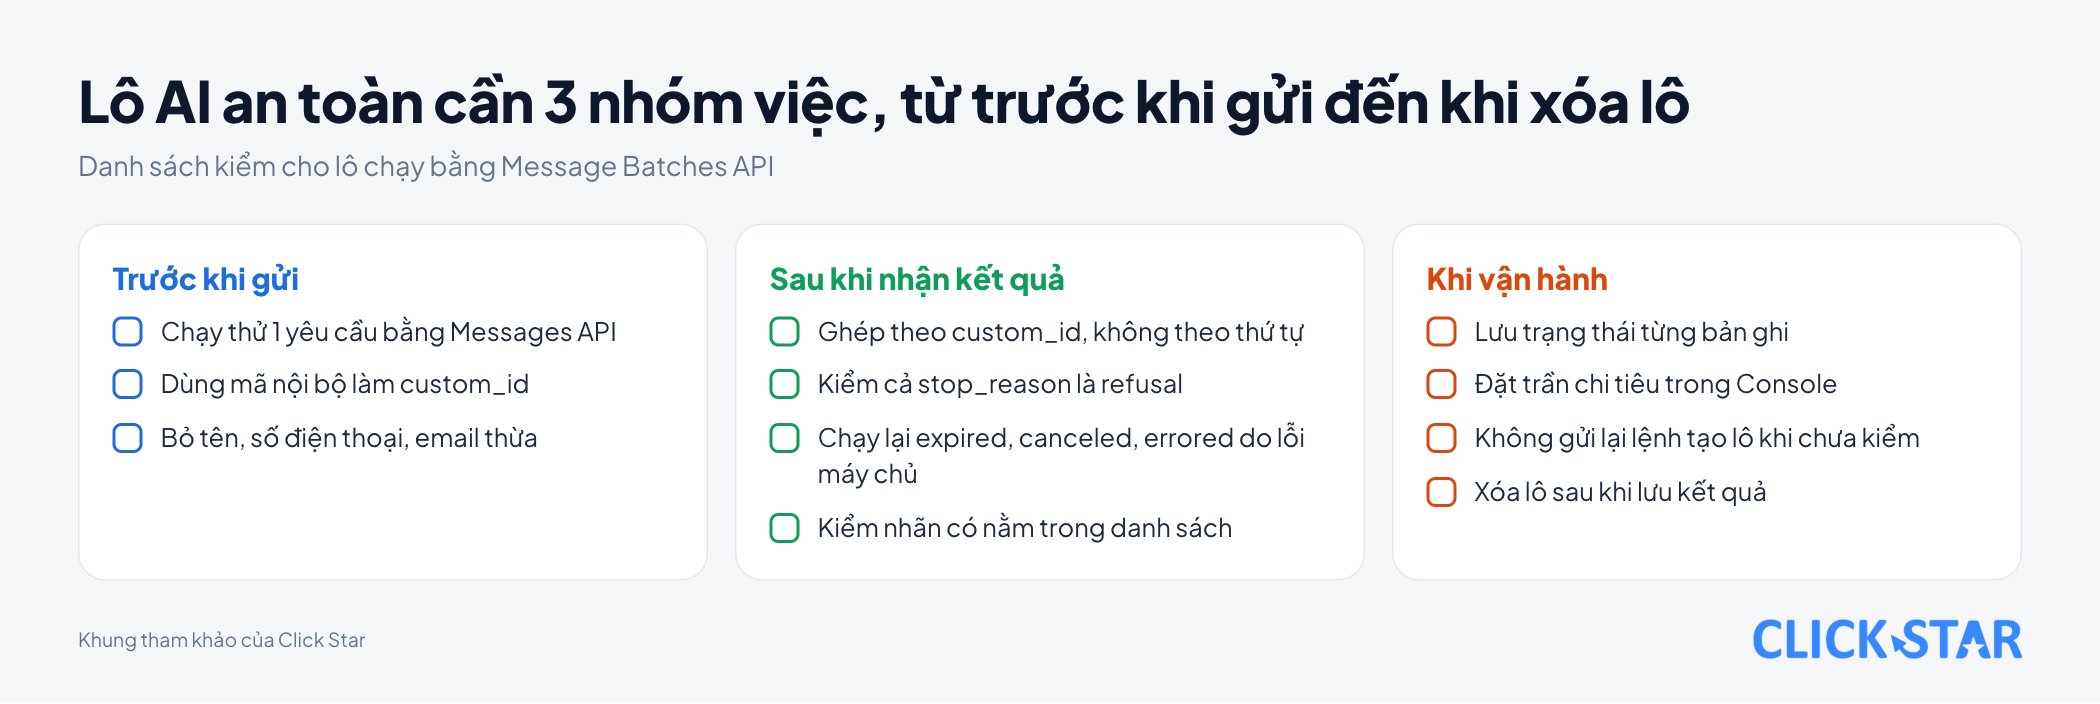
Ghi trạng thái từng bản ghi trong cơ sở dữ liệu: chưa gửi, đã gửi kèm mã lô, đã có kết quả, cần chạy lại. Trang Anthropic không nói lệnh tạo lô có idempotent hay không, còn Google nói là không, nên Click Star coi việc gửi lại lệnh tạo lô là không an toàn.
Chỉ gửi lại nguyên văn bản ghi expired, canceled hoặc errored do lỗi máy chủ; lỗi invalid_request_error phải sửa trước.
Với yêu cầu bị từ chối, Anthropic nói gửi lại cùng model thường bị từ chối tiếp, nên hãy thử model khác (cách gửi lại: mục Refusals in Message Batches). Với loại từ chối reasoning_extraction (đòi model ghi lại lập luận trong câu trả lời), Anthropic nói nên đổi nội dung thay vì thử lại.
Với dữ liệu cá nhân, trang Batch processing ghi dữ liệu lô được lưu 29 ngày, không thuộc diện không lưu dữ liệu, và cho xóa lô sau khi xử lý (lô đang chạy phải hủy trước). Hãy gửi mã nội bộ thay vì tên, số điện thoại hay email, và đừng đặt chúng vào custom_id.
Điều này có nghĩa gì với doanh nghiệp Việt Nam
Click Star chưa tìm thấy số đo công khai về mức tiết kiệm thực tế của doanh nghiệp Việt Nam khi gọi theo lô. Mức 50% là giá niêm yết trên token, chưa phải mức giảm của tổng hóa đơn, vì hóa đơn còn phụ thuộc tỷ lệ chạy lại, model chọn, công dựng quy trình và tỷ giá.
Đánh giá của Click Star. Xử lý theo lô hợp với việc nền chạy theo lịch như gắn nhãn, tóm tắt, trích dữ liệu và chấm bộ câu hỏi thử. Nó không phải cách giảm chi phí cho tính năng mà khách đang chờ kết quả.
Rủi ro lớn nằm ở quản trị hơn là giá: bản ghi lỗi bị bỏ sót, đầu ra chưa kiểm đã vào CRM, dữ liệu cá nhân gửi thừa. Click Star có dịch vụ tích hợp AI và AI automation nên có lợi ích liên quan.
Việc nên làm: lộ trình 7 ngày
Đây là lộ trình tham khảo của Click Star, không lấy từ nguồn ngoài.
Ngày 1 đến 2: chọn việc và dữ liệu
- Chọn 1 việc đạt cả 4 câu hỏi ở mục đầu.
- Lập 50 đến 100 bản ghi mẫu có đáp án do người chấm.
Ngày 3 đến 5: chạy thử
- Chạy 1 yêu cầu mẫu bằng Messages API để sửa lỗi tham số (trang Batch processing khuyên làm vậy).
- So 2 model trên bộ mẫu, chọn model rẻ nhất vẫn đạt độ chính xác chấp nhận được.
- Gửi 1 lô thử 50 đến 100 bản ghi (gợi ý của Click Star), ghi chi phí, thời gian đến
endedvà số yêu cầu lỗi.
Ngày 6 đến 7: đưa vào vận hành
- Lưu trạng thái từng bản ghi, viết bước xử lý riêng: gửi lại
expired,canceledvà lỗi máy chủ, sửainvalid_request_error, nhãn sai hoặc đầu ra bị cắt (max_tokens), đổi model chorefusal. - Đặt trần chi tiêu trong Console và cảnh báo khi lô chưa xong sau 24 giờ.
- Xóa lô sau khi đã lưu kết quả vào hệ thống của bạn.
Cách đo
Đo 4 chỉ số cho mỗi lô:
- Chi phí mỗi bản ghi, tính từ trường
usagetrong kết quả. - Tỷ lệ
succeeded,errored,expired,canceledvàrefusal. - Thời gian từ lúc gửi đến khi lô
ended. - Độ chính xác so với bộ mẫu có đáp án.
Những sai lầm thường gặp
- Dùng lô cho việc khách đang chờ kết quả.
- Ghép kết quả theo thứ tự dòng thay vì
custom_id. - Coi
succeededlà đạt mà không kiểmstop_reasonlàrefusal. - Gửi cả lô lớn mà chưa thử 1 yêu cầu hay 1 lô nhỏ.
- Gửi lại lệnh tạo lô khi chưa kiểm lô cũ, dẫn đến 2 lô và trả tiền 2 lần.
Điều chưa biết
Chưa có số đo cho Việt Nam về mức tiết kiệm thực tế. Cũng chưa biết thời gian hoàn thành lô thật và tỷ lệ trúng bộ nhớ đệm trên dữ liệu của bạn.
Trang Anthropic không nêu lệnh tạo lô có idempotent hay không, trang Google không nêu thời gian lưu kết quả. Click Star chưa gọi API thật bằng ví dụ mã, và chưa đọc văn bản pháp luật Việt Nam về dữ liệu cá nhân. Ví dụ cửa hàng và phép tính 10.000 phản hồi là minh họa.
Bài liên quan



Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.