Website bao nhiêu trang thì phải lo crawl budget? Mốc Google nêu
Google nói website không có nhiều trang đổi nhanh, hoặc có trang mới thường được đọc trong ngày, thì không cần đọc hướng dẫn crawl budget. Bài tóm tắt các mốc Google nêu, cách đọc báo cáo Crawl Stats và khung 5 bước kiểm tra, dựa trên 8 trang tài liệu của Google.
Chủ cửa hàng online có 300 trang sản phẩm nghe nói Google "không đọc hết website" và lo kế hoạch SEO hỏng (tình huống minh họa, không phải số đo). Google viết hướng dẫn riêng cho website rất lớn hoặc đổi rất nhanh, ví dụ từ 10.000 địa chỉ đổi mỗi ngày.
Bài này dựa trên 8 trang tài liệu của Google (hướng dẫn cho nhà phát triển và trợ giúp Search Console), đối chiếu đến ngày 04/11/2026. Cả 8 trang đều mở được.
Kết luận ngắn: Google nói website không có nhiều trang đổi nhanh, hoặc có trang mới thường được đọc trong ngày, thì không cần đọc hướng dẫn crawl budget (ngân sách thu thập). Bài chỉ ra khi nào cần lo, cách đọc báo cáo Thống kê thu thập dữ liệu và 5 việc nên làm.
Click Star đã có bài riêng về Googlebot, robots.txt, bộ lọc sản phẩm sinh địa chỉ trùng, 404/410 và chuyển hướng 301/302.
Điểm chính
- Crawl budget là tập các địa chỉ (URL) mà Google vừa có thể vừa muốn thu thập trên 1 tên máy chủ (hostname). Mỗi tên máy chủ có ngân sách riêng.
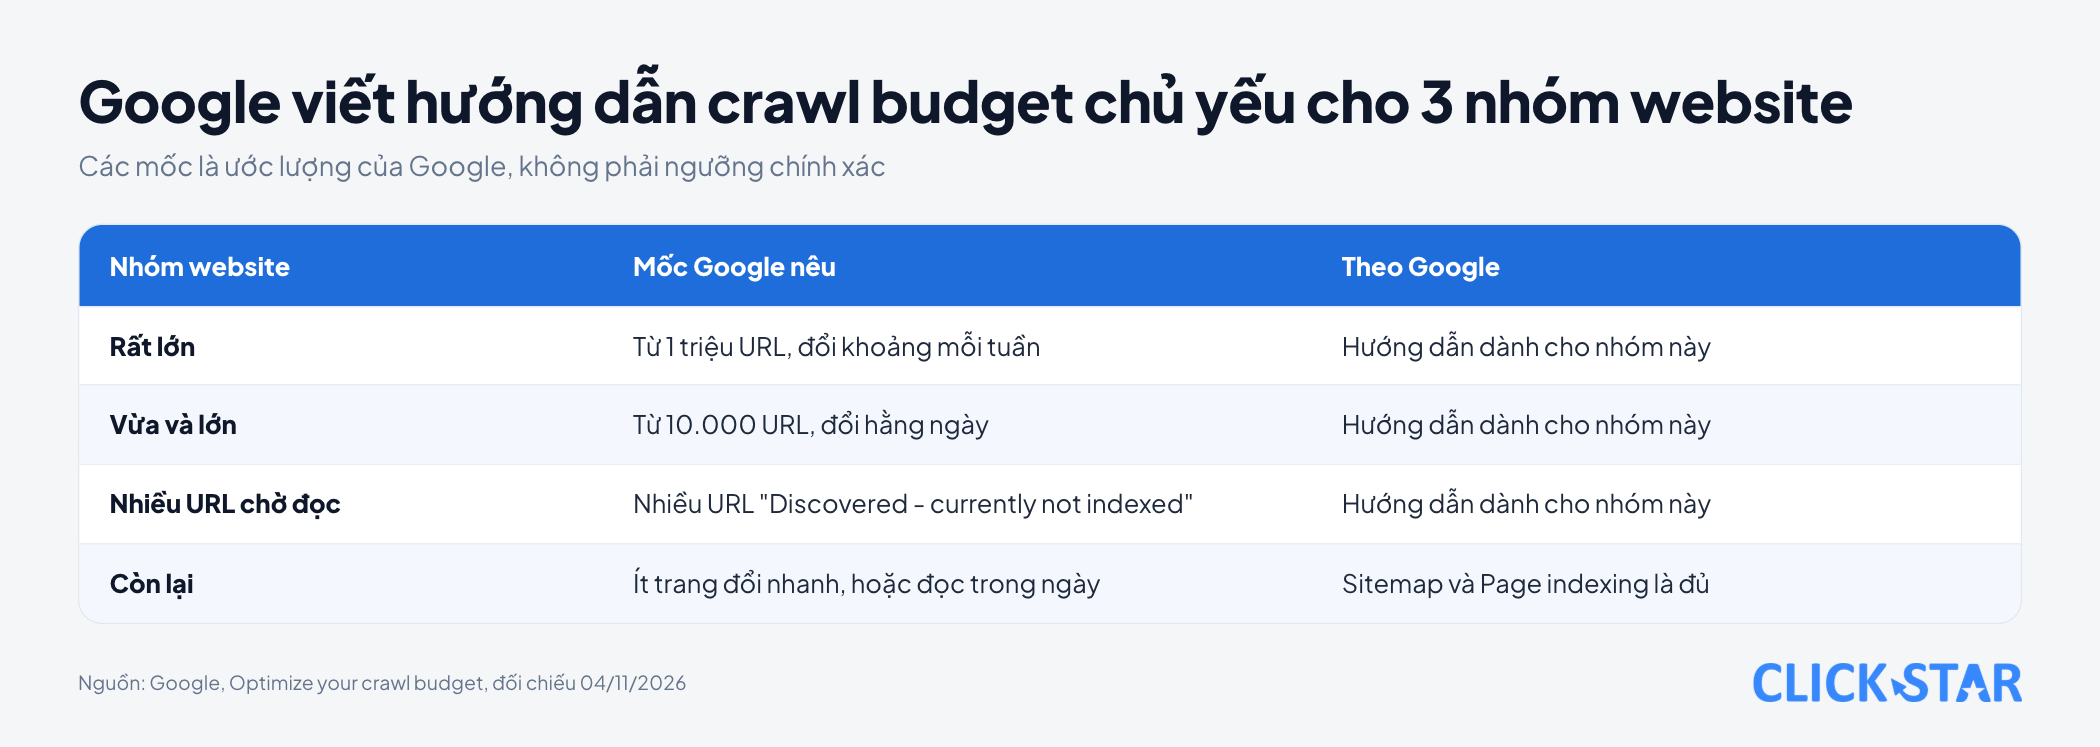
- Google viết hướng dẫn này chủ yếu cho 3 nhóm: từ 1 triệu trang đổi khoảng mỗi tuần, từ 10.000 trang đổi hằng ngày, hoặc có nhiều URL bị Search Console xếp "Discovered - currently not indexed". Các con số chỉ là ước lượng, không phải ngưỡng chính xác.
- Nếu website không có nhiều trang đổi nhanh, hoặc trang mới thường được thu thập ngay trong ngày đăng, Google nói không cần đọc hướng dẫn: giữ sitemap cập nhật và xem báo cáo Lập chỉ mục trang đều đặn là đủ.
- Ngân sách gồm 2 phần: giới hạn năng lực thu thập (máy chủ chịu được bao nhiêu) và nhu cầu thu thập (Google muốn đọc bao nhiêu). Phần chủ website tác động nhiều nhất là kho URL.
- Nếu không gộp được trang không quan trọng, Google khuyên chặn bằng robots.txt, nhưng không dùng nó để tạm thời chuyển ngân sách. Phần được giải phóng không tự dồn sang trang khác, trừ khi website đang chạm giới hạn năng lực.
Crawl budget là gì và website nào mới cần lo
Crawl budget là số địa chỉ mà Google có thể và muốn thu thập trên website của bạn. Thu thập (crawl) là việc Googlebot, chương trình tự động của Google, tải từng trang về để đọc. Theo hướng dẫn "Optimize your crawl budget" (ghi cập nhật 22/07/2026, đọc 04/11/2026), web gần như vô hạn nên Google không đọc được mọi địa chỉ công khai.
Google tính 1 website là 1 tên máy chủ. Blog ở blog.example.com và cửa hàng ở www.example.com vì thế có 2 ngân sách tách biệt.
Các mốc Google nêu
Google nói hướng dẫn chủ yếu dành cho 3 loại website. Loại thứ nhất có từ 1 triệu địa chỉ riêng biệt, nội dung đổi khoảng mỗi tuần. Loại thứ hai có từ 10.000 địa chỉ, nội dung đổi hằng ngày.
Loại thứ ba có một tỷ lệ lớn địa chỉ bị Search Console xếp vào nhóm "Discovered - currently not indexed". Theo trang "Page indexing report" (không ghi ngày, đọc 04/11/2026), đó là URL Google đã biết nhưng chưa đọc, thường vì dự đoán việc đọc sẽ làm máy chủ quá tải nên hoãn lại.
Trang khác dùng mốc khác: "Crawl Stats report" (không ghi ngày) nói website dưới 1.000 trang không cần báo cáo đó. Bài blog 16/01/2017, Google ghi chú có thể đã cũ, nói website dưới vài nghìn URL thường được đọc hiệu quả.
2 phần tạo nên ngân sách: năng lực và nhu cầu
Theo hướng dẫn trên, ngân sách do 2 yếu tố quyết định: giới hạn năng lực thu thập (crawl capacity limit) và nhu cầu thu thập (crawl demand), tức máy chủ chịu được bao nhiêu và Google muốn đọc bao nhiêu.
Giới hạn năng lực, còn gọi là hostload, là tổng thời gian máy chủ phải giữ kết nối mở cho Google. Mọi website bắt đầu từ cùng 1 mức mặc định thận trọng. Giới hạn tăng khi máy chủ phản hồi đều và nhanh, giảm khi máy chủ chậm đi, trả lỗi 5xx hoặc tín hiệu như 429.
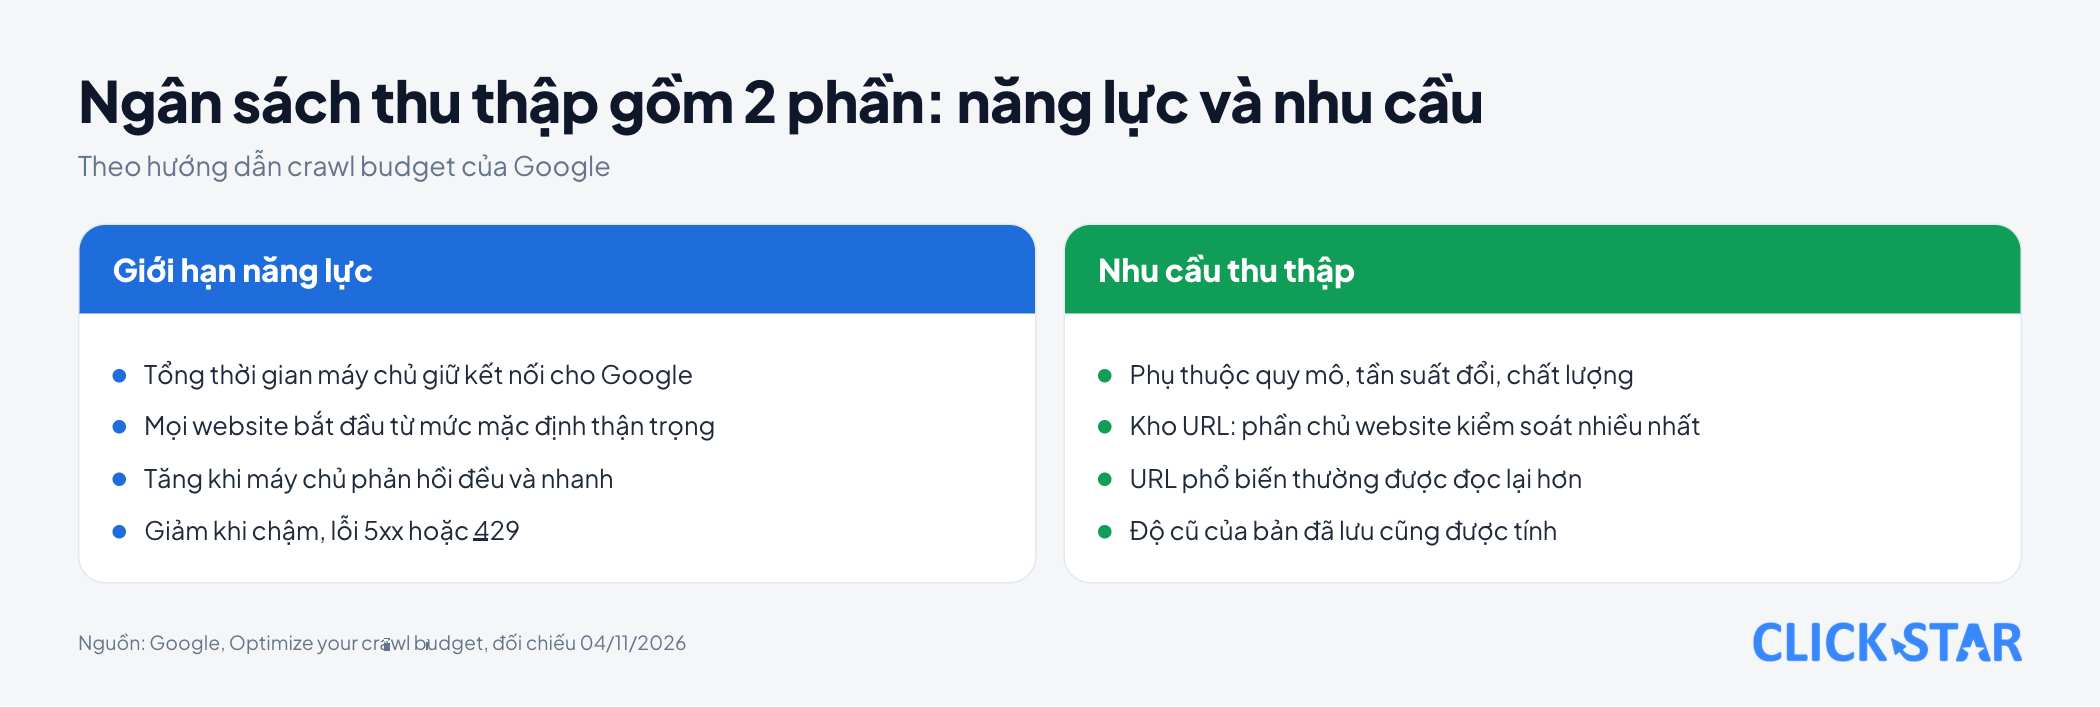
Với Googlebot, nhu cầu phụ thuộc quy mô, tần suất cập nhật, chất lượng và độ liên quan so với website khác. Google nêu 3 yếu tố chủ website tác động được: kho URL Google biết, mức phổ biến của URL và độ cũ của bản đã lưu.
Google viết kho URL là phần kiểm soát tích cực nhiều nhất. Nếu không được hướng dẫn, Google cố đọc gần hết URL đã biết, nên URL trùng hay đã bỏ làm phí thời gian.
Điều gì làm phí ngân sách thu thập
Phần việc có tác động nhiều nhất là dọn kho URL. Nếu Google mất nhiều thời gian vào URL không nên đọc, crawler có thể không khám phá phần còn lại của website. Google khuyên:
- Gộp nội dung trùng, để Google tập trung vào nội dung riêng biệt chứ không phải địa chỉ riêng biệt.
- Trả 404 hoặc 410 cho trang đã xóa vĩnh viễn. Google không quên URL đã biết, nhưng 404 là tín hiệu mạnh để không đọc lại. URL chỉ bị chặn bằng robots.txt ở trong hàng đợi lâu hơn.
- Loại soft 404. Đó là trang hiện thông báo "không tìm thấy" nhưng vẫn trả mã 200. Google nói chúng tiếp tục bị thu thập và làm phí ngân sách.
- Giữ sitemap cập nhật, kèm thẻ
<lastmod>khi nội dung đổi. - Tránh chuỗi chuyển hướng dài. Tài liệu mã trạng thái (ghi cập nhật 04/02/2026) nói Googlebot thường theo tối đa 10 bước.
- Làm trang tải nhanh và hỗ trợ mã 304. Nếu trang không đổi, 304 báo Google dùng bản đã lưu, đỡ tốn băng thông.
Trang "Build and submit a sitemap" (ghi cập nhật 08/07/2026) nói Google dùng <lastmod> nếu giá trị chính xác nhất quán và kiểm chứng được. Sửa nội dung chính, dữ liệu có cấu trúc hoặc liên kết thường được coi là đáng kể; đổi năm bản quyền thì không. Mỗi sitemap tối đa 50 MB (chưa nén) hoặc 50.000 URL.
Muốn Google đọc nhiều hơn, hướng dẫn nêu 2 cách: thêm tài nguyên máy chủ khi công cụ Kiểm tra URL báo "Hostload exceeded", hoặc nâng chất lượng nội dung.
robots.txt và noindex: dùng đúng việc
Hướng dẫn nói nếu không gộp được các trang không quan trọng, như trang cuộn vô hạn lặp thông tin hoặc bản sắp xếp khác của cùng một trang, hãy chặn chúng bằng robots.txt. Chặn như vậy ngăn Google đọc và giảm đáng kể khả năng URL được lập chỉ mục.
Google nêu 2 điều không nên làm: dùng noindex cho mục đích này (Google vẫn gửi yêu cầu rồi mới bỏ trang khi thấy thẻ), và dùng robots.txt để tạm thời chuyển ngân sách sang trang khác.
Trang "Introduction to robots.txt" (ghi cập nhật 10/12/2025) nhắc thêm: robots.txt không phải cách giữ trang khỏi kết quả tìm kiếm. URL bị chặn vẫn có thể hiện, không có mô tả.
Đọc báo cáo Thống kê thu thập dữ liệu (Crawl Stats)
Báo cáo nằm trong Search Console, ở mục cài đặt thuộc tính rồi Crawl stats. Báo cáo chỉ có cho thuộc tính cấp gốc (Domain hoặc URL-prefix như https://example.com).
Báo cáo gồm 8 mục: tổng yêu cầu, dung lượng tải, thời gian phản hồi, trạng thái máy chủ, phản hồi, loại tệp, mục đích và loại Googlebot. Số liệu chưa đếm hết mọi yêu cầu, nên có thể lệch nhẹ so với nhật ký máy chủ.
Trạng thái máy chủ và robots.txt
Trạng thái máy chủ xét 3 nhóm: tải robots.txt, phân giải DNS và kết nối máy chủ.
Phần robots.txt dễ bị bỏ sót. Google coi phản hồi 200 (kể cả tệp rỗng), 403, 404 và 410 là thành công; 429 và 5xx là không thành công.
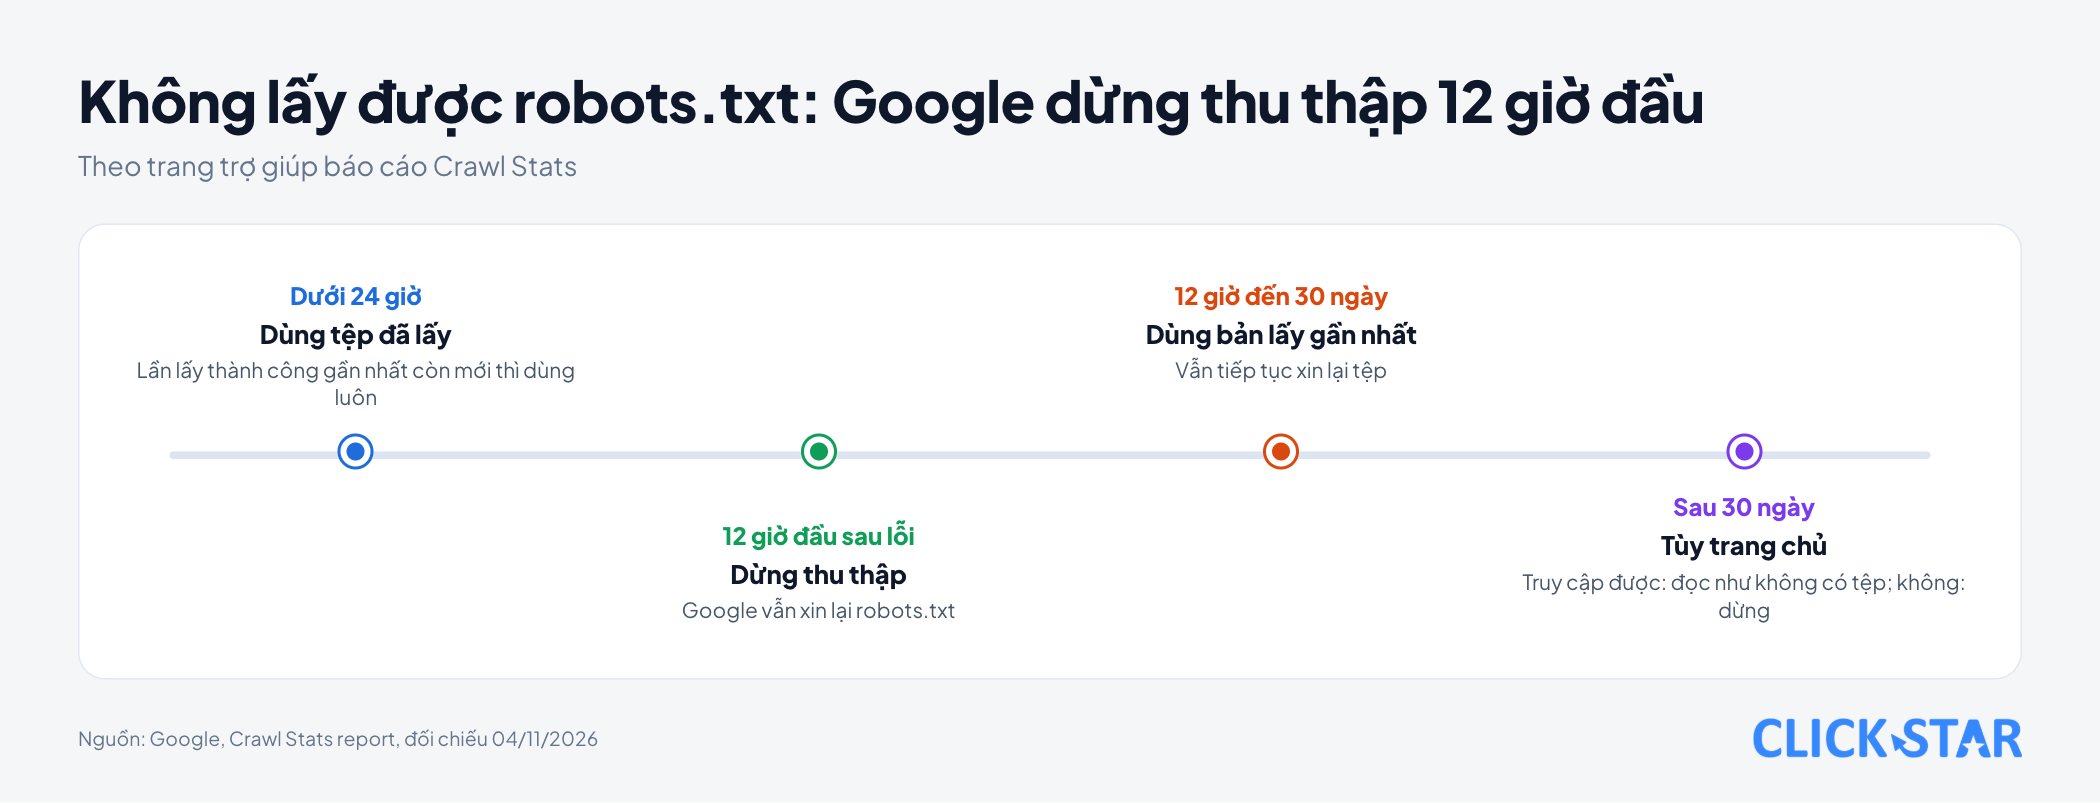
Nếu lần lấy gần nhất thất bại hoặc đã cũ hơn 24 giờ, Google xin lại tệp. Trong 12 giờ đầu Google dừng thu thập; từ 12 giờ đến 30 ngày dùng bản lấy được gần nhất; sau 30 ngày, nếu trang chủ truy cập được thì thu thập như không có robots.txt, nếu không thì dừng.
Cách đọc bảng phản hồi
Trong bảng phản hồi, hầu hết phải là 200 hoặc nhóm "tốt" khác. Google viết 404 thường là phản hồi đúng, nên không cần sửa mọi 404; lỗi 5xx thì nên sửa.
Khi Google đọc quá nhiều làm máy chủ quá tải
Có tình huống ngược lại. Theo trang "Reduce the Google crawl rate" (ghi cập nhật 06/10/2026), nguyên nhân phổ biến là bộ lọc hoặc sắp xếp, lịch có rất nhiều URL theo ngày, hoặc mục tiêu quảng cáo tìm kiếm động. Google khuyên xem nhật ký truy cập máy chủ trước.
Chỉ khi khẩn cấp mới trả mã 500, 503 hoặc 429 thay cho 200, trong vài giờ đến 1-2 ngày. Nếu kéo dài nhiều ngày, URL có thể bị loại khỏi chỉ mục.
Theo trang "How HTTP status codes affect Google's crawlers" (ghi cập nhật 04/02/2026), không dùng 401 và 403 để giới hạn tốc độ: 4xx trừ 429 không ảnh hưởng tốc độ.
Điều này có nghĩa gì với doanh nghiệp Việt Nam
Click Star chưa tìm thấy số đo công khai về số website Việt Nam chạm các mốc của Google. Phần dưới là nhận định của Click Star, không lấy từ nguồn ngoài.
Với website giới thiệu doanh nghiệp vài chục đến vài trăm trang, crawl budget gần như không phải việc cần xử lý. Công sức nên dành cho nội dung, liên kết nội bộ và sitemap.
Nhóm có thể chạm mốc là cửa hàng online nhiều bộ lọc, trang tin hàng chục nghìn bài, cổng tin đăng đổi mỗi ngày. Ở nhóm này, kho URL phình ra thường là nguyên nhân, không phải thiếu tài nguyên máy chủ.
Đánh giá của Click Star. Nên xem crawl budget như công cụ chẩn đoán, không phải mục tiêu. Khi có dấu hiệu cụ thể, như trang mới lâu được đọc hay lỗi 5xx tăng, hãy đọc Crawl Stats rồi sửa kho URL trước.
Click Star có dịch vụ thiết kế website chuẩn SEO tải nhanh, nên có lợi ích liên quan đến chủ đề này.
Việc nên làm: khung 5 bước kiểm tra
Khung tham khảo của Click Star, không lấy từ nguồn ngoài, chưa chạy thử trên dữ liệu thật.
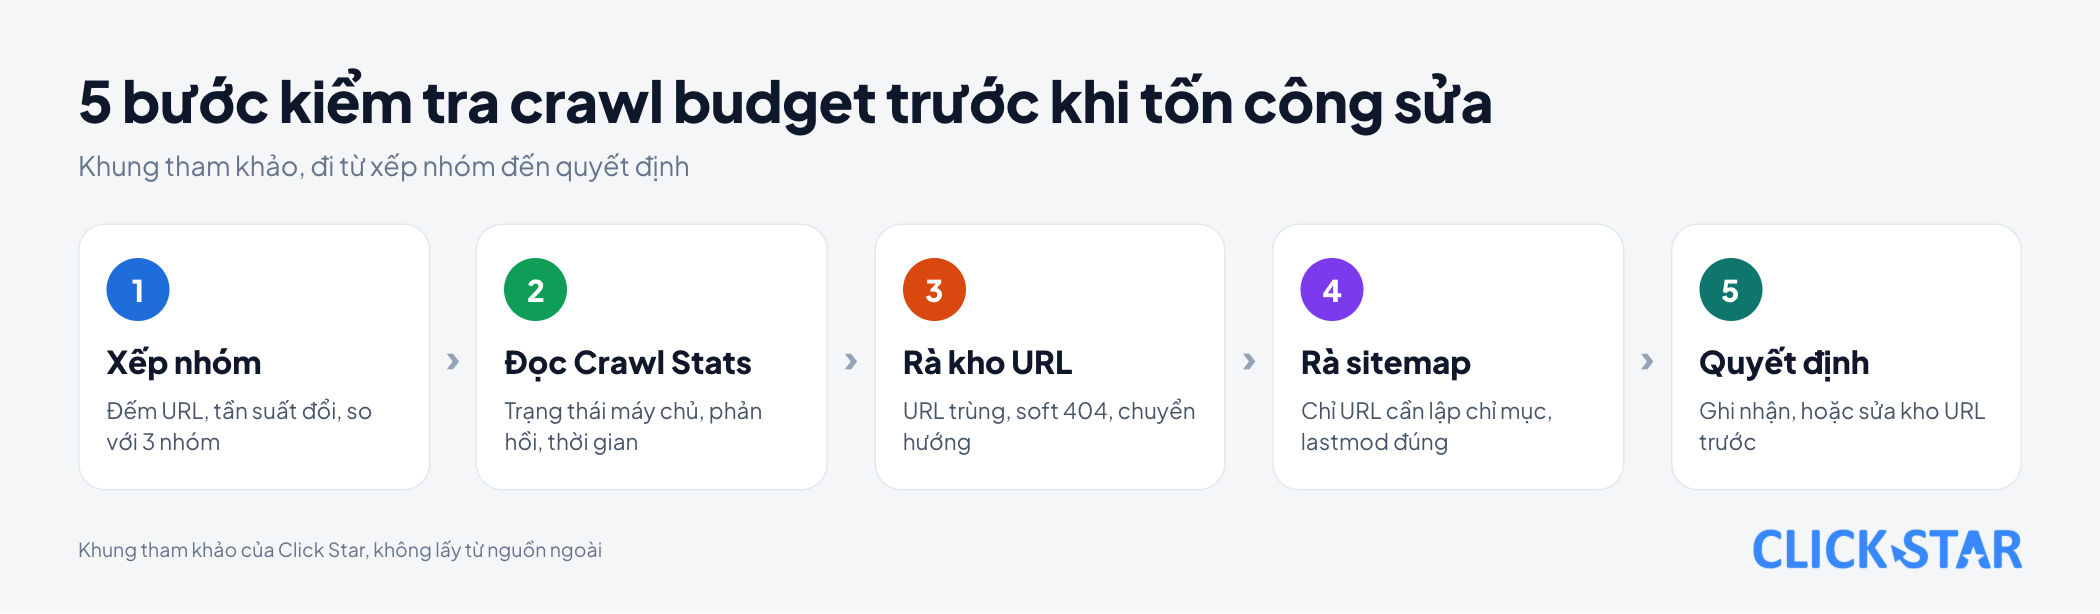
Bước 1. Xếp website vào đúng nhóm. Đếm URL riêng biệt muốn lập chỉ mục, ghi tần suất đổi và số URL "Discovered - currently not indexed", rồi so với 3 mốc của Google.
Bước 2. Mở Crawl Stats nếu có thuộc tính cấp gốc. Xem trạng thái máy chủ, tỷ lệ phản hồi 200, 301, 404, 5xx và thời gian phản hồi.
Bước 3. Rà kho URL. Tìm địa chỉ trùng do tham số lọc hoặc sắp xếp, trang soft 404 và chuỗi chuyển hướng.
Bước 4. Rà sitemap. Chỉ liệt kê URL muốn lập chỉ mục, giữ mỗi tệp trong 50.000 URL, và đặt <lastmod> đúng với lần sửa đáng kể gần nhất.
Bước 5. Quyết định. Nếu không thuộc nhóm cần lo và trang mới vẫn được đọc trong ngày, ghi nhận và kiểm lại định kỳ. Nếu thuộc nhóm cần lo, sửa kho URL và tốc độ máy chủ trước khi thêm tài nguyên.
Cách đo
Sau mỗi thay đổi, theo dõi 2 thứ trong Search Console.
- Số URL "Discovered - currently not indexed" trong báo cáo Lập chỉ mục trang.
- Tỷ lệ phản hồi và thời gian phản hồi trung bình trong Crawl Stats.
Những sai lầm thường gặp
- Lo crawl budget cho website vài chục trang, trong khi nội dung và liên kết nội bộ mới là vấn đề (nhận định của Click Star).
- Chặn cả thư mục bằng robots.txt rồi mong các trang quan trọng được đọc nhiều hơn.
- Dùng
noindexvới ý định tiết kiệm ngân sách thu thập. - Để trang đã xóa hiện thông báo "không tìm thấy" nhưng vẫn trả mã 200.
- Đặt
<lastmod>là ngày hôm nay cho mọi URL mỗi lần xuất sitemap, dù trang không đổi (suy luận của Click Star từ yêu cầu<lastmod>phải chính xác). - Trả 503 hoặc 429 nhiều ngày để "bảo vệ máy chủ".
Điều chưa biết
Chưa rõ ngưỡng thật: Google nói các con số chỉ là ước lượng, và các tài liệu dùng mốc khác nhau (1.000 trang, vài nghìn URL, 10.000, hàng trăm nghìn và 1 triệu trang).
Trang Crawl Stats gọi website hàng trăm nghìn trang là lớn. Với website nhỏ và vừa mà thấy Google không thu thập hết, trang này khuyên cập nhật sitemap và kiểm tra không chặn nhầm trang.
Các trang của Google chưa khớp ở 2 chỗ. Thứ nhất, hướng dẫn crawl budget nói Google vẫn gửi yêu cầu tới trang có noindex. Trong mục hỏi đáp về trang đã xóa (trả 4xx), trang "Page indexing report" viết rằng trường hợp duy nhất URL không bị thu thập là khi nó trả chỉ thị noindex. Click Star chưa tìm được nguồn giải thích.
Thứ hai, trang Crawl Stats khuyên đừng trả 503 hoặc 429 quá 2-3 ngày, còn trang "Reduce the Google crawl rate" nêu 1-2 ngày.
Chưa có số đo cho website Việt Nam, và khung 5 bước chưa được chạy thử. Trang Crawl Stats và Page indexing không ghi ngày cập nhật.
Bài liên quan



Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.