Đầu ra có cấu trúc JSON từ mô hình AI: đưa vào CRM và quy trình an toàn
Bài trả lời khi nào đầu ra JSON theo schema của Anthropic và OpenAI vẫn không khớp, và cần kiểm tra lại ở máy chủ ra sao, dựa trên tài liệu hiện hành đọc ngày 23/10/2026.
Khi kết quả của mô hình AI đi tiếp vào CRM, biểu mẫu hoặc quy trình tự động, hệ thống phía sau không đọc được câu văn tự do. Nó cần các trường có tên, kiểu dữ liệu và giá trị cho phép, thường ở dạng JSON.
Bài dựa trên tài liệu hiện hành của Anthropic và OpenAI về đầu ra có cấu trúc (structured outputs), tài liệu JSON Schema và 2 trang của OWASP, đối chiếu đến ngày 23/10/2026. Các trang này không hiển thị ngày cập nhật.
Bài trả lời: tính năng hiện có làm được gì, khi nào đầu ra vẫn không khớp, và kiểm tra lại ra sao. Click Star đã có bài riêng về AI agent, MCP, prompt injection và đánh giá chatbot.
Điểm chính
- Đầu ra có cấu trúc là buộc mô hình trả dữ liệu theo khuôn định trước (trường nào, kiểu gì, giá trị nào được phép) để hệ thống phía sau không phải đoán.
- Anthropic và OpenAI đều có tính năng ràng buộc đầu ra theo JSON Schema, nhưng mỗi bên hỗ trợ một tập con khác nhau. Trang Anthropic ghi minimum, maxLength và schema đệ quy là chưa hỗ trợ; trang OpenAI liệt kê minimum, maxItems và đệ quy là hỗ trợ.
- Từ chối vì an toàn, bị cắt do hết giới hạn token và enum lệch chữ hoa đều có thể cho đầu ra không khớp schema (từ chối và bị cắt: theo cả 2 bên; enum lệch chữ hoa: theo Anthropic).
- Schema hợp lệ không có nghĩa nội dung đúng. OpenAI ghi đầu ra vẫn có thể sai; OWASP khuyến nghị coi đầu ra mô hình như đầu vào của người dùng bất kỳ.
- Việc nên làm: schema nhỏ có lối ra "không rõ", đọc lý do dừng trước khi đọc JSON, xác thực lại ở máy chủ, có hàng đợi duyệt tay và bộ mẫu kiểm thử.
Vì sao cần đầu ra có cấu trúc
Giả sử CRM có cột "nhu cầu" là danh sách chọn và cột "số điện thoại" là chuỗi. Nếu mô hình trả về câu "Khách muốn tư vấn gói chăm sóc da, gọi sau 5 giờ chiều", phải có thêm mã đoán để tách thành từng cột.
Theo tài liệu của Anthropic, kể cả khi nhắc cẩn thận vẫn có thể gặp JSON sai cú pháp, thiếu trường bắt buộc hoặc kiểu dữ liệu không nhất quán.
JSON Schema là bản thiết kế cho dữ liệu AI trả về
Theo tài liệu JSON Schema (đọc ngày 23/10/2026), đây là ngôn ngữ mô tả một bản ghi JSON gồm những trường nào và giá trị ra sao. Anthropic và OpenAI đều dùng nó để nhận khuôn.
Trang "object" của JSON Schema nêu 2 mặc định hay bị bỏ sót. Thuộc tính khai trong properties không bắt buộc, muốn bắt buộc phải khai trong required. Thuộc tính thừa được phép, muốn cấm phải đặt additionalProperties là false.
Cả 2 nhà cung cấp biến điều này thành quy tắc cứng. Anthropic yêu cầu additionalProperties là false cho mọi object. Trang Function calling của OpenAI yêu cầu thêm mọi trường nằm trong required, và trường tùy chọn biểu diễn bằng cách cho phép kiểu null.
Hệ quả thiết kế: cho phép null hoặc giá trị "không rõ" trong danh sách chọn, để mô hình có lối ra thay vì bịa.
Anthropic và OpenAI hỗ trợ gì hiện nay
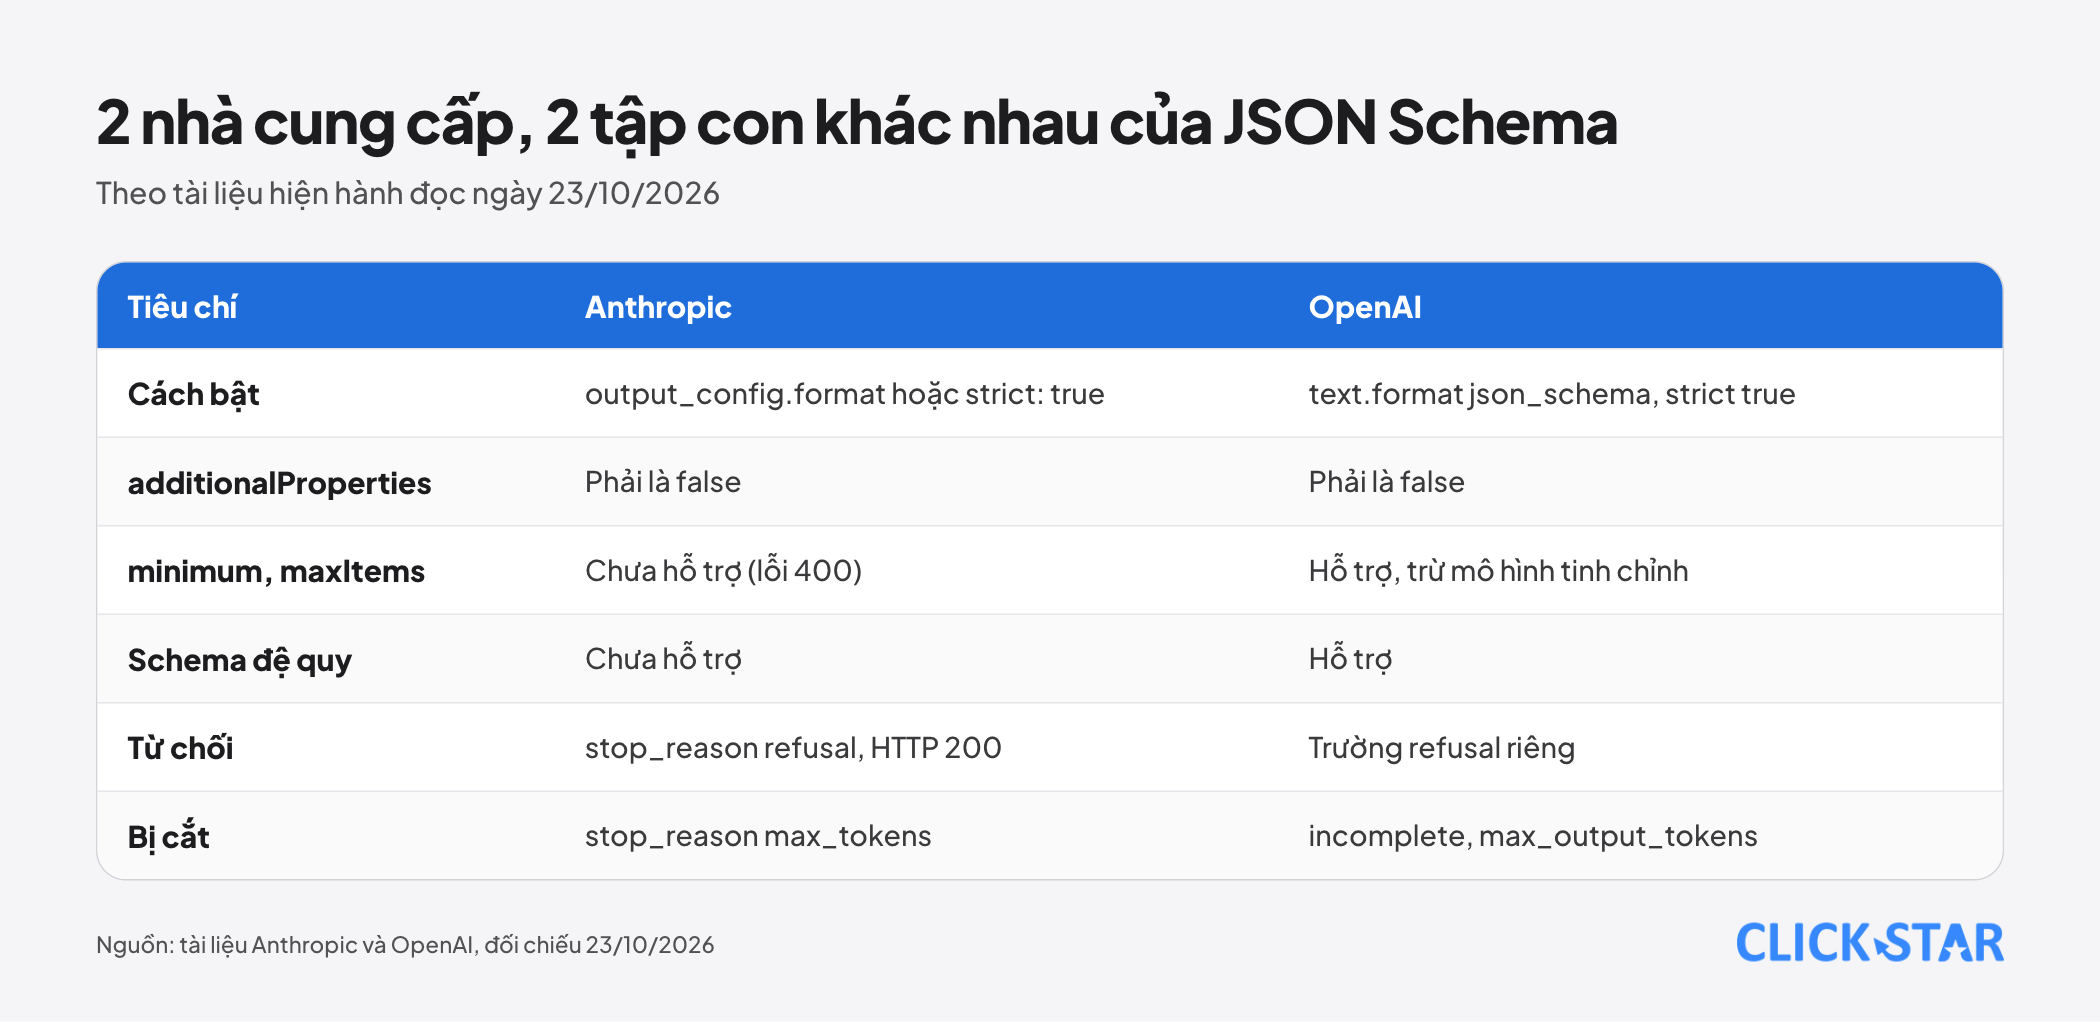
Anthropic. Trang "Structured outputs" (đọc ngày 23/10/2026) mô tả 2 tính năng dùng riêng hoặc cùng nhau. JSON outputs đặt schema ở output_config.format với type là json_schema. Strict tool use đặt strict là true trên công cụ để kiểm tra tên công cụ và tham số.
Trang ghi trạng thái GA kèm danh sách mô hình hỗ trợ. Cơ chế là giải mã có ràng buộc: schema được biên dịch thành ngữ pháp giới hạn token mô hình được sinh.
OpenAI. Trang "Structured model outputs" (đọc ngày 23/10/2026) ghi tính năng có từ GPT-4o trở đi, ở 2 dạng: function calling khi mô hình nối với công cụ của bạn, và text.format với type json_schema, strict true khi câu trả lời theo khuôn. Trang ghi JSON mode chỉ cho JSON hợp lệ, còn Structured Outputs bảo đảm đúng schema.
Khác biệt cần chú ý. Trang Anthropic liệt kê minimum, maximum, multipleOf, minLength, maxLength, mảng ngoài minItems 0 hoặc 1 và schema đệ quy là chưa hỗ trợ; dùng chúng sẽ nhận lỗi 400. Trang OpenAI liệt kê minimum, maximum, minItems, maxItems là hỗ trợ, và có mục riêng nói đệ quy được hỗ trợ.
OpenAI ghi các thuộc tính đó (chuỗi, số, mảng) không dùng được với mô hình tinh chỉnh.
Phần lớn hàm hỗ trợ trong SDK của Anthropic bỏ ràng buộc chưa hỗ trợ khỏi schema gửi đi, ghi chúng vào mô tả và, ở hàm có kiểm tra, kiểm tra lại phản hồi. Cả 2 bên giới hạn độ phức tạp; Anthropic ghi tối đa 24 tham số tùy chọn và 16 tham số dùng union (kể cả kiểu có null) mỗi yêu cầu, nên schema nhỏ có lợi.
Cả 2 có độ trễ ở lần đầu dùng một schema; Anthropic ghi ngữ pháp đã biên dịch được lưu 24 giờ kể từ lần dùng cuối.
3 tình huống đầu ra vẫn không khớp schema
Từ chối. Theo trang Anthropic, khi Claude từ chối vì an toàn, phản hồi có stop_reason là refusal, mã HTTP vẫn là 200, bạn vẫn bị tính phí và đầu ra có thể không khớp schema.
OpenAI xử lý khác: phản hồi có trường refusal riêng. Trang OpenAI còn nói mô hình luôn cố khớp schema nên có thể bịa nếu đầu vào không liên quan, và khuyên ghi trong lời nhắc cách xử lý, ví dụ trả tham số rỗng.
Bị cắt giữa chừng. Với Anthropic là stop_reason bằng max_tokens, khuyến nghị thử lại với max_tokens cao hơn. Với OpenAI là trạng thái incomplete và lý do max_output_tokens trong ví dụ mã của trang.
Trang "Stop reasons and fallback" của Anthropic ghi mã dừng nằm trong phản hồi thành công, còn lỗi là HTTP 4xx hoặc 5xx, nên theo suy luận của Click Star, chương trình chỉ bắt lỗi HTTP sẽ bỏ lọt cả từ chối lẫn bị cắt.
Enum lệch chữ hoa. Trang Anthropic ghi Claude có thể trả giá trị chỉ khác schema ở chữ hoa, phản hồi vẫn hoàn tất và không có mã dừng đặc biệt. Khuyến nghị: so sánh enum không phân biệt hoa thường.
Xác thực lại ở máy chủ vẫn là bắt buộc
Khớp schema chỉ bảo đảm hình dạng (cú pháp, kiểu, trường bắt buộc), không bảo đảm giá trị chấp nhận được với nghiệp vụ. Theo hướng dẫn kiểm tra đầu vào của OWASP (đọc ngày 23/10/2026), cần kiểm tra cả cú pháp lẫn ngữ nghĩa, ví dụ ngày kết thúc phải sau ngày bắt đầu.
Mục LLM05:2025 của OWASP gọi lỗi này là Improper Output Handling: kiểm tra đầu ra mô hình chưa đủ trước khi chuyển cho thành phần khác. Khuyến nghị là coi mô hình như bất kỳ người dùng nào và dùng truy vấn tham số hóa với đầu ra mô hình.
Một bộ kiểm tra phía máy chủ nên có cho dữ liệu kiểu CRM:
- Giá trị chọn nằm trong tập cho phép (so khớp không phân biệt hoa thường).
- Định dạng và độ dài chuỗi như số điện thoại, email, theo quy tắc nghiệp vụ của doanh nghiệp.
- Quy tắc giữa các trường và giới hạn kích thước trước khi phân tích cú pháp (theo OWASP).
OWASP còn cảnh báo lỗi tin dữ liệu từ nguồn nội bộ. Kết quả AI đến từ hệ thống của bạn nhưng giá trị có thể bắt nguồn từ tin nhắn khách. Click Star đã có bài về prompt injection: schema không ngăn chỉ dẫn độc hại chui vào một trường văn bản.
Schema hợp lệ không có nghĩa nội dung đúng
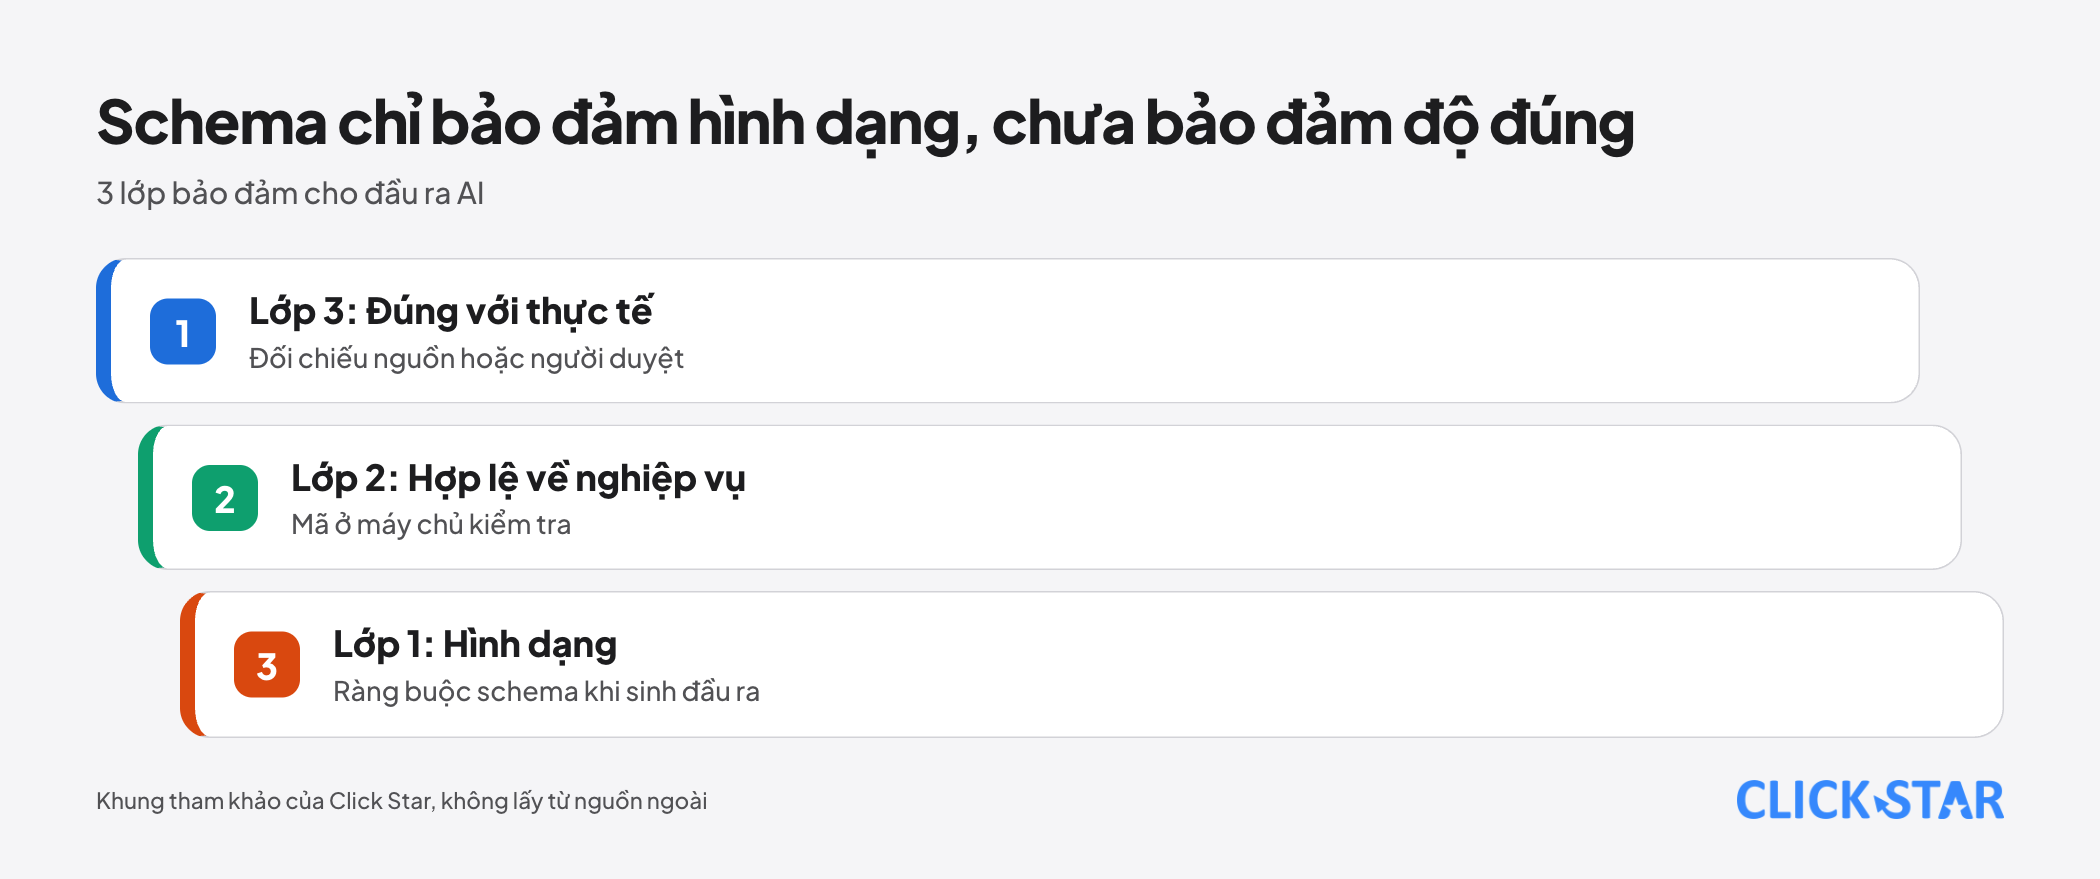
OpenAI ghi thẳng ở mục mẹo: Structured Outputs vẫn có thể chứa sai sót, và khuyên chỉnh hướng dẫn, thêm ví dụ hoặc chia nhỏ tác vụ. Ràng buộc schema giới hạn hình dạng của câu trả lời, không giới hạn độ đúng. Trường số điện thoại kiểu chuỗi vẫn có một chuỗi dù tin nhắn không có số, nếu schema không cho phép null.
Click Star đề xuất nhìn đầu ra theo 3 lớp (khung tham khảo của Click Star, không lấy từ nguồn ngoài). Lớp 1 là hình dạng, do ràng buộc khi sinh đảm nhận. Lớp 2 là hợp lệ về nghiệp vụ, do mã ở máy chủ kiểm tra. Lớp 3 là đúng với thực tế, chỉ đối chiếu nguồn hoặc người duyệt mới trả lời được.
Cách làm lớp 3 dễ hơn: thêm trường trích dẫn, bắt mô hình chép nguyên đoạn tin nhắn làm căn cứ, rồi máy chủ kiểm tra đoạn đó có nằm trong tin gốc. Đây là gợi ý của Click Star, không có trong tài liệu 2 nhà cung cấp, và chỉ chặn một loại bịa dễ thấy.
Ví dụ minh họa: đưa tin nhắn khách vào CRM
Ví dụ này do Click Star dựng, không phải dữ liệu thật. Tin nhắn mẫu: "Em là Lan, muốn tư vấn gói chăm sóc da cho 2 người. Gọi em sau 5 giờ chiều nhé, số 0900 000 000."
Schema gợi ý, mọi trường nằm trong required và trường có thể thiếu cho phép null:
- ten_khach, so_dien_thoai, thoi_diem_lien_he: chuỗi hoặc null.
- nhu_cau: một trong tu_van, bao_gia, ho_tro, khieu_nai, khac, khong_ro.
- can_nguoi_duyet: true hoặc false, đặt true khi mô hình không chắc.
- trich_dan: đoạn chép nguyên văn từ tin nhắn làm căn cứ cho nhu_cau.
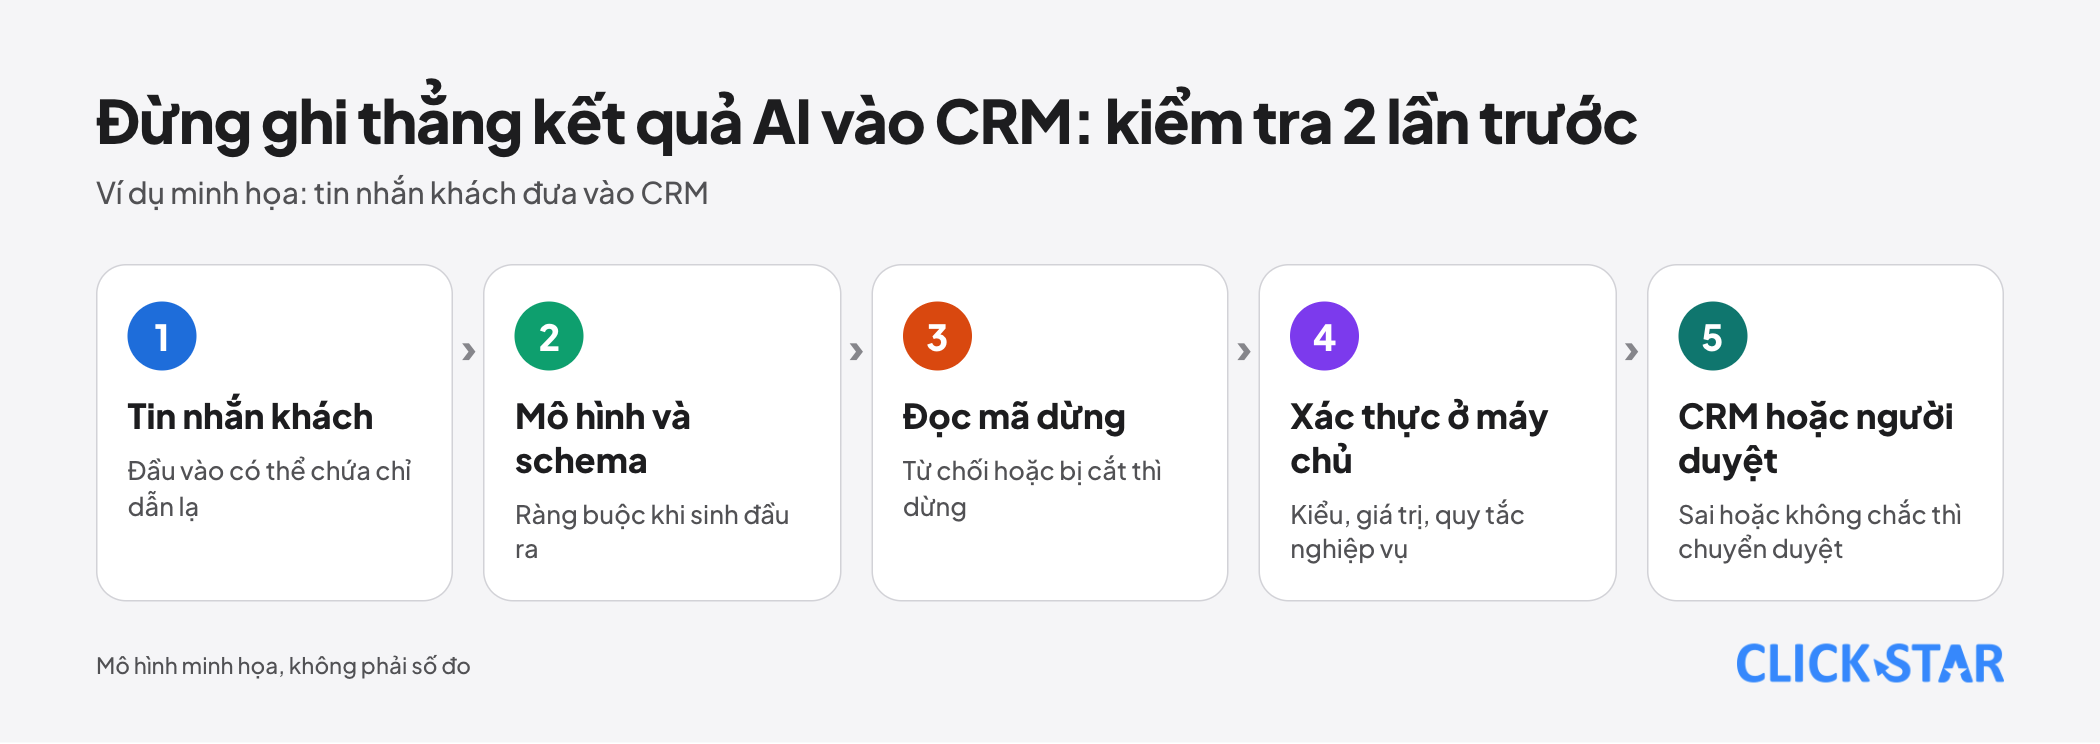
Quy trình: đọc mã dừng; nếu bình thường thì phân tích JSON, kiểm tra schema bằng Pydantic hoặc Zod cùng quy tắc nghiệp vụ và kiểm tra trich_dan nằm trong tin gốc. Nếu bước nào thất bại hoặc can_nguoi_duyet là true, đưa vào hàng đợi cho nhân viên duyệt thay vì ghi vào CRM. Tên và số điện thoại là dữ liệu cá nhân, nên chỉ gửi phần cần dùng.
Đánh giá của Click Star. Đầu ra có cấu trúc giải quyết đúng một việc: làm hình dạng dữ liệu đáng tin để mã phía sau không phải đoán. Nó không thay thế kiểm tra nghiệp vụ, duyệt tay hay đo chất lượng.
Rủi ro thường gặp là tin vào chữ "bảo đảm" và bỏ lớp xác thực. Click Star có dịch vụ tích hợp AI và CRM, nên có lợi ích liên quan; nhận định dựa vào tài liệu đã dẫn, không dựa vào dự án cụ thể.
Kiểm thử bằng bộ mẫu
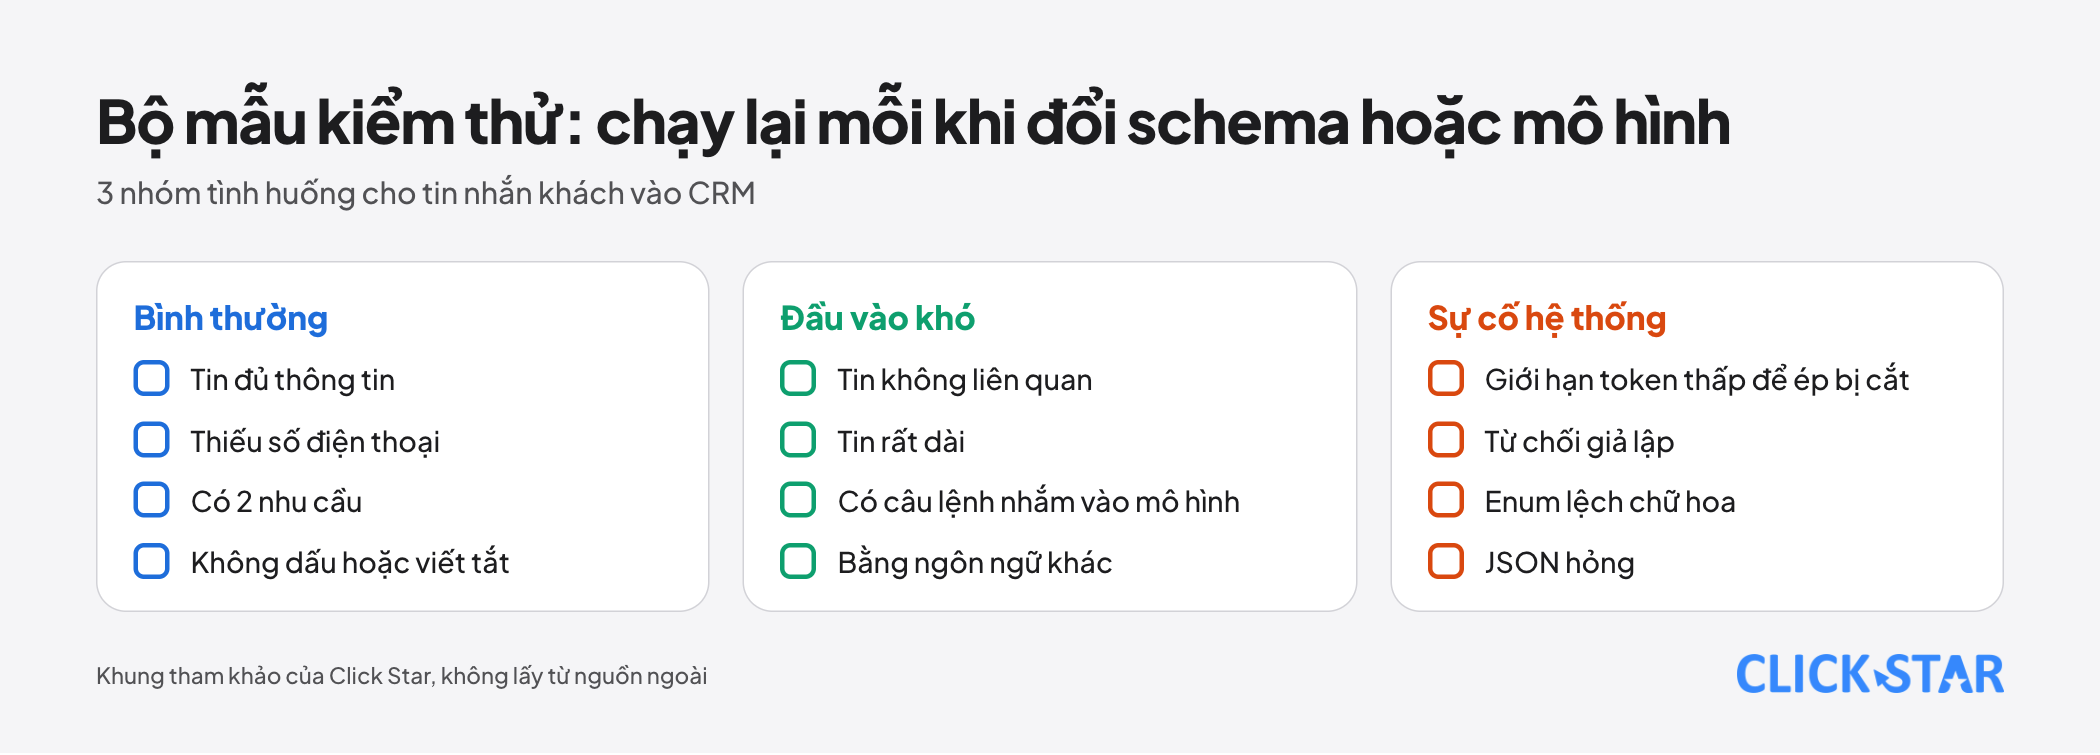
OpenAI khuyên tạo evals để chọn cấu trúc phù hợp, và thêm quy tắc CI cảnh báo khi schema hoặc kiểu dữ liệu trong mã bị sửa, hoặc tự sinh schema từ kiểu.
Bộ mẫu là danh sách đầu vào kèm đáp án viết trước; mỗi lần đổi schema, lời nhắc hoặc mô hình thì chạy lại. Các nhóm dưới đây là khung tham khảo của Click Star, không lấy từ nguồn ngoài.
- Bình thường: tin đủ thông tin, thiếu số điện thoại, có 2 nhu cầu, không dấu hoặc viết tắt.
- Đầu vào khó: tin không liên quan, rất dài, chứa câu lệnh nhắm vào mô hình, bằng ngôn ngữ khác.
- Sự cố hệ thống: giới hạn token thấp để ép bị cắt, từ chối giả lập, enum lệch chữ hoa, JSON hỏng.
Các nguồn không đưa số mẫu hay ngưỡng chuẩn; doanh nghiệp tự đặt theo mức thiệt hại của một bản ghi sai.
Bối cảnh Việt Nam
Click Star không tìm thấy số đo công khai cho Việt Nam về mức dùng đầu ra có cấu trúc hay tỷ lệ lỗi dữ liệu do AI trả về, nên bài không nêu số liệu thị trường. Với tin nhắn tiếng Việt, hãy thử riêng tin không dấu, viết tắt, trộn tiếng Anh bằng dữ liệu của bạn.
Click Star đã có bài về đưa AI vào doanh nghiệp an toàn dữ liệu; bài này không tư vấn pháp lý.
Lộ trình 14 ngày
Đây là khung tham khảo của Click Star, không lấy từ nguồn ngoài.
- Ngày 1 đến 2: chọn 1 luồng nhỏ, liệt kê trường CRM cần và trường nào được phép null.
- Ngày 3 đến 4: viết schema theo trang của đúng nhà cung cấp, đối chiếu danh sách chưa hỗ trợ.
- Ngày 5 đến 7: viết lớp xác thực ở máy chủ, xử lý mã dừng và hàng đợi duyệt tay.
- Ngày 8 đến 10: dựng bộ mẫu 3 nhóm, chạy và ghi các ca lỗi.
- Ngày 11 đến 14: chạy song song với người làm tay, rồi quyết định mức tự động hóa.
Cách đo: tỷ lệ vào hàng đợi duyệt, tỷ lệ bị từ chối hoặc bị cắt, số bản ghi nhân viên phải sửa lại, độ trễ lần đầu dùng schema mới.
Điều chưa biết
Click Star không có số đo độc lập về tỷ lệ lỗi thực tế của đầu ra có cấu trúc. Các tài liệu đã đọc là của chính nhà cung cấp và không hiển thị ngày cập nhật.
Click Star chưa chạy mã gọi API để tự đo độ trễ hay tỷ lệ bị cắt, từ chối, và chưa đọc các nhà cung cấp khác. Chưa có số đo chất lượng trích xuất tiếng Việt. Ví dụ CRM và khung 3 lớp là suy luận.
Những sai lầm thường gặp
- Chỉ dặn "trả về JSON" trong lời nhắc rồi đọc thẳng, không dùng ràng buộc schema của nhà cung cấp.
- Tin rằng đã bật ràng buộc thì khỏi kiểm tra, dù tài liệu ghi từ chối, bị cắt và enum lệch chữ hoa.
- Chỉ bắt lỗi HTTP mà không đọc mã dừng hoặc trạng thái phản hồi.
- Bắt mọi trường phải có giá trị nhưng không cho null hay "không rõ", đẩy mô hình vào chỗ phải bịa.
- Áp danh sách tính năng của nhà cung cấp này cho bên kia, ví dụ dùng minimum hay schema đệ quy với Anthropic.
- Ghi thẳng kết quả AI vào CRM hoặc nối vào truy vấn, không xác thực và không qua hàng đợi duyệt.
- Không có bộ mẫu, nên đổi mô hình hoặc schema mà không biết chất lượng đổi ra sao.
Bài liên quan



Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.