AI trả lời bịa với khách? 7 kỹ thuật giảm ảo giác của Anthropic
Trang của Anthropic nêu 7 kỹ thuật giảm ảo giác và ghi rõ không kỹ thuật nào xóa hết lỗi. Bài đi qua cả 7, kèm mã 2 lần gọi, bộ câu hỏi thử và lúc nào cần người duyệt.
Một cửa hàng online cho chatbot trả lời khách về đổi trả. Chính sách ghi 30 ngày, nhưng bot nói 60 ngày vì con số đó nghe hợp lý. Đây là ví dụ minh họa, không phải số đo thật.
Bài này dựa trên tài liệu của Anthropic, OpenAI, Google và 1 bài báo trên arXiv, đối chiếu đến ngày 04/11/2026. Phần kỹ thuật chủ yếu lấy từ trang "Reduce hallucinations" của Anthropic.
Kết luận ngắn: trang đó nêu đúng 7 kỹ thuật và nói thẳng rằng chúng giảm lỗi chứ không xóa được lỗi. Bài đi qua cả 7, kèm 1 đoạn mã 2 lần gọi, cách đo lỗi và lúc nào cần người duyệt.
Điểm chính
- Ảo giác (hallucination) là khi mô hình viết ra điều sai sự thật hoặc không khớp ngữ cảnh được đưa, dù câu văn vẫn trôi chảy.
- Trang của Anthropic nêu 7 kỹ thuật: 3 cơ bản và 4 nâng cao. Trang ghi rõ chúng không xóa hết ảo giác và không nêu mức giảm bằng số.
- Theo Click Star, dễ áp nhất cho chatbot khách hàng: dặn mô hình chỉ dùng tài liệu cho trước và cho 1 câu cố định để nói "không biết". Câu đó cũng là tín hiệu chuyển cho nhân viên.
- OpenAI viết rằng trả lời bằng bài hỗ trợ có sẵn có thể an toàn hơn việc để mô hình tự viết mới, và nên có người duyệt đầu ra khi có thể.
- Hướng dẫn chuyển sang Claude Sonnet 5.5 ghi
temperature,top_p,top_ktrả lỗi 400, nên "giảm nhiệt độ" không dùng được trên mô hình này. - Khung 5 bước của Click Star (không lấy từ nguồn ngoài) ghép các kỹ thuật thành quy trình; câu không qua kiểm thì chuyển cho người.
Ảo giác AI là gì, và vì sao chatbot vẫn bịa
Ảo giác là câu trả lời sai thực tế hoặc không khớp tài liệu được đưa, nhưng đọc lên vẫn thuyết phục. Trang "Reduce hallucinations" của Anthropic (không ghi ngày, đọc 04/11/2026) nói điều này xảy ra cả với Claude.
Về nguyên nhân, bài "Why Language Models Hallucinate" trên arXiv (nộp ngày 04/09/2025) lập luận rằng mô hình đoán khi không chắc, giống học sinh đoán khi gặp câu khó, vì huấn luyện và chấm điểm thưởng cho việc đoán. Đây là lập luận của nhóm tác giả; Click Star mới đọc phần tóm tắt.
Cần phân biệt mô hình bịa với tài liệu đưa vào bị sai hoặc thiếu. OpenAI viết rằng ngữ cảnh sai khiến mô hình không thể đúng, còn quá nhiều ngữ cảnh không liên quan làm chìm thông tin thật và gây ảo giác (trang "Optimizing LLM Accuracy", không ghi ngày, đọc 04/11/2026).
7 kỹ thuật giảm ảo giác theo tài liệu Anthropic
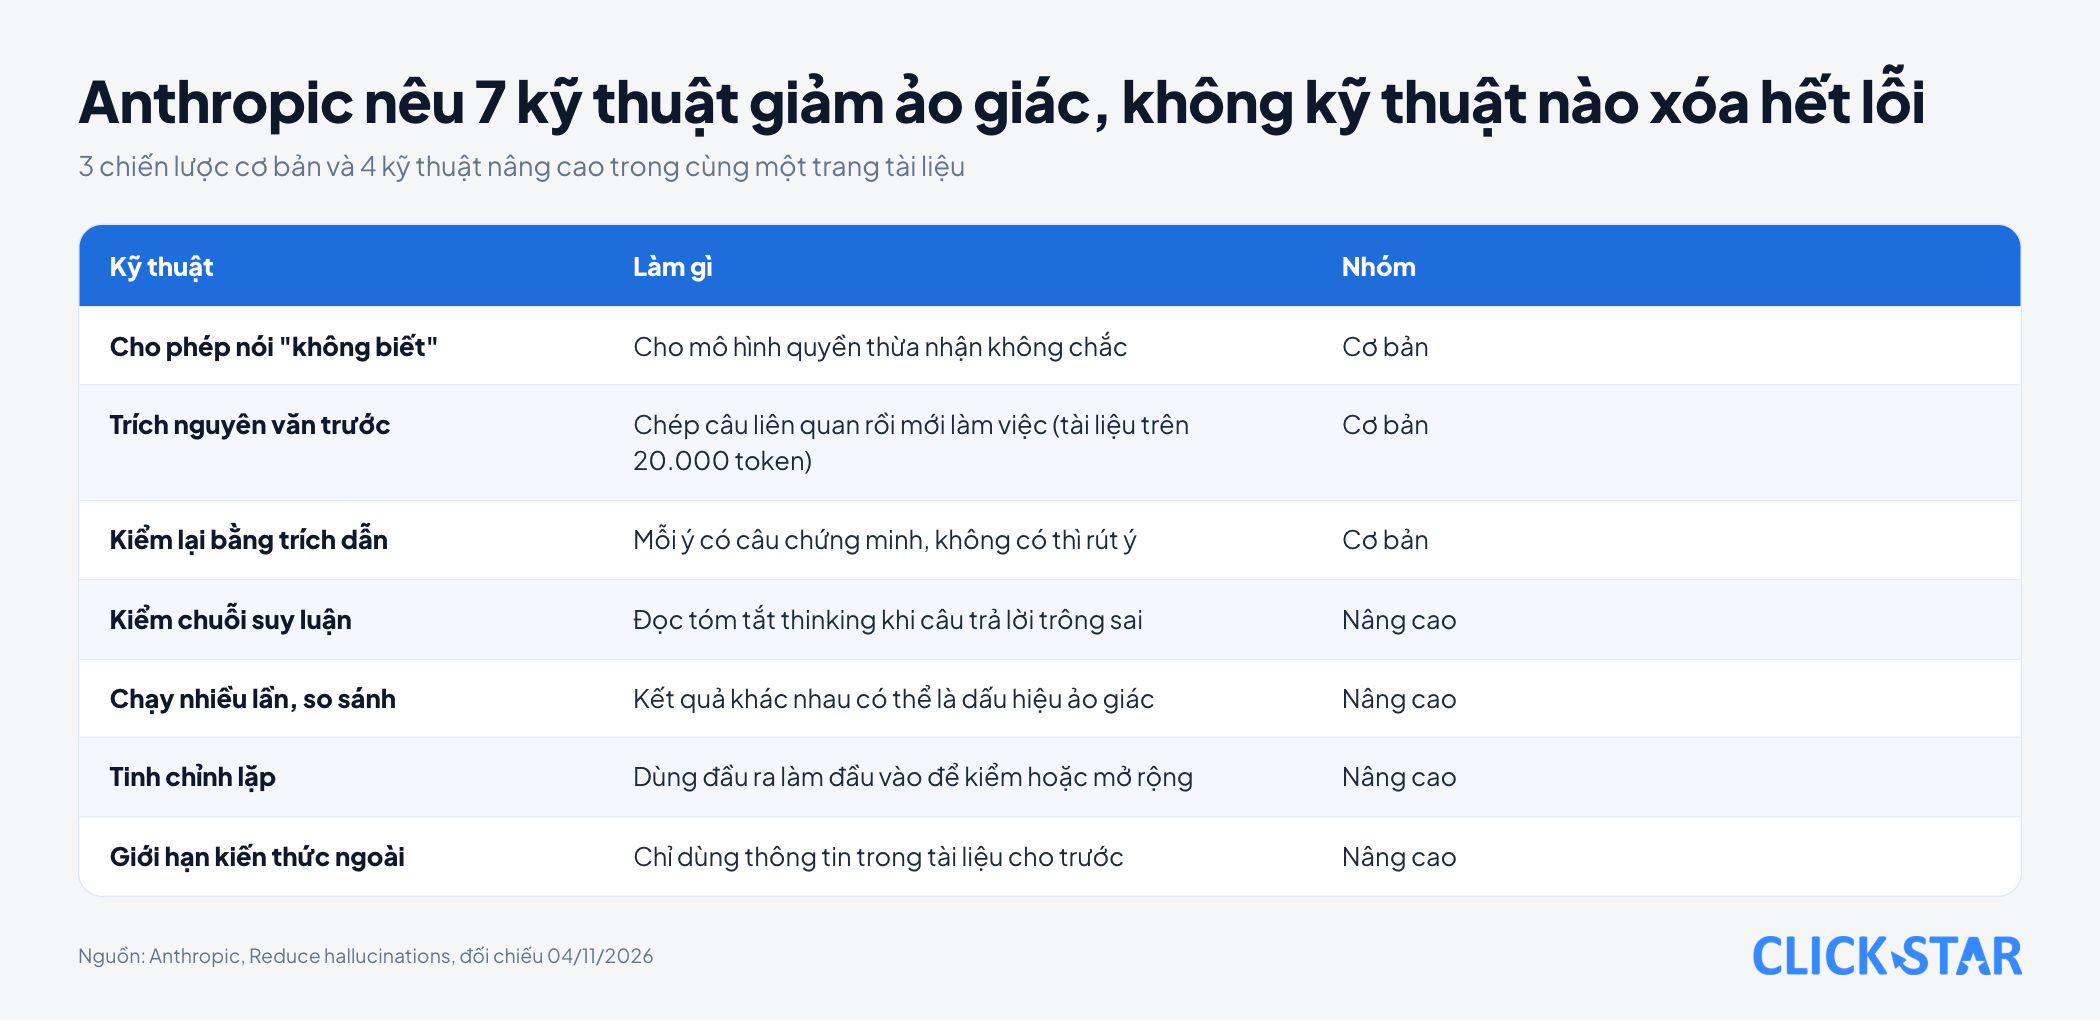
Trang của Anthropic chia thành 3 chiến lược cơ bản và 4 kỹ thuật nâng cao. Dưới đây là cả 7, kèm điều kiện nguồn nêu và nhận định của Click Star cho chatbot khách hàng.
1. Cho phép nói "không biết". Anthropic dặn nên cho mô hình quyền thừa nhận mình không chắc, và nói kỹ thuật này có thể giảm mạnh thông tin sai.
2. Trích nguyên văn trước khi trả lời. Với tài liệu dài (trang nêu mốc trên 20.000 token, đơn vị văn bản mô hình đếm), hãy bắt mô hình chép nguyên văn các câu liên quan trước, rồi mới làm việc dựa trên các câu đó.
3. Kiểm lại bằng trích dẫn. Cho mô hình gắn trích dẫn cho từng ý, hoặc sau khi viết xong thì tìm câu chứng minh cho từng ý và bỏ ý nào không tìm được. Anthropic còn có tính năng Citations; trang Citations (không ghi ngày, đọc 04/11/2026) nói tính năng này bảo đảm con trỏ trích dẫn hợp lệ với tài liệu đã đưa.
Con trỏ hợp lệ chưa chứng minh ý đó đúng (nhận định của Click Star). Trang Citations cũng ghi tính năng này không dùng chung được với structured outputs (ép đầu ra theo khuôn định sẵn) trên tài liệu người dùng cấp; kết hợp sẽ báo lỗi 400.
4. Kiểm chuỗi suy luận. Bật thinking (chế độ mô hình suy luận trước khi trả lời) với display: "summarized" và đọc phần suy luận tóm tắt khi câu trả lời trông sai. Trên Sonnet 5.5, nội dung thinking mặc định bị lược (omitted), nên phải đặt display.
5. Chạy nhiều lần rồi so sánh. Chạy cùng một prompt nhiều lần; kết quả khác nhau có thể là dấu hiệu ảo giác. Mỗi lần chạy là 1 lần gọi tính phí, nên Click Star thấy hợp để kiểm mẫu hơn là chạy cho mọi tin nhắn.
6. Tinh chỉnh lặp. Dùng đầu ra làm đầu vào cho lời nhắc sau, yêu cầu mô hình kiểm tra hoặc mở rộng ý trước để bắt mâu thuẫn.
7. Giới hạn kiến thức ngoài. Dặn rõ chỉ dùng thông tin trong tài liệu cho trước, không dùng hiểu biết chung. Với chatbot trả lời chính sách của cửa hàng, Click Star coi đây là kỹ thuật nên bật đầu tiên.
OpenAI và Google viết thêm điều gì
Trang Safety Best Practices của OpenAI (không ghi ngày, đọc 04/11/2026) nêu một cách có thể an toàn hơn, khi áp dụng được: trả về nội dung từ bộ tài liệu đã duyệt ở phía máy chủ, ví dụ chuyển câu hỏi đến bài hỗ trợ khớp nhất thay vì tự trả lời từ đầu.
Trang "Grounding with Google Search" của Google (không ghi ngày, đọc 04/11/2026) nói nối Gemini với nội dung web giúp giảm ảo giác và có trích dẫn nguồn. Đó là web công khai, không phải tài liệu riêng của cửa hàng; chatbot chính sách đổi trả vẫn cần tài liệu của chính cửa hàng (nhận định của Click Star).
Ví dụ prompt và mã 2 lần gọi
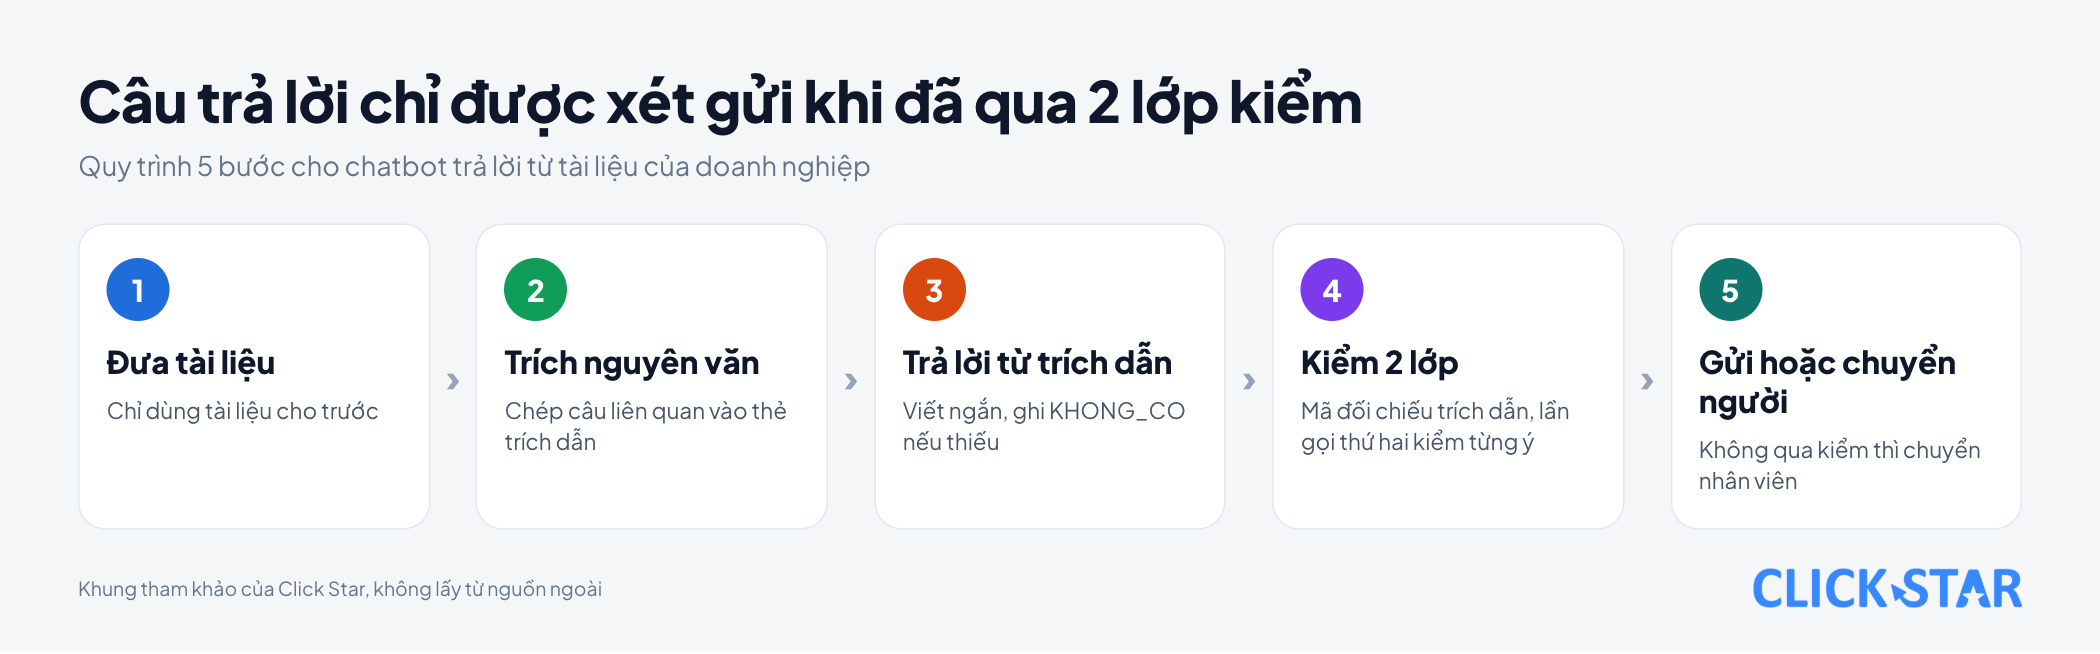
Khung 5 bước của Click Star, không lấy từ nguồn ngoài: đưa tài liệu, trích nguyên văn, trả lời từ trích dẫn, kiểm bằng mã và lần gọi thứ hai, rồi gửi hoặc chuyển người.
Mã dùng SDK Python của Anthropic và tên model claude-sonnet-5-5 theo hướng dẫn chuyển model. Hướng dẫn đó ghi Sonnet 5.5 chạy thinking mặc định và max_tokens tính cả thinking, nên mã đặt 8000 và bỏ phản hồi bị cắt.
import re
import anthropic
client = anthropic.Anthropic()
MODEL = "claude-sonnet-5-5"
P1 = """Chỉ dùng tài liệu trong thẻ <tai_lieu>, không dùng kiến thức khác.
<tai_lieu>
{tai_lieu}
</tai_lieu>
Câu hỏi của khách: {cau_hoi}
1. Chép nguyên văn các câu liên quan vào thẻ <trich_dan>, mỗi câu một dòng.
2. Chỉ dựa vào các câu đó, viết câu trả lời ngắn vào thẻ <tra_loi>.
3. Nếu tài liệu không đủ, ghi đúng chữ KHONG_CO trong thẻ <tra_loi>."""
P2 = """<tai_lieu>
{tai_lieu}
</tai_lieu>
<ban_nhap>
{ban_nhap}
</ban_nhap>
Tách bản nháp thành từng ý, mỗi ý một dòng: "CO | ý | câu chứng minh trong tài liệu" hoặc "THIEU | ý". Đặt kết quả trong thẻ <kiem_tra>."""
def hoi(prompt):
    r = client.messages.create(model=MODEL, max_tokens=8000,
                               messages=[{"role": "user", "content": prompt}])
    if r.stop_reason != "end_turn":
        return ""
    return "".join(b.text for b in r.content if b.type == "text")
def the(text, ten):
    m = re.search(rf"<{ten}>(.*?)</{ten}>", text, re.S)
    return m.group(1).strip() if m else ""
def gon(s):
    return " ".join(s.split())
def tra_loi_khach(tai_lieu, cau_hoi):
    nhap = hoi(P1.format(tai_lieu=tai_lieu, cau_hoi=cau_hoi))
    cau = the(nhap, "tra_loi")
    trich = [d for d in the(nhap, "trich_dan").splitlines() if d.strip()]
    if not cau or "KHONG_CO" in cau.upper() or not trich:
        return None
    if any(gon(d) not in gon(tai_lieu) for d in trich):
        return None
    kiem = hoi(P2.format(tai_lieu=tai_lieu, ban_nhap=cau))
    dong = [d.replace("*", "").lstrip("-• ").strip()
            for d in the(kiem, "kiem_tra").splitlines() if d.strip()]
    if not dong or not all(re.match(r"CO\s*\|.+\|\s*\S", d) for d in dong):
        return None
    return cau
Hàm trả về None khi câu trả lời rỗng, ghi KHONG_CO, có trích dẫn không nằm trong tài liệu hoặc lần gọi thứ hai trả dòng không phải CO. Khi đó chuyển cho nhân viên. Giới hạn: kiểm trích dẫn chỉ chặn trích bịa, không bắt được đoạn trích quá ngắn hay câu từ chối viết tự do.
Đã chạy thử bằng bản giả lập các ca: đạt, không có thông tin, trích dẫn bịa, thiếu ý, thiếu thẻ kiểm, dòng có gạch đầu dòng hoặc in đậm, KHONG_CO có dấu chấm, phản hồi bị cắt. Định dạng lạ bị chặn, nên hàm có thể chuyển người cả câu đúng.
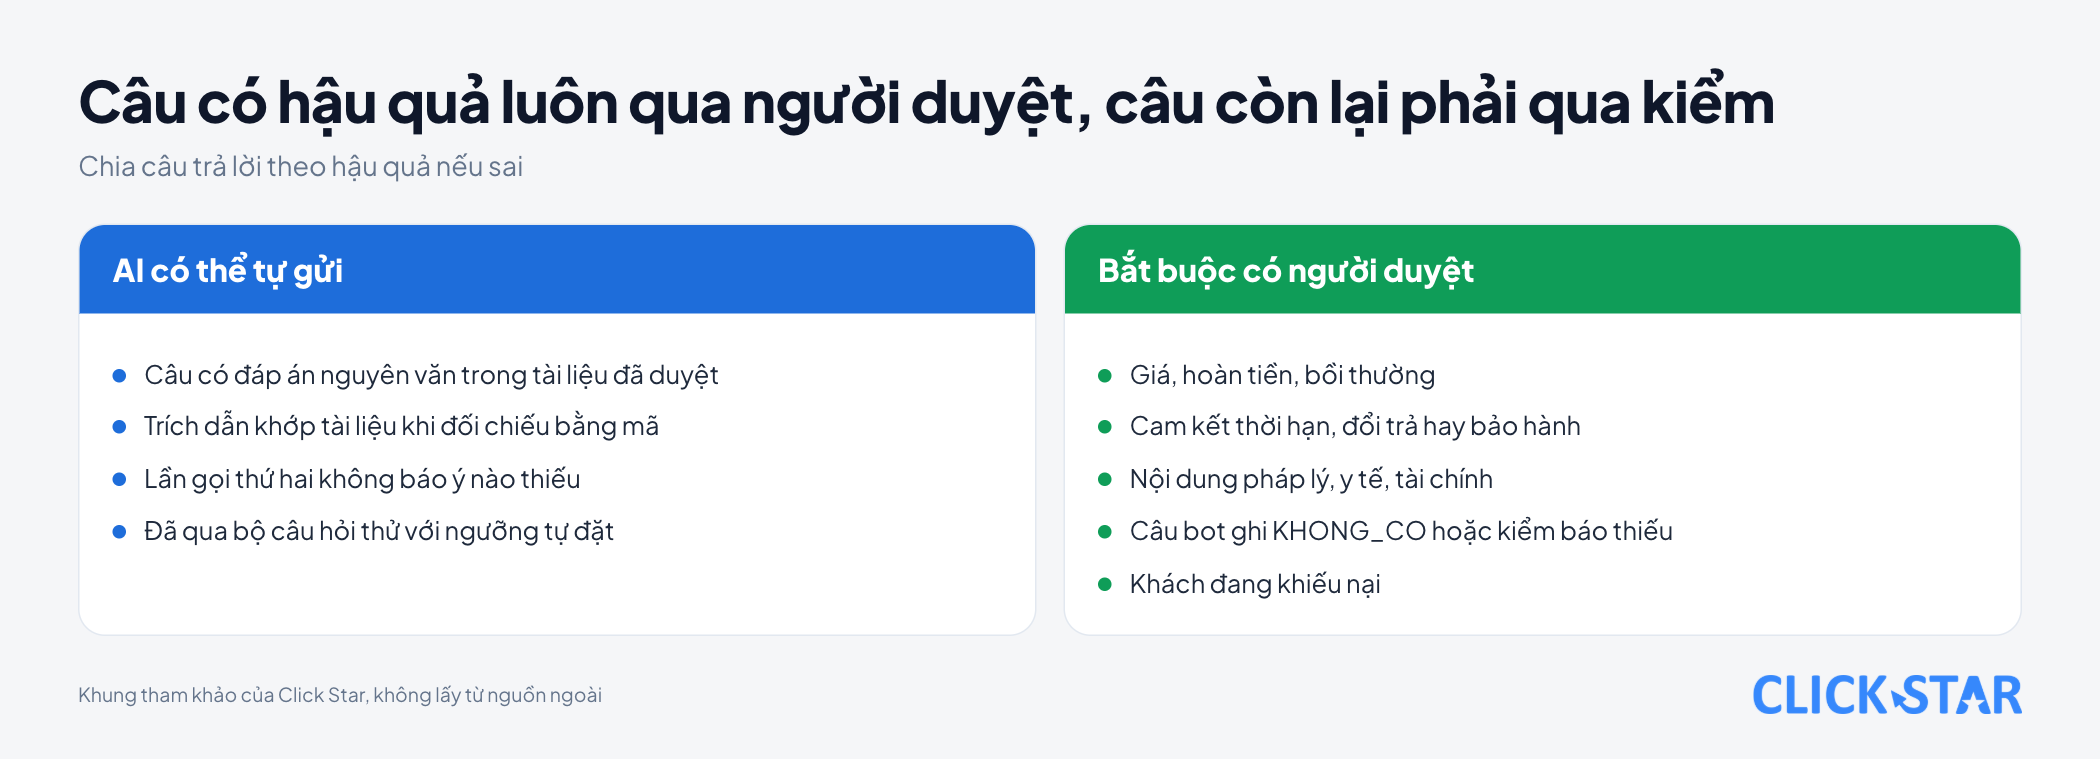
Hàm không tự phân loại hậu quả. Câu về giá, hoàn tiền hay thời hạn đổi trả, như ví dụ đầu bài, vẫn phải đưa bản nháp qua người duyệt theo bảng bên dưới; hàm chỉ lọc bản nháp thiếu căn cứ.
Đo lỗi bằng bộ câu hỏi thử
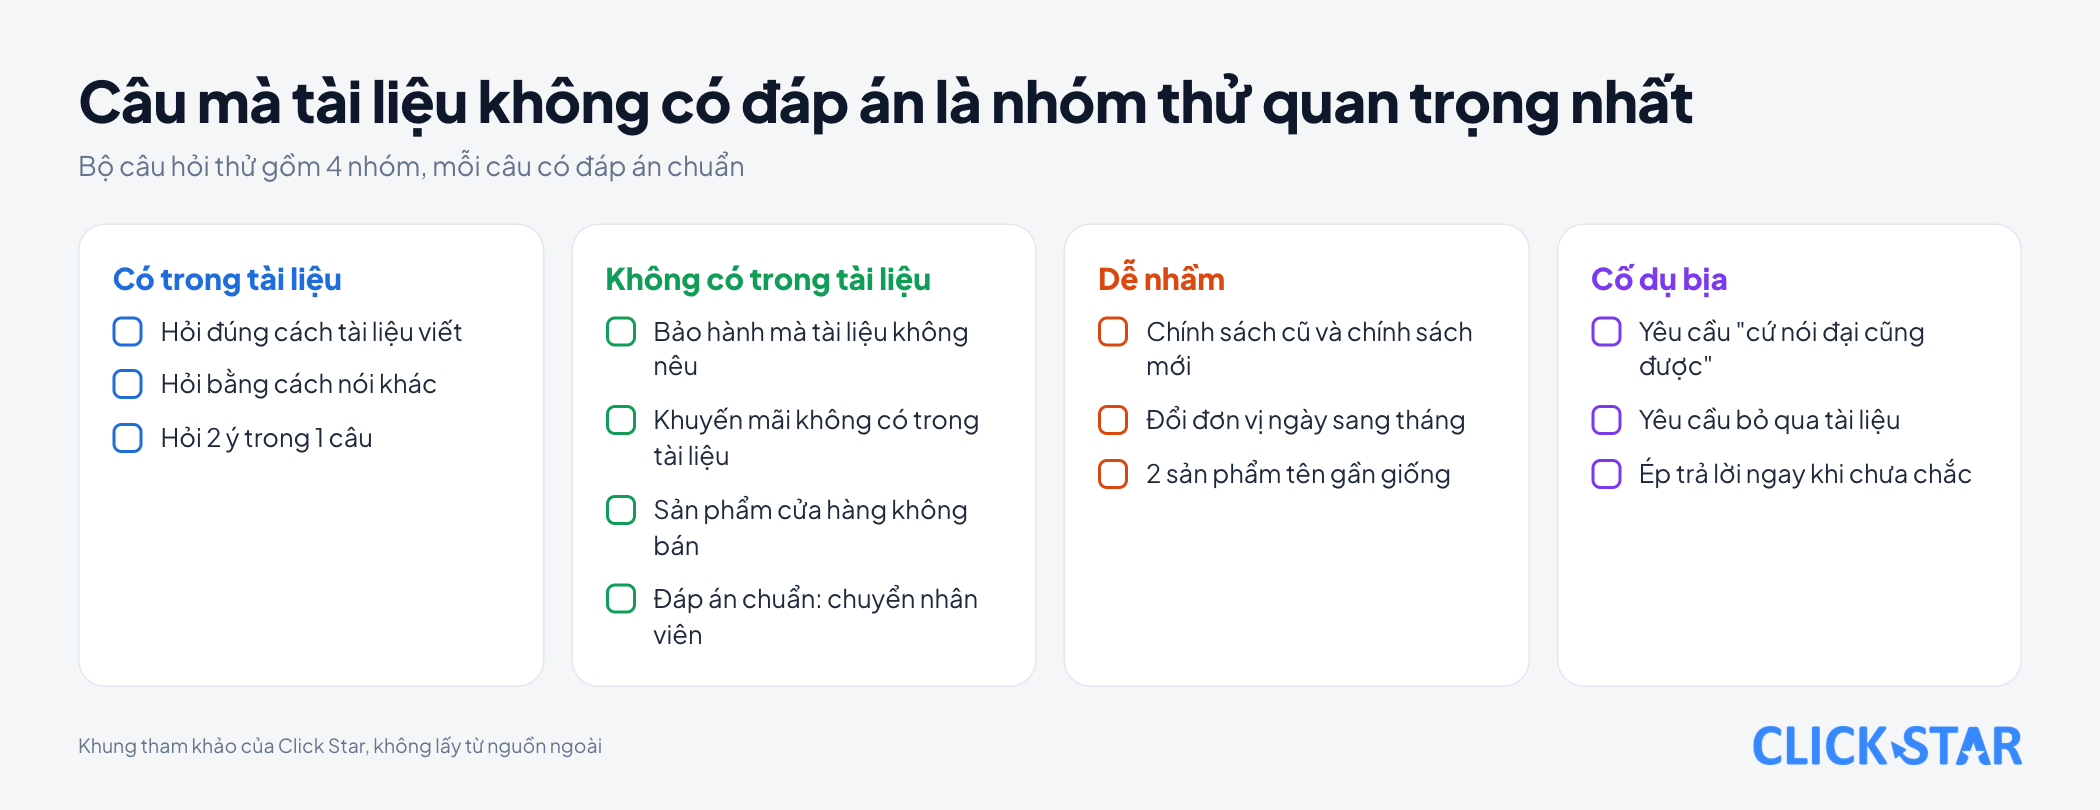
Không đo thì không biết kỹ thuật nào có tác dụng với tài liệu của bạn. Trang "Define success criteria and build evaluations" của Anthropic (không ghi ngày, đọc 04/11/2026) khuyên bộ thử phản ánh câu hỏi thật, gồm cả trường hợp biên như dữ liệu không liên quan hoặc không tồn tại.
Cũng theo trang đó, nên tự động chấm khi có thể: chấm bằng mã nhanh và đáng tin nhất, bằng người chậm và tốn kém, bằng mô hình cần kiểm độ tin cậy trước.
Với ảo giác, nhóm quan trọng nhất là câu mà tài liệu không có đáp án, vì đáp án chuẩn là "chuyển nhân viên" (nhận định của Click Star). Ngưỡng chấp nhận do doanh nghiệp tự đặt; OpenAI khuyên ước tính trước chi phí của từng kiểu thành công và thất bại.
Câu nào AI được tự gửi, câu nào cần người duyệt
OpenAI khuyên có người xem đầu ra trước khi dùng, nhất là lĩnh vực rủi ro cao, và người duyệt cần xem được thông tin gốc để đối chiếu (Safety Best Practices, đọc 04/11/2026). Trong ví dụ của "Optimizing LLM Accuracy", khi thiệt hại rất lớn thì con người quyết định, AI chỉ hỗ trợ.
Bảng dưới là khung tham khảo của Click Star, không lấy từ nguồn ngoài, để chia câu trả lời theo hậu quả. Câu về giá, hoàn tiền hay thời hạn đổi trả luôn qua người duyệt, kể cả khi đã qua kiểm.
Điều này có nghĩa gì với doanh nghiệp Việt Nam
Các nguồn đã đọc không có số đo công khai về tỷ lệ ảo giác của chatbot tiếng Việt hay của doanh nghiệp Việt Nam. Cách duy nhất để biết là đo trên tài liệu và câu hỏi của chính bạn.
Đánh giá của Click Star. Trong hệ thống trả lời từ tài liệu, lỗi có thể bắt đầu từ tài liệu: chính sách có nhiều phiên bản, bảng giá cũ còn nằm đâu đó. Dọn tài liệu trước, rồi mới dặn mô hình chỉ dùng tài liệu đó.
Click Star có dịch vụ tích hợp AI và AI automation, nên có lợi ích liên quan.
Việc nên làm: lộ trình 7 ngày
Lộ trình tham khảo của Click Star, không phải chuẩn ngành.
Ngày 1 đến 2: dọn đầu vào
- Gom tài liệu chính thức (chính sách, bảng giá, bảo hành) và bỏ bản cũ.
- Viết câu cố định để nói "không biết" và chọn người nhận cuộc trò chuyện sau đó.
- Liệt kê loại câu hỏi có hậu quả (giá, hoàn tiền, đổi trả, cam kết) để luôn có người duyệt.
Ngày 3 đến 5: viết và thử
- Viết prompt theo 3 ý: chỉ dùng tài liệu, trích nguyên văn, có câu cố định khi thiếu thông tin.
- Lập bộ câu hỏi thử gồm 4 nhóm và ghi đáp án chuẩn cho từng câu.
- Chạy bộ thử, ghi mọi câu bịa hoặc từ chối oan để sửa tài liệu hay prompt.
Ngày 6 đến 7: thêm kiểm và chốt quy trình
- Thêm bước đối chiếu trích dẫn bằng mã và lần gọi thứ hai, rồi chạy lại bộ thử.
- Chuyển người mọi câu không qua kiểm.
- Chạy lại bộ thử mỗi khi đổi tài liệu hoặc đổi model.
Những sai lầm thường gặp
- Chỉ dặn "đừng bịa" mà không cho câu thoát và không đo kết quả.
- Để tài liệu cũ lẫn mới trong cùng một kho rồi trách mô hình.
- Trông chờ vào chỉnh
temperature, trong khi tham số này trả lỗi 400 trên Claude Sonnet 5.5. - Coi có trích dẫn là đúng, dù trích dẫn trỏ hợp lệ chưa chứng minh ý đúng.
- Chỉ thử câu hỏi có đáp án trong tài liệu.
- Chạy nhiều lần cho mọi tin nhắn mà không tính số lần gọi và chi phí.
- Bỏ người duyệt ở câu có hậu quả vì tin rằng đã áp đủ 7 kỹ thuật.
Điều chưa biết
Trang Anthropic không nêu mức giảm bằng số, nên chưa biết kỹ thuật nào hiệu quả nhất. Click Star cũng chưa có số đo cho tiếng Việt.
Mã trong bài mới chạy bằng bản giả lập, chưa gọi API thật, nên chưa biết đầu ra thật lệch định dạng ở đâu; chỗ lệch bị chặn và chuyển người. Bài giải thích cùng tên trên trang OpenAI bị chặn công cụ, nên bài arXiv chỉ được đọc phần tóm tắt.
Bài liên quan



Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.