Giới hạn tốc độ và lỗi 429 khi gọi API AI: thử lại, hàng đợi và dự phòng
Cách phân loại lỗi 429 và lỗi quá tải, thử lại có lùi dần và ngẫu nhiên, dùng hàng đợi, API lô và mô hình dự phòng khi gọi API AI. Dựa trên tài liệu Anthropic, OpenAI, RFC, AWS và Google SRE.
Ứng dụng gọi API mô hình AI sớm muộn sẽ nhận lỗi 429 (quá nhiều yêu cầu) hoặc lỗi quá tải. Nếu mã chỉ biết thử lại ngay, nó thường làm tình hình xấu hơn, tốn thêm tiền và khiến khách chờ lâu.
Bài đối chiếu đến ngày 23/10/2026, dựa trên tài liệu của Anthropic và OpenAI, 2 chuẩn RFC, các bài của AWS và sách Google SRE. Trang tài liệu của hãng AI không ghi ngày cập nhật, nên Click Star ghi ngày đọc.
Bài trả lời: mỗi nhóm lỗi xử lý ra sao, thử lại thế nào cho an toàn, khi nào cần hàng đợi và mô hình dự phòng. Click Star đã có bài riêng về tối ưu token và AI agent.
Điểm chính
- Lỗi 429 có 2 nguyên nhân. Vượt giới hạn tốc độ thì chờ rồi thử lại được; chạm trần chi tiêu thì thử lại vô ích (không có retry-after, API tạm dừng đến đầu tháng sau, theo tài liệu Anthropic).
- Có retry-after thì chờ đúng số giây đó. Không có thì lùi dần theo cấp số nhân kèm yếu tố ngẫu nhiên (jitter), giới hạn số lần và tổng thời gian chờ.
- Thử lại ở nhiều lớp sẽ nhân lên: theo sách Google SRE, 3 lớp cùng thử lại 3 lần có thể tạo 64 lượt gọi lên tầng dưới cùng. Chỉ thử lại ở 1 lớp.
- Request dài nên dùng phát trực tuyến, nhưng lỗi vẫn có thể đến sau khi API đã trả 200.
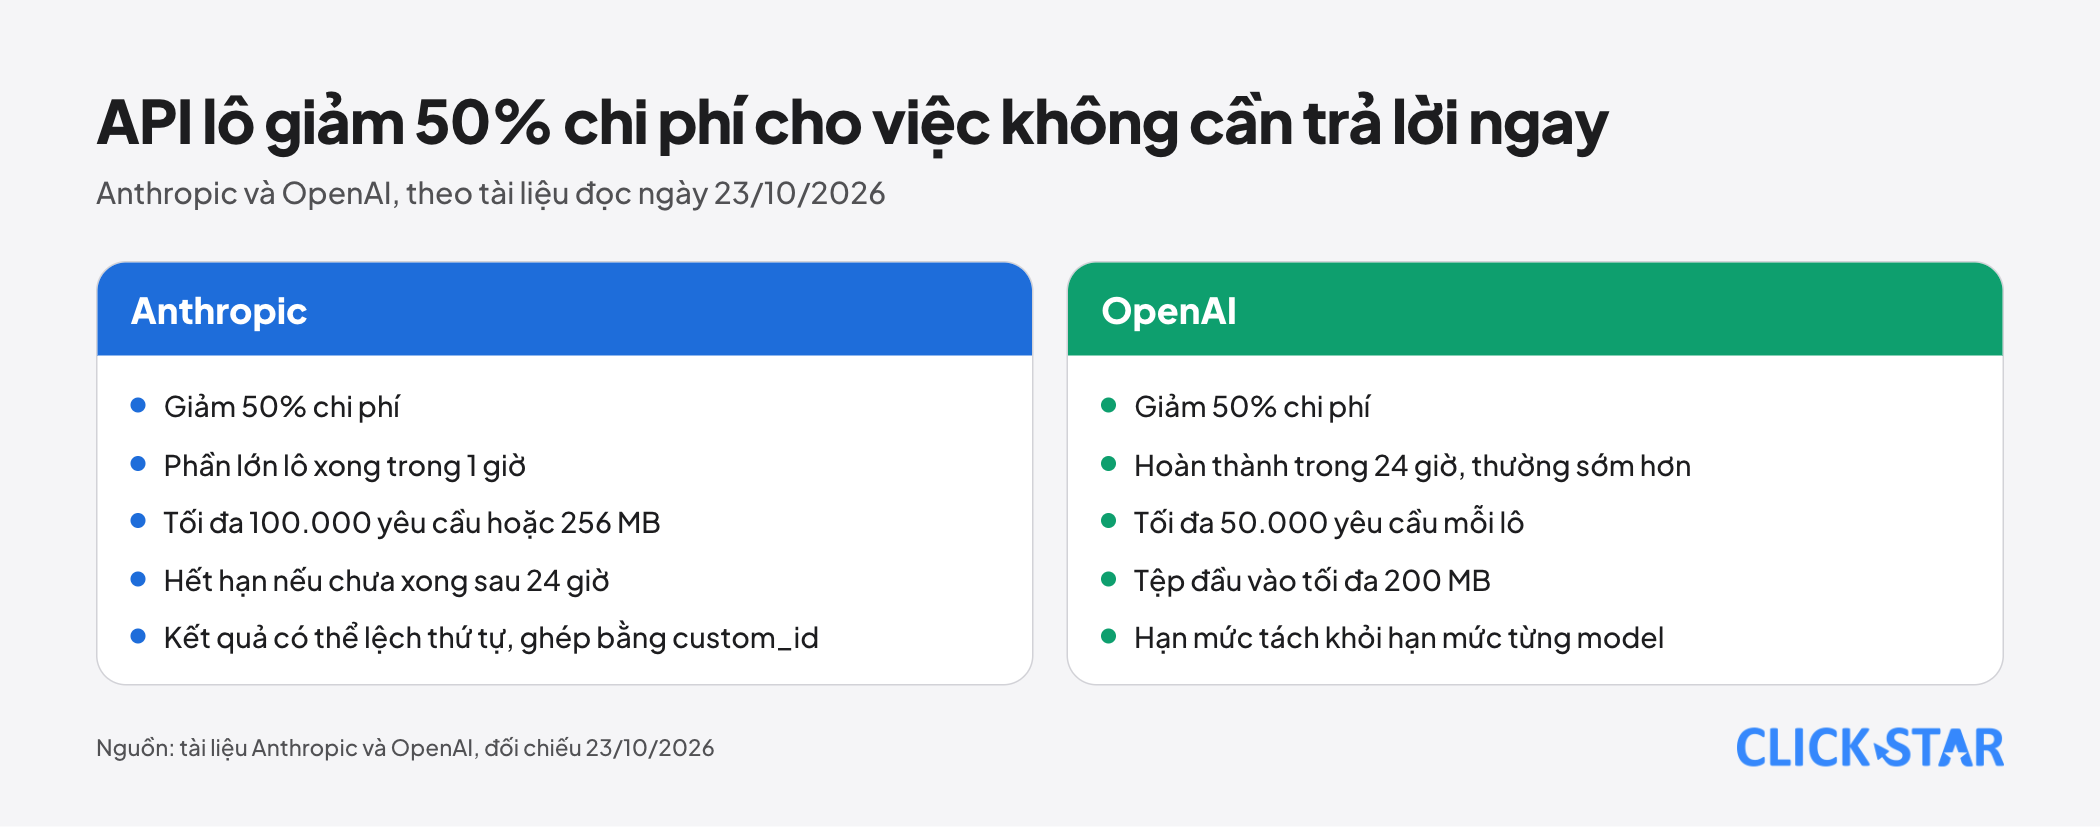
- Việc không cần trả lời ngay nên chuyển sang API lô: cả Anthropic và OpenAI ghi giảm 50% chi phí và có hạn mức riêng cho API này.
- Lớp cuối là mô hình dự phòng, trần ngân sách và nhật ký (log). Tham số thử lại và lộ trình trong bài là khung tham khảo của Click Star, chưa kiểm trên dữ liệu Việt Nam.
Giới hạn tốc độ và lỗi 429: vì sao ứng dụng gặp nó
Theo RFC 6585 (tháng 4/2012), mã 429 nghĩa là người dùng gửi quá nhiều yêu cầu trong một khoảng thời gian; tiêu đề Retry-After đi kèm là tùy chọn.
Theo tài liệu Anthropic (đọc ngày 23/10/2026), giới hạn của Messages API tính theo 3 đại lượng cho từng nhóm model: số yêu cầu mỗi phút (RPM), token đầu vào mỗi phút (ITPM) và token đầu ra mỗi phút (OTPM). Vượt bất kỳ giới hạn nào cũng nhận 429.
Anthropic dùng thuật toán thùng token (token bucket): dung lượng được nạp lại liên tục. Mức 60 yêu cầu mỗi phút có thể bị áp như 1 yêu cầu mỗi giây, nên một chùm yêu cầu ngắn vẫn gây lỗi. Với phần lớn model, token đọc từ bộ nhớ đệm không tính vào ITPM, và max_tokens không tính vào OTPM.
OpenAI (đọc ngày 23/10/2026) đo bằng RPM, RPD (mỗi ngày), TPM, TPD và IPM (ảnh mỗi phút); hạn mức nào chạm trước thì áp dụng. Giới hạn đặt ở cấp tổ chức và dự án, không phải cấp người dùng.
Khác biệt: OpenAI tính hạn mức theo giá trị lớn hơn giữa max_tokens và ước tính từ số ký tự yêu cầu, nên max_tokens quá cao giữ chỗ vô ích. Cả 2 hãng xếp tổ chức vào các bậc dùng (tier); Click Star không nêu con số hạn mức vì số khác nhau theo tài khoản, hãy xem trong Console của bạn.
Anthropic còn cảnh báo 429 do giới hạn tăng tốc khi lưu lượng tăng vọt. OpenAI có mã slow_down tương tự, kèm quy tắc kinh nghiệm: trên 1 triệu TPM đầu vào, đừng tăng quá 50% mỗi 15 phút (trang mã lỗi).
2 loại 429: chờ được và không chờ được
Theo Anthropic, khi tổ chức chạm trần chi tiêu hằng tháng của bậc, API tạm dừng đến 00:00 UTC ngày đầu tháng sau. Yêu cầu nhận 429 với mã chi tiết enforced_spend_limit_reached, không có retry-after, và thử lại, kể cả SDK tự thử lại, đều thất bại.
Nếu bạn tự đặt giới hạn chi tiêu thấp hơn, Anthropic thường trả HTTP 400 khi chạm giới hạn đó, không phải 429. Ngoại lệ là workspace Claude Code, có thể nhận 429 kèm retry-after.
OpenAI tách tương tự: credit_balance_exhausted và các mã organization_spend_limit_exceeded, project_spend_limit_exceeded, organization_usage_limit_exceeded là 429 mà thử lại không khôi phục được quyền truy cập. Hệ quả: bộ phân loại lỗi phải đọc loại và mã chi tiết, không chỉ mã HTTP; lỗi chi tiêu nên báo người phụ trách.
Mỗi nhóm lỗi nên xử lý ra sao
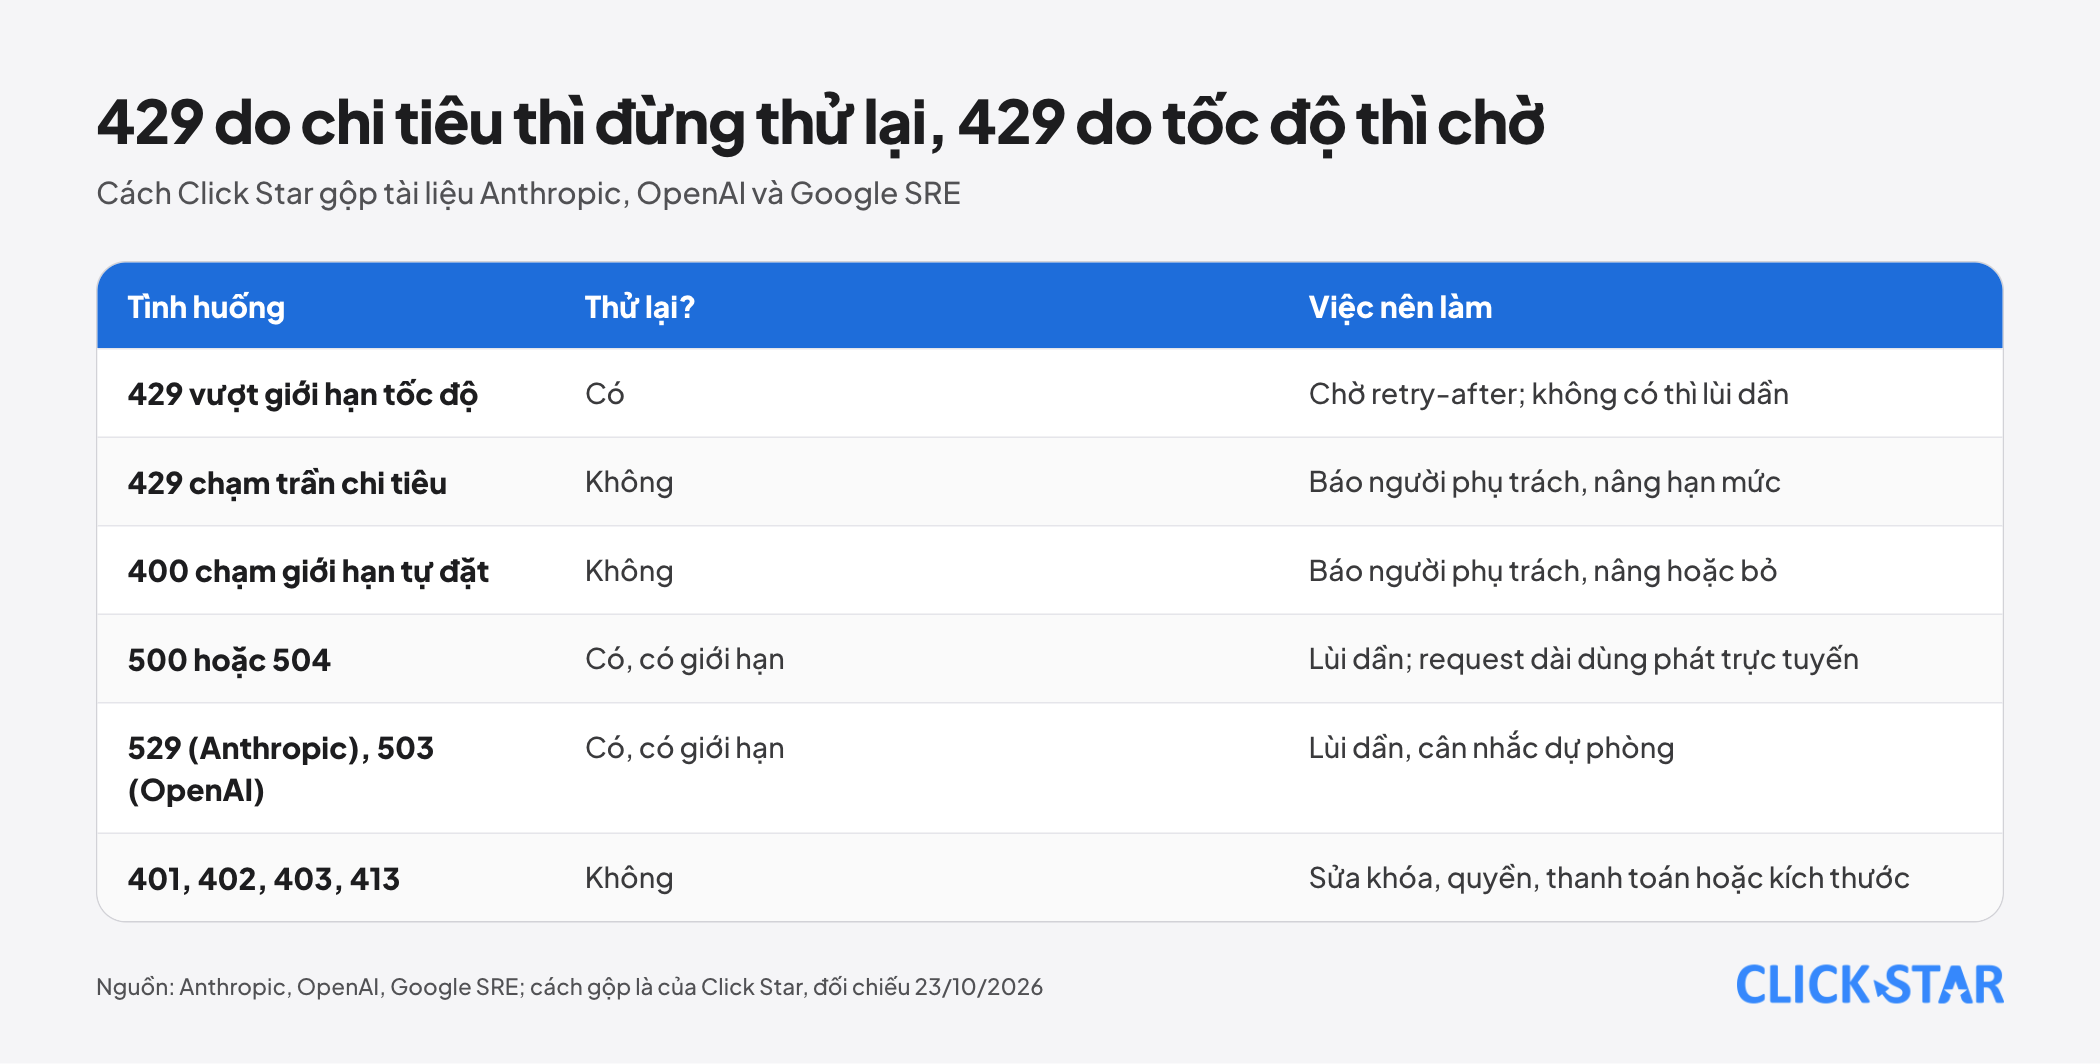
Trang lỗi của Anthropic (đọc ngày 23/10/2026) liệt kê 400, 401, 402, 403, 404, 409, 413 (yêu cầu quá lớn), 429, 500, 504 và 529 (quá tải). Với 500, tài liệu khuyên thử lại có lùi dần. Với 504, khuyên dùng phát trực tuyến cho request dài.
OpenAI dùng 503 (server_is_overloaded) cho quá tải: làm theo Retry-After nếu có, nếu không thì tăng dần khoảng cách giữa các lần thử. Sách Google SRE khuyên tách lỗi thử lại được khỏi lỗi không thử lại được, và không thử lại lỗi vĩnh viễn hay yêu cầu sai định dạng. Bảng ở đầu bài là cách Click Star gộp các nguồn thành quyết định.
Thử lại có lùi dần và ngẫu nhiên
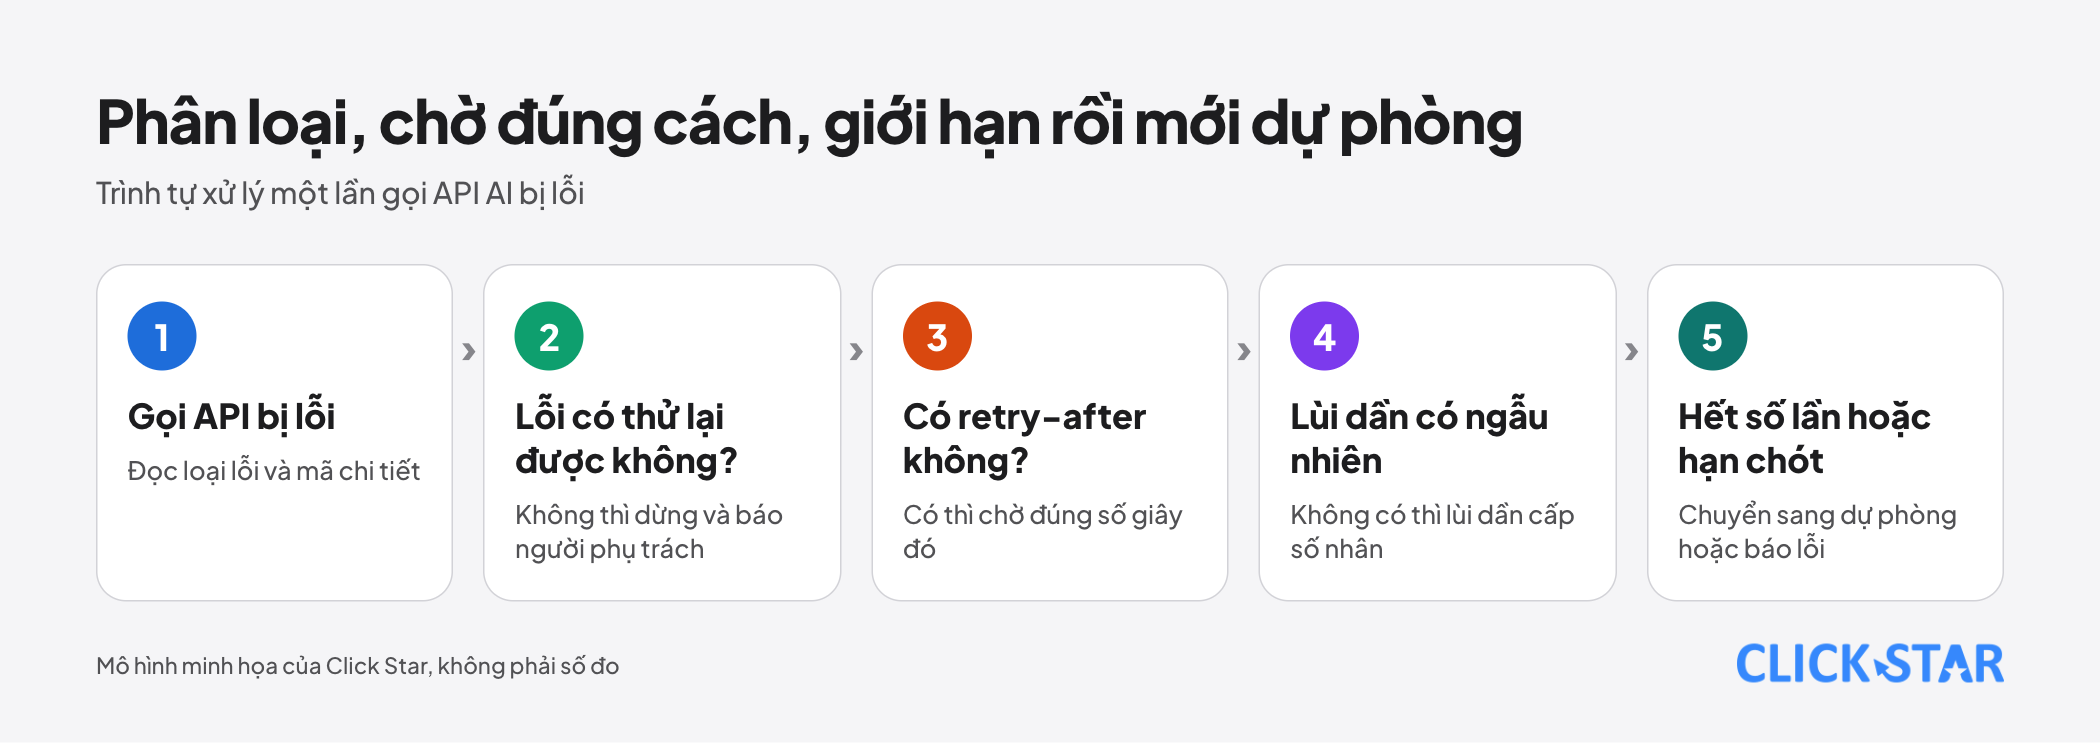
Theo RFC 9110 (tháng 6/2022), Retry-After là một ngày giờ HTTP hoặc số giây phải chờ. Anthropic ghi thử lại sớm hơn sẽ thất bại, và không phải 429 nào cũng có tiêu đề này.
Khi không có tiêu đề, dùng lùi dần có trần và thêm ngẫu nhiên. Bài của AWS Architecture Blog (Marc Brooker, 4/3/2015, cập nhật 5/2023) mô phỏng 100 client tranh chấp ghi cơ sở dữ liệu: lùi dần không ngẫu nhiên chỉ giảm việc chút ít, thêm jitter giảm số lượt gọi hơn một nửa.
Giới hạn: mô phỏng nói về cơ sở dữ liệu, không phải API AI; nguyên lý chung, con số thì không áp nguyên được. Google SRE khuyên giới hạn thử lại mỗi yêu cầu, và nêu ví dụ ngân sách 60 lần thử lại mỗi phút cho cả tiến trình, hết thì để yêu cầu thất bại.
Cách thêm ngẫu nhiên phổ biến là chờ một khoảng ngẫu nhiên từ 0 đến mức trần hiện tại của lùi dần (mô tả của Click Star). Hãy đặt số lần, trần và hạn chót theo từng chức năng: chatbot đang chờ khách cần hạn chót ngắn hơn tác vụ chạy ban đêm.
SDK đã thử lại thay bạn
Theo tài liệu SDK Python của Anthropic, lỗi kết nối, 408, 409, 429 và lỗi từ 500 trở lên được thử lại tự động 2 lần theo mặc định; max_retries đổi hoặc tắt việc này. README SDK Python của OpenAI (GitHub) ghi cùng cách.
Vậy mỗi lệnh gọi đã có thể là tối đa 3 lượt. Nếu bạn bọc thêm vòng gồm 3 lượt gọi, 1 yêu cầu thành tối đa 9 lượt (phép nhân do Click Star tự tính). OpenAI ghi yêu cầu thất bại vẫn tính vào giới hạn mỗi phút.
Thời gian chờ, phát trực tuyến và luồng bị cắt
Thời gian chờ mặc định của SDK Python (Anthropic và OpenAI) là 10 phút. Anthropic khuyên dùng phát trực tuyến hoặc API lô cho request dài, vì một số mạng cắt kết nối rảnh.
Phát trực tuyến có bẫy: Anthropic ghi lỗi có thể đến sau khi API đã trả 200, dạng sự kiện error trong luồng (ví dụ overloaded_error, tương ứng 529). README SDK OpenAI ghi việc đọc luồng không được tự thử lại.
Anthropic mô tả cách khôi phục: lưu phần đã nhận, gửi yêu cầu mới kèm phần đó để model viết tiếp; khối gọi công cụ và khối suy luận không khôi phục một phần được. Hãy kiểm tra stop_reason: giá trị max_tokens nghĩa là câu trả lời bị cắt, không nên đi thẳng vào CRM hay gửi cho khách.
Nếu bước sau có tác dụng phụ (tạo khách hàng, gửi tin nhắn), hãy dùng khóa chống trùng. Bài AWS Builders' Library về API idempotent nói API có tác dụng phụ cần có tính idempotent để thử lại an toàn. Click Star đã có bài về webhook.
Hàng đợi, giới hạn đồng thời và API lô
Phòng hơn chữa: đặt hàng đợi và giới hạn số lệnh gọi đồng thời trước API để tải đều (đề xuất của Click Star). Hãy đọc tiêu đề phản hồi để biết còn bao nhiêu hạn mức: anthropic-ratelimit-*-remaining ở Anthropic, x-ratelimit-remaining-requests và x-ratelimit-remaining-tokens ở OpenAI.
Với việc không cần trả lời ngay, API lô tránh tranh hạn mức với lưu lượng thời gian thực. Anthropic ghi giảm 50% chi phí, phần lớn lô xong trong 1 giờ, tối đa 100.000 yêu cầu hoặc 256 MB mỗi lô, và lô hết hạn nếu chưa xong sau 24 giờ.
OpenAI ghi giảm 50% chi phí, hoàn thành trong 24 giờ (thường sớm hơn), tối đa 50.000 yêu cầu mỗi lô, tệp đầu vào tối đa 200 MB, và hạn mức API lô tách khỏi hạn mức từng model. Kết quả lô của Anthropic có thể không theo thứ tự, phải ghép bằng custom_id.
Mô hình dự phòng: khi nào có ích
Dự phòng nghĩa là sau số lần thử đã định, ứng dụng chuyển sang model hoặc nhà cung cấp khác. Nó chỉ có ích với lỗi tạm thời (quá tải, 5xx, giới hạn tốc độ), không có ích với lỗi cấu hình hay chạm trần chi tiêu.
Cần kiểm tra dự phòng có dùng chung hạn mức không. Bảng hạn mức của Anthropic có dòng gộp nhiều model chung một hạn mức và dòng có hạn mức riêng; chuyển sang model cùng nhóm gộp không giải quyết 429.
Theo trang hạn mức, chạm trần chi tiêu làm việc dùng API tạm dừng cho cả tổ chức. Suy luận của Click Star: dự phòng sang model khác cùng tổ chức không cứu được trường hợp này.
Dự phòng sang nhà cung cấp khác có cái giá: chất lượng và phong cách khác, và dữ liệu khách hàng đi đến bên thứ 2 nên cần xem điều khoản xử lý dữ liệu.
Click Star khuyên chạy bộ câu hỏi mẫu qua model dự phòng trước khi cần, và ghi vào nhật ký model nào đã trả lời.
Trần ngân sách và nhật ký
Anthropic cho đặt giới hạn chi tiêu thấp hơn trần của bậc, ở cấp tổ chức và workspace (không đặt được cho workspace mặc định); OpenAI có mã lỗi cho giới hạn chi tiêu cấp tổ chức và dự án. Click Star khuyên báo động trước khi chạm trần, vì vòng lặp lỗi hay khóa bị lộ có thể đốt tiền rất nhanh.
Anthropic trả mã yêu cầu trong tiêu đề request-id và thân lỗi; hãy ghi mã này cho mọi lời gọi lỗi để gửi kèm khi liên hệ hỗ trợ.
Nhật ký tối thiểu mỗi lời gọi (khung tham khảo của Click Star): thời điểm, chức năng, model, số lần thử, mã lỗi, thời gian chờ, có dùng dự phòng không, số token vào và ra. Đừng ghi nội dung đầy đủ nếu có dữ liệu cá nhân.
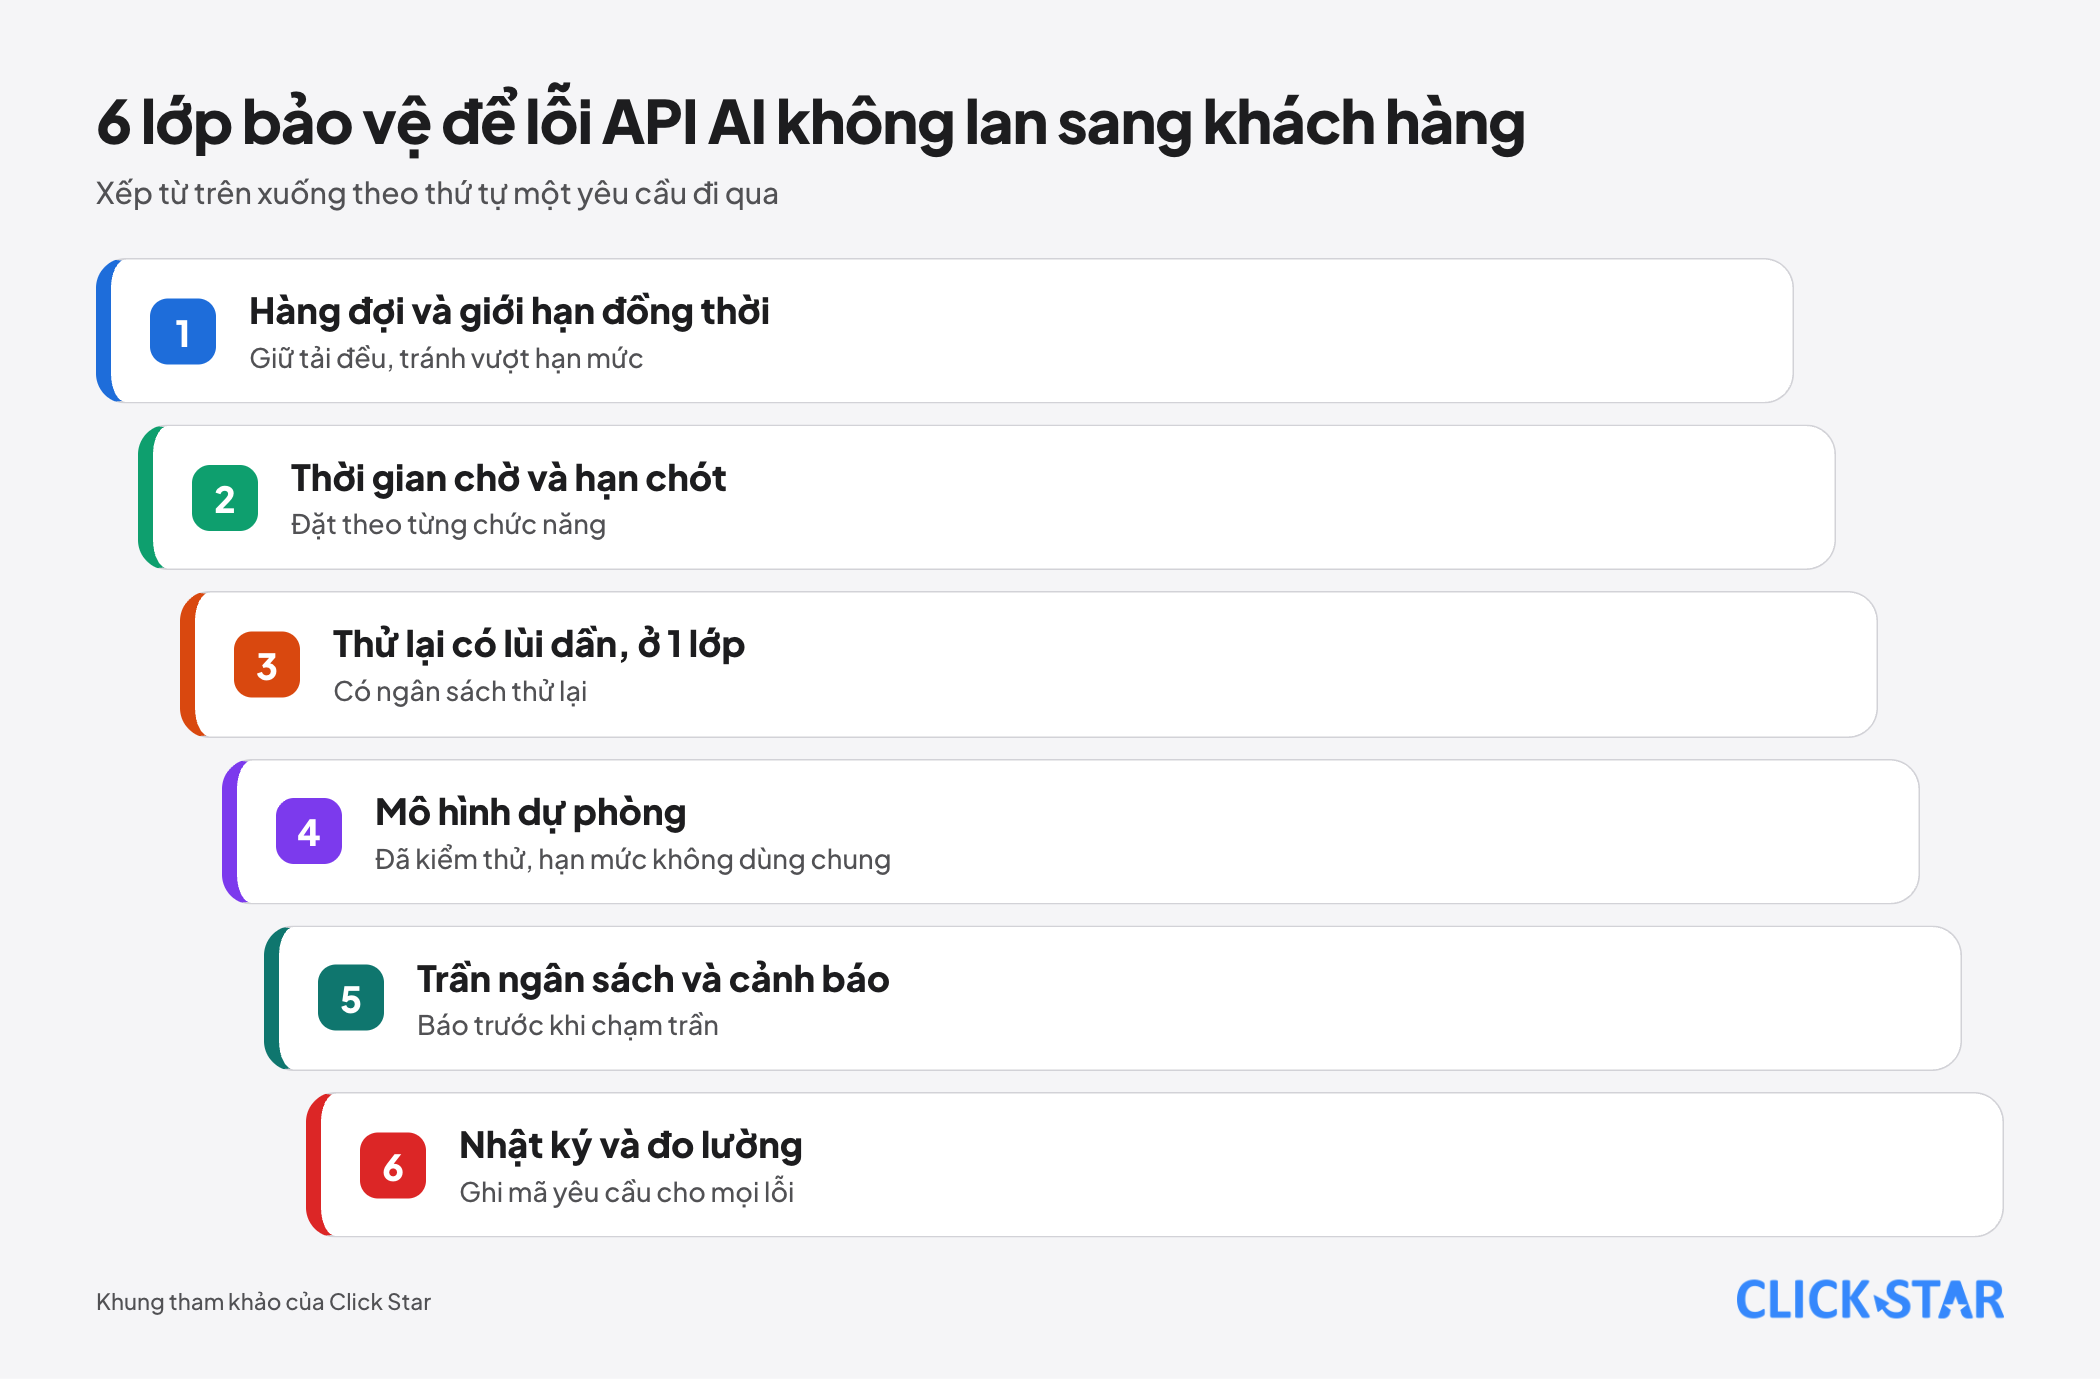
Đánh giá của Click Star. Lỗi 429 là tín hiệu bình thường của một dịch vụ dùng chung. Phần khó không nằm ở đoạn mã thử lại, mà ở việc phân loại đúng lỗi, giới hạn khuếch đại và quyết định trước điều gì xảy ra khi hết đường lui.
Nên bắt đầu đơn giản: phân loại lỗi, thử lại có ngẫu nhiên ở 1 lớp, hạn chót, trần ngân sách và nhật ký. Hàng đợi và dự phòng nhà cung cấp thứ 2 chỉ thêm khi nhật ký cho thấy cần.
Công khai lợi ích: Click Star có làm dịch vụ tích hợp AI và AI automation. Các điểm trên là nhận định kỹ thuật, không phải số đo từ dự án của Click Star.
Việc nên làm: lộ trình 4 tuần
Khung tham khảo của Click Star, không từ nguồn ngoài, chưa thử trên dữ liệu Việt Nam.
- Tuần 1: liệt kê mọi nơi gọi API AI; ghi max_retries đang dùng và vòng thử lại tự viết chồng lên.
- Tuần 2: viết bộ phân loại lỗi (thử lại, không thử lại, báo người phụ trách); đặt hạn chót theo chức năng.
- Tuần 3: thêm lùi dần có ngẫu nhiên, ngân sách thử lại, trần chi tiêu, cảnh báo và nhật ký.
- Tuần 4: chuyển việc không gấp sang API lô; giả lập lỗi 429 và 529 trên môi trường kiểm thử; chạy bộ câu hỏi mẫu qua model dự phòng.
Cách đo hệ thống còn khỏe
Khung tham khảo của Click Star, không có ngưỡng chuẩn ngành. Theo dõi 6 chỉ số: tỷ lệ yêu cầu nhận 429 và 5xx, số lần thử lại trung bình mỗi yêu cầu, độ trễ ở phân vị cao, tỷ lệ dùng dự phòng, tỷ lệ kết quả bị cắt (stop_reason là max_tokens) và chi tiêu mỗi ngày so với trần.
Những sai lầm thường gặp
- Coi mọi 429 là lỗi thử lại được, trong khi chạm trần chi tiêu cần người xử lý.
- Chỉ bắt mã 429 và bỏ sót HTTP 400 khi chạm giới hạn chi tiêu tự đặt.
- Thử lại ngay, không chờ, không ngẫu nhiên, nên mọi client thử cùng lúc.
- Thử lại ở nhiều lớp (SDK, hàm bọc, hàng đợi, giao diện) khiến lượt gọi nhân lên.
- Đặt max_tokens quá cao trên nhà cung cấp tính hạn mức theo giá trị này.
- Ghi kết quả bị cắt dở vào CRM mà không kiểm stop_reason.
- Có model dự phòng nhưng chưa từng thử, hoặc dự phòng dùng chung hạn mức với model chính.
Điều chưa biết
Click Star không có số đo độ trễ và tỷ lệ lỗi khi gọi các API này từ Việt Nam. Các trang hạn mức của Anthropic và OpenAI không ghi ngày cập nhật, nên bài không nêu hạn mức theo bậc hay giá.
Click Star chưa đọc tài liệu của nhà cung cấp khác (như Google Gemini), của kênh bán lại qua nền tảng đám mây, hay của SDK ngoài Python. Chưa có nguồn ghi yêu cầu đồng bộ bị lỗi có bị tính tiền hay không. Lộ trình và chỉ số chưa kiểm thử trên khối lượng thật.
Bài liên quan



Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.