Website chạy bằng JavaScript thì Google có đọc được nội dung không?
Google chạy được JavaScript nhưng không bấm, không cuộn. Bài giải thích 3 giai đoạn Google xử lý trang, lỗi hay làm bỏ sót nội dung và 5 việc kiểm tra, dựa trên tài liệu Google Search Central.
Một cửa hàng online dựng website bằng JavaScript. Mở trên trình duyệt thì thấy đủ sản phẩm, nhưng gõ đúng tên sản phẩm lên Google lại không thấy trang đâu. Đây là tình huống minh họa, không phải số đo.
Bài này dựa trên tài liệu của Google, web.dev, Next.js và nghiên cứu thứ cấp của Vercel và MERJ, đối chiếu đến ngày 04/11/2026. Click Star không tự thử trên Google, nên điều về hành vi của Google đều lấy từ tài liệu.
Kết luận ngắn: theo Google, Google chạy được JavaScript, nhưng nội dung phải hiện ra mà không cần bấm hay cuộn. Click Star đã có bài riêng về nguyên lý Googlebot, robots.txt và noindex, trang hết hàng 404 và 410.
Điểm chính
- Theo Google (trang cập nhật 04/03/2026), trang JavaScript đi qua 3 giai đoạn: thu thập, hiển thị (render) và lập chỉ mục. Google hiển thị bằng Chromium bản mới.
- Trang trả mã 200 được xếp hàng chờ hiển thị. Nếu HTML gốc có
noindex, mã JavaScript gỡnoindexcó thể không chạy. - Google không tương tác với trang: nội dung chờ bấm hoặc cuộn, địa chỉ dùng
#và liên kết không phải<a href>dễ bị bỏ sót. - Hiển thị động (dynamic rendering) được Google gọi là giải pháp tạm; hướng thay thế là hiển thị phía máy chủ, tĩnh hoặc hydration.
- Thử nghiệm thứ cấp của Vercel và MERJ (tháng 4/2024, chủ yếu trên nextjs.org): độ trễ hiển thị trung vị 10 giây, phân vị 90 khoảng 3 giờ.
Google xử lý trang JavaScript qua những giai đoạn nào
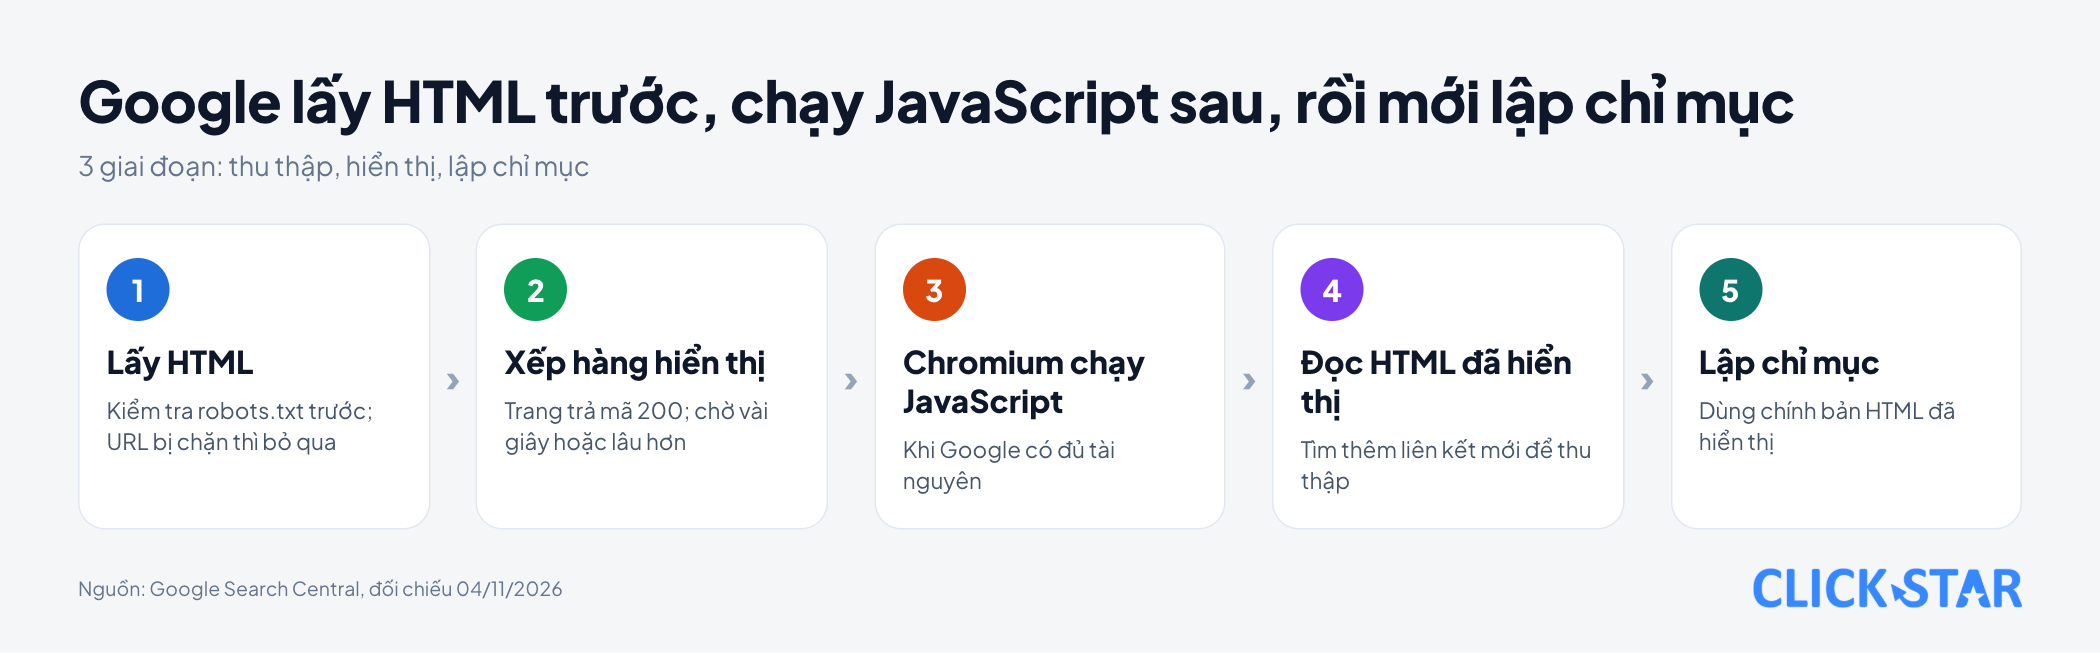
Có 3 giai đoạn: thu thập, hiển thị và lập chỉ mục.
Theo trang "Understand JavaScript SEO Basics" (cập nhật 04/03/2026, đọc 04/11/2026), Googlebot kiểm tra robots.txt rồi lấy HTML. URL bị chặn thì bị bỏ qua, và JavaScript trong tệp bị chặn không được hiển thị.
Trang trả mã 200 được xếp hàng hiển thị, trừ khi thẻ hoặc tiêu đề robots cấm lập chỉ mục. Hàng chờ có thể mất vài giây hoặc lâu hơn. Với mã khác 200, như 404, bước hiển thị có thể bị bỏ qua.
Chromium không giao diện chạy JavaScript khi Google có đủ tài nguyên. Google đọc HTML đã hiển thị để tìm liên kết mới, và dùng chính bản này để lập chỉ mục.
Google đọc được JavaScript đến đâu
Đủ để đọc nhiều trang dựng bằng JavaScript, nhưng có giới hạn rõ. Google vẫn khuyên hiển thị phía máy chủ hoặc dựng sẵn, vì nhanh hơn và không phải bot nào cũng chạy được JavaScript.
Về số đo, có nghiên cứu thứ cấp của Vercel và MERJ (trang "Javascript SEO: How Google Crawls, Renders & Indexes JS", dữ liệu tháng 4/2024, đọc 04/11/2026). Trong hơn 100.000 lượt Googlebot lấy trang ở nextjs.org, 100% trang HTML (đã loại trang lỗi và trang không lập chỉ mục) được hiển thị đầy đủ.
Trên hơn 37.000 cặp dữ liệu, độ trễ từ lúc thu thập đến lúc hiển thị xong là 10 giây ở trung vị, khoảng 3 giờ ở phân vị 90 và khoảng 18 giờ ở phân vị 99.
Giới hạn: Vercel tự đặt công cụ đo lên các website này, chủ yếu nextjs.org. Vercel viết thêm rằng JavaScript phức tạp trên website rất lớn có thể ảnh hưởng hiệu quả thu thập. Chưa có số đo cho Việt Nam.
Trang "Fix Search-Related JavaScript Problems" (cập nhật 18/12/2025) nêu các giới hạn của bộ hiển thị của Google:
- Không giữ trạng thái giữa các lần tải: cookie, Local Storage và Session Storage bị xóa.
- Từ chối yêu cầu quyền như camera, và không hỗ trợ WebSocket hay WebRTC, nên cần phương án HTTP dự phòng.
Về kích thước, trang "What Is Googlebot" (cập nhật 03/02/2026) nêu Googlebot đọc 2MB đầu của mỗi tệp được hỗ trợ, tính trên dữ liệu đã giải nén. Tệp JavaScript và CSS tải riêng, mỗi tệp chịu cùng giới hạn.
Hiển thị phía máy chủ, hiển thị tĩnh hay phía máy khách
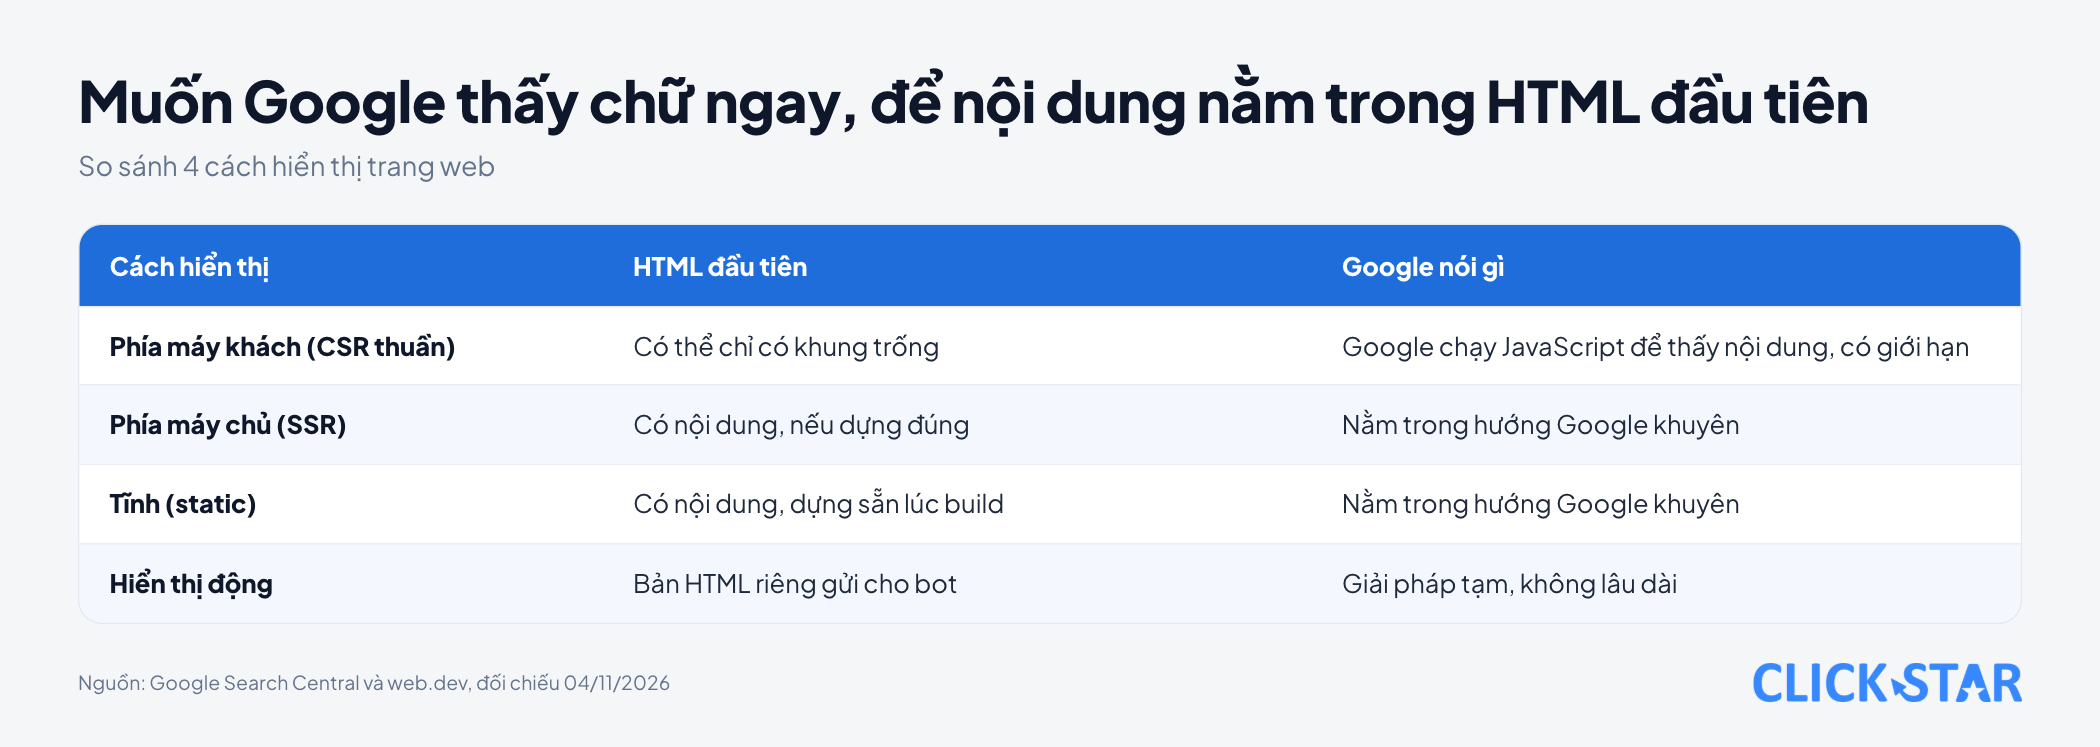
Hãy đưa nội dung chính vào HTML ngay từ đầu. Bài "Rendering on the web" (web.dev, cập nhật 05/01/2026) nói các tác giả khuyến khích cân nhắc hiển thị phía máy chủ hoặc tĩnh hơn rehydration đầy đủ.
Bài này mô tả 3 cách:
- Hiển thị phía máy chủ (SSR): máy chủ dựng xong HTML cho mỗi yêu cầu.
- Hiển thị tĩnh (static rendering): HTML dựng sẵn lúc build, mỗi URL 1 tệp.
- Hiển thị phía máy khách (CSR): trình duyệt dùng JavaScript tự dựng trang.
Next.js, React và WordPress
Tài liệu Next.js "Server and Client Components" (cập nhật 05/10/2026, đọc 04/11/2026) nói trang và layout mặc định là Server Components, còn Client Components cùng RSC Payload được dùng để dựng sẵn HTML. Click Star suy ra: dữ liệu chỉ nạp sau khi trang mở trong trình duyệt có thể không nằm trong HTML đầu tiên.
Trang "How to build single-page applications with Next.js" (cập nhật 15/10/2026, đọc 04/11/2026) định nghĩa "strict SPA": 1 tệp HTML, mọi route và dữ liệu do JavaScript trong trình duyệt xử lý. Click Star cho rằng nên kiểm dạng này đầu tiên.
Với WordPress, "Template Hierarchy" trong Theme Handbook (cập nhật 24/07/2024, đọc 04/11/2026) chỉ mô tả cách chọn tệp mẫu để tạo trang, không nói nơi dựng HTML. Click Star suy luận: giao diện cổ điển dựng HTML bằng PHP ở máy chủ. Plugin hoặc giao diện tách rời (headless) chuyển việc sang JavaScript thì cần kiểm như SPA.
Hiển thị động
Hiển thị động là máy chủ nhận ra bot rồi gửi bản HTML dựng sẵn, còn người dùng nhận bản chạy JavaScript. Trang "Dynamic Rendering as a workaround" (cập nhật 10/12/2025) nói đây là giải pháp tạm vì thêm độ phức tạp và tài nguyên.
Cùng trang nói đây thường không bị coi là cloaking (che giấu nội dung) nếu nội dung tương tự; gửi nội dung khác hẳn cho người và bot thì có thể bị coi là cloaking.
Những lỗi khiến Google bỏ sót nội dung
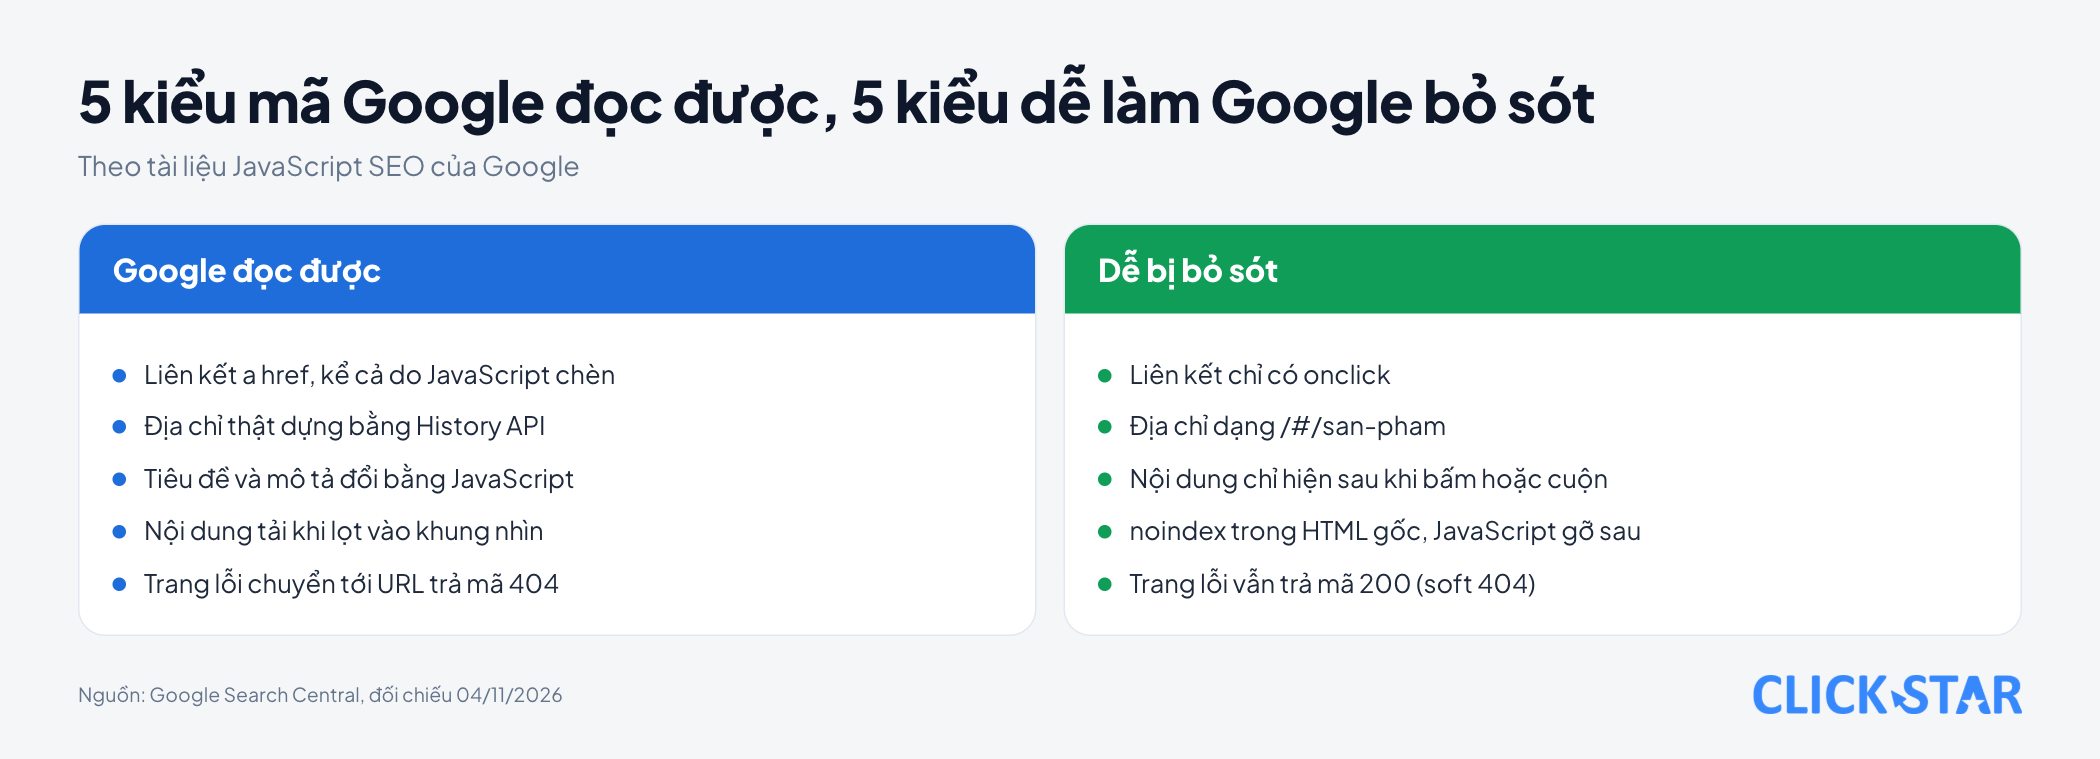
Liên kết và địa chỉ
- Liên kết không phải
<a>cóhref. Trang "SEO Link Best Practices for Google" (cập nhật 10/12/2025) nói Google thường chỉ thu thập được liên kết dạng<a href="/san-pham">. Dạng chỉ cóonclickkhông được khuyến nghị. Liên kết do JavaScript chèn vào trang vẫn thu thập được nếu dùng đúng dạng đó. - Dùng
#để đổi nội dung. Google nói cơ chế AJAX-crawling bị loại bỏ từ 2015, nên đừng dựa vào địa chỉ như/#/san-pham. Hãy dùng History API để có địa chỉ/san-pham.
Nội dung cần thao tác
- Nội dung chờ bấm hoặc cuộn. Trang "Fix Lazy-Loaded Website Content" (cập nhật 10/12/2025) nói Google Search không tương tác với trang. Hãy để nội dung tải khi lọt vào khung nhìn, bằng lazy-loading của trình duyệt hoặc
IntersectionObserver.
Trạng thái và chỉ thị
- Trang không tồn tại vẫn trả mã 200 (soft 404). Trang "Fix Search-Related JavaScript Problems" nêu 2 cách: chuyển bằng JavaScript tới URL mà máy chủ trả 404, hoặc thêm
<meta name="robots" content="noindex">bằng JavaScript. noindextrong HTML gốc rồi gỡ bằng JavaScript. Google có thể bỏ qua hiển thị khi gặpnoindex, nên mã gỡ có thể không chạy. Muốn lập chỉ mục thì đừng đặtnoindextrong mã gốc.- Tiêu đề, mô tả, canonical đổi bằng JavaScript. Google cho phép, nhưng khuyên đặt canonical trong HTML. Nếu HTML gốc đã có canonical thì JavaScript không được đổi sang giá trị khác; nếu không đặt được trong HTML thì mới thêm bằng JavaScript.
Cách xem Google thấy gì trên trang của bạn
Kiểm 2 lớp: HTML gốc trước, rồi bản Google hiển thị. Lệnh sau bỏ các thẻ <script>, <style>, <title> và <meta> khỏi HTML gốc, rồi đếm số dòng còn chứa 1 cụm chữ chính của trang (thay địa chỉ và cụm chữ bằng của bạn; cần máy có perl):
curl -sL https://ten-mien-cua-ban.vn/san-pham | perl -0pe 's/<(script|style|title)\b.*?<\/\1>//gsi; s/<meta[^>]*>//gsi' | grep -c "Áo thun nam"
Kết quả 0 nghĩa là cụm chữ không nằm ngoài các thẻ vừa bỏ, dù có thể vẫn hiện sau khi hiển thị. Kết quả từ 1 trở lên chưa chắc nghĩa là chữ hiện trên trang: cụm chữ có thể nằm trong chú thích, thuộc tính hay phần ẩn, và lệnh không tự phân biệt được. Hãy mở "xem nguồn trang" để kiểm chữ nằm trong thẻ hiển thị như <h1>, hoặc dùng Live Test.
Click Star chạy thử lệnh này trên 4 tệp HTML tự tạo ở máy cục bộ: tệp nạp nội dung bằng JavaScript riêng cho kết quả 0, tệp có chữ trong <h1> cho 1, tệp chỉ có chữ trong JSON của thẻ <script> cho 0, tệp chỉ có chữ trong <title> và meta cũng cho 0. Nếu chỉ dùng grep -c, hai tệp sau đều cho kết quả lớn hơn 0.
Bước tiếp theo là URL Inspection. Theo trang "URL Inspection tool" (Search Console Help, không ghi ngày, đọc 04/11/2026):
- URL phải thuộc property đang mở. Trang khác: Rich Results Test.
- Kết quả "đã lập chỉ mục" là phiên bản lần thu thập gần nhất. Muốn xem trang hiện tại, bấm Live Test.
- Ở Live Test, "View tested page" cho ảnh chụp trang đã hiển thị, HTML trả về, tiêu đề HTTP, đầu ra console JavaScript và tài nguyên đã tải.
Điều này có nghĩa gì với doanh nghiệp Việt Nam
Trang cần lên Google, như dịch vụ, danh mục, sản phẩm và bài viết, nên có nội dung chính trong HTML gốc.
Click Star có dịch vụ thiết kế website chuẩn SEO tải nhanh, nên có lợi ích liên quan.
Đánh giá của Click Star. Google nói chạy được JavaScript, nhưng rủi ro vẫn nằm ở người làm website: hàng chờ hiển thị, giới hạn kích thước, trạng thái không được lưu, và bot không chạy JavaScript.
Cách ít tốn công kiểm nhất là đưa tiêu đề, mô tả, liên kết, nội dung chính và giá vào HTML gốc, còn JavaScript dùng để thêm tương tác. Đây là nhận định kỹ thuật, không phải kết luận từ nguồn ngoài.
Việc nên làm: 5 việc kiểm tra website dùng JavaScript
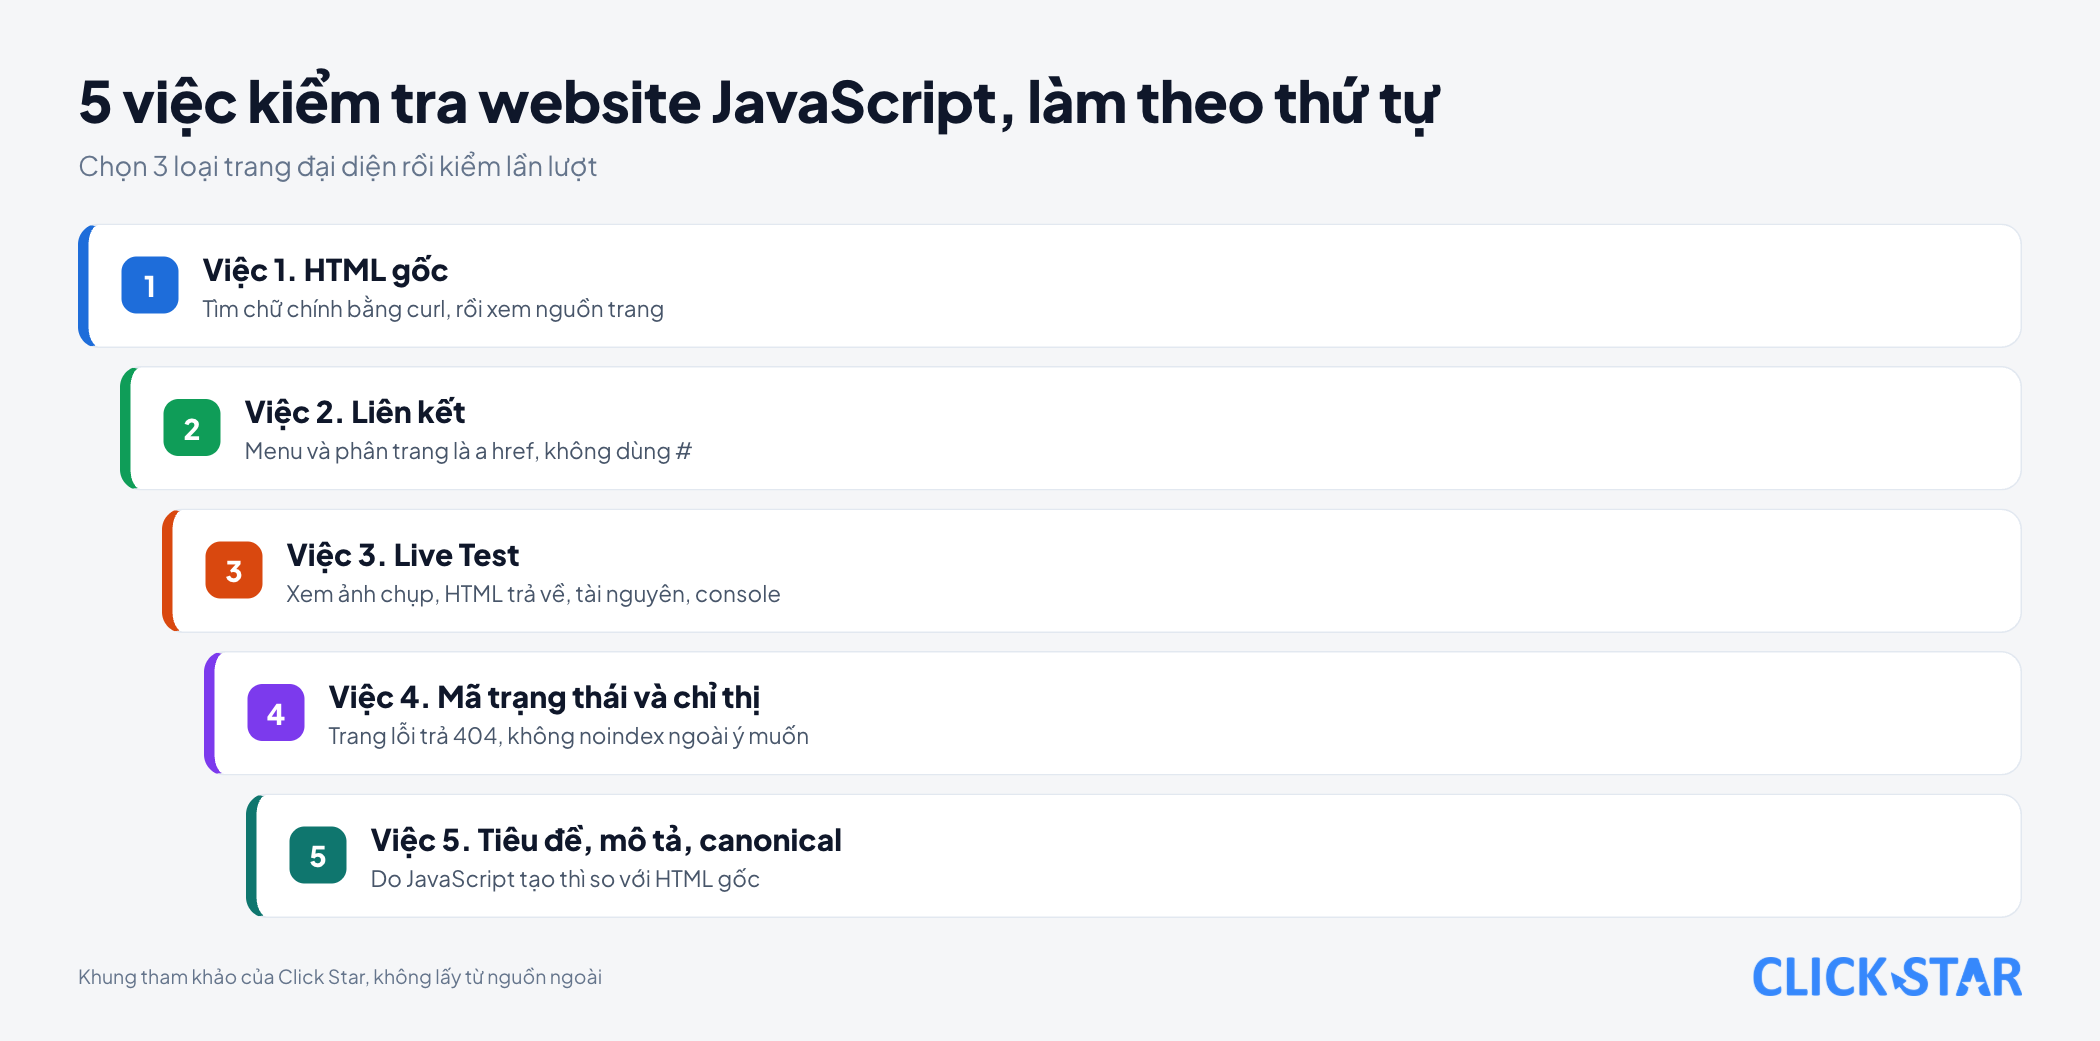
Khung tham khảo của Click Star, không lấy từ nguồn ngoài và chưa chạy thử trên Google. Hãy chọn 3 loại trang đại diện: trang chủ, trang danh mục hoặc sản phẩm, và bài viết.
Cách đo: sau mỗi lần phát hành lớn, đếm bằng lệnh trên số trang mẫu có cụm chữ chính, mở xem nguồn trang để loại trang mà chữ không nằm trong thẻ hiển thị, rồi đếm số trang mẫu mà Live Test hiển thị đủ nội dung.
Việc 1. Tìm nội dung chính trong HTML gốc. Dùng lệnh curl ở trên với tiêu đề, tên sản phẩm và giá, rồi mở xem nguồn trang để chắc chữ nằm trong thẻ hiển thị như <h1>.
Việc 2. Rà liên kết. Menu, phân trang và danh mục phải là <a href="/duong-dan">, không chỉ có onclick, không dùng #.
Việc 3. Chạy Live Test cho 3 loại trang.
Việc 4. Kiểm mã trạng thái và chỉ thị. Trang không tồn tại trả 404, HTML gốc không có noindex ngoài ý muốn, robots.txt không chặn JavaScript cần để hiển thị.
Việc 5. Kiểm tiêu đề, mô tả và canonical. Nếu do JavaScript tạo ra, so với HTML gốc.
Những sai lầm thường gặp
- Cho rằng Google chạy được JavaScript nên không cần kiểm.
- Chỉ xem trang bằng trình duyệt của mình, nơi bạn có thể bấm, cuộn và đã lưu cookie.
- Dùng
#cho các trang con thay vì địa chỉ thật. - Để trang không tồn tại trả mã 200 trong ứng dụng một trang.
- Đặt
noindextrong HTML gốc rồi gỡ bằng JavaScript. - Chặn tệp JavaScript trong robots.txt.
- Dùng hiển thị động làm giải pháp lâu dài, hoặc gửi bot nội dung khác với người dùng.
Điều chưa biết
Chưa có số đo cho website Việt Nam về tỷ lệ trang bị bỏ sót do JavaScript. Số đo độ trễ của Vercel và MERJ là nguồn thứ cấp, chủ yếu từ nextjs.org tháng 4/2024, không nên coi là con số cố định.
Click Star chưa đọc tài liệu chính thức về việc công cụ tìm kiếm khác hay công cụ AI có chạy JavaScript hay không.
Click Star không tự thử trên Google. Lệnh curl chỉ chạy thử trên 4 tệp tự tạo, Rich Results Test chưa được chạy thử (công cụ là ứng dụng JavaScript), và nhận định về Next.js, WordPress là suy luận.
Bài liên quan



Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.