Nguyên lý hoạt động của Googlebot: từ thu thập, hiển thị đến lập chỉ mục và 7 việc nên làm
Giải thích 5 chặng từ phát hiện địa chỉ đến kết quả tìm kiếm, giới hạn 2MB, hàng đợi hiển thị JavaScript, chọn bản chuẩn, kèm bảng chẩn đoán theo triệu chứng và 7 việc nên làm.
Khi một trang không xuất hiện trên Google, câu hỏi thường được đặt ra là "Googlebot không đọc trang của mình à?".
Câu trả lời đúng hiếm khi là có hoặc không, vì giữa việc Googlebot tải một địa chỉ và việc trang đó hiện trong kết quả tìm kiếm là cả một chuỗi bước độc lập: tìm ra địa chỉ, được phép tải, tải trọn vẹn, hiển thị mã JavaScript, chọn phiên bản chuẩn, lưu vào chỉ mục. Mỗi bước có cách hỏng riêng.
Bài này giải thích nguyên lý đó theo tài liệu chính thức của Google Search Central (các trang "How Google Search works", "JavaScript SEO basics" và "Google's common crawlers", đọc ngày 21/10/2026) cùng bản tường thuật về bài đăng ngày 31/3/2026 của Gary Illyes về cách Googlebot thu thập và các giới hạn byte (Click Star chưa đọc được toàn văn bài gốc nên các chi tiết lấy từ bài này được ghi rõ là theo tường thuật).
Phần cuối là bảng chẩn đoán theo triệu chứng và 7 việc nên làm. Click Star đã có bài về quy trình làm SEO trong thời đại AI, trong đó bước đầu là xác nhận điều kiện kỹ thuật; bài này đi sâu vào cơ chế phía sau bước đó.
Điểm chính
- Googlebot không phải một chương trình duy nhất mà là một "khách hàng" của hạ tầng thu thập dữ liệu dùng chung, mà các sản phẩm khác của Google như Shopping và AdSense cũng dùng (theo tường thuật bài của Google ngày 31/3/2026). Tên Googlebot là di sản từ thời Google chỉ có một trình thu thập.
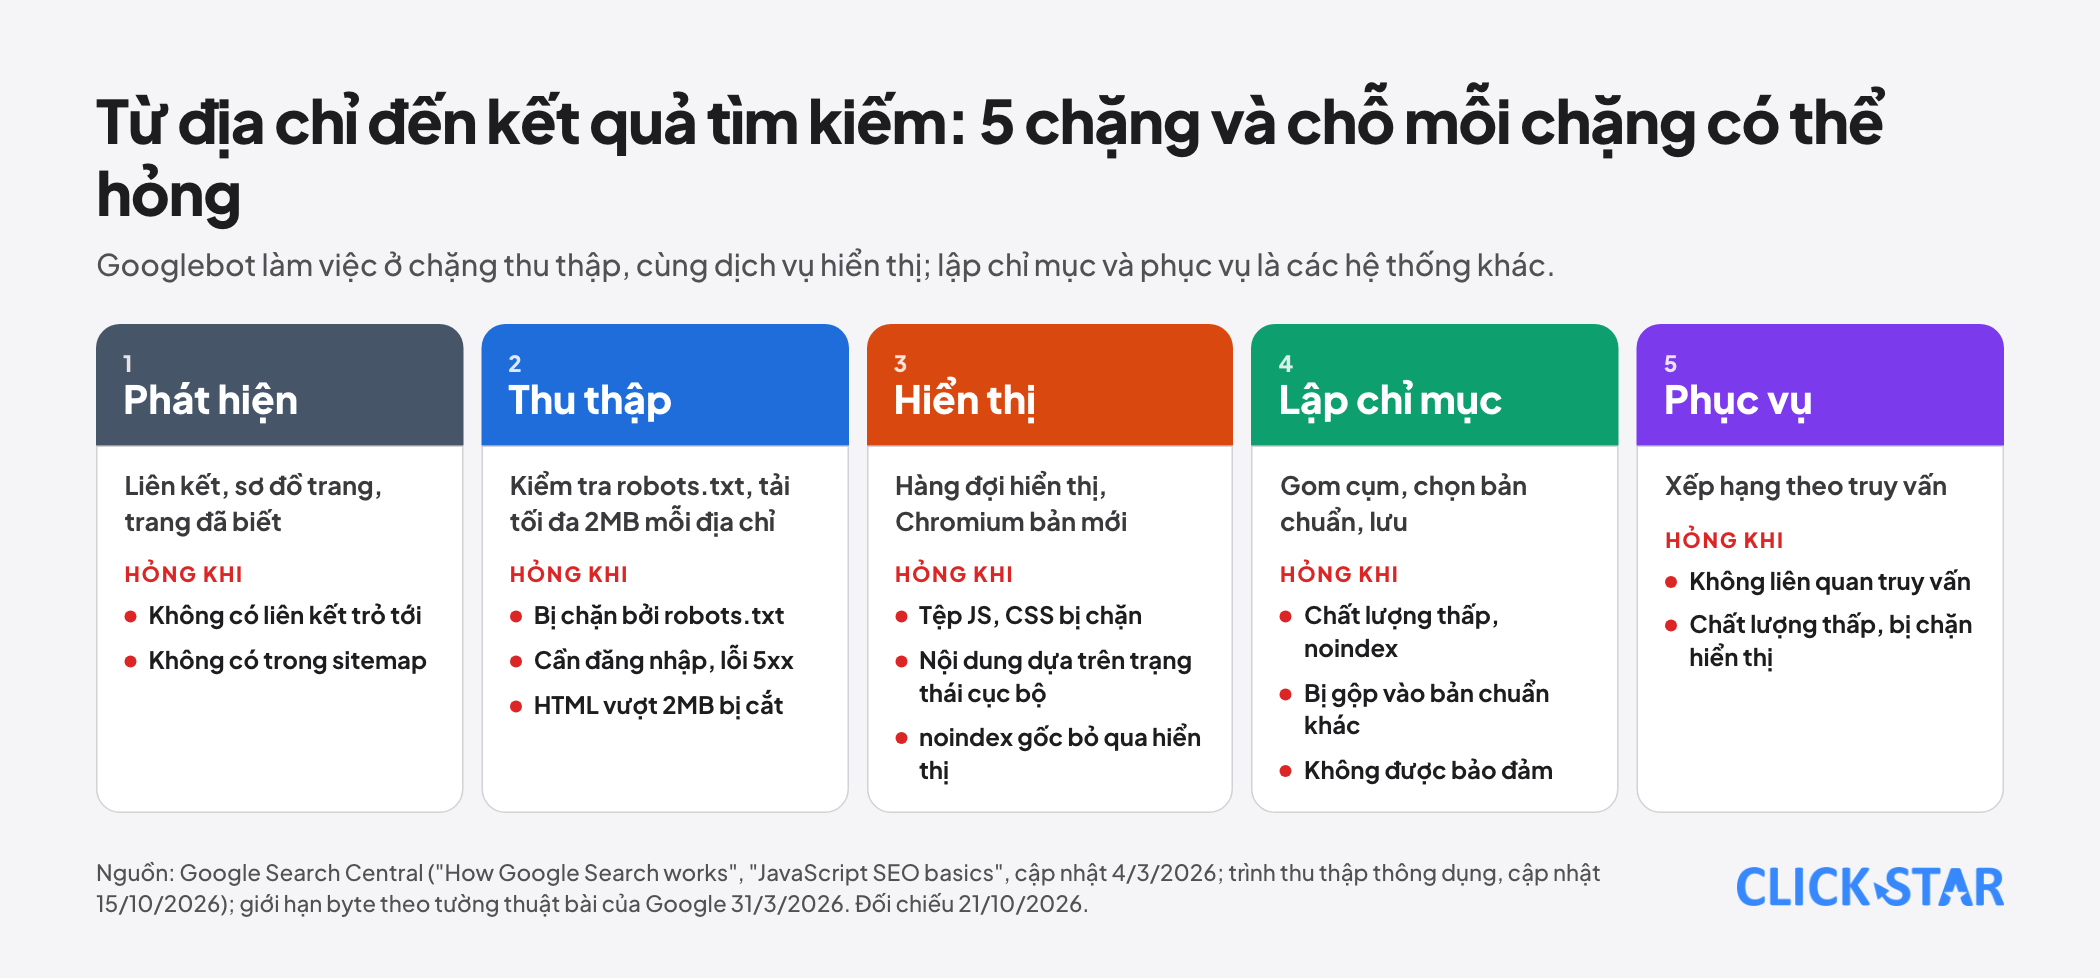
- Quy trình gồm 3 giai đoạn do Google mô tả: thu thập (crawling), lập chỉ mục (indexing) và phục vụ kết quả (serving). Googlebot làm việc ở giai đoạn thu thập, cùng dịch vụ hiển thị chạy một Chromium bản mới để thực thi JavaScript.
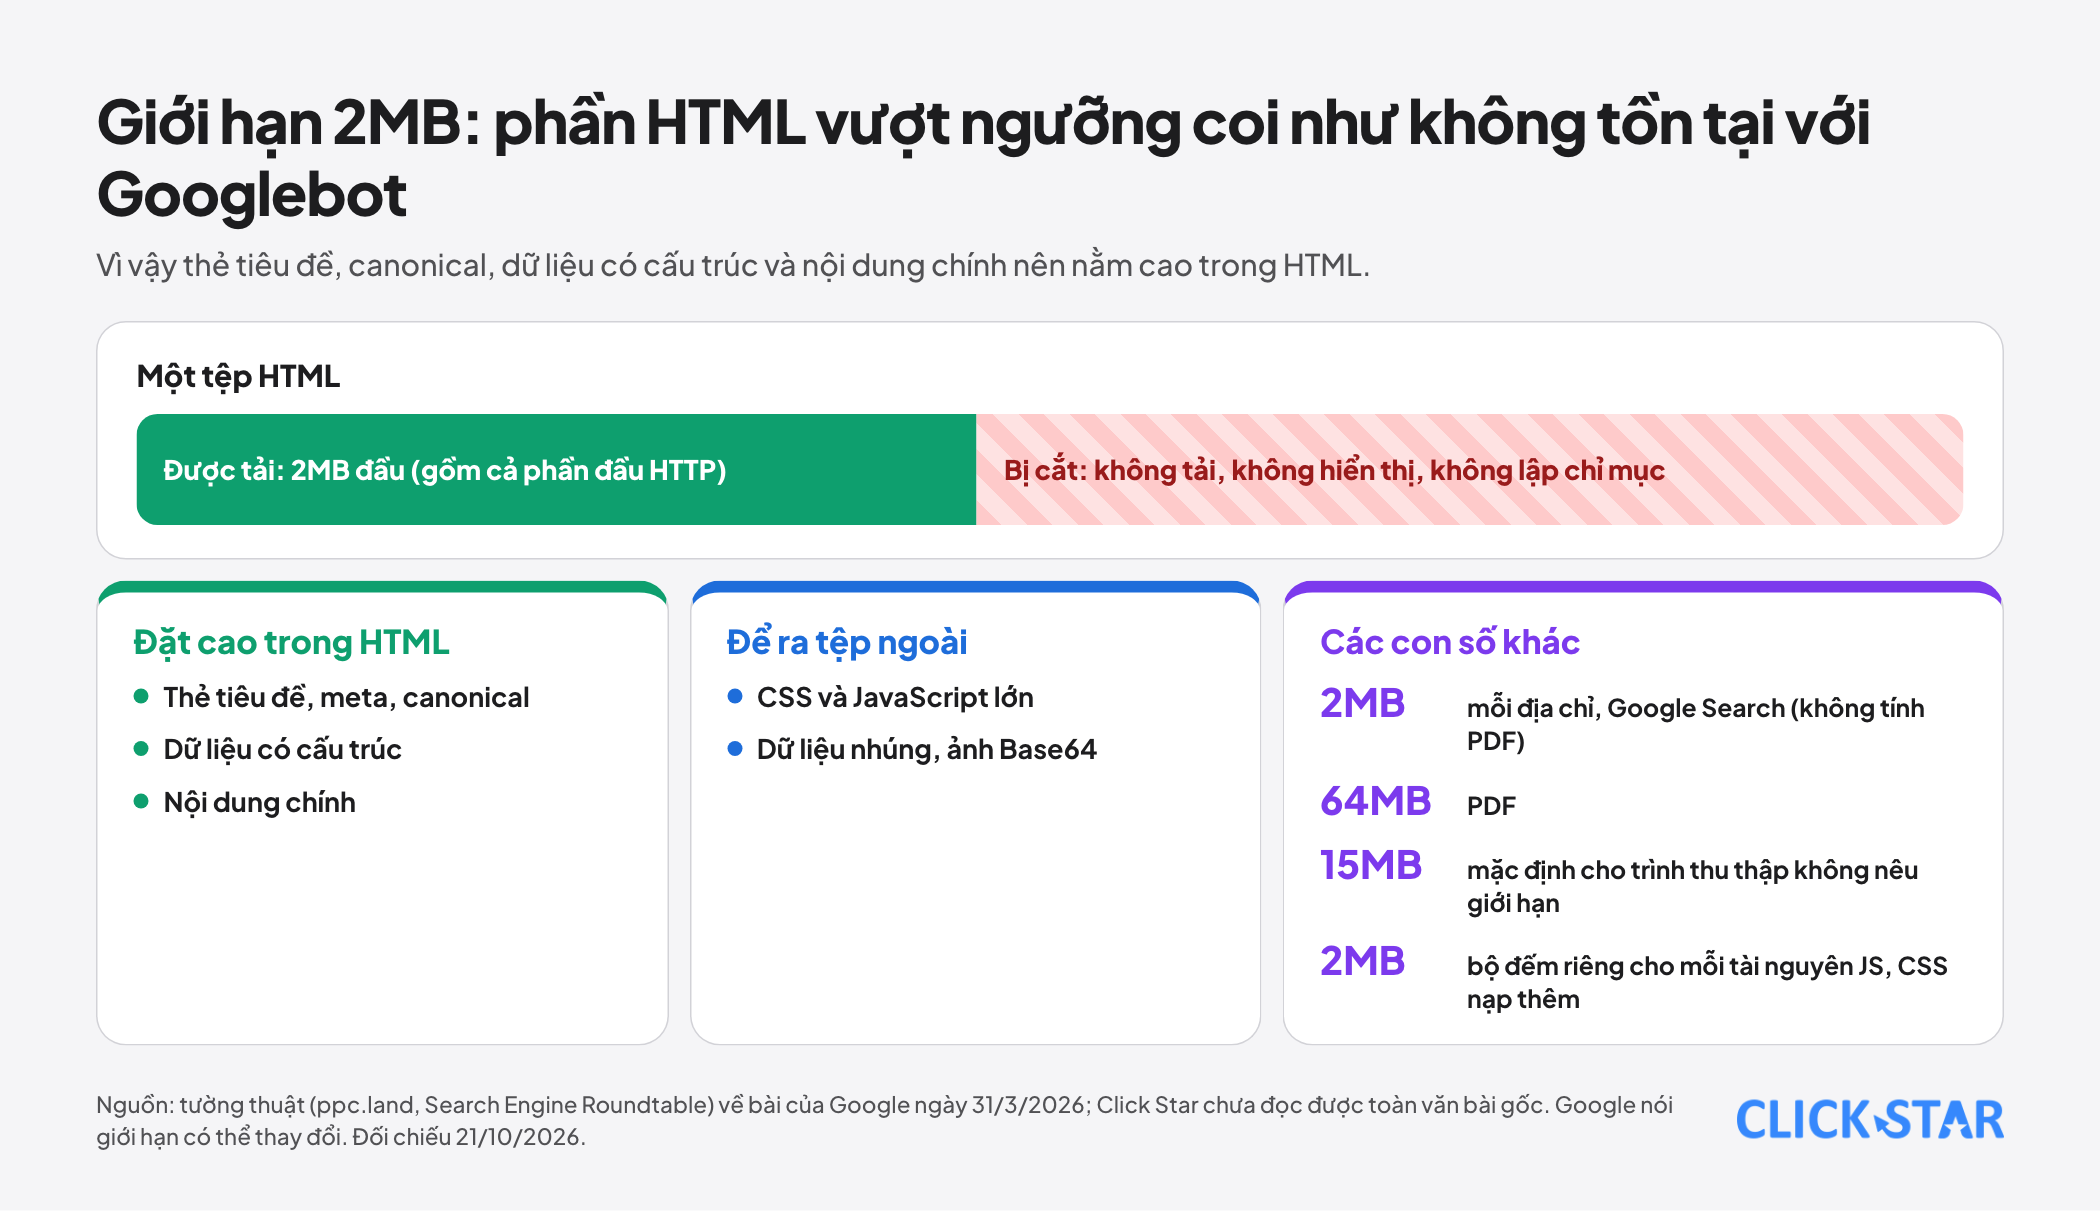
- Googlebot tải tối đa 2MB cho mỗi địa chỉ (không tính PDF), gồm cả phần đầu HTTP; PDF tối đa 64MB; trình thu thập không nêu giới hạn dùng mặc định 15MB của hạ tầng (theo tường thuật). Phần vượt giới hạn bị cắt: không được tải, không hiển thị, không lập chỉ mục.
- Mọi trang trả mã 200 đều được đưa vào hàng đợi hiển thị, dù có JavaScript hay không; trang có thẻ noindex có thể bỏ qua bước hiển thị nên mã JavaScript gỡ noindex không hiệu quả.
- Lập chỉ mục không được bảo đảm, ngay cả khi trang đáp ứng mọi khuyến nghị của Google. Google không nhận tiền để thu thập hay xếp hạng.
- Chẩn đoán theo giai đoạn nhanh hơn đoán theo kết quả: biết trang dừng ở bước nào mới biết sửa ở đâu.
Googlebot thực sự là gì
Theo tài liệu về trình thu thập thông dụng của Google (cập nhật 15/10/2026), Googlebot có hai dạng nhận diện chính là Googlebot Smartphone và Googlebot Desktop.
Cả hai chứa chuỗi "Googlebot/2.1; +http://www.google.com/bot.html", và phần số phiên bản Chrome trong chuỗi chỉ là chỗ giữ vị trí tăng dần theo thời gian, nên khi lọc nhật ký máy chủ cần dùng ký tự đại diện. Thẻ dùng trong robots.txt là Googlebot; trình thu thập ảnh, video, tin tức có thẻ riêng.
Google nhắc rằng chuỗi nhận diện trình duyệt có thể bị giả mạo, và các trình thu thập thông dụng luôn tuân theo robots.txt khi thu thập tự động.
Theo tường thuật về bài ngày 31/3/2026, Googlebot là một khách hàng của một nền tảng thu thập tập trung.
Các loại trình lấy dữ liệu chia thành 3 nhóm: trình thu thập thông dụng (như Googlebot) tuân thủ robots.txt khi chạy tự động; trình thu thập trường hợp đặc biệt (như AdsBot) có thể tuân thủ hoặc không tùy thỏa thuận với website; và trình lấy dữ liệu do người dùng kích hoạt thì bỏ qua robots.txt vì có người thực sự yêu cầu.
Theo cùng nguồn, Google bổ sung trình lấy dữ liệu do người dùng kích hoạt tên Google-Agent ngày 20/3/2026. Điều này liên quan trực tiếp đến cách nhìn nhật ký truy cập: không phải mọi truy cập mang tên Google đều là Googlebot tìm kiếm.
Giai đoạn 1: thu thập
Phát hiện địa chỉ. Theo tài liệu "How Google Search works", không có một danh bạ trung tâm của mọi trang web. Google tìm địa chỉ mới qua liên kết từ các trang đã biết, qua sơ đồ trang (sitemap) và từ các trang đã từng ghé thăm. Googlebot quyết định trang web nào được thu thập, tần suất và số trang mỗi lần, và chậm lại khi máy chủ trả lỗi HTTP 500.
Kiểm tra robots.txt. Trước khi tải một địa chỉ, Googlebot kiểm tra robots.txt; nếu bị chặn thì bỏ qua. Hệ quả ít người để ý theo trang JavaScript SEO: Google không hiển thị JavaScript từ các tệp bị chặn hoặc trên các trang bị chặn. Chặn thư mục chứa tệp JavaScript hay CSS quan trọng có thể khiến Google thấy một trang khác với người dùng.
Các thứ cản trở thu thập. Theo tài liệu: trang bị chủ website chặn (ví dụ bằng robots.txt), trang yêu cầu đăng nhập, lỗi máy chủ và sự cố mạng.
Giới hạn byte. Theo bản tường thuật bài của Google, Googlebot tải tối đa 2MB mỗi địa chỉ (không tính PDF), phép đếm này bao gồm phần đầu HTTP. PDF có giới hạn 64MB. Trình thu thập không nêu giới hạn rơi về mặc định 15MB của nền tảng.
Trình thu thập ảnh và video dùng ngưỡng riêng do từng nhóm sản phẩm đặt, nên con số 2MB chỉ áp dụng cho Google Search. Một tệp HTML vượt giới hạn bị cắt ở 2MB thay vì bị từ chối: chỉ 2MB đầu được chuyển cho bước lập chỉ mục và dịch vụ hiển thị, phần sau coi như không tồn tại với Googlebot.
Mỗi tài nguyên mà dịch vụ hiển thị nạp thêm, như tệp JavaScript hay CSS, có bộ đếm 2MB riêng và không tính vào trang cha; phông chữ, phương tiện và một số loại tệp hiếm bị loại khỏi việc này. Google cho biết giới hạn này có thể thay đổi theo thời gian. Bài viết chưa làm rõ việc đếm theo dung lượng đã nén hay chưa nén, nên đừng suy diễn.
Xác minh Googlebot thật. Các trình thu thập thông dụng dùng dải IP liệt kê trong tệp common-crawlers.json, và tên máy trả ngược có dạng crawl-***-***-***-***.googlebot.com hoặc geo-crawl-***.geo.googlebot.com.
Để kiểm lẻ, làm tra cứu DNS ngược rồi tra cứu DNS xuôi để so khớp; để kiểm quy mô lớn, đối chiếu địa chỉ IP với tệp JSON ở dạng CIDR. Theo tường thuật, các tệp dải IP chuyển từ đường dẫn /search/apis/ipranges/ sang /crawling/ipranges/ trên developers.google.com, chỉ đổi nơi lưu tài liệu chứ dải IP không đổi, và đường dẫn cũ sẽ chuyển hướng rồi bị gỡ trong khoảng 6 tháng. Danh sách cho phép trong tường lửa dùng đường dẫn cũ cần cập nhật.
Giai đoạn 2: hiển thị (rendering)
Đây là nơi nhiều website chạy bằng JavaScript hỏng mà không hay. Theo trang JavaScript SEO (cập nhật 4/3/2026), có 3 pha: thu thập, hiển thị và lập chỉ mục. Googlebot phân tích HTML trả về để tìm các liên kết href và đưa vào hàng chờ thu thập.
Sau đó, mọi trang trả mã 200 đều được gửi vào hàng đợi hiển thị, dù có JavaScript hay không; trang có thể chờ trong hàng đợi vài giây hoặc lâu hơn. Một Chromium không đầu (headless) bản mới thực thi JavaScript, rồi Googlebot phân tích HTML sau hiển thị để tìm liên kết và lập chỉ mục. Phản hồi không phải 200, như 404, có thể bỏ qua hiển thị.
Theo tường thuật về bài của Google, dịch vụ hiển thị web (WRS) thực thi JavaScript gần giống trình duyệt hiện đại, nạp tệp JavaScript và CSS và xử lý yêu cầu XHR, nhưng không yêu cầu ảnh hay video, và chỉ chạy được mã mà trình tải đã lấy về, nên một lần tải bị cắt cho nó nguyên liệu chưa đủ.
Nó cũng không giữ trạng thái: bộ nhớ cục bộ và dữ liệu phiên bị xóa giữa các yêu cầu, nên trang dựa vào trạng thái lưu phía trình duyệt có thể hỏng. Trang JavaScript SEO bổ sung rằng WRS có thể bỏ qua tiêu đề bộ nhớ đệm, nên nên dùng dấu vân tay nội dung cho tệp JS và CSS.
Những thứ hiển thị có thể bỏ sót. Nội dung phải xuất hiện trong HTML sau hiển thị mới được lập chỉ mục; với thành phần web, Google làm phẳng shadow DOM và light DOM nên chỉ nội dung hiển thị thấy mới tính.
Trang có thẻ noindex có thể bỏ qua hiển thị, nên đoạn JavaScript gỡ noindex có thể không chạy; nếu muốn trang được lập chỉ mục, đừng đặt noindex trong mã gốc. Nên đặt URL chuẩn (canonical) trong HTML nếu có thể, còn nếu dùng JavaScript thì giá trị phải khớp HTML và chỉ có một thẻ canonical.
Dùng liên kết <a href> kèm History API thay vì phần mảnh URL. Với ứng dụng hiển thị phía trình duyệt, tránh lỗi 404 mềm bằng cách chuyển hướng tới một URL 404 phía máy chủ hoặc chèn noindex bằng JavaScript. Hiển thị phía máy chủ hoặc dựng sẵn vẫn được khuyến nghị vì không phải trình thu thập nào cũng chạy JavaScript.
Giai đoạn 3: lập chỉ mục
Theo "How Google Search works", Google phân tích văn bản, các thẻ và thuộc tính chính (như phần tử <title> và thuộc tính alt), hình ảnh và video. Các trang có nội dung tương tự được gom thành một cụm và Google chọn trang đại diện nhất làm bản chuẩn, có thể xuất hiện trong kết quả; các trang còn lại trong cụm là phiên bản thay thế.
Google ghi nhận tín hiệu về bản chuẩn, như ngôn ngữ, quốc gia mà trang gắn với và khả năng sử dụng. Thông tin được lưu trong chỉ mục, một cơ sở dữ liệu rất lớn. Lập chỉ mục không được bảo đảm. Các lý do cản trở: nội dung chất lượng thấp, quy tắc robots meta cấm lập chỉ mục, và thiết kế website khiến việc lập chỉ mục khó khăn.
Giai đoạn 4, phục vụ kết quả, nằm ngoài phạm vi của Googlebot: Google tìm trong chỉ mục và trả về kết quả được đánh giá chất lượng và liên quan cao nhất, dựa trên hàng trăm yếu tố gồm vị trí, ngôn ngữ và thiết bị.
Một trang có thể được lập chỉ mục nhưng không hiện ra nếu nội dung không liên quan đến truy vấn, chất lượng thấp hoặc bị quy tắc robots meta ngăn phục vụ.
Google nói rõ họ không nhận tiền để thu thập một website thường xuyên hơn và không bảo đảm sẽ thu thập, lập chỉ mục hay phục vụ một trang, kể cả khi trang tuân thủ Google Search Essentials.
Đánh giá của Click Star. Với doanh nghiệp, điều đáng nhớ nhất là mọi thứ phía sau lập chỉ mục, kể cả việc xuất hiện trong tính năng AI của Google, đều phụ thuộc vào việc trang đã đi qua đủ các bước trên. Trang không đi vào chỉ mục thì không có chuyện tối ưu nội dung để được trích dẫn. Vì vậy chẩn đoán kỹ thuật nên đi trước mọi quyết định về nội dung.
Bảng chẩn đoán theo triệu chứng
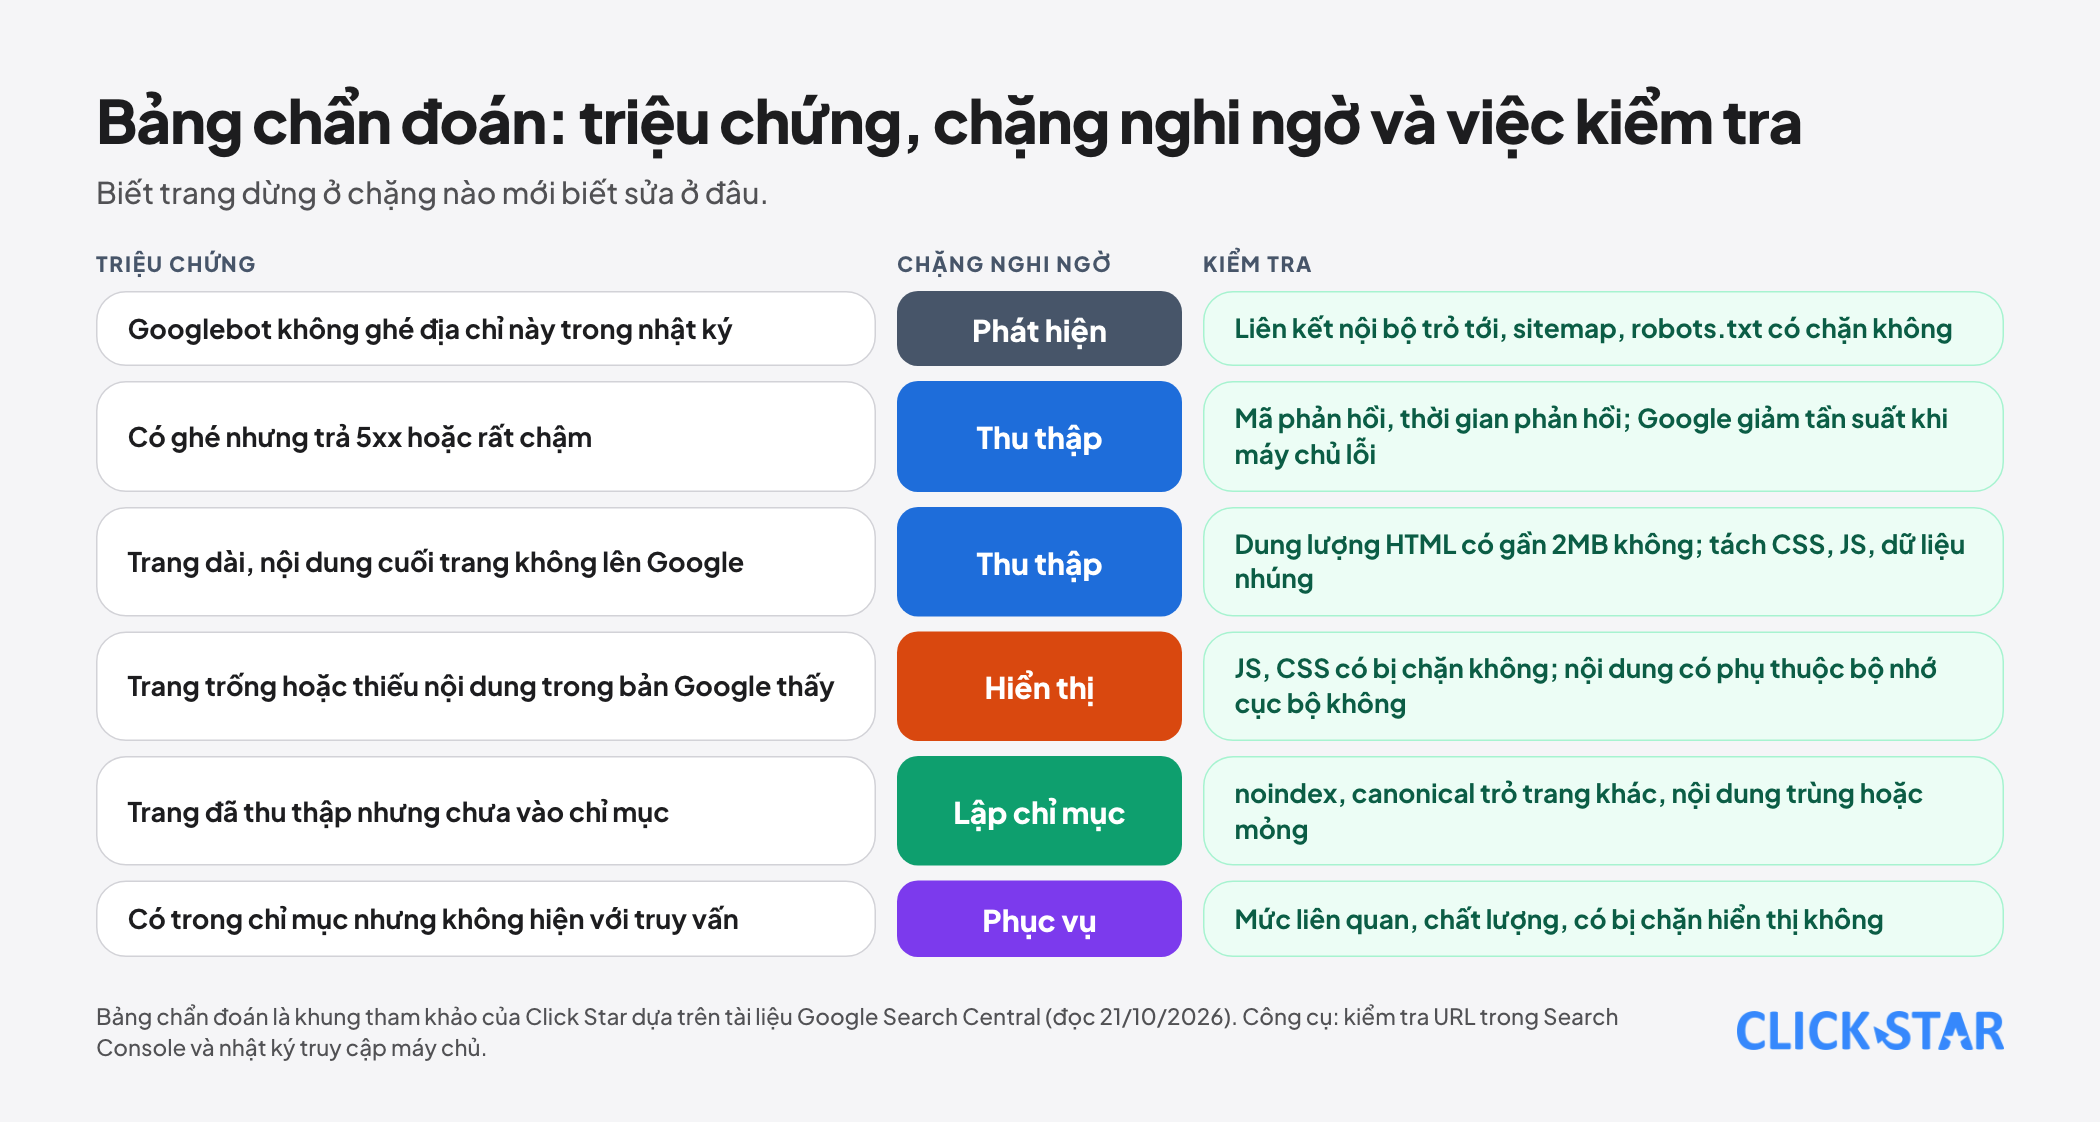
Bảng chẩn đoán trong hình ghép triệu chứng với giai đoạn có khả năng hỏng nhất. Khi áp dụng, dùng công cụ kiểm tra URL trong Search Console để xem Google nhìn thấy HTML nào và có lập chỉ mục được không, và nhật ký truy cập máy chủ để xem Googlebot thật đã ghé những địa chỉ nào, với mã phản hồi nào và dung lượng bao nhiêu.
7 việc nên làm
- Kiểm tra robots.txt: không chặn thư mục chứa JavaScript, CSS và các tài nguyên cần cho hiển thị.
- Đo dung lượng HTML của các trang quan trọng; nếu gần hoặc vượt 2MB, tách CSS, JavaScript và dữ liệu nhúng lớn (như ảnh Base64) ra tệp ngoài.
- Đặt các phần tử quan trọng (thẻ tiêu đề, canonical, dữ liệu có cấu trúc, nội dung chính) ở cao trong HTML để nằm trước ngưỡng cắt.
- Với website dựng bằng JavaScript, bảo đảm nội dung chính có trong HTML sau hiển thị, không phụ thuộc bộ nhớ cục bộ hay trạng thái phiên; ưu tiên hiển thị phía máy chủ cho trang quan trọng.
- Không đặt noindex trong mã gốc rồi trông chờ JavaScript gỡ; không để trang 404 mềm.
- Theo dõi thời gian phản hồi và mã lỗi 5xx của máy chủ: khi máy chủ chậm hoặc lỗi, Google giảm tần suất thu thập.
- Xác minh Googlebot trong nhật ký bằng DNS ngược và xuôi hoặc dải IP chính thức, cập nhật danh sách cho phép tường lửa theo đường dẫn tệp dải IP mới, và không tin vào chuỗi nhận diện trình duyệt.
Điều chưa biết
Click Star chưa đọc được toàn văn bài đăng ngày 31/3/2026 của Google, nên các số liệu 2MB, 64MB, 15MB, hành vi cắt, bộ đếm riêng cho từng tài nguyên và cách hoạt động của WRS là theo bản tường thuật của ppc.land và phần tóm tắt của Search Engine Roundtable; hãy đối chiếu với bài gốc trước khi dựa vào số cụ thể.
Google nói giới hạn có thể thay đổi. Chưa rõ giới hạn tính theo dung lượng nén hay không nén. Chưa có số đo cho thị trường Việt Nam về tỷ lệ trang vượt giới hạn. Cuối cùng, tài liệu không nói thời gian một trang chờ trong hàng đợi hiển thị, chỉ nói "vài giây hoặc lâu hơn".
Những sai lầm thường gặp
- Kết luận "Googlebot không đọc được" mà không biết trang dừng ở bước nào.
- Chặn thư mục JavaScript và CSS trong robots.txt rồi thắc mắc vì sao Google thấy trang trống.
- Nhồi dữ liệu nhúng lớn vào HTML, đẩy nội dung và dữ liệu có cấu trúc ra ngoài ngưỡng 2MB.
- Dựa vào JavaScript để gỡ noindex hoặc để đặt canonical khác HTML gốc.
- Dùng bộ nhớ cục bộ hay trạng thái phiên để hiển thị nội dung chính, trong khi dịch vụ hiển thị không giữ trạng thái.
- Tin chuỗi nhận diện trình duyệt trong nhật ký là đủ để xác minh Googlebot, trong khi chuỗi này có thể bị giả mạo.
- Cho rằng đã được thu thập nghĩa là sẽ được lập chỉ mục và xếp hạng.
Bài liên quan



Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.