Phân khúc khách hàng bằng RFM: cách tính, chấm điểm và dùng trong CRM
Bài giải thích RFM tính và chấm điểm thế nào, kèm đoạn SQL PostgreSQL chạy thử, khung 6 phân khúc, giới hạn và cách đo bằng nhóm đối chứng. Dựa trên tài liệu của Braze, Adobe, Klaviyo, PostgreSQL và bài của Fader, Hardie, Lee.
Nhiều doanh nghiệp có hàng nghìn khách trong CRM nhưng gửi cùng một thông điệp cho tất cả. RFM là cách phân khúc đơn giản, chỉ cần 3 dữ liệu có sẵn trong đơn hàng: ngày mua, số lần mua và số tiền đã chi.
Bài dựa trên tài liệu của Braze, Adobe Commerce Intelligence, Klaviyo, PostgreSQL và bài của Fader, Hardie, Lee (bản chỉnh sửa tháng 2/2005), đối chiếu đến ngày 22/10/2026. Đoạn SQL được Click Star chạy thử trên PostgreSQL 16.2 với dữ liệu giả.
Bài trả lời 4 câu hỏi: RFM tính và chấm điểm thế nào, dùng ra sao trong CRM và chiến dịch, giới hạn ở đâu, và đo kết quả thế nào cho đúng.
Điểm chính
- RFM chấm mỗi khách theo 3 chỉ số: mua gần đây thế nào (Recency), mua bao nhiêu lần (Frequency) và chi bao nhiêu tiền (Monetary), thường theo thang từ 1 đến 5.
- Không có cách tính chuẩn duy nhất: Braze và Adobe chia 5 nhóm đều 20%, Klaviyo dùng thang từ 1 đến 3, nhóm Fader lấy trung bình tiền mỗi đơn thay cho tổng tiền.
- NTILE(5) trong PostgreSQL chấm điểm được ngay, nhưng khách cùng số đơn vẫn có thể nhận điểm khác nhau nếu không xử lý giá trị trùng.
- Cần đủ dữ liệu: báo cáo RFM của Klaviyo đòi ít nhất 500 khách đã mua và 180 ngày lịch sử; Click Star chưa có ngưỡng chung cho mọi ngành.
- RFM mô tả hành vi đã xảy ra, không giải thích nguyên nhân, và nhạy với chu kỳ mua. Khách mới, B2B và từng nhóm sản phẩm cần cách xử lý riêng.
- Muốn biết phân khúc có tạo thêm doanh thu hay không, hãy giữ một nhóm đối chứng ngẫu nhiên không nhận chiến dịch rồi so cùng khoảng thời gian.
RFM là gì và từ đâu ra
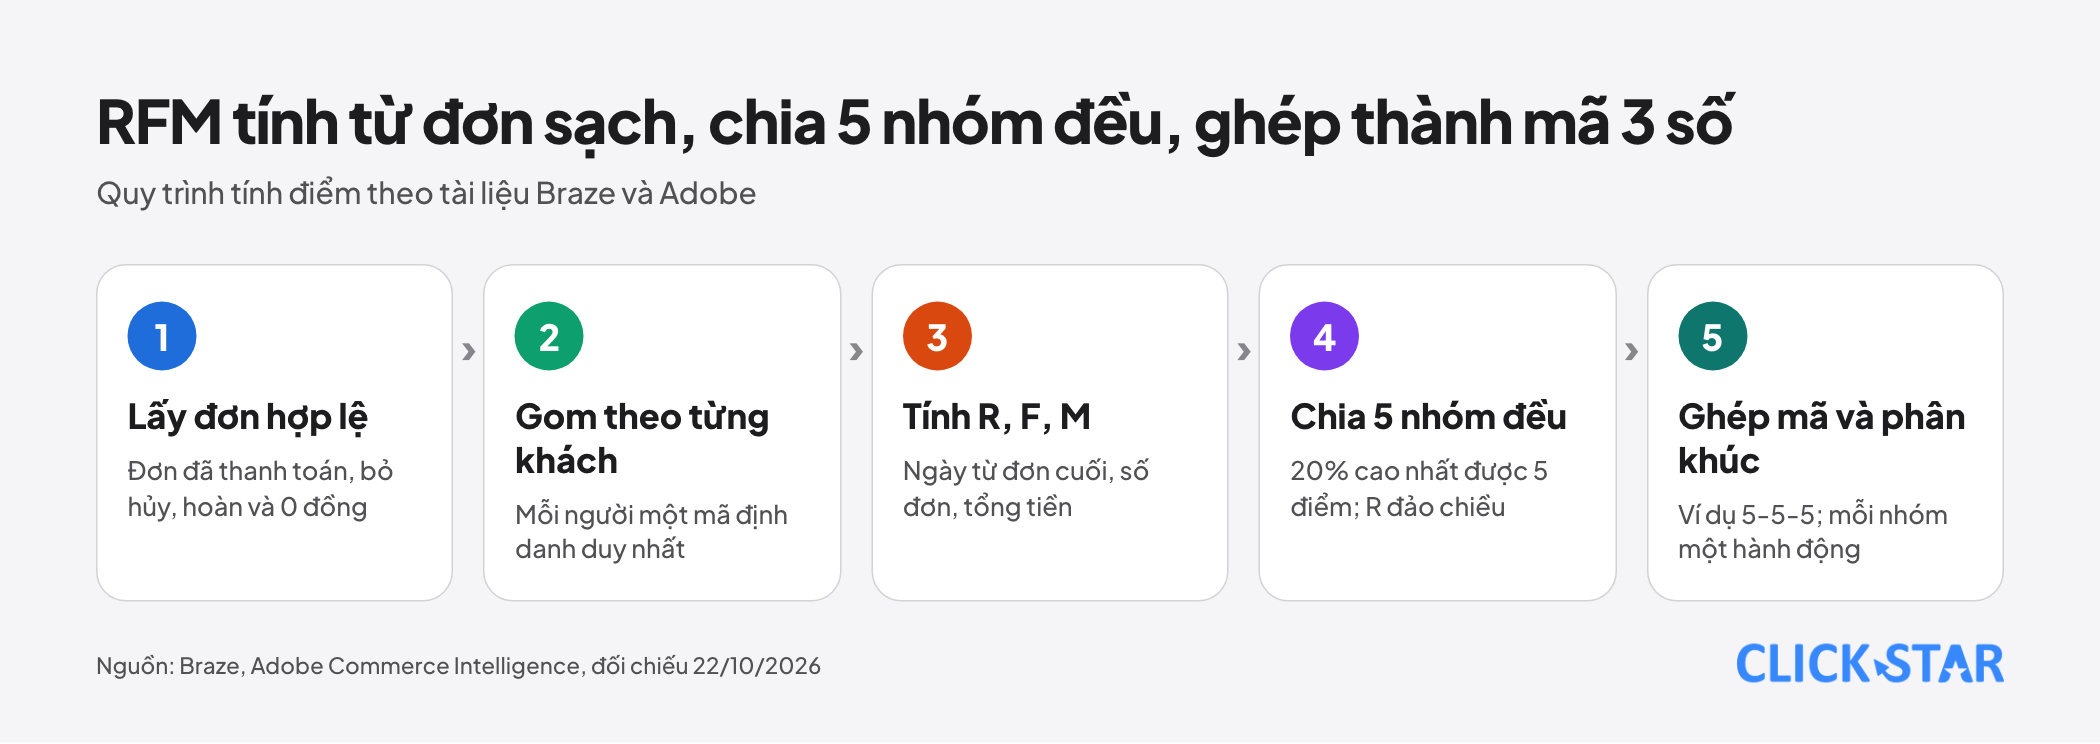
Theo Braze (đăng 23/5/2025, sửa lần cuối 11/11/2025), RFM nhóm khách theo hành vi giao dịch bằng 3 chỉ số. Mỗi chỉ số được xếp hạng, chia thành 5 nhóm đều nhau, rồi ghép thành một mã như 5-5-5 hay 1-2-1.
Fader, Hardie và Lee (bản chỉnh sửa tháng 2/2005) nói tóm tắt hành vi mua trong quá khứ bằng R, F, M là thông lệ phổ biến, lấy từ tài liệu về marketing trực tiếp. Theo Wikipedia (nguồn thứ cấp), bài đăng ở Journal of Marketing Research.
Click Star không tìm được nguồn mở nêu rõ người đặt ra phương pháp, nên không khẳng định.
Tính 3 chỉ số: R, F, M
Hãy bắt đầu từ bảng đơn sạch: chỉ tính đơn đã thanh toán, loại đơn hủy, hoàn tiền và đơn 0 đồng. Klaviyo chỉ tính đơn có giá trị dương (trang hỗ trợ cập nhật 18/11/2025).
- R (Recency): số ngày từ đơn gần nhất đến ngày tính. Adobe Commerce Intelligence (cập nhật 8/10/2026) tính bằng số giây từ đơn gần nhất.
- F (Frequency): số đơn trong cửa sổ thời gian. Adobe dùng số đơn từ trước đến nay.
- M (Monetary): tổng tiền thuần. Adobe dùng tổng doanh thu từ trước đến nay; Fader và cộng sự dùng trung bình tiền mỗi đơn.
Chọn tổng hay trung bình làm đổi ý nghĩa. Tổng tiền gắn chặt với số đơn, nên F và M hay đi cùng nhau; trung bình mỗi đơn tách khách mua ít đơn lớn khỏi khách mua nhiều đơn nhỏ.
Hãy chốt cửa sổ thời gian theo chu kỳ mua của ngành. Mỗi khách cũng cần một mã định danh duy nhất: đơn qua Zalo, website và cửa hàng không nối về một người sẽ làm F thấp giả. Click Star đã có bài về hợp nhất dữ liệu khách hàng.
Chấm điểm: chia nhóm theo phân vị và các biến thể
Braze chia mỗi chỉ số thành 5 nhóm đều: 20% cao nhất được 5 điểm, 20% kế tiếp được 4 điểm, và cứ thế đến 1. Adobe làm tương tự. R phải đảo chiều: càng ít ngày kể từ đơn cuối thì điểm càng cao.
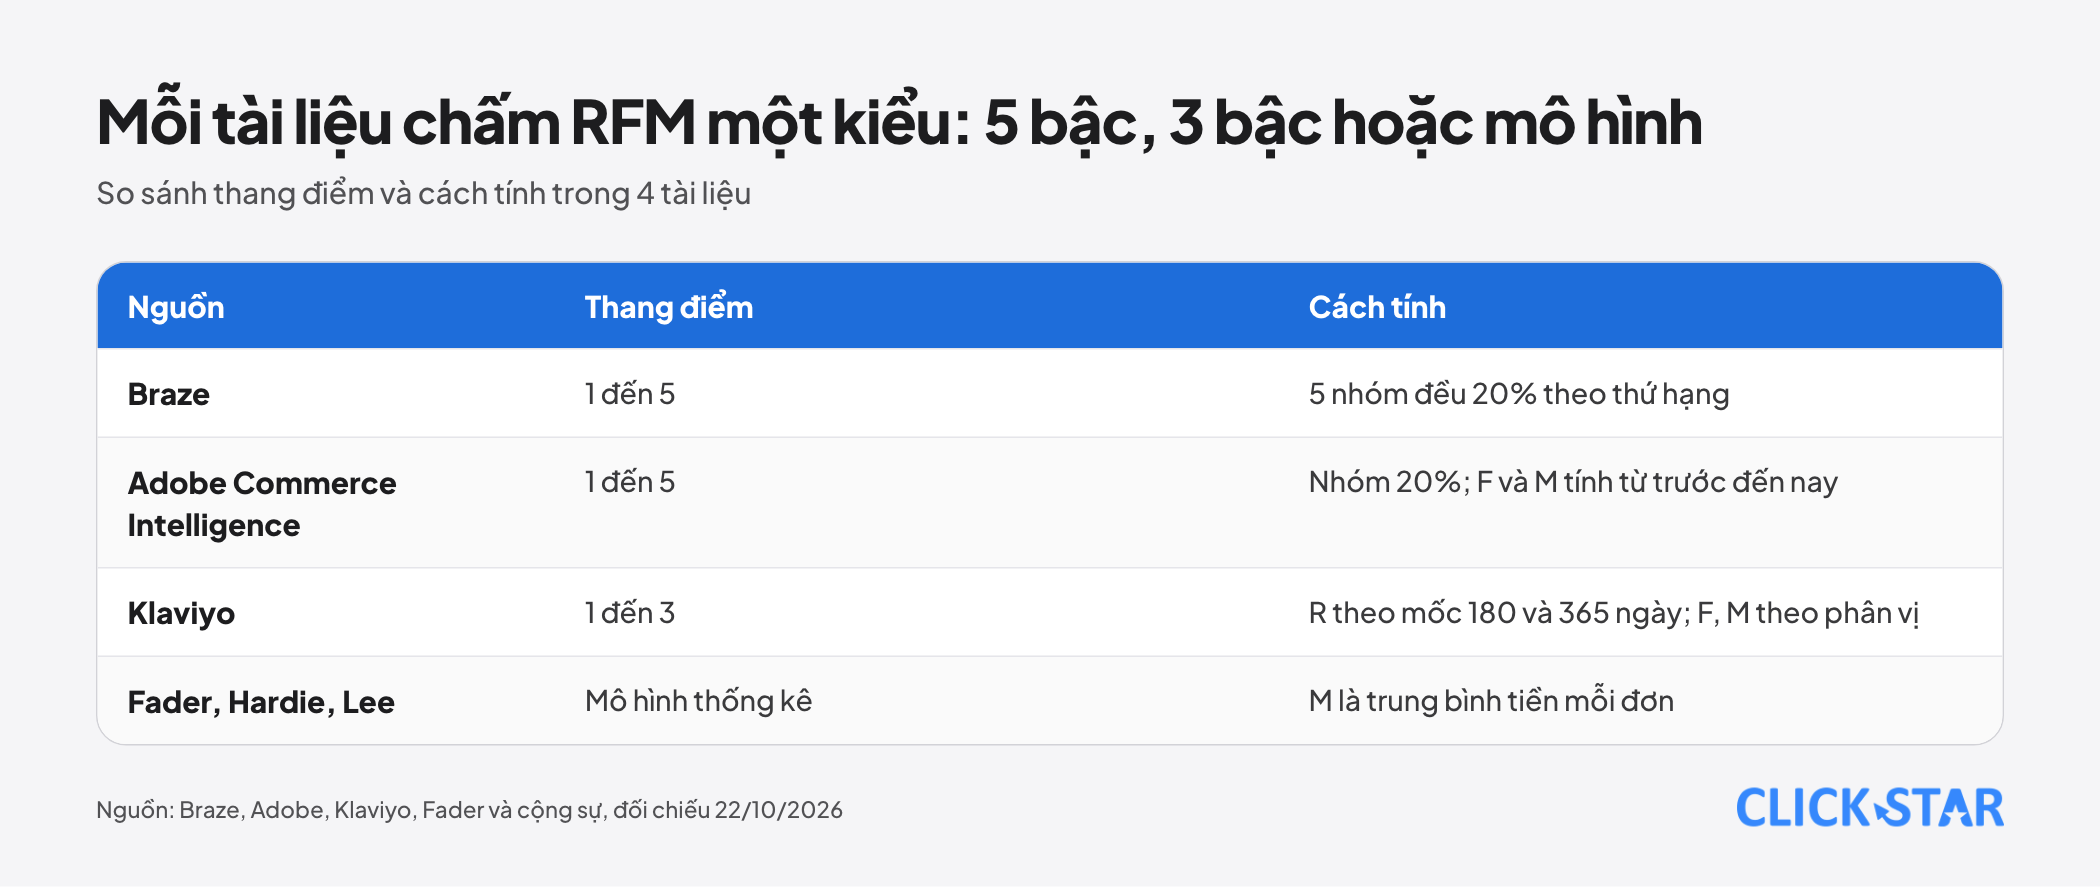
Klaviyo dùng thang từ 1 đến 3. Recency chấm theo mốc ngày: đơn trong 180 ngày gần nhất được 3, trong 365 ngày được 2, cũ hơn và khó mua lại theo Klaviyo được 1. Frequency và Monetary chấm theo phân vị, 33% cao nhất được 3.
Suy luận của Click Star, không lấy từ nguồn ngoài: ít khách thì dùng 3 bậc để mỗi ô còn đủ người, nhiều khách thì 5 bậc. Con số 500 khách của Klaviyo là điều kiện riêng của báo cáo đó, không phải chuẩn ngành.
Ví dụ SQL tính RFM trong PostgreSQL
Tài liệu PostgreSQL 18 (đọc 22/10/2026) mô tả ntile(num_buckets) trả về số nguyên từ 1 đến giá trị truyền vào, chia phân vùng đều nhất có thể. Đoạn dưới là mẫu minh họa của Click Star trên bảng orders giả định (order_date kiểu date).
WITH base AS (
  SELECT customer_id,
         DATE '2026-10-22' - MAX(order_date) AS recency_days,
         COUNT(DISTINCT order_id) AS frequency,
         SUM(net_amount) AS monetary
  FROM orders
  WHERE order_date BETWEEN DATE '2025-10-23' AND DATE '2026-10-22'
    AND status = 'paid' AND net_amount > 0
  GROUP BY customer_id
), scored AS (
  SELECT *,
         NTILE(5) OVER (ORDER BY recency_days DESC, customer_id) AS r,
         NTILE(5) OVER (ORDER BY frequency, customer_id) AS f,
         NTILE(5) OVER (ORDER BY monetary, customer_id) AS m
  FROM base
)
SELECT customer_id, r, f, m,
  CASE
    WHEN r >= 4 AND f >= 4 AND m >= 4 THEN 'vip_dang_hoat_dong'
    WHEN r <= 2 AND f >= 4 AND m >= 4 THEN 'vip_nguy_co_roi_di'
    WHEN r >= 4 AND f <= 2 THEN 'moi_it_mua'
    WHEN r <= 2 AND f <= 2 THEN 'ngu_dong'
    WHEN r <= 2 THEN 'giam_dan'
    ELSE 'deu_dan'
  END AS segment
FROM scored;
R sắp xếp giảm dần theo số ngày để khách mua gần nhất nhận điểm 5. Khi số khách không chia hết cho 5, các nhóm lệch nhau tối đa 1 người: Click Star thử 7 dòng chia 3 nhóm trên PostgreSQL 16.2 ra 3, 2 và 2 dòng.
NTILE cắt theo vị trí dòng chứ không theo giá trị. Khi nhiều khách cùng số đơn, họ vẫn có thể nhận điểm F khác nhau, chỉ nhờ cột phụ customer_id. Nếu nhiều giá trị trùng, hãy cân nhắc mốc cố định (1, 2, 3 đơn trở lên) thay cho chia phân vị.
Khung phân khúc tham khảo của Click Star
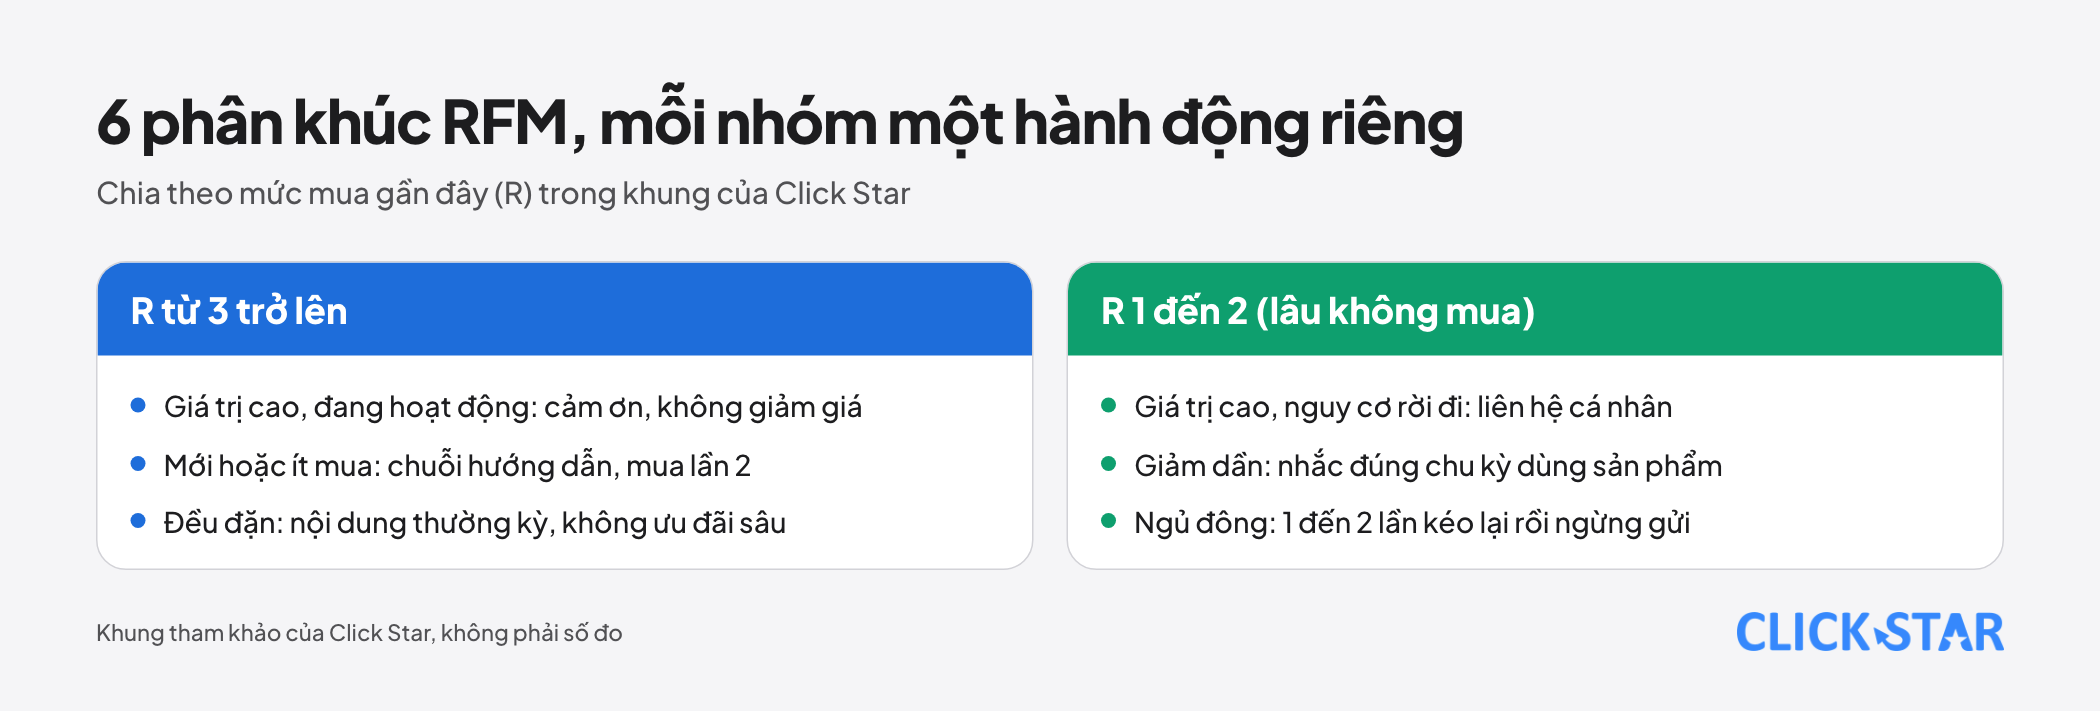
Đây là khung 6 phân khúc mà đoạn SQL dùng: khung tham khảo của Click Star, không lấy từ nguồn ngoài và không phải số đo. Hãy chỉnh theo chu kỳ mua của ngành.
- Giá trị cao, đang hoạt động (R 4 đến 5, F 4 đến 5, M 4 đến 5): mua nhiều, chi nhiều, mới mua gần đây.
- Giá trị cao, có nguy cơ rời đi (R 1 đến 2, F 4 đến 5, M 4 đến 5): từng là khách tốt nhưng lâu không mua. Nên liên hệ cá nhân trước tiên.
- Mới hoặc ít mua (R 4 đến 5, F 1 đến 2): vừa mua, chưa lặp lại.
- Ngủ đông (R 1 đến 2, F 1 đến 2): lâu không mua, mua ít.
- Giảm dần (R 1 đến 2, F từ 3 trở lên, chưa vào nhóm giá trị cao): từng mua đều nhưng đang xa dần.
- Đều đặn (nhóm còn lại, R từ 3 trở lên): mua ở mức trung bình, chưa cần can thiệp.
Điều kiện dữ liệu: chu kỳ mua, khách mới, B2B và dữ liệu thiếu
Chu kỳ mua. R chỉ có nghĩa khi so với nhịp mua thông thường. Suy luận của Click Star: cửa hàng bán đồ bền, 2 năm mua một lần, sẽ thấy hầu hết khách có R thấp dù chẳng ai rời đi.
Khách mới. Khách có 1 đơn đều có F bằng 1, nên F không phân biệt họ. Nên tách khách mới thành một nhóm riêng và chỉ chia điểm cho khách đã mua lặp lại.
B2B. Click Star chưa có nguồn mở về RFM cho B2B. Suy luận của Click Star: khi chỉ có vài chục tài khoản, mỗi hợp đồng lớn kéo cả điểm M nên chia phân vị dễ gây nhiễu. Danh sách theo từng tài khoản, gắn người phụ trách và ngày gia hạn, thường hữu ích hơn.
Dữ liệu thiếu. Đơn chưa nối với người mua, mã khách trùng hoặc đơn hoàn chưa trừ làm điểm sai mà không báo lỗi. Klaviyo để trống RFM của hồ sơ chưa đủ dữ liệu; nên làm tương tự thay vì gán điểm thấp.
Giới hạn của RFM
RFM chỉ cho biết điều đã xảy ra, không cho biết lý do. Khách có R thấp có thể đã hết nhu cầu, chuyển sang đối thủ, gặp lỗi dịch vụ hoặc chưa đến kỳ mua lại; điểm số không phân biệt được.
Wikipedia (nguồn thứ cấp) cảnh báo nhóm giá trị nhất có thể chỉ là khớp ngẫu nhiên nên cần kiểm lại trên bộ dữ liệu khác. Trang này cũng nói cách định nghĩa điểm tùy mô hình kinh doanh và có thể gộp các nhóm con quá nhỏ.
Fader và cộng sự coi R, F, M chỉ là chỉ báo không hoàn hảo của hành vi nền bên dưới, và đề xuất mô hình thống kê (Pareto/NBD cùng gamma-gamma) để dự báo giá trị vòng đời. Điểm RFM phù hợp để chia nhóm hành động, chưa phải công cụ dự báo.
RFM cũng nhạy với chu kỳ mua và nhóm sản phẩm: khách mua cả hàng tiêu dùng nhanh lẫn hàng bền gộp vào một điểm F sẽ bị méo. Nên tính riêng theo nhóm sản phẩm hoặc dòng dịch vụ.
Bài của nhóm Fader còn cảnh báo sai lệch chọn mẫu: nếu khách đã được ưu đãi khác nhau dựa trên hành vi cũ, việc đọc kết quả cần rất thận trọng. Đó là lý do cần nhóm đối chứng.
Dùng RFM trong CRM và chiến dịch
Tính RFM theo lịch (hằng tuần hoặc hằng tháng), lưu 3 điểm và tên phân khúc trên hồ sơ khách trong CRM, rồi dùng trường đó để lọc danh sách gửi email, Zalo, SMS hoặc tệp quảng cáo.
Trang dịch vụ CRM và CDP của Click Star công bố khả năng phân khúc khách, tạo tệp tiếp thị lại và gửi tự động qua email, Zalo ZNS và SMS. Lợi ích liên quan: Click Star làm dịch vụ này.
Braze gợi ý thưởng nhóm mua nhiều nhất, tái kích hoạt nhóm lâu không mua, hoặc bỏ qua nhóm kém tương tác hay đưa vào chuỗi win-back. Áp vào khung của Click Star:
- Giá trị cao, đang hoạt động: lời cảm ơn, quyền mua sớm, không cần giảm giá.
- Giá trị cao, có nguy cơ rời đi: người phụ trách liên hệ, hỏi lý do thay vì gửi mã giảm giá hàng loạt.
- Mới hoặc ít mua: chuỗi hướng dẫn và gợi ý mua lần thứ 2.
- Giảm dần: nhắc đúng chu kỳ dùng sản phẩm.
- Ngủ đông: 1 đến 2 lần thử kéo lại, sau đó ngừng gửi.
- Đều đặn: nội dung thường kỳ, không ưu đãi sâu.
Chỉ gửi qua kênh khách đã đồng ý nhận tin, và giới hạn số tin mỗi tuần cho từng khách.
Đo kết quả bằng nhóm đối chứng
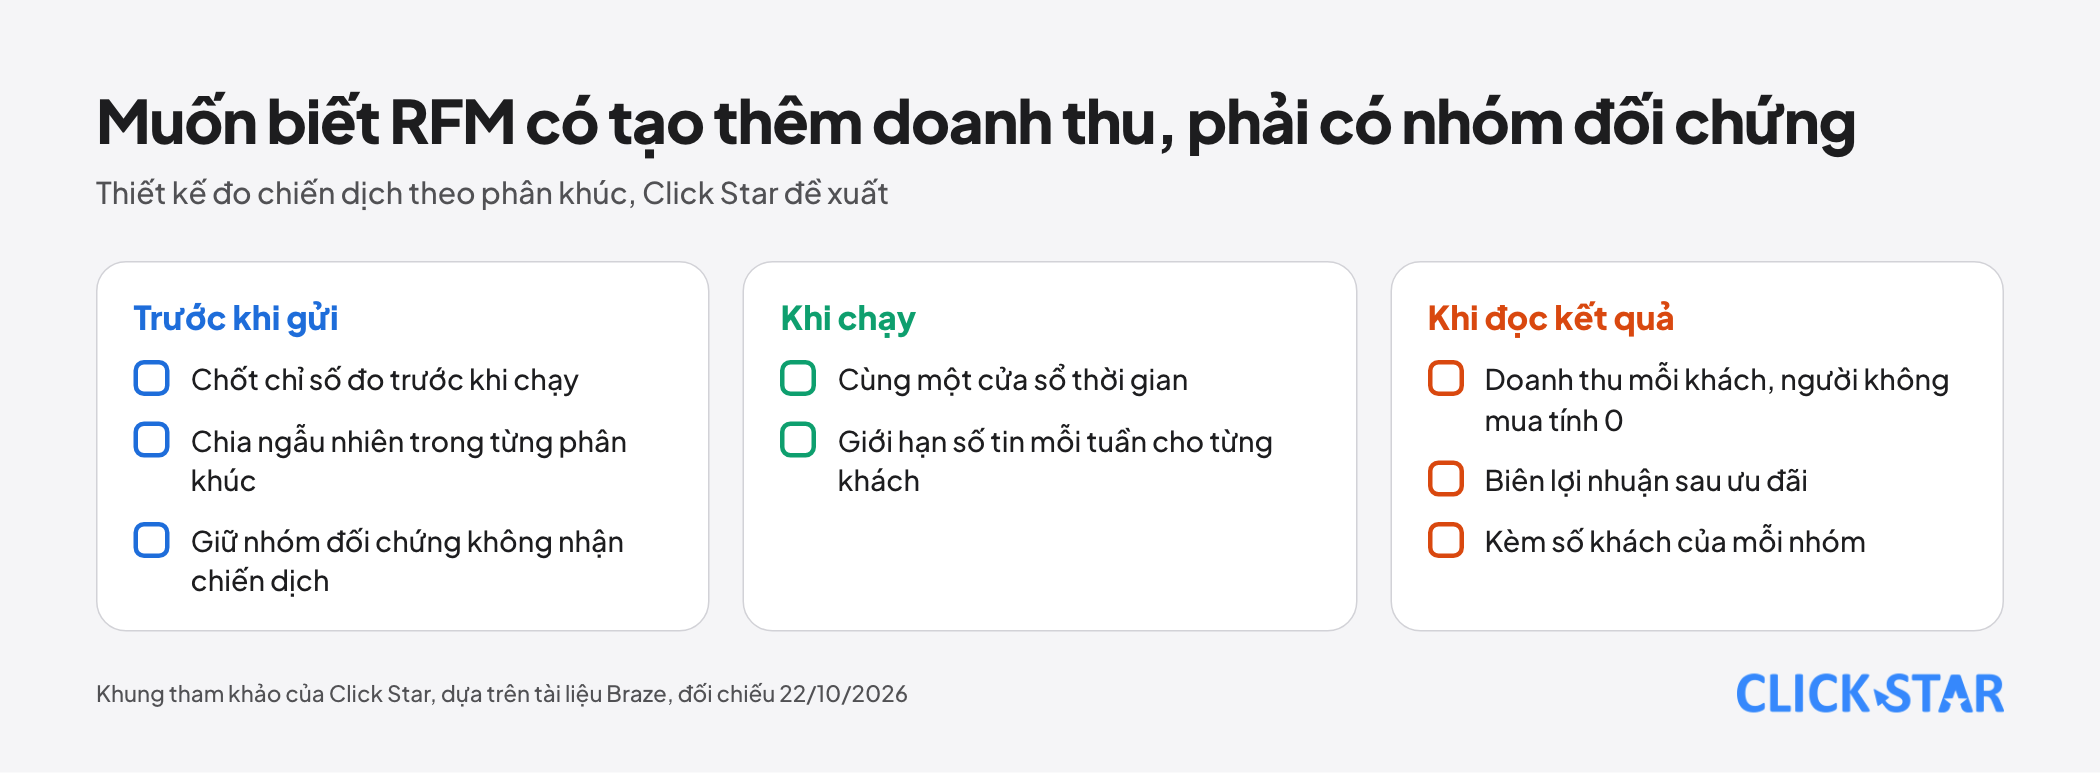
So trước và sau chiến dịch là chưa đủ, vì một phần khách sẽ tự quay lại dù không có chiến dịch. Cách sạch hơn là giữ một nhóm đối chứng ngẫu nhiên không nhận chiến dịch, rồi so với nhóm nhận trong cùng khoảng thời gian.
Tài liệu Global Control Group của Braze (không ghi ngày, đọc 22/10/2026) mô tả cách này cho sản phẩm của họ: một tỷ lệ người dùng chọn ngẫu nhiên bị loại khỏi các chiến dịch và Canvas (trừ chiến dịch API và chiến dịch gắn tag loại trừ), rồi báo cáo so sánh hai nhóm.
Hướng dẫn thử nghiệm của Braze: nhóm tối thiểu 1.000 người, không quá khoảng 10% tệp (tệp dưới 10.000 thì nâng lên tối đa 15% để đủ 1.000 người), chạy ít nhất 1 tháng. Đây là khuyến nghị cho sản phẩm Braze, không phải quy tắc chung; số lượt chuyển đổi nhỏ làm kết quả dao động.
Cách làm Click Star đề xuất, dựa trên các tài liệu trên:
- Chia ngẫu nhiên bên trong từng phân khúc.
- Chốt trước chỉ số đo: tỷ lệ mua lại trong N ngày, doanh thu mỗi khách (người không mua tính 0), biên lợi nhuận sau ưu đãi và tỷ lệ hủy nhận tin.
- Không loại khách không mở tin khỏi nhóm nhận khi so sánh.
- Đọc kết quả cùng một cửa sổ thời gian, kèm số khách mỗi nhóm.
Đánh giá của Click Star. RFM là bước đầu hợp lý khi doanh nghiệp đã có dữ liệu đơn sạch và muốn bỏ thói quen gửi một thông điệp cho mọi người. Giá trị của nó là buộc đội ngũ đặt tên và hành động cho từng nhóm, không phải độ chính xác của điểm.
Rủi ro chính là tin điểm số giải thích được hành vi. Phần chứng minh hiệu quả thuộc về thử nghiệm đối chứng. Click Star có làm dịch vụ CRM và CDP, nên hãy cân nhắc theo đó.
Lộ trình 30 ngày
- Tuần 1: chốt định nghĩa đơn hợp lệ, cửa sổ thời gian và mã định danh khách; đếm đơn chưa nối được về một người.
- Tuần 2: chạy truy vấn trên dữ liệu thật, xem F có nhiều giá trị trùng không, chọn thang 3 hay 5 bậc và chốt 5 đến 6 phân khúc.
- Tuần 3: lưu điểm và phân khúc lên hồ sơ CRM, viết mỗi phân khúc 1 hành động và quy tắc giới hạn tần suất gửi.
- Tuần 4: chạy chiến dịch đầu tiên có nhóm đối chứng và hẹn ngày đọc kết quả theo chu kỳ mua.
Những sai lầm thường gặp
- Chia phân vị mà không xử lý giá trị trùng, nên khách giống nhau nhận điểm khác nhau.
- Dùng ngưỡng của nền tảng khác (180 ngày, 500 khách) cho ngành có chu kỳ mua rất khác.
- Đọc điểm R thấp là khách đã bỏ đi, trong khi chu kỳ mua có thể dài hơn cửa sổ đang dùng.
- Gộp mọi nhóm sản phẩm và mọi kênh vào một điểm duy nhất.
- Giảm giá cho nhóm đang mua đều, mất biên lợi nhuận mà không thêm đơn.
- So trước và sau chiến dịch không có nhóm đối chứng, rồi kết luận RFM hiệu quả.
Điều chưa biết
Click Star không có số đo về mức tăng doanh thu nhờ RFM ở doanh nghiệp Việt Nam và không nêu phần trăm hiệu quả nào vì chưa có nguồn mở đáng tin. Chưa có ngưỡng khách tối thiểu hay cách chia điểm chung theo ngành, và chưa có nguồn mở về RFM cho B2B.
Chưa xác định được ai đặt ra phương pháp. Tài liệu của Braze, Adobe, Klaviyo có thể đổi; phần so sánh chỉ đúng tại ngày đọc.
Bài liên quan



Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.