Prompt, RAG hay tinh chỉnh mô hình: AI sai thì chữa cách nào?
Prompt, RAG hay tinh chỉnh chữa loại lỗi nào của AI? Bài tổng hợp tài liệu OpenAI, Anthropic, Google Cloud, Amazon Bedrock và arXiv, kèm bộ câu hỏi thử và lộ trình 14 ngày.
Một cửa hàng online có chatbot trả lời sai chính sách đổi trả, lại nói giọng cộc lốc với khách. Nhóm có 3 ý kiến: viết lại câu lệnh cho AI, nạp tài liệu cho AI tra cứu, hoặc huấn luyện lại mô hình.
Bài này so sánh 3 cách: prompt (câu lệnh gửi cho AI), RAG (cho AI tra tài liệu ngay lúc trả lời) và tinh chỉnh (fine-tuning, tức huấn luyện thêm mô hình trên ví dụ của bạn). Nguồn chính là tài liệu của OpenAI, Anthropic, Google Cloud, Amazon Bedrock và các nghiên cứu trên arXiv, đối chiếu đến ngày 24/10/2026.
Bài trả lời: mỗi cách chữa loại lỗi nào, làm sao biết mình gặp lỗi nào, khi nào nên dừng. Click Star đã có bài riêng về RAG, về đánh giá chatbot AI và về tối ưu token; bài này không lặp lại các bài đó.
Điểm chính
- Có 2 loại lỗi khác nhau. Thiếu kiến thức (tài liệu riêng, thông tin đã cũ) thì cần đưa ngữ cảnh vào. Sai cách làm (định dạng, giọng văn) thì cần dạy hành vi (theo OpenAI).
- Hãy bắt đầu từ prompt và bộ câu hỏi thử có đáp án (OpenAI nêu 20 câu trở lên) để thấy lỗi nằm ở đâu.
- RAG hợp khi kiến thức đổi thường xuyên hoặc là dữ liệu riêng. Tinh chỉnh hợp khi cần hành vi ổn định và có ví dụ chất lượng: OpenAI gợi ý từ 50 ví dụ, Google Cloud nêu khoảng 100.
- Tinh chỉnh không phải đường nạp kiến thức. Gekhman và cộng sự (EMNLP 2024) thấy mô hình học sự kiện mới rất chậm qua tinh chỉnh, và khi đã học thì có xu hướng bịa nhiều hơn.
- Ghép nhiều cách chưa chắc tốt hơn. Trong thử nghiệm của OpenAI, thêm RAG lấy ví dụ từ kho tra cứu vào mô hình đã tinh chỉnh làm điểm BLEU (thang 100, đo độ gần với đáp án mẫu) giảm từ 87 xuống 83.
- Tinh chỉnh còn tùy nhà cung cấp: OpenAI đang thu hẹp nền tảng tự phục vụ của mình, Google Cloud và Amazon Bedrock vẫn mô tả tính năng.
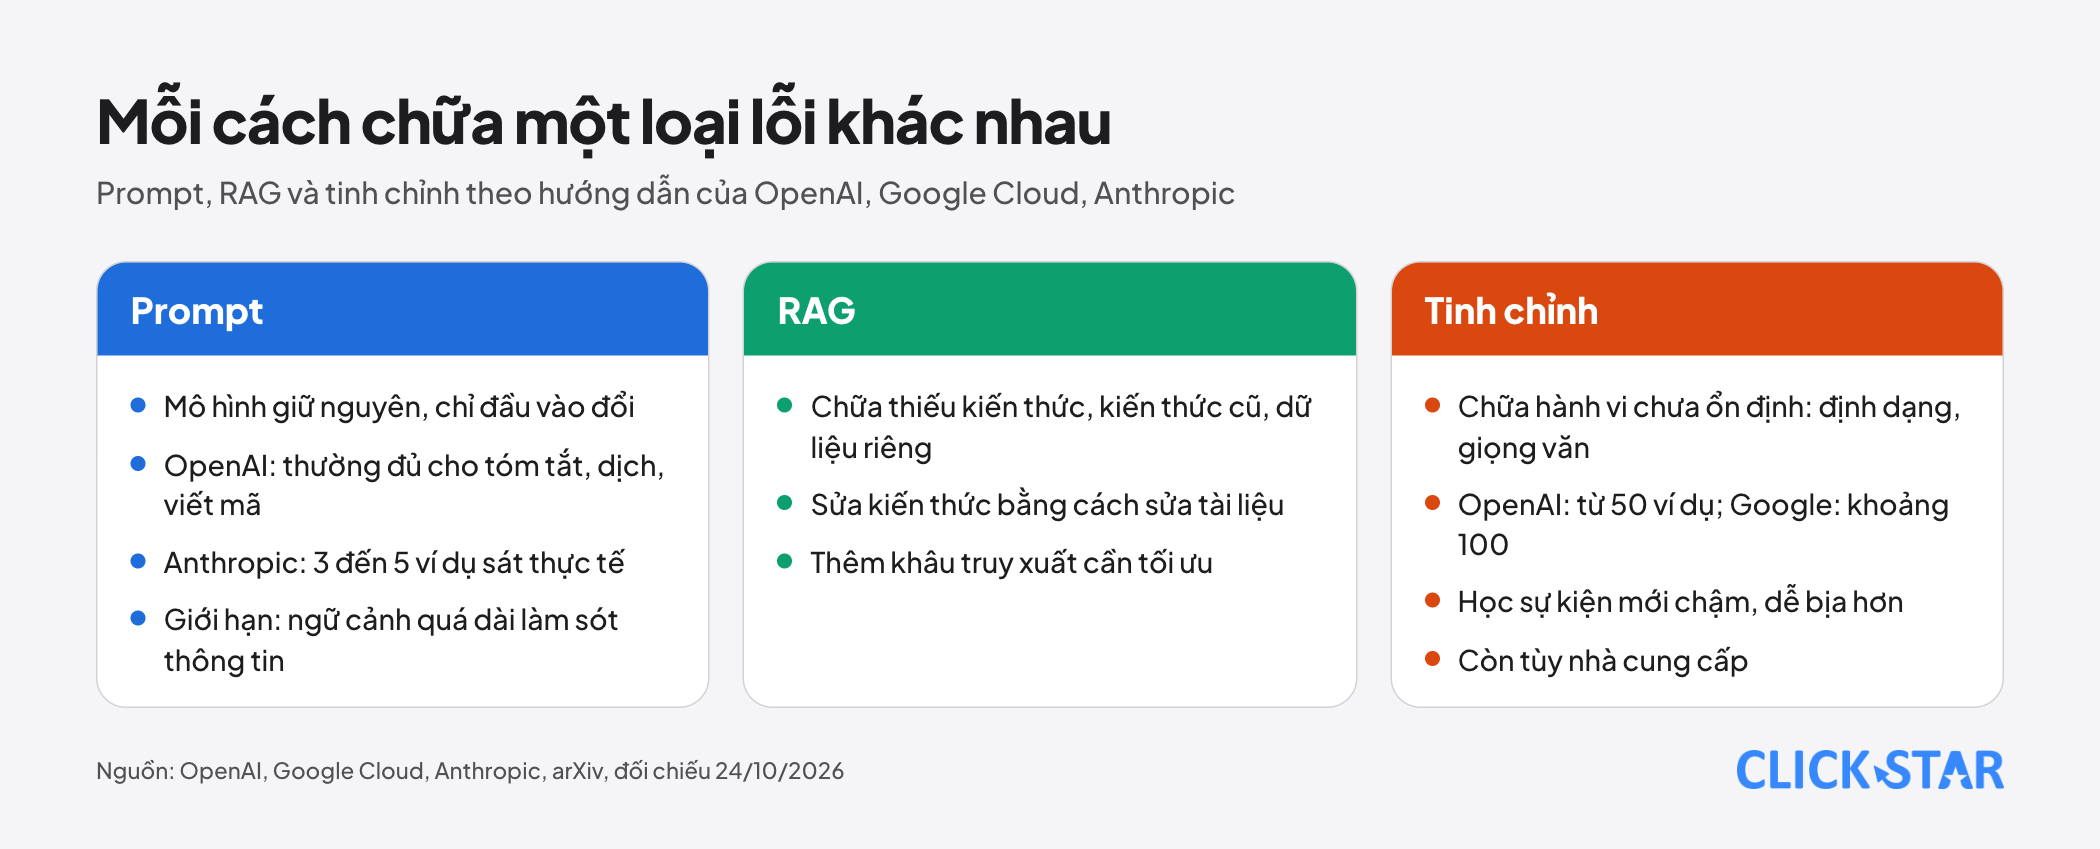
3 cách làm AI "biết việc" khác nhau ở đâu
Hãy hình dung AI là một nhân viên mới. Prompt là tờ hướng dẫn công việc đặt trước mặt. RAG là tủ hồ sơ để nhân viên tra khi khách hỏi. Tinh chỉnh là khóa huấn luyện dài ngày để làm đúng thói quen mà không cần nhìn hướng dẫn. Phép so sánh này của Click Star, gần ý ví von kỳ thi của OpenAI.
Với prompt và RAG, mô hình giữ nguyên, chỉ đầu vào đổi: RAG tìm đoạn tài liệu liên quan rồi đưa vào prompt trước khi mô hình trả lời.
Tinh chỉnh là huấn luyện tiếp một mô hình có sẵn trên bộ dữ liệu nhỏ, chuyên cho 1 việc. Theo Google Cloud (cập nhật ngày 22/10/2026), cách này điều chỉnh tham số của mô hình theo dữ liệu của bạn.
Bắt đầu từ loại lỗi, không bắt đầu từ công cụ
Nhiều bài xếp 3 cách thành bậc thang: prompt, rồi RAG, rồi tinh chỉnh. OpenAI nói thực tế thường không phải đường thẳng: đó là các cần gạt chữa vấn đề khác nhau, và cần kéo đúng cần.
Cần tối ưu ngữ cảnh khi mô hình thiếu kiến thức, kiến thức đã cũ hoặc cần thông tin độc quyền. Cần tối ưu hành vi khi kết quả không nhất quán, sai định dạng hoặc sai giọng văn (OpenAI, hướng dẫn "Optimizing LLM Accuracy", không ghi ngày).
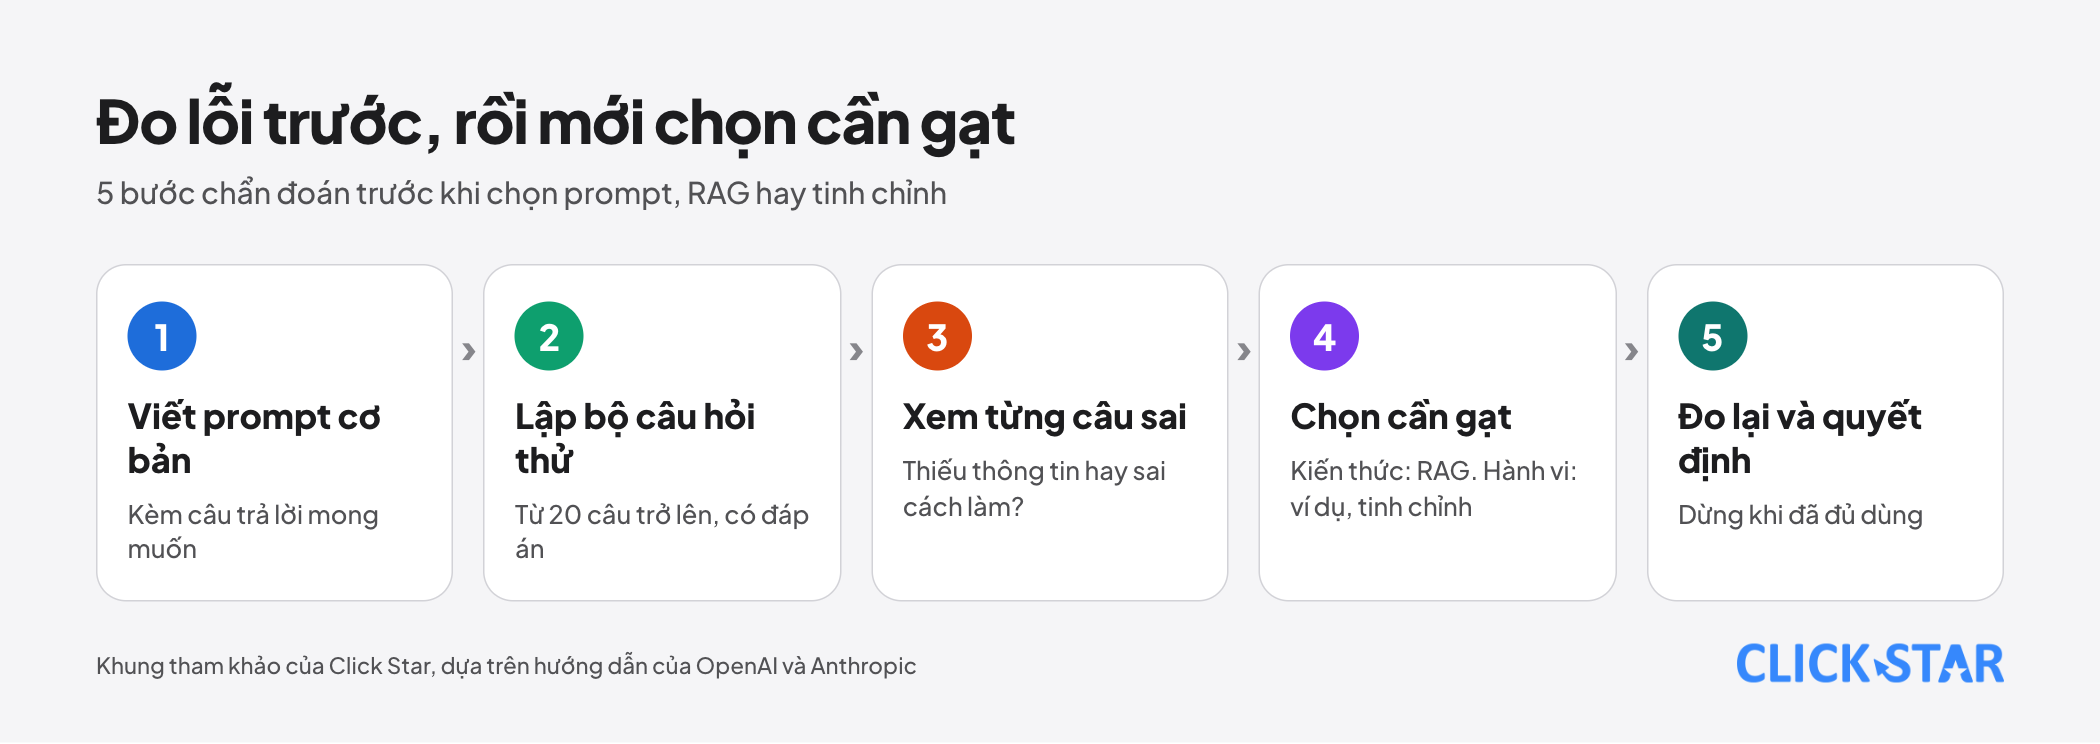
Vì vậy bước đầu là đo, không phải chọn công cụ. Anthropic yêu cầu tiêu chí thành công cụ thể, đo được, rồi kiểm thử trên bộ ví dụ giữ riêng (tài liệu "Define success criteria and build evaluations", không ghi ngày).
OpenAI gợi ý bộ câu hỏi thử từ 20 câu trở lên kèm đáp án đúng. Với mỗi câu sai, hãy hỏi: mô hình thiếu thông tin, hay có thông tin mà làm sai cách?
Prompt: đủ cho nhiều việc hơn bạn nghĩ
Với tóm tắt, dịch và viết mã, OpenAI cho biết prompt thường là đủ để dùng thật. Lý do hãng nêu cho việc bắt đầu từ prompt: viết prompt buộc bạn định nghĩa thế nào là đúng.
Ví dụ từ hãng: sửa lỗi câu tiếng Iceland bằng GPT-4, điểm BLEU là 62 khi không có ví dụ và 70 khi thêm 3 ví dụ mẫu. Mô hình cũ, tiếng Iceland, chỉ để minh họa.
Anthropic khuyên dùng 3 đến 5 ví dụ sát thực tế và đa dạng (hướng dẫn viết prompt cho Claude của Anthropic). Hãng cũng khuyên cho phép trả lời "tôi không đủ thông tin" khi tài liệu thiếu, và nói các kỹ thuật này giảm chứ không loại bỏ hoàn toàn ảo giác (tài liệu "Reduce hallucinations").
Giới hạn: nhồi cả kho tài liệu vào prompt chưa chắc giải quyết được. Liu và cộng sự (arXiv, 6/7/2023) thấy độ chính xác giảm đáng kể khi thông tin cần tìm nằm giữa ngữ cảnh dài.
OpenAI không bảo bỏ ngữ cảnh dài, mà khuyên đo ở nhiều cỡ ngữ cảnh.
RAG: khi kiến thức đổi thường xuyên hoặc là dữ liệu riêng
Chọn RAG khi lỗi là "AI không biết". Bảng giá đổi mỗi tuần hay tài liệu nội bộ là kiến thức mô hình không có sẵn hoặc đã cũ.
Ưu điểm lớn: sửa kiến thức bằng cách sửa tài liệu. Bài báo gốc về RAG (Lewis và cộng sự, arXiv, 22/5/2020) nêu 2 vấn đề còn bỏ ngỏ của mô hình chỉ dựa vào những gì nó đã học: cập nhật kiến thức và chỉ ra nguồn của câu trả lời.
RAG thêm một thứ cần tối ưu là khâu truy xuất. Theo OpenAI, truy xuất đưa sai đoạn hoặc quá nhiều đoạn thừa sẽ át mất thông tin thật.
Tinh chỉnh: dạy cách làm, không dạy kiến thức
Chọn tinh chỉnh khi mô hình đã biết đủ nhưng làm không đều. OpenAI nêu 2 lý do chính: tăng độ chính xác trên 1 việc cụ thể, hoặc tăng hiệu quả (ít token hơn, hoặc dùng mô hình nhỏ hơn).
Google Cloud nêu các việc hợp với tinh chỉnh có giám sát: phân loại, phân tích cảm xúc, trích xuất thực thể và tóm tắt nội dung không phức tạp. Lợi ích kèm theo là prompt ngắn hơn, nên giảm chi phí và độ trễ khi chạy.
Về dữ liệu, OpenAI khuyên bắt đầu từ 50 ví dụ trở lên, ưu tiên chất lượng hơn số lượng, và ví dụ phải giống đầu vào thật. Google Cloud nêu "khoảng 100 ví dụ trở lên", còn phần tinh chỉnh có giám sát của trang nói hàng trăm ví dụ có nhãn. Mỗi hãng nêu mốc riêng; đừng coi đó là ngưỡng chuẩn.
Điểm hay bị hiểu sai là dùng tinh chỉnh để AI "thuộc" tài liệu công ty. Gekhman và cộng sự (arXiv, 9/5/2024, bản 3 ngày 1/10/2024) thấy ví dụ chứa kiến thức mới được học chậm hơn hẳn ví dụ khớp kiến thức sẵn có, và khi đã học thì làm tăng tuyến tính xu hướng bịa.
Họ kết luận mô hình chủ yếu học sự kiện lúc tiền huấn luyện (giai đoạn học ban đầu), còn tinh chỉnh dạy cách dùng chúng. Giới hạn: đây là bài toán hỏi đáp không có tài liệu kèm, chưa nói thay cho mọi mô hình hiện nay.
Thử nghiệm của OpenAI cho thấy cả hai mặt. Tinh chỉnh với 1.000 ví dụ đưa điểm BLEU của gpt-3.5-turbo lên 78 và của gpt-4 lên 87, so với 70 khi chỉ có 3 ví dụ mẫu. Thêm RAG (lấy thêm 1.000 ví dụ khác từ kho tra cứu) vào mô hình tinh chỉnh làm điểm giảm còn 83: hãng giải thích đây là vấn đề hành vi và ngữ cảnh thêm chỉ là nhiễu.
OpenAI cũng nói 2 cách này có thể cộng dồn nếu lỗi gồm cả thiếu kiến thức lẫn sai hành vi.
Tinh chỉnh còn tùy nhà cung cấp và vòng đời mô hình
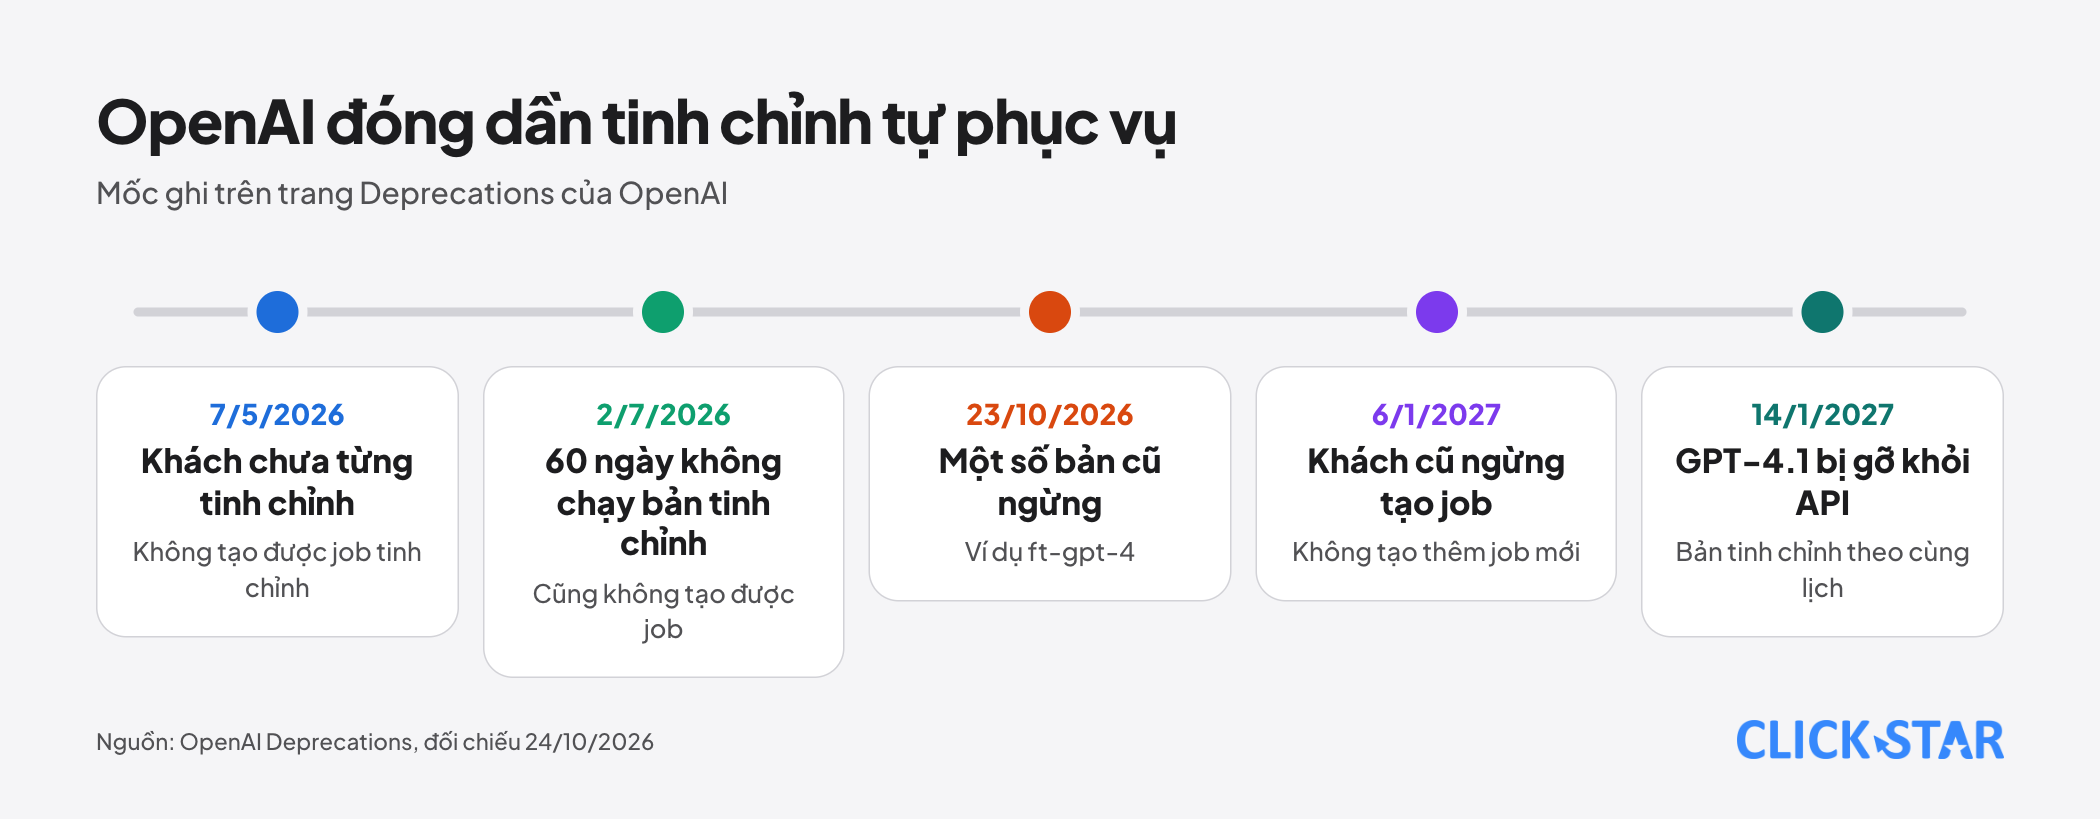
Hãy kiểm tra nhà cung cấp còn cho tinh chỉnh không. Trang "Model optimization" của OpenAI ghi hãng đang dần ngừng nền tảng tinh chỉnh: không mở cho người dùng mới, người dùng cũ còn tạo job (đợt huấn luyện mới) trong vài tháng tới.
Trang "Deprecations", mục nền tảng tinh chỉnh tự phục vụ, có các mốc: từ 7/5/2026 tổ chức chưa từng tinh chỉnh không tạo được job; từ 2/7/2026 tổ chức 60 ngày không chạy mô hình tinh chỉnh cũng vậy; từ 6/1/2027 khách cũ không tạo job mới.
Mô hình đã tinh chỉnh vẫn chạy đến khi mô hình gốc bị ngừng. Trang ghi GPT-4.1 bị gỡ khỏi API ngày 14/1/2027, bản tinh chỉnh theo cùng lịch; một số bản cũ như ft-gpt-4 đã ngừng ngày 23/10/2026.
Tinh chỉnh chưa hết thời. Trang "Introduction to tuning" của Google Cloud (cập nhật ngày 22/10/2026) liệt kê các mô hình Gemini hỗ trợ tinh chỉnh có giám sát, như Gemini 3.5 Flash. Trang Amazon Bedrock mô tả tinh chỉnh có giám sát, tinh chỉnh tăng cường và chưng cất.
Về Claude: bảng thuật ngữ của Anthropic ghi API Claude hiện chưa cung cấp tinh chỉnh. Trang tinh chỉnh của Amazon Bedrock chỉ liệt kê Claude 3 Haiku (vùng us-west-2).
So sánh theo tiêu chí
Bảng tổng hợp từ các tài liệu đã nêu, theo cách sắp xếp của Click Star (khung tham khảo, không phải số đo).
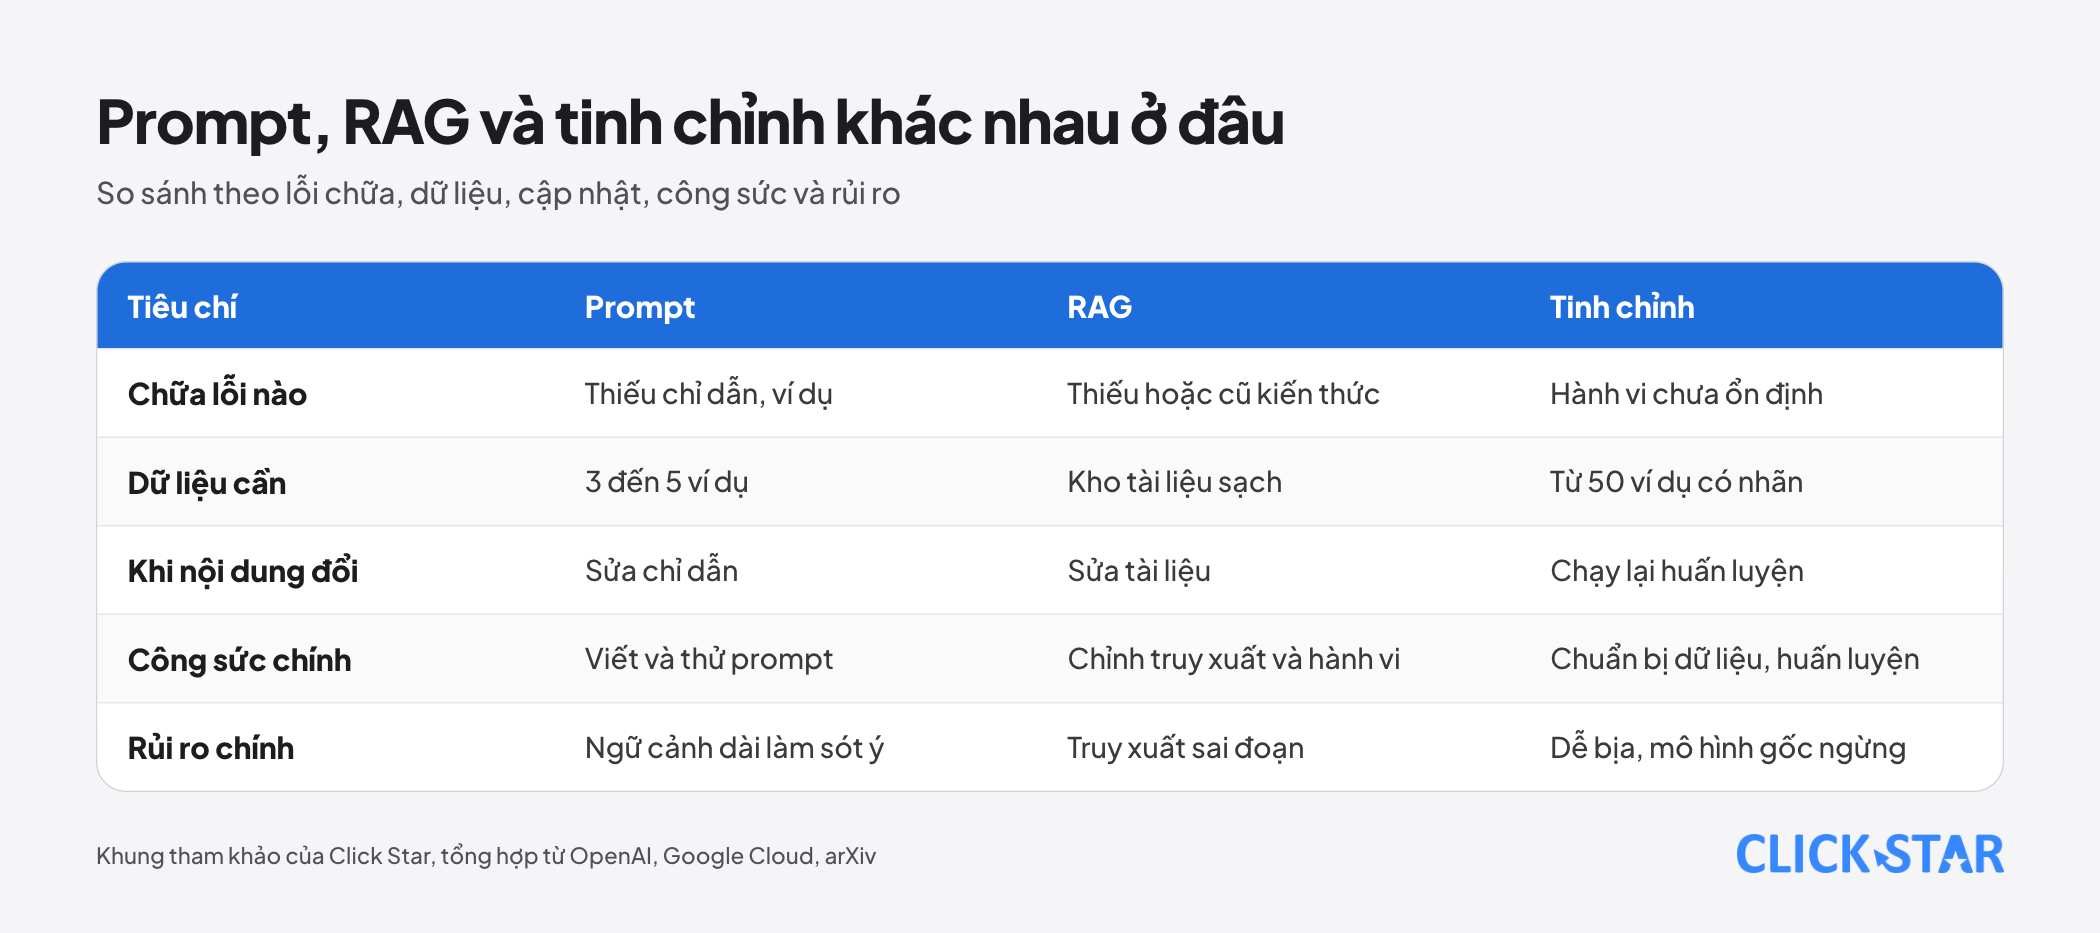
Theo OpenAI, RAG phải chỉnh khâu truy xuất, còn tinh chỉnh phải chạy lại huấn luyện và quản lý bộ dữ liệu. Khi nội dung đổi, RAG nhẹ hơn vì chỉ sửa tài liệu (nhận định của Click Star).
Hãng cũng cảnh báo cả 2 có thể gây hồi quy (kết quả vốn tốt bỗng tệ đi) khi ứng dụng phức tạp dần.
Tính bằng tiền trước khi đầu tư
Mức chính xác "đủ tốt" phụ thuộc thiệt hại của 1 lỗi. OpenAI đưa ví dụ minh họa cho trợ lý hỗ trợ khách hàng: ca AI xử lý thành công tiết kiệm 20 USD, ca chuyển nhầm cho nhân viên tốn 40 USD, ca khiến khách bỏ đi tốn 1.000 USD.
Giả định thêm 5% ca lỗi dẫn đến mất khách, hãng tính mức chính xác hòa vốn là 81,5% (số minh họa cách làm, không phải chuẩn ngành). Với việc thiệt hại cực lớn như gian lận, hãng để con người quyết định và AI chỉ hỗ trợ.
Click Star gợi ý (khung tham khảo, không lấy từ nguồn ngoài) lập bảng tương tự bằng số của bạn: giá trị 1 ca đúng, thiệt hại 1 ca sai nhẹ và 1 ca sai nặng. Nếu mức hiện tại đã trên hòa vốn, có thể chưa cần gấp đầu tư thêm, nhưng hãy so lợi ích tăng thêm với chi phí.
Ý nghĩa với doanh nghiệp Việt Nam
Click Star không tìm thấy số đo công khai so sánh 3 cách này trên dữ liệu tiếng Việt. Mọi con số trong bài đến từ nguồn nước ngoài; hãy thử bằng câu hỏi tiếng Việt thật của khách, có dấu và không dấu.
RAG lẫn tinh chỉnh đều chạm vào dữ liệu công ty, có thể gồm thông tin cá nhân của khách. Hãy hỏi bộ phận pháp lý trước khi đưa dữ liệu cá nhân vào; Click Star đã có bài riêng về đưa AI vào doanh nghiệp an toàn dữ liệu.
Đánh giá của Click Star. Với đa số chatbot doanh nghiệp, thứ tự hợp lý là lập bộ câu hỏi thử, chỉnh prompt, rồi thêm RAG nếu lỗi là thiếu kiến thức. Tinh chỉnh nên đến sau, chỉ để sửa hành vi, khi đã có nhiều ví dụ chất lượng và nhà cung cấp còn hỗ trợ.
Lý do là chi phí quay đầu: sửa prompt hoặc tài liệu nhanh hơn nhiều so với làm lại bản tinh chỉnh. Click Star làm dịch vụ tích hợp AI, nên nhận định này có thể thiên về giải pháp sẵn dùng; hãy đối chiếu với bộ câu hỏi thử của chính bạn.
Việc nên làm: lộ trình 14 ngày
Lộ trình dưới đây là khung tham khảo của Click Star, không lấy từ nguồn ngoài.
- Ngày 1 đến 2: gom 20 câu hỏi thật trở lên từ khách kèm đáp án đúng; đặt tiêu chí thành công đo được.
- Ngày 3 đến 4: viết prompt cơ bản, chạy toàn bộ câu hỏi, ghi lại câu sai.
- Ngày 5 đến 6: gắn nhãn mỗi câu sai: thiếu kiến thức hay sai cách làm.
- Ngày 7 đến 9: thêm 3 đến 5 ví dụ mẫu và quy tắc "không biết thì nói không biết".
- Ngày 10 đến 12: nếu còn thiếu kiến thức, thêm RAG với 1 nhóm tài liệu nhỏ; đo lại.
- Ngày 13 đến 14: lập bảng thiệt hại, so với mức chính xác hiện tại; quyết định dừng, mở rộng RAG hay gom ví dụ cho tinh chỉnh.
Những sai lầm thường gặp
- Chọn công cụ trước khi đo: thấy "tinh chỉnh" nghe chuyên nghiệp rồi làm ngay, không có bộ câu hỏi thử.
- Dùng tinh chỉnh để nạp bảng giá hay chính sách, trong khi nghiên cứu cho thấy mô hình khó học sự kiện mới qua đường này.
- Nhồi cả kho tài liệu vào prompt rồi tin mô hình đọc đủ.
- Gộp RAG và tinh chỉnh mà không đo lại, dù thử nghiệm của OpenAI cho thấy điểm có thể giảm.
- Dùng ví dụ huấn luyện khác đầu vào thật, như dữ liệu sạch trong khi khách gõ không dấu.
- Lên kế hoạch tinh chỉnh khi chưa kiểm tra nhà cung cấp và lịch ngừng mô hình gốc.
- Đưa dữ liệu khách hàng vào bộ huấn luyện hoặc kho tài liệu mà chưa hỏi pháp lý.
Điều chưa biết
Click Star chưa có số đo công khai so sánh 3 cách trên dữ liệu tiếng Việt. Hướng dẫn của OpenAI và Anthropic không ghi ngày trên trang; thử nghiệm tiếng Iceland dùng mô hình nay đã ngừng.
2 trang về Claude trên không ghi ngày, nên chưa rõ tình trạng này kéo dài đến bao giờ. Bài cũng chưa dùng bảng giá tinh chỉnh chính thức nào.
Bài liên quan



Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.