Quản lý ngữ cảnh hội thoại chatbot AI: cửa sổ ngữ cảnh, cắt bớt và tóm tắt
Mô hình AI không nhớ giữa các lượt nên ứng dụng phải gửi lại lịch sử. Bài dựa trên tài liệu của Anthropic và OpenAI để so sánh 5 cách giữ hội thoại trong giới hạn cửa sổ ngữ cảnh.
Chatbot AI trông như nhớ cả cuộc trò chuyện, nhưng ở mức API mô hình không giữ gì giữa các lượt: ứng dụng phải gửi lại lịch sử mỗi lần. Hội thoại càng dài, lịch sử càng chạm giới hạn cửa sổ ngữ cảnh, kéo theo chi phí tăng và chất lượng giảm.
Bài dựa trên tài liệu hiện hành của Anthropic và OpenAI, một bài kỹ thuật của Anthropic và một nghiên cứu về ngữ cảnh dài, đối chiếu đến ngày 23/10/2026.
Bài trả lời: ngữ cảnh gồm những gì, vì sao dài thì đắt và kém, các cách giữ trong giới hạn đánh đổi gì và nên đo ra sao. Click Star đã có bài riêng về tối ưu token và RAG nên không lặp bảng giá hay cách tính phí bộ nhớ đệm. Click Star có dịch vụ tích hợp AI nên có lợi ích liên quan.
Điểm chính
- Ở mức API, mô hình không nhớ giữa các lượt. Anthropic ghi Messages API không giữ trạng thái và bạn luôn gửi toàn bộ lịch sử; OpenAI ghi mỗi yêu cầu là độc lập.
- Cửa sổ ngữ cảnh chứa mọi thứ trong yêu cầu cộng phần mô hình sinh ra: prompt hệ thống, định nghĩa công cụ, tin nhắn, kết quả công cụ, ảnh, tài liệu và phần suy nghĩ.
- Dài hơn không đồng nghĩa tốt hơn: Anthropic mô tả "context rot", và nghiên cứu Lost in the Middle ghi nhận hiệu năng thường thấp nhất khi thông tin nằm giữa.
- Có 5 cách giữ hội thoại trong giới hạn: cắt bớt, xóa kết quả công cụ cũ, tóm tắt, bộ nhớ ngoài và truy xuất, mỗi cách đều đánh đổi.
- Khối tóm tắt của Anthropic là văn bản đọc được, còn mục nén của OpenAI được mã hóa và không dành cho người đọc.
- Bản tóm tắt và bộ nhớ thừa hưởng dữ liệu cá nhân trong lịch sử. Hãy đặt hạn lưu, phân quyền và đo bằng bộ câu hỏi giữ thông tin trước khi bật nén.
Cửa sổ ngữ cảnh là gì và vì sao mô hình không tự nhớ
Cửa sổ ngữ cảnh là toàn bộ văn bản mô hình tham chiếu khi tạo một phản hồi, kể cả chính phản hồi đó. Theo tài liệu "Context windows" của Anthropic (không ghi ngày, đọc 23/10/2026), đây là "bộ nhớ làm việc", khác với kho dữ liệu huấn luyện.
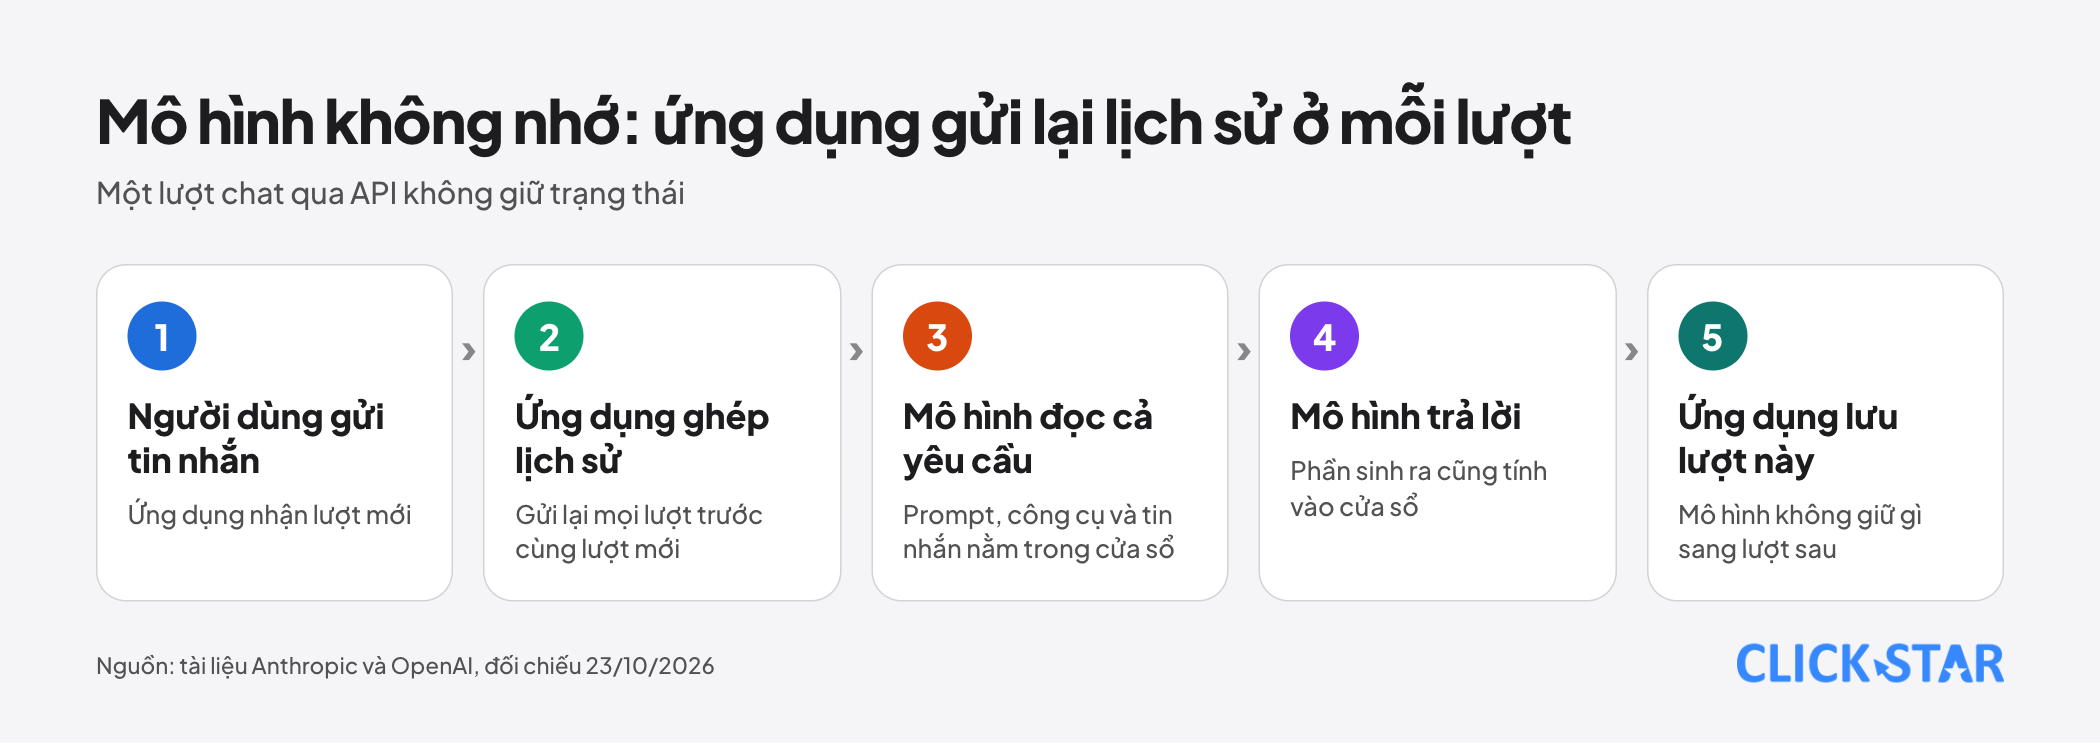
Tài liệu "Using the Messages API" của Anthropic (đọc 23/10/2026) viết rằng API không giữ trạng thái nên bạn luôn gửi toàn bộ lịch sử. Hướng dẫn "Conversation state" của OpenAI (đọc 23/10/2026) viết tương tự: mỗi yêu cầu độc lập, nhiều lượt được tạo bằng cách đưa thêm tin nhắn.
OpenAI có thêm 2 cách để nhà cung cấp lưu hộ: đối tượng Conversations và tham số previous_response_id. Tài liệu nói rõ: dù dùng previous_response_id, mọi token đầu vào trước đó trong chuỗi vẫn bị tính như token đầu vào.
Cái gì chiếm chỗ trong cửa sổ
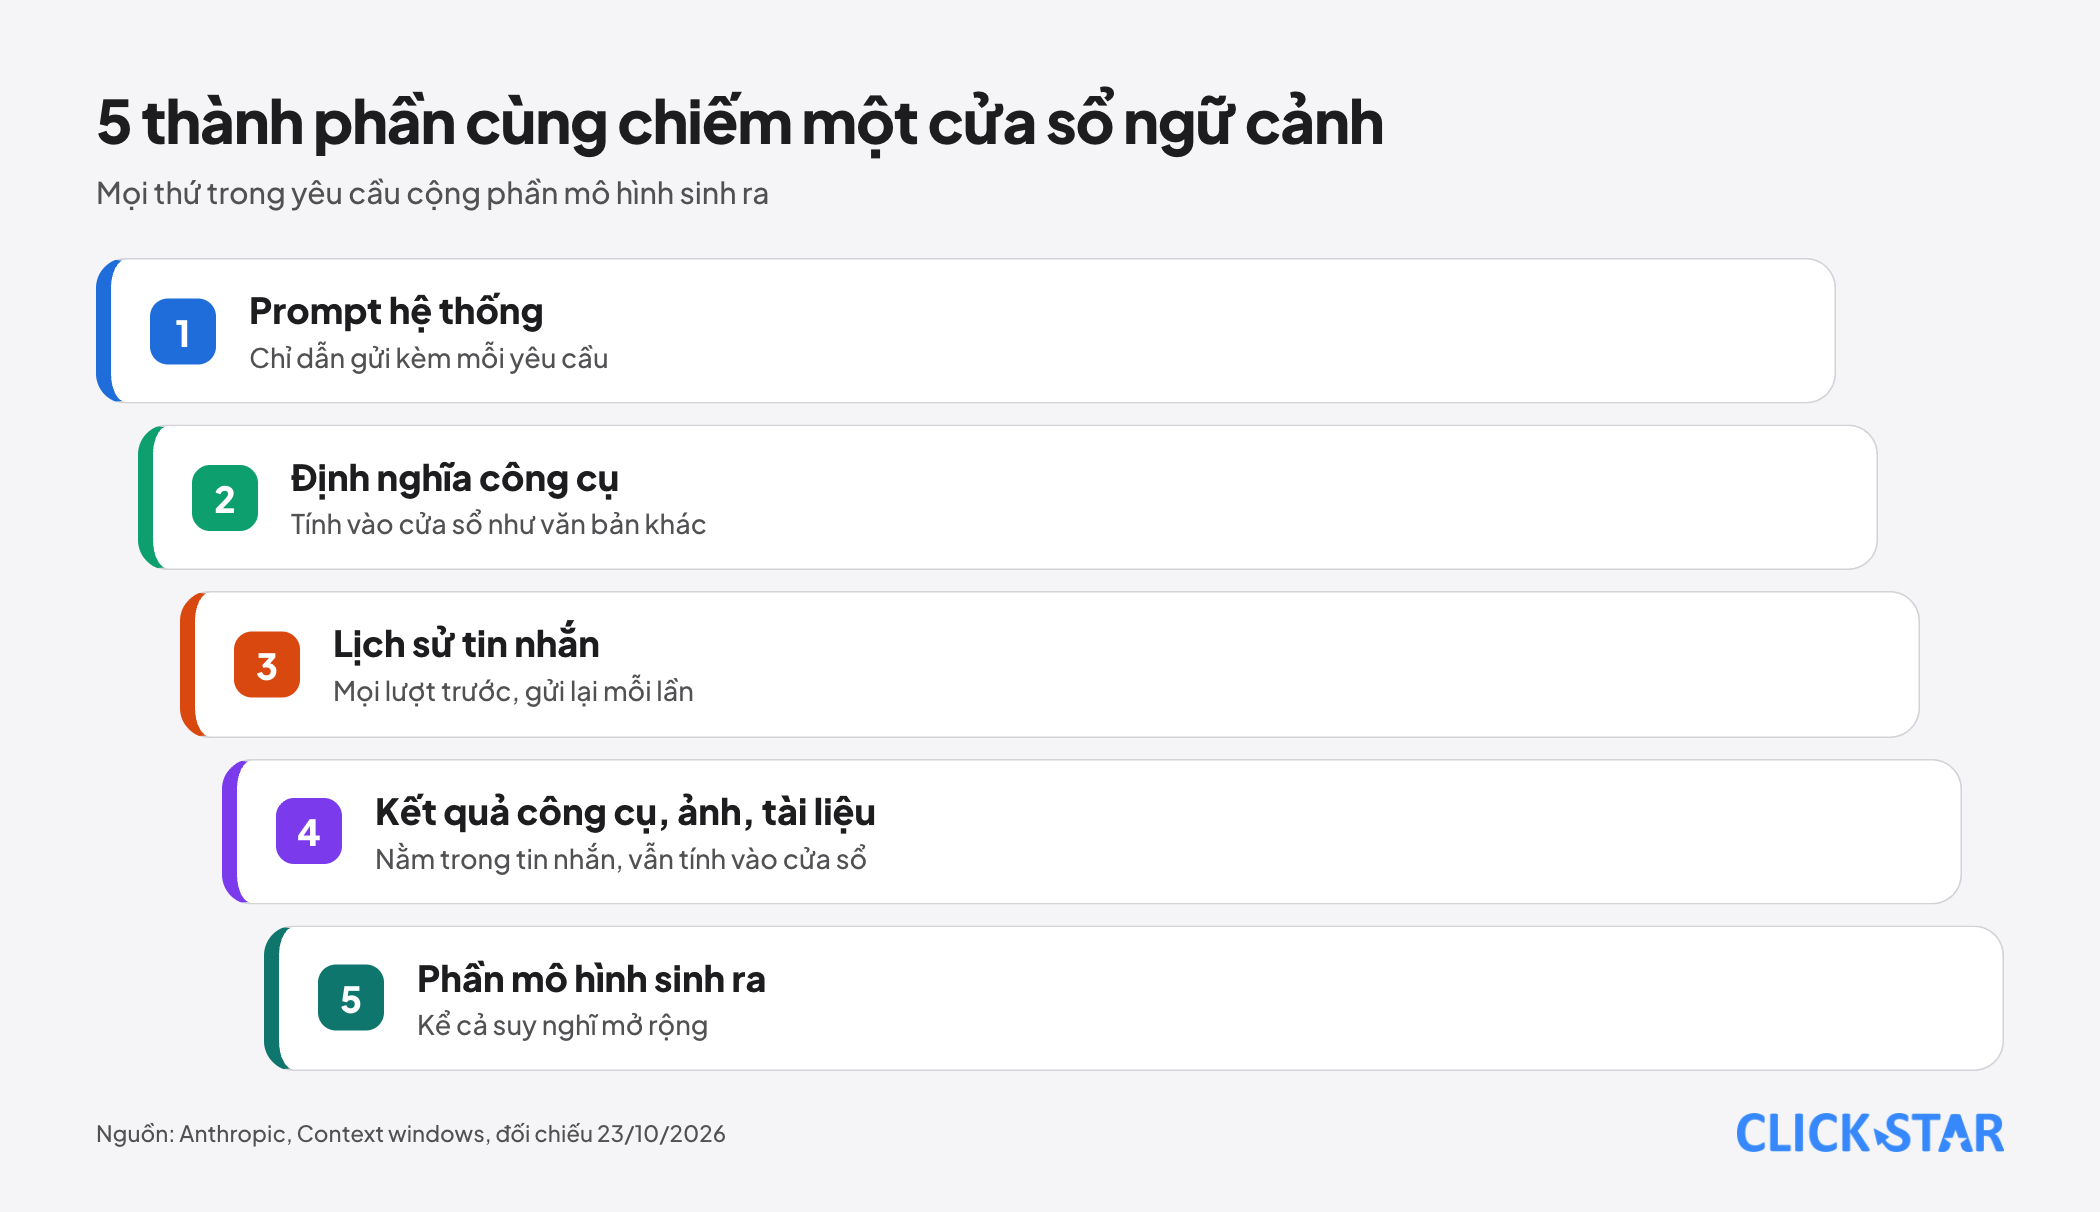
Theo Anthropic, mọi thứ trong yêu cầu đều tính vào cửa sổ: prompt hệ thống, từng tin nhắn (kể cả kết quả công cụ, ảnh, tài liệu) và định nghĩa công cụ. Phần mô hình sinh ra, kể cả suy nghĩ mở rộng, cũng tính. Bộ nhớ đệm prompt chỉ đổi giá của các token ấy, không đổi việc chúng chiếm chỗ.
Theo tài liệu đếm token của Anthropic, từ Claude Opus 4.7 trở đi bộ tách token mới cho ra nhiều hơn khoảng 30% token với cùng văn bản, nên phải đếm lại theo đúng mô hình.
Khi tràn, hành vi khác nhau. Theo Anthropic, nếu riêng đầu vào đã vượt cửa sổ thì API trả lỗi 400. Với Claude 4.5 trở lên, nếu đầu vào cộng max_tokens vượt cửa sổ thì yêu cầu vẫn được nhận và dừng với stop_reason model_context_window_exceeded.
Với OpenAI, trang tham chiếu Responses API ghi tham số truncation (đánh dấu deprecated) mặc định là disabled, yêu cầu quá cỡ trả lỗi 400; đặt auto thì mô hình bỏ các mục từ đầu hội thoại.
Hội thoại dài thì tốn và kém đi thế nào
Chi phí tăng nhanh hơn số lượt vì mỗi lượt gửi lại toàn bộ lịch sử. Ví dụ số học minh họa, không phải số đo: giả sử lịch sử dài thêm 500 token sau mỗi lượt, mỗi yêu cầu gửi toàn bộ lịch sử đến lượt đó và bỏ qua prompt hệ thống lẫn bộ nhớ đệm, tổng đầu vào cộng dồn khoảng 27.500 token sau 10 lượt, 105.000 sau 20 lượt và 410.000 sau 40 lượt.
Bài kỹ thuật của Anthropic (đăng 29/9/2025) mô tả "context rot": khi số token tăng, khả năng nhớ lại chính xác giảm. Bài nói đây là dải suy giảm chứ không phải vách đá; lý do kể đến n² quan hệ cặp giữa n token và việc mô hình quen chuỗi ngắn hơn khi huấn luyện.
Nghiên cứu "Lost in the Middle" (arXiv, nộp 6/7/2023, bản sửa 20/11/2023) thử hỏi đáp nhiều tài liệu và truy xuất khóa-giá trị. Hiệu năng thường cao nhất khi thông tin ở đầu hoặc cuối và giảm đáng kể khi ở giữa. Giới hạn: mô hình năm 2023.
5 cách giữ hội thoại trong giới hạn
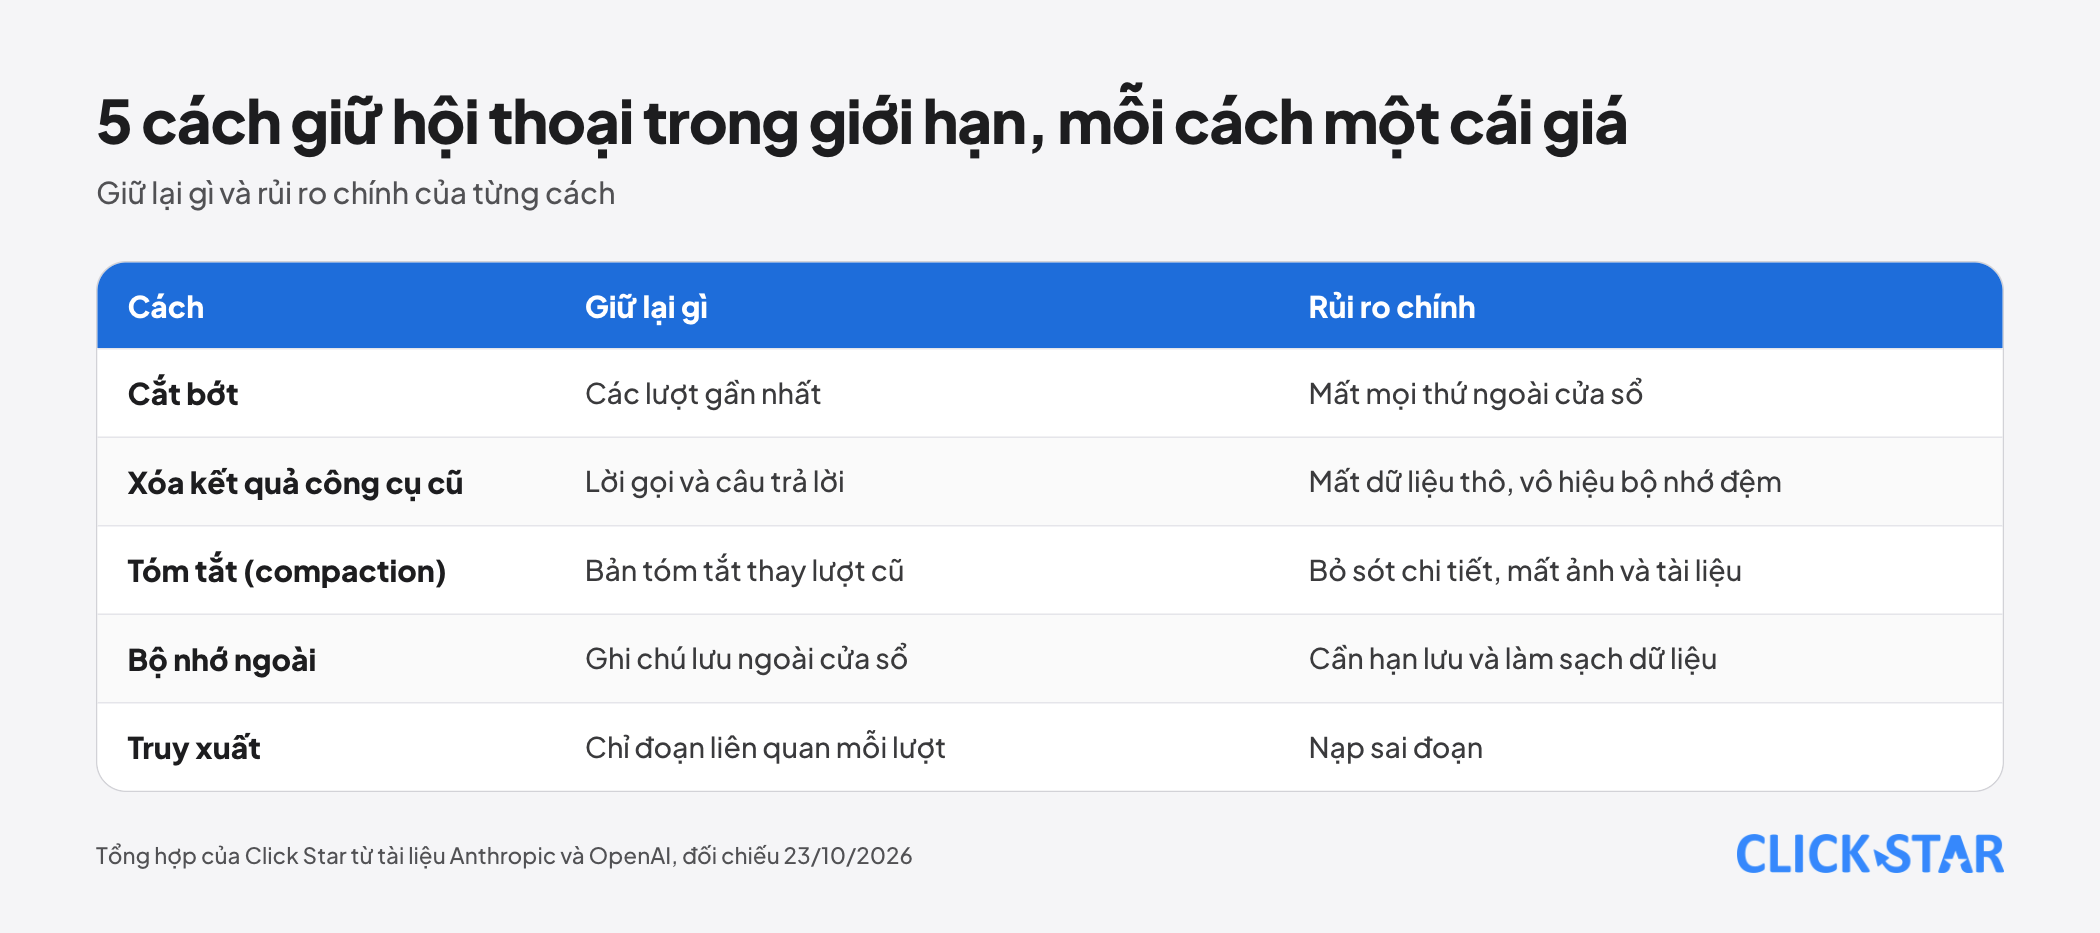
Về mô hình: nén phía máy chủ cần Claude 4.6 trở lên; xóa kết quả công cụ dùng được trên mọi mô hình được hỗ trợ.
Cắt bớt. Giữ vài lượt gần nhất, bỏ phần cũ. Đơn giản và không tốn lệnh gọi thêm, nhưng mọi thứ ngoài cửa sổ mất hẳn. Hãy ghim dữ kiện cần giữ.
Xóa kết quả công cụ cũ. Context editing của Anthropic xóa kết quả công cụ cũ nhất khi vượt ngưỡng (mặc định 100.000 token đầu vào, giữ 3 lần dùng công cụ gần nhất) và thay bằng văn bản giữ chỗ, ở phía máy chủ; ứng dụng vẫn giữ lịch sử đầy đủ. Tính năng ở bản beta. Xóa làm vô hiệu tiền tố đã lưu đệm nên có tham số clear_at_least.
Tóm tắt (compaction). Anthropic thay các lượt cũ bằng bản tóm tắt do Claude viết. Kiểu theo yêu cầu cho ứng dụng quyết định lúc tóm tắt; kiểu theo ngưỡng (trang "Compaction at a token threshold") để API tự làm khi đầu vào chạm mốc (mặc định 150.000 token, tối thiểu 50.000).
Cả hai ở bản beta. Kiểu theo yêu cầu có thể giữ nguyên văn vài lượt gần nhất, và lệnh tóm tắt của nó bị tính phí như yêu cầu thường.
Bộ nhớ ngoài. Công cụ bộ nhớ của Anthropic cho Claude đọc và ghi tệp trong thư mục /memories, còn ứng dụng thực thi trên kho do bạn kiểm soát. Bài kỹ thuật của Anthropic gọi đây là ghi chú có cấu trúc.
Truy xuất. Chỉ nạp đoạn liên quan mỗi lượt, nên rủi ro là nạp sai đoạn.
Anthropic và OpenAI khác nhau ở đâu
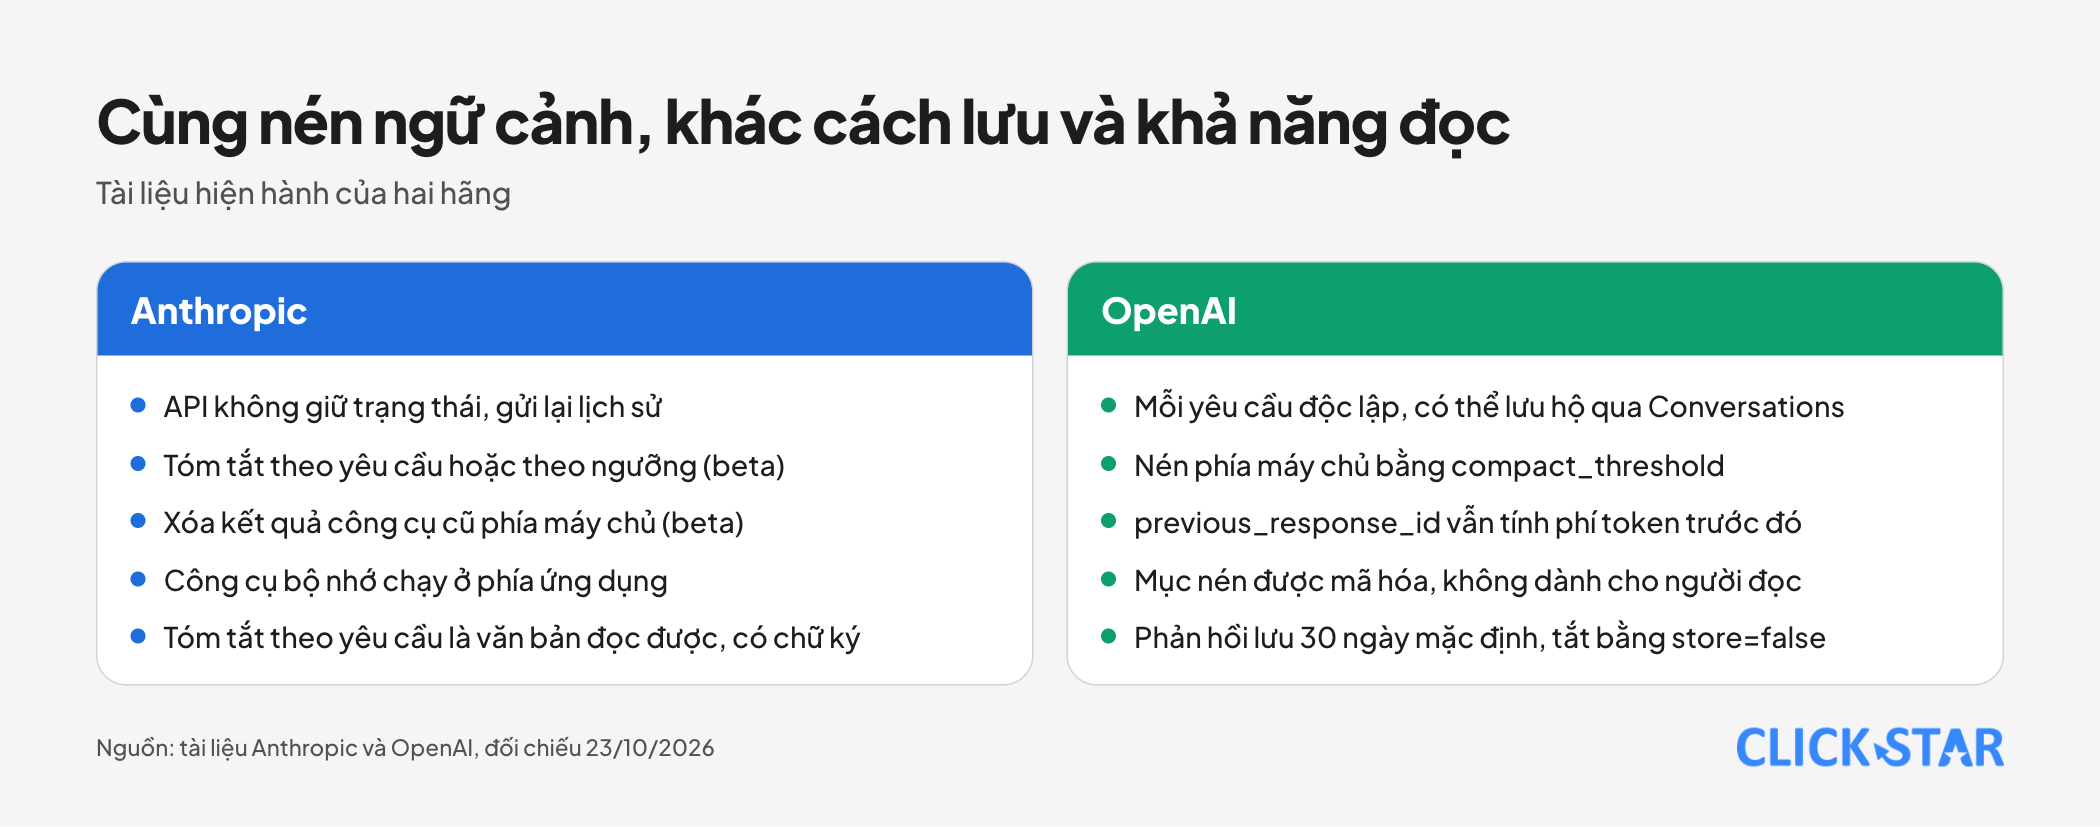
Tài liệu "Compaction" của OpenAI (đọc 23/10/2026) cho bật nén phía máy chủ bằng context_management với compact_threshold trong yêu cầu /responses. Khi số token vượt ngưỡng, máy chủ nén và phát mục nén trong cùng luồng.
Khác biệt lớn là khả năng đọc. Khối compaction theo yêu cầu của Anthropic chứa bản tóm tắt dạng văn bản đọc được, kèm chữ ký, và phải gửi lại nguyên vẹn. OpenAI mô tả mục nén là mã hóa và không dành cho người đọc. Suy luận của Click Star: với Anthropic có thể ghi nhật ký và rà soát tóm tắt, với OpenAI phải dùng biện pháp khác.
Nén có giá. Hướng dẫn Prompt caching của OpenAI viết nén có thể đổi tiền tố và làm lần gọi sau nén tái dùng ít bộ nhớ đệm hơn; Anthropic viết xóa kết quả công cụ làm vô hiệu tiền tố đã lưu đệm.
Rủi ro: mất thông tin và lộ dữ liệu cá nhân
Mất thông tin. Bài của Anthropic cảnh báo nén quá tay có thể làm mất ngữ cảnh tinh tế mà tầm quan trọng chỉ lộ ra sau. Theo tài liệu, ảnh, tài liệu và URL đã lấy trong phần bị tóm tắt sẽ biến mất, và chỉ dẫn vai system trong phạm vi đó hết hiệu lực nên phải nhắc lại.
Hỏng lặng. Anthropic nêu, với nén theo yêu cầu, 2 lỗi không báo lỗi: còn tin nhắn đã tóm tắt sau khối thì chúng bị gửi lại; bỏ khối ở yêu cầu sau thì mô hình không có tóm tắt. Chatbot sẽ "quên" mà nhật ký không có lỗi, nên cần kiểm thử hành vi.
Dữ liệu cá nhân. Lịch sử chat có thể chứa tên, số điện thoại, địa chỉ, nên bản tóm tắt và bộ nhớ thừa hưởng. OWASP xếp lộ thông tin nhạy cảm vào LLM02:2025, khuyến nghị làm sạch dữ liệu và cấp quyền tối thiểu.
Với bộ nhớ, Anthropic viết Claude thường từ chối ghi thông tin nhạy cảm, nhưng nên thêm bước kiểm tra trước khi ghi, giới hạn dung lượng và xóa tệp lâu không dùng.
OpenAI ghi phản hồi được lưu 30 ngày theo mặc định (tắt bằng store là false), còn mục trong Conversations không bị giới hạn 30 ngày đó. Bài không phân tích nghĩa vụ pháp lý về dữ liệu cá nhân.
Ý nghĩa với doanh nghiệp Việt Nam
Click Star không tìm thấy số đo cho Việt Nam về độ dài hội thoại điển hình, tỷ lệ chạm giới hạn hay chất lượng tóm tắt tiếng Việt. Số token tiếng Việt cũng chưa có nguồn, nên hãy đếm trên văn bản thật.
Khung tham khảo của Click Star, không lấy từ nguồn ngoài. Bot hỗ trợ ngắn trên website thường không cần nén: chỉ ghim prompt và đặt trần số lượt.
Cũng thuộc khung này: bot tư vấn nhiều ngày nên lưu nhu cầu, cam kết và trạng thái của khách ở CRM thay vì nhồi lịch sử.
Agent gọi công cụ nhiều lần dễ dồn kết quả; bài kỹ thuật của Anthropic gọi việc xóa kết quả công cụ cũ là một trong những dạng nén nhẹ và an toàn nhất. Suy luận của Click Star: nên thử cách này trước khi tóm tắt.
Đánh giá của Click Star. Nên coi ngữ cảnh là ngân sách chứ không phải kho chứa. Dữ kiện không được quên (tên, nhu cầu, điều đã hứa, trạng thái xử lý) nên nằm ở dữ liệu có cấu trúc do doanh nghiệp quản lý, vì bản tóm tắt luôn có thể bỏ sót.
Khung 3 lớp để cân nhắc (khung tham khảo của Click Star): lượt gần nhất giữ nguyên văn, lịch sử cũ tóm tắt cuộn, hồ sơ sự kiện có cấu trúc lưu ngoài. Click Star làm dịch vụ tích hợp AI, CRM và CDP nên có lợi ích liên quan; nhận định này chỉ về kỹ thuật và quản trị.
Cách đo
Danh sách dưới là khung tham khảo của Click Star.
- Token đầu vào theo số lượt, đọc từ trường usage; nhìn phân vị cao chứ không chỉ trung bình.
- Tỷ lệ hội thoại chạm ngưỡng nén hoặc gặp lỗi tràn, và chi phí đầu vào cộng dồn mỗi hội thoại.
- Bộ hội thoại dài có câu hỏi kiểm tra sự kiện ở đầu, giữa và cuối, chấm trước và sau khi nén.
- Tỷ lệ bản tóm tắt chứa dữ liệu cá nhân hoặc sự kiện sai, đọc theo mẫu.
Việc nên làm: lộ trình 14 ngày
Khung tham khảo của Click Star, không lấy từ nguồn ngoài.
- Ngày 1 đến 2: ghi token đầu vào mỗi lượt, xem bao nhiêu hội thoại thực sự dài.
- Ngày 3 đến 4: liệt kê dữ kiện không được quên, chuyển sang dữ liệu có cấu trúc; kiểm tra dữ liệu cá nhân trong lịch sử.
- Ngày 5 đến 7: dựng bộ hội thoại dài kèm câu hỏi giữ thông tin; chấm khi chưa nén.
- Ngày 8 đến 10: thử cách đơn giản nhất đủ dùng (cắt có ghim hoặc xóa kết quả công cụ cũ) rồi chấm lại.
- Ngày 11 đến 14: nếu còn thiếu mới thử tóm tắt, đọc mẫu bản tóm tắt, đặt hạn lưu và phân quyền, rồi kiểm tra tài liệu mới nhất trước khi bật thật.
Những sai lầm thường gặp
- Tin rằng mô hình tự nhớ, trong khi ứng dụng mới là bên giữ và gửi lại lịch sử.
- Nhồi toàn bộ lịch sử vì cửa sổ lớn, bỏ qua chi phí cộng dồn và suy giảm chất lượng.
- Bật tóm tắt tự động mà không có bộ câu hỏi kiểm tra giữ thông tin.
- Để dữ kiện quan trọng chỉ nằm trong bản tóm tắt.
- Với nén theo yêu cầu, quên gửi lại khối tóm tắt hoặc để sót tin nhắn đã tóm tắt, rồi chatbot quên mà không có lỗi nào.
- Lưu lịch sử, tóm tắt và bộ nhớ không có hạn lưu, phân quyền hay bước làm sạch dữ liệu cá nhân, và đổi mô hình mà không đếm lại token.
Điều chưa biết
Click Star chưa có số đo cho Việt Nam về độ dài hội thoại, số token tiếng Việt hay chất lượng tóm tắt tiếng Việt, và chưa đọc kết quả kiểu Lost in the Middle trên mô hình hiện hành. Bài chưa đọc tài liệu của Google.
Tính năng nén của Anthropic ở bản beta nên tham số có thể đổi. Các chỗ ghi "suy luận của Click Star" chưa được kiểm thử. Nghĩa vụ pháp lý khi lưu lịch sử chat chưa được phân tích.
Bài liên quan



Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.