RAG là gì: cho AI trả lời từ tài liệu của doanh nghiệp, chi phí và những sai lầm thường gặp
RAG cho AI tra cứu tài liệu của doanh nghiệp trước khi trả lời. Bài giải thích 6 bước, so với tinh chỉnh và ngữ cảnh dài, 5 nguyên nhân sai, công thức chi phí, phân quyền và cách đánh giá, dựa trên tài liệu của OpenAI, Anthropic, Microsoft và OWASP.
Nhiều doanh nghiệp muốn một trợ lý AI trả lời đúng theo quy chế, bảng giá và tài liệu nội bộ. Mô hình phổ thông chưa đọc những tài liệu này, còn dán cả kho vào mỗi câu hỏi thì tốn kém hoặc không vừa.
Bài giải thích RAG (Retrieval-Augmented Generation, tạm dịch: sinh câu trả lời có truy xuất). Nguồn chính là bài gốc của Lewis và cộng sự (2020), tài liệu của OpenAI, Anthropic, Microsoft và khung rủi ro của OWASP, đối chiếu đến ngày 21/10/2026.
Bài trả lời: RAG chạy qua những bước nào, khi nào chọn RAG thay vì tinh chỉnh hay ngữ cảnh dài, vì sao RAG sai, chi phí và cách đo ra sao.
Điểm chính
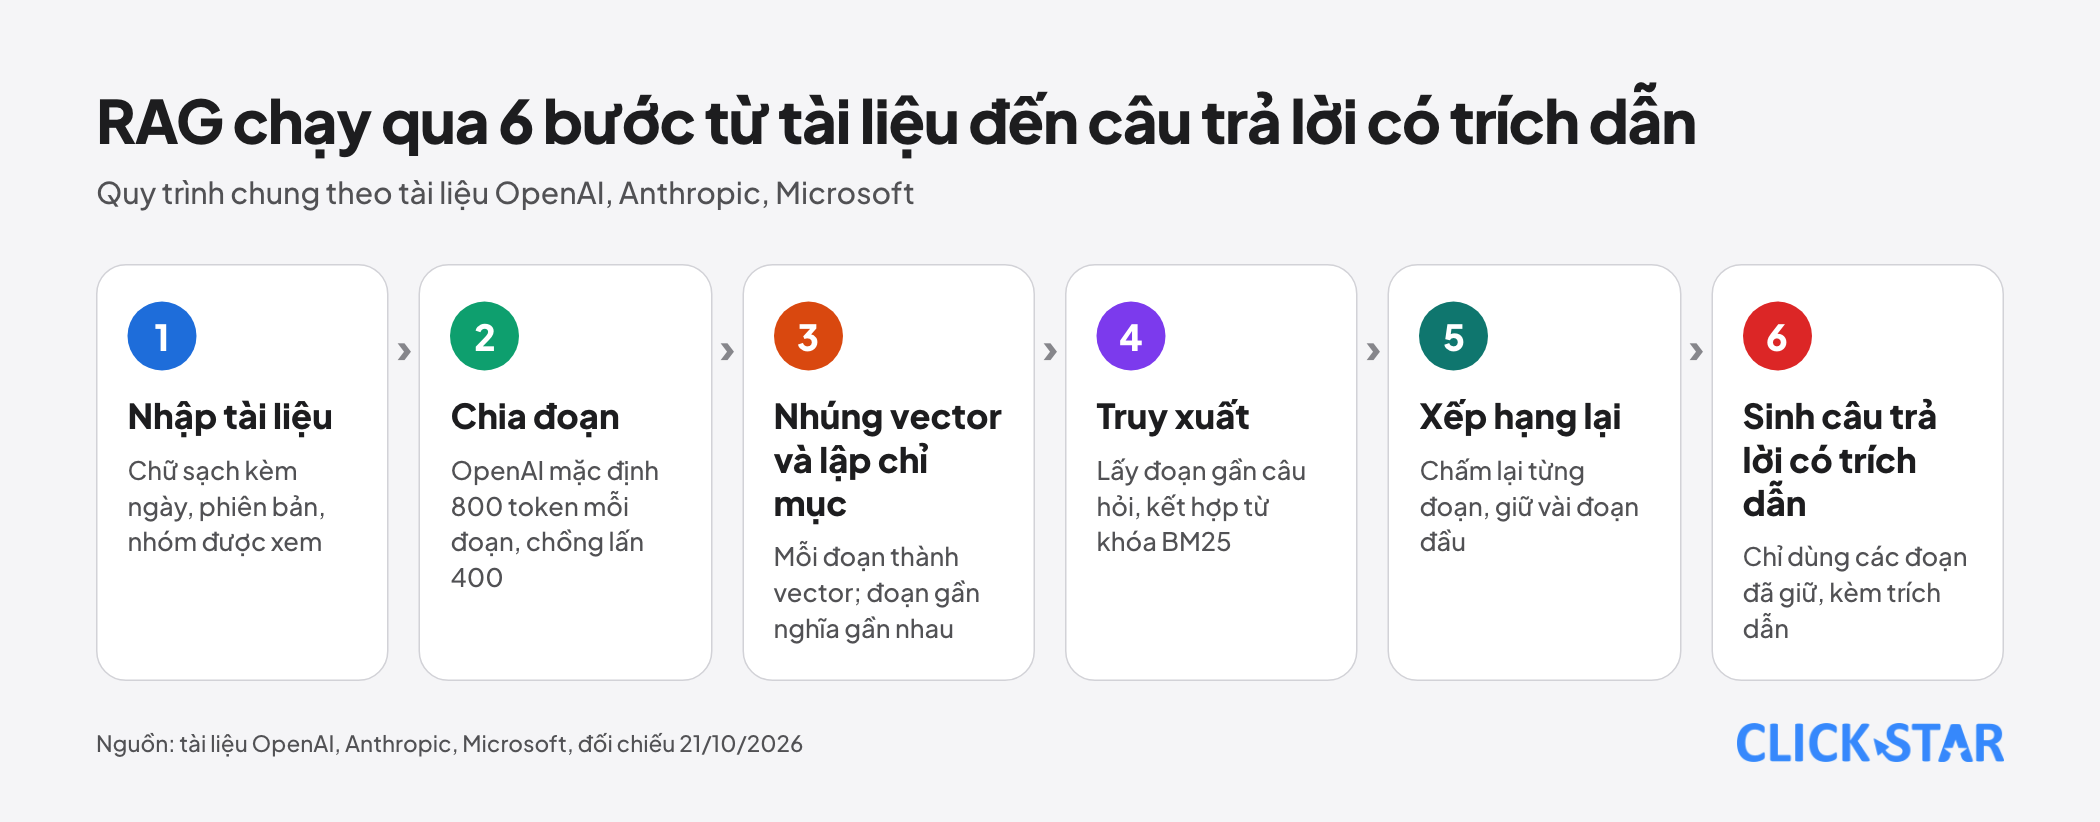
- RAG thêm 1 bước tra cứu trước khi mô hình trả lời, qua 6 bước từ nhập tài liệu đến sinh câu trả lời có trích dẫn. Chất lượng quyết định ở các bước đầu, không chỉ ở mô hình.
- Kho dưới 200.000 token (khoảng 500 trang) có thể đưa thẳng vào lời nhắc (Anthropic, 19/9/2024). RAG hợp khi kho lớn, đổi thường xuyên hoặc cần phân quyền; tinh chỉnh dùng để đổi hành vi (OpenAI).
- Trong thử nghiệm của Anthropic, thêm tìm theo từ khóa và xếp hạng lại giảm tỷ lệ hụt đoạn đúng từ 5,7% xuống 1,9%.
- Phân quyền phải áp ở bước truy xuất, không dựa vào lời dặn trong lời nhắc. OWASP xếp điểm yếu của kho vector thành rủi ro LLM08:2025.
- Hãy đánh giá bằng bộ câu hỏi mẫu (OpenAI gợi ý từ 20 câu): đo truy xuất, tính trung thực với nguồn và tỷ lệ "không biết".
RAG là gì và vì sao ra đời
RAG là kỹ thuật cho mô hình tra cứu tài liệu bên ngoài ngay lúc trả lời, thay vì chỉ dựa vào điều đã học khi huấn luyện. Bài gốc của Lewis và cộng sự đăng trên arXiv ngày 22/5/2020 và được nhận tại NeurIPS 2020.
Bài gốc ghép bộ nhớ trong tham số (mô hình seq2seq) với bộ nhớ ngoài (chỉ mục vector của Wikipedia mà một bộ truy xuất tìm kiếm). Động cơ: mô hình khó truy cập chính xác kiến thức trong tham số, khó chỉ ra nguồn và khó cập nhật. Kết quả đó đo trên Wikipedia năm 2020, không phải tài liệu doanh nghiệp Việt Nam.
RAG chạy qua những bước nào
Bước 1, nhập tài liệu. Đọc PDF, Word, trang web thành văn bản sạch kèm ngày, phiên bản và nhóm được xem. Theo tài liệu của Anthropic, PDF quét không có chữ trích xuất được thì không trích dẫn được, nên cần OCR.
Bước 2, chia đoạn. Tài liệu dài được cắt thành đoạn nhỏ để tìm riêng. OpenAI mặc định 800 token mỗi đoạn, chồng lấn 400; Microsoft khuyên bắt đầu từ 512 token, chồng lấn 25%. Con số khác nhau, nên cần đo.
Bước 3, nhúng vector và lập chỉ mục. Mô hình nhúng (embedding) đổi mỗi đoạn thành dãy số mã hóa ý nghĩa; đoạn gần nghĩa cho vector gần nhau. Anthropic không có mô hình nhúng riêng và giới thiệu Voyage AI; OpenAI và Google có.
Bước 4, truy xuất. Câu hỏi cũng được nhúng để lấy các đoạn gần nhất. Anthropic nhắc tìm theo từ khóa BM25 hữu ích cho mã định danh và thuật ngữ; OpenAI cho trộn điểm ngữ nghĩa và từ khóa.
Bước 5, xếp hạng lại. Một mô hình chấm lại mức liên quan của từng đoạn đã lấy, rồi chỉ giữ vài đoạn đầu.
Bước 6, sinh câu trả lời có trích dẫn. Mô hình chỉ dùng các đoạn được giữ. Tính năng trích dẫn của Anthropic trả về đoạn hỗ trợ từng ý; phần trích không tính vào token đầu ra.
RAG, tinh chỉnh hay ngữ cảnh dài: chọn khi nào
Chọn RAG khi mô hình thiếu kiến thức, kiến thức đã cũ hoặc cần dữ liệu độc quyền. Theo hướng dẫn của OpenAI (đọc ngày 21/10/2026), RAG xử lý kiến thức thiếu, còn tinh chỉnh xử lý sự nhất quán về định dạng và giọng điệu; 2 hướng bổ sung nhau và nên bắt đầu từ thiết kế lời nhắc.
Ovadia và cộng sự (10/12/2023) thấy RAG vượt trội nhất quán so với tinh chỉnh không giám sát khi nạp kiến thức, kể cả kiến thức mới. Giới hạn: theo chủ đề và mô hình của nghiên cứu.
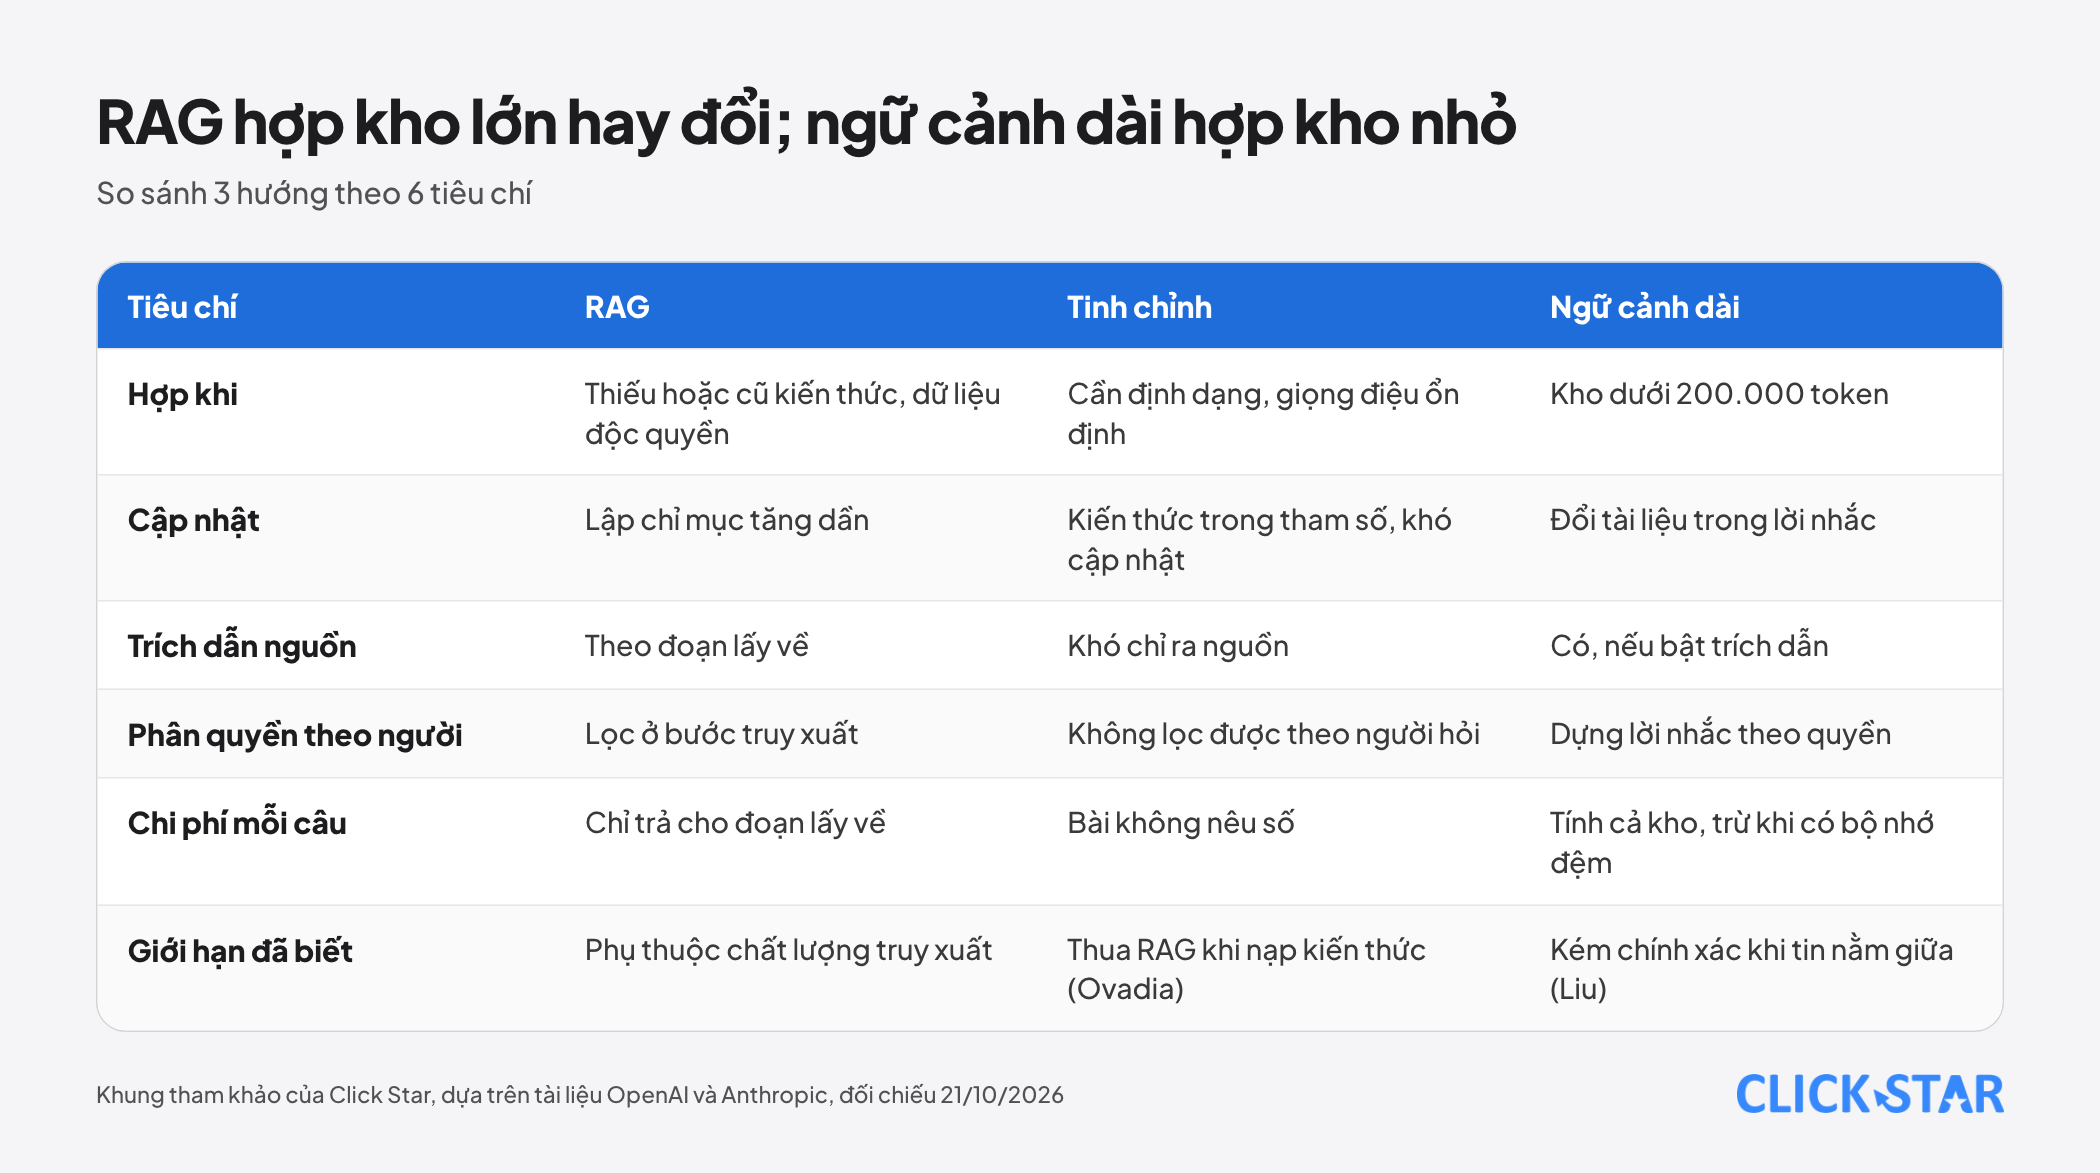
Với ngữ cảnh dài, Anthropic (19/9/2024) nói kho dưới 200.000 token (khoảng 500 trang) có thể đưa cả vào lời nhắc. Bảng giá của hãng (đọc ngày 21/10/2026) ghi các model từ 4.6 trở lên, trừ Haiku 5.5, có cửa sổ 1 triệu token ở giá chuẩn.
Chứa được chưa có nghĩa dùng tốt: Liu và cộng sự (6/7/2023) thấy độ chính xác giảm khi thông tin nằm giữa ngữ cảnh. Click Star chưa có phép đo tương đương cho model hiện nay.
5 nguyên nhân khiến RAG trả lời sai và cách chữa
Khi RAG sai, hãy xác định lỗi ở truy xuất hay ở khâu sinh trước khi đổi mô hình.
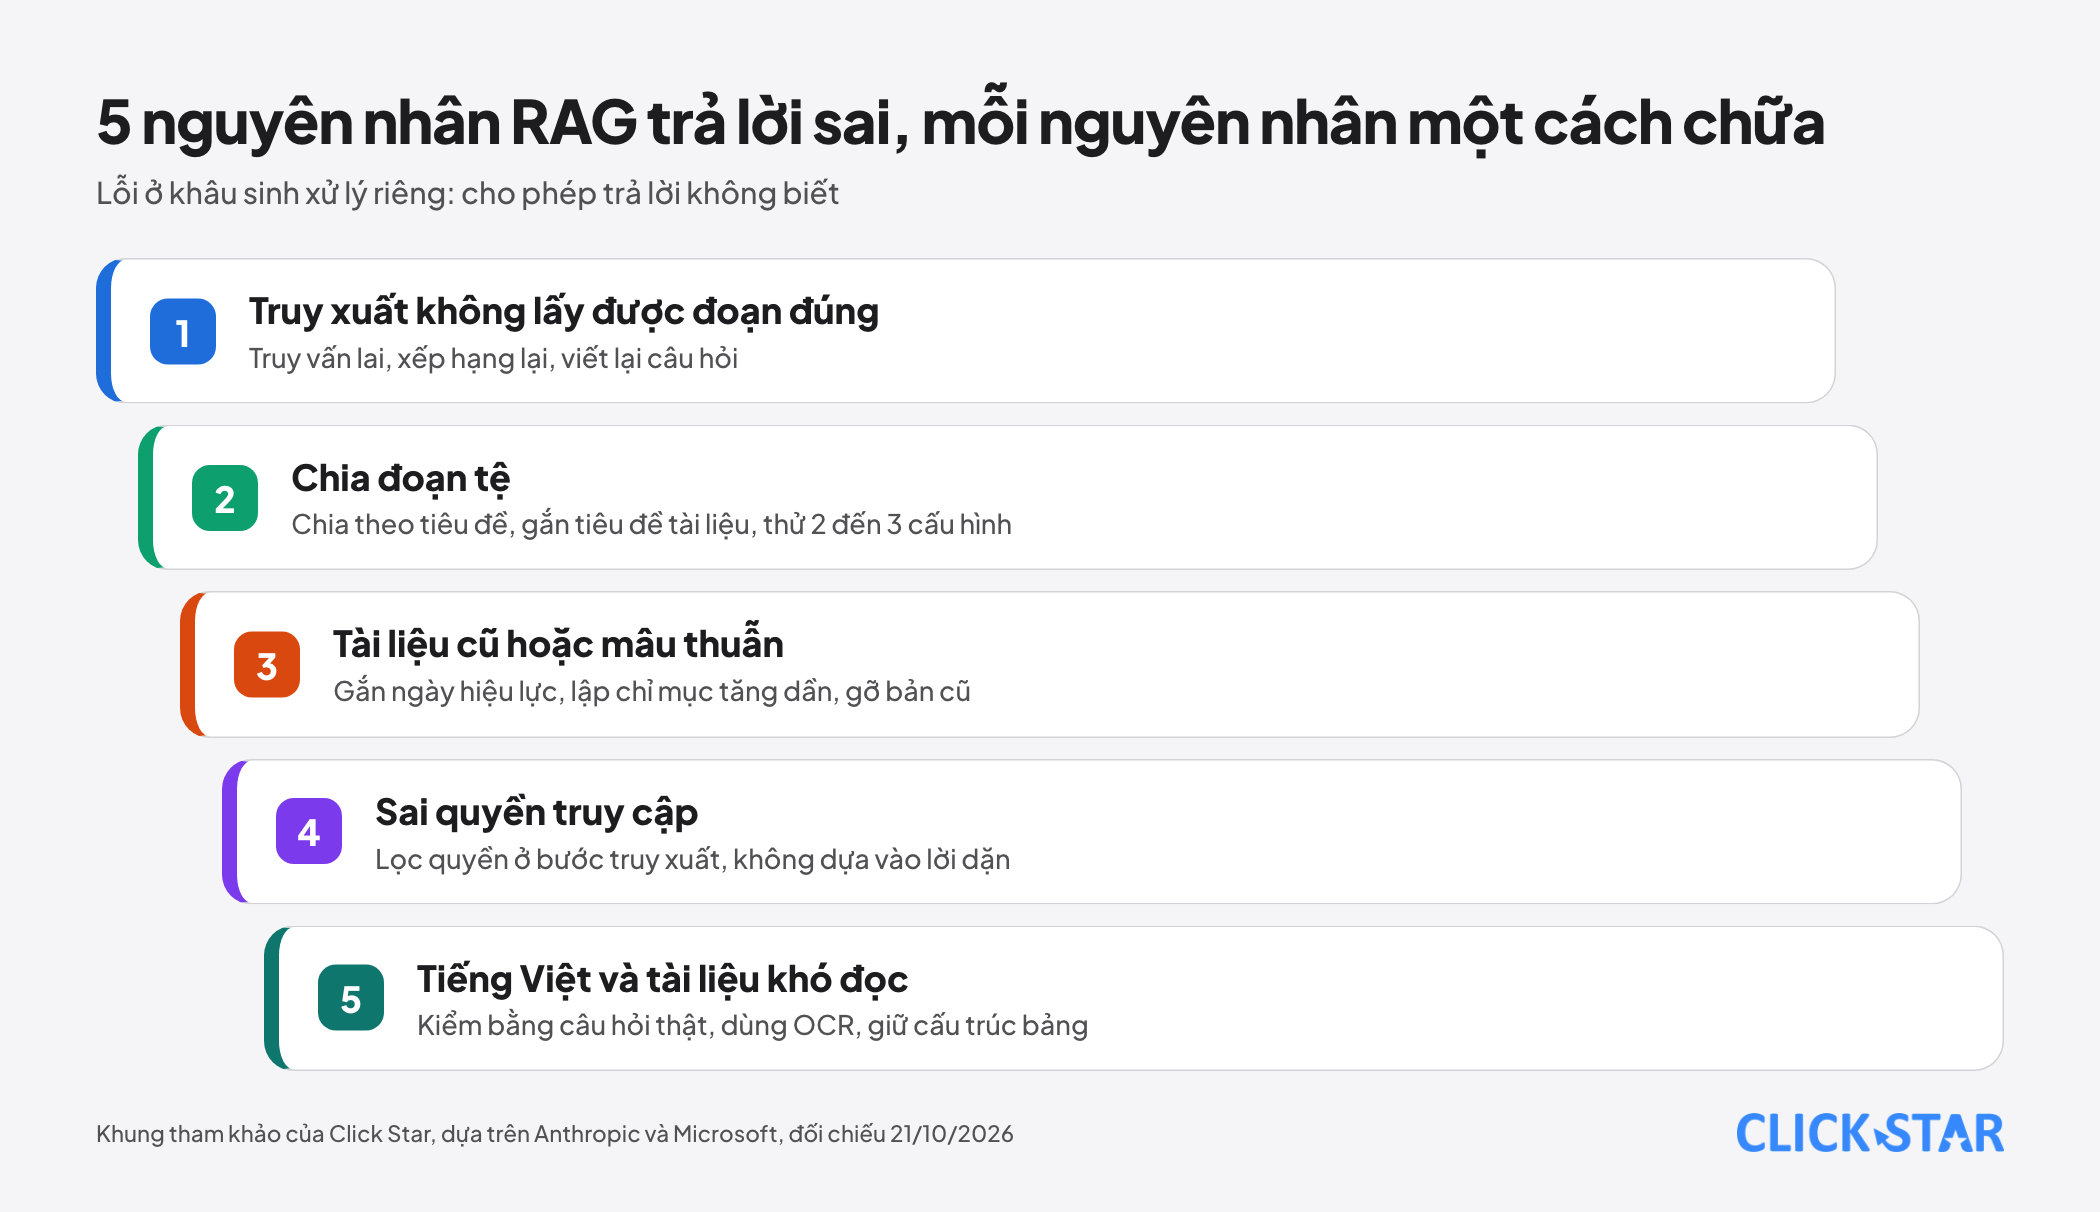
1. Truy xuất không lấy được đoạn đúng. Cách chữa: truy vấn lai, xếp hạng lại, viết lại câu hỏi.
Anthropic (19/9/2024) đo tỷ lệ không lấy được đoạn đúng trong 20 đoạn đầu: 5,7% ở cơ sở, 3,7% khi nhúng có ngữ cảnh, 2,9% khi thêm BM25, 1,9% khi có xếp hạng lại (giảm 67%). Hãng tự đo, không phải tiếng Việt.
2. Chia đoạn tệ. Đoạn cắt giữa bảng hay điều khoản mất nghĩa; đoạn quá to trộn nhiều chủ đề. Cách chữa: chia theo tiêu đề và mục, gắn tiêu đề tài liệu vào đoạn giữa văn bản (Microsoft nêu), thử 2 đến 3 cấu hình rồi đo.
3. Tài liệu cũ hoặc mâu thuẫn. RAG trả lời đúng theo tài liệu, kể cả khi tài liệu đã lỗi thời. Cách chữa: gắn ngày hiệu lực, lập chỉ mục tăng dần, gỡ bản bị thay thế, hiện ngày của nguồn trong trích dẫn.
4. Sai quyền truy cập. Đoạn nằm trong chỉ mục dù người hỏi không được xem. Cách chữa ở bước truy xuất (xem mục bảo mật).
5. Tiếng Việt và tài liệu khó đọc. Mô hình nhúng có thể kém hơn với tiếng Việt; bảng biểu và bản quét dễ hỏng khi trích xuất. Cách chữa: kiểm bằng câu hỏi tiếng Việt thật, dùng OCR, giữ cấu trúc bảng.
Còn lỗi ở khâu sinh: có đoạn đúng, mô hình vẫn có thể diễn giải sai. Anthropic khuyên cho phép trả lời "không biết", trích nguyên văn trước với tài liệu dài và rút lại ý không có trích dẫn; các kỹ thuật này chỉ giảm, không loại bỏ hoàn toàn ảo giác.
RAG với tiếng Việt: điều đã biết và chưa biết
Click Star chưa tìm thấy số đo công khai về độ chính xác truy xuất trên tài liệu doanh nghiệp tiếng Việt. VN-MTEB (arXiv, 29/7/2025; Findings of EACL 2026) có 41 bộ dữ liệu và 18 mô hình nhúng, nhưng tạo bằng cách dịch mẫu của MTEB nên không phải tài liệu thật.
Cũng chưa có bảng chính thức về số token mỗi trang tiếng Việt, nên hãy đếm trên tài liệu thật. Gợi ý của Click Star (chưa có nguồn đo): thử câu hỏi có dấu và không dấu, mã nội bộ, từ viết tắt, và so 2 mô hình nhúng.
Chi phí của một hệ RAG: công thức và ví dụ minh họa
Công thức 1, nhúng tài liệu: token nguồn nhân hệ số chồng lấn, chia 1 triệu, nhân giá nhúng. Với mặc định của OpenAI (đoạn 800, chồng lấn 400), token nhúng khoảng gấp đôi token nguồn (phép tính của Click Star).
Công thức 2, mỗi câu hỏi: (token đoạn truy xuất + câu hỏi + chỉ dẫn) nhân giá đầu vào, cộng token trả lời nhân giá đầu ra, đều chia 1 triệu.
Giá công bố đọc ngày 21/10/2026, cho 1 triệu token: nhúng của OpenAI là 0,02 USD (text-embedding-3-small) và 0,13 USD (text-embedding-3-large).
Claude Sonnet 5.5 của Anthropic là 2 USD đầu vào, 10 USD đầu ra; đọc từ bộ nhớ đệm là 0,10 USD.
Ví dụ minh họa với giả định do Click Star đặt, không phải số đo: kho 10 triệu token; mỗi câu hỏi lấy 5 đoạn 800 token cộng 500 token câu hỏi và chỉ dẫn (4.500 đầu vào), trả lời 300 token.
- Nhúng khoảng 20 triệu token: 0,40 USD với bản small, 2,60 USD với bản large.
- Mỗi câu hỏi với Sonnet 5.5: 0,009 USD đầu vào cộng 0,003 USD đầu ra, tổng 0,012 USD; 1.000 câu là 12 USD.
- Ngữ cảnh dài, kho 150.000 token trong mỗi lời nhắc Sonnet 5.5: phần kho tốn 0,30 USD mỗi câu, tức 300 USD cho 1.000 câu. Với bộ nhớ đệm, mỗi lần đọc là 0,015 USD.
Ví dụ chưa gồm phí ghi bộ nhớ đệm, lưu trữ vector, xếp hạng lại và nhân công; hãy dùng số đo thật.
Bảo mật và phân quyền theo người dùng
Phân quyền phải thực thi ở bước truy xuất, trước khi mô hình thấy đoạn nào. Nếu đoạn của phòng khác đã vào lời nhắc, lời dặn "đừng tiết lộ" không đủ tin cậy.
OWASP (LLM08:2025) nêu các rủi ro: truy cập sai quyền gây rò rỉ, rò rỉ chéo giữa các nhóm trong kho dùng chung, đảo ngược embedding để khôi phục thông tin nguồn và đầu độc dữ liệu.
Microsoft mô tả mẫu lọc bảo mật: mỗi tài liệu có trường danh tính được xem, và mọi truy vấn kèm bộ lọc theo người hỏi.
Việc cần làm: lưu quyền cùng từng đoạn, lọc theo danh tính thật của người đăng nhập, thử bằng tài khoản khác quyền. Click Star đã có bài riêng về bảo vệ dữ liệu khách hàng khi phân tích bằng AI; bài này không phân tích pháp lý.
Cách đánh giá một hệ RAG
OpenAI khuyên bắt đầu bằng bộ câu hỏi và đáp án chuẩn từ 20 câu trở lên, rồi xem các câu sai để đặt giả thuyết. Ragas (Es và cộng sự, 26/9/2023) đánh giá RAG theo 3 mặt: mức liên quan của đoạn lấy về, tính trung thực với đoạn đó và chất lượng câu trả lời.
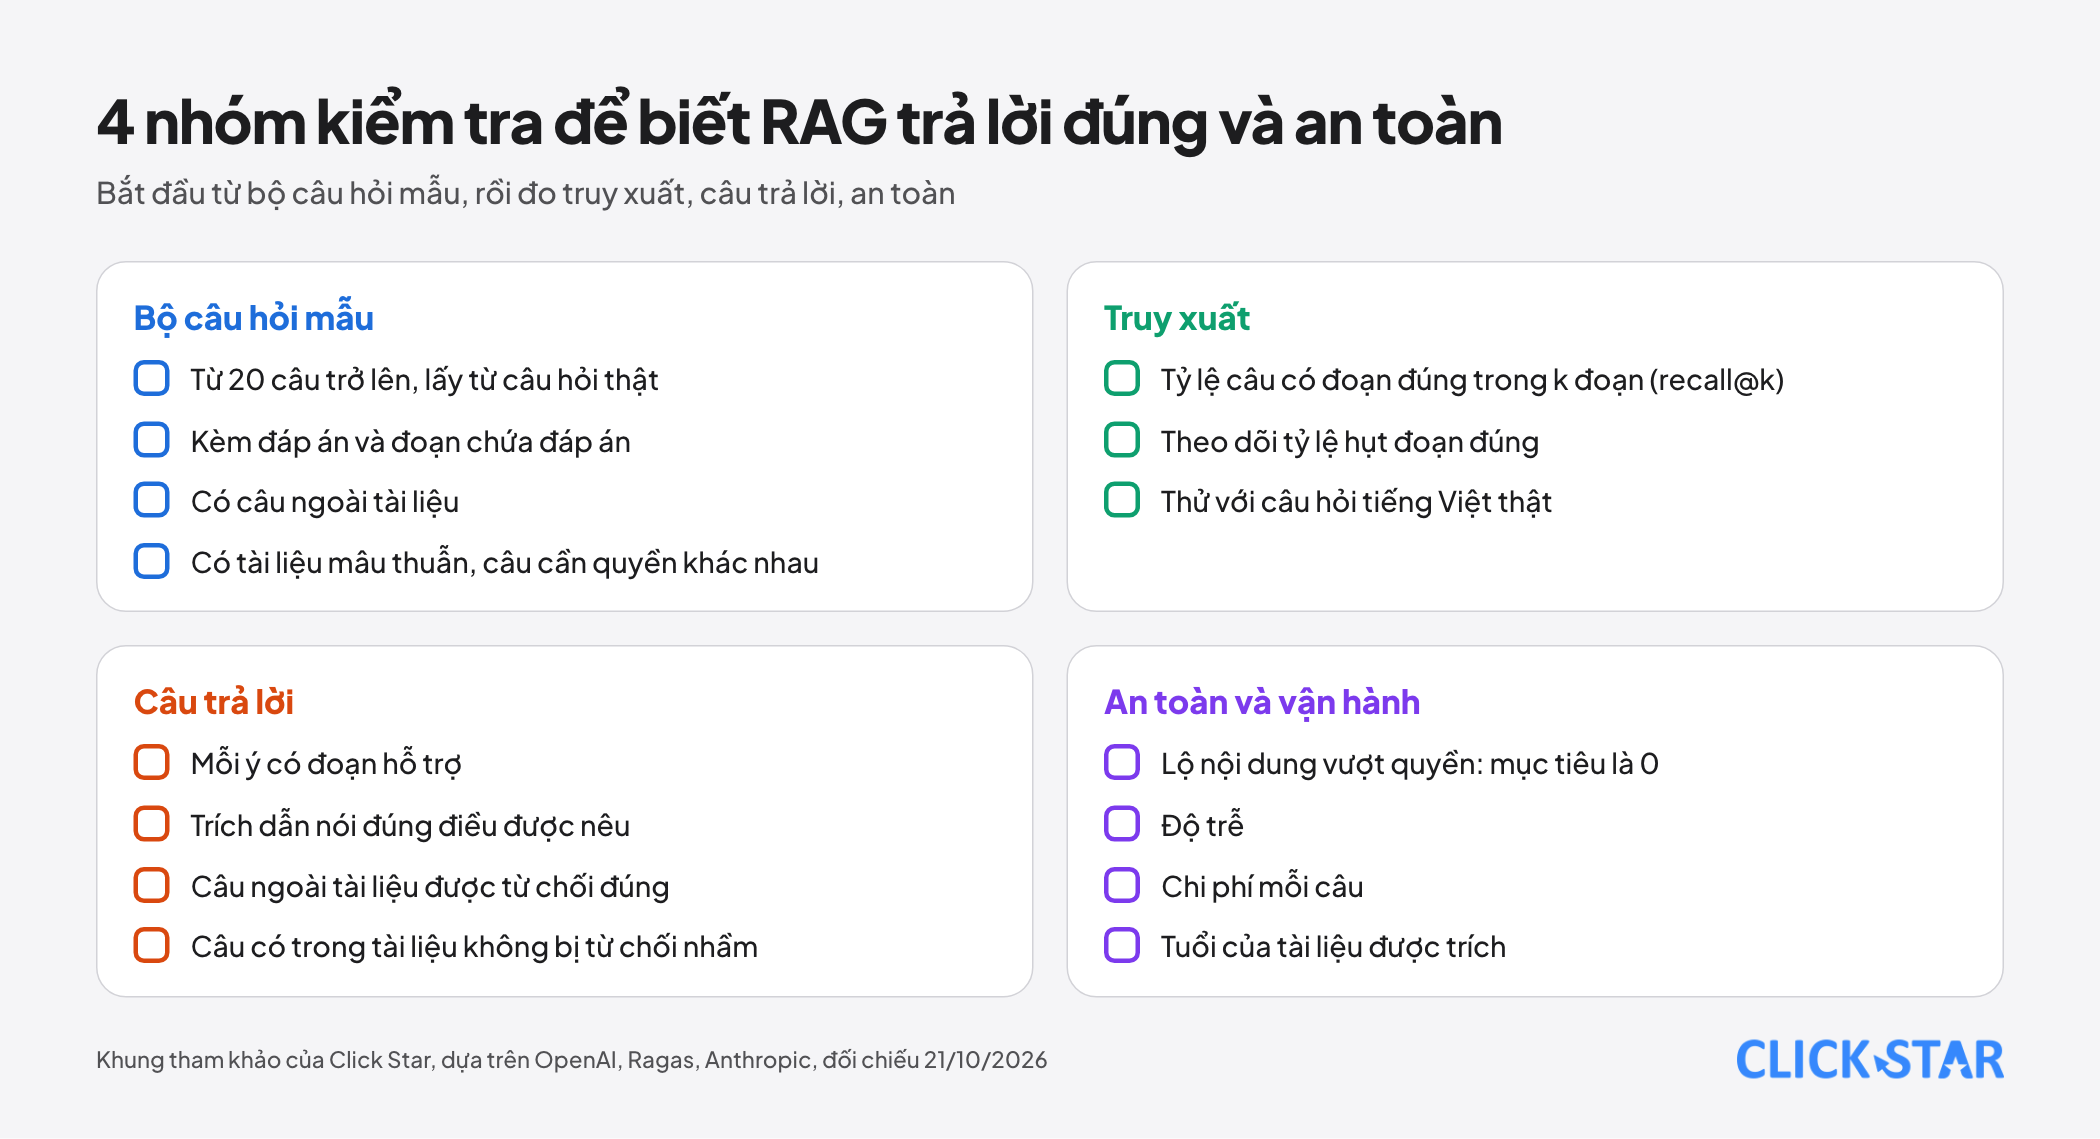
Bộ câu hỏi mẫu. Lấy từ câu hỏi thật, kèm đáp án và đoạn chứa đáp án; gồm cả câu có đáp án trong 1 đoạn, nhiều đoạn, không có trong tài liệu, tài liệu mâu thuẫn và câu cần quyền khác nhau.
Độ chính xác truy xuất. Tỷ lệ câu có đoạn đúng nằm trong k đoạn lấy về (recall@k).
Tính trung thực với nguồn. Mỗi ý có đoạn hỗ trợ không, và phần trích dẫn có nói đúng điều đó không. Người duyệt đọc mẫu, hoặc mô hình chấm rồi người kiểm.
Tỷ lệ "không biết". Đo 2 chiều: câu ngoài tài liệu có bị từ chối đúng không, câu có trong tài liệu có bị từ chối nhầm không.
An toàn và vận hành. Số lần lộ nội dung vượt quyền (mục tiêu là 0), độ trễ, chi phí mỗi câu và tuổi tài liệu được trích. Chưa có ngưỡng chuẩn có nguồn; doanh nghiệp tự đặt theo rủi ro.
Đánh giá của Click Star. RAG là bài toán tìm kiếm trước, bài toán mô hình sau. Phần lớn công sức nên dồn vào chất lượng tài liệu, chia đoạn, truy xuất, phân quyền và bộ câu hỏi đo, vì đó là phần doanh nghiệp tự kiểm soát được.
Với doanh nghiệp vừa và nhỏ, hướng thận trọng là bắt đầu hẹp: 1 nhóm tài liệu, 1 nhóm người hỏi, 20 đến 50 câu hỏi thật và có người duyệt đầu ra.
Click Star cung cấp dịch vụ tích hợp AI và AI automation nên có lợi ích liên quan; bài vì vậy nghiêng về tiêu chí tự kiểm, kể cả khi kết luận là chỉ cần đưa tài liệu vào lời nhắc. Click Star đã có bài riêng về chatbot AI trên website và cơ sở dữ liệu vận hành.
Việc nên làm: lộ trình 30 ngày
- Ngày 1 đến 7: chọn 1 nhóm tài liệu; ghi chủ sở hữu, ngày hiệu lực, quyền xem; viết 20 đến 50 câu hỏi thật, có câu ngoài tài liệu.
- Ngày 8 đến 14: dựng bản thử đơn giản; đếm token trên tài liệu thật; nếu dưới 200.000 token, thử cả phương án chỉ dùng lời nhắc.
- Ngày 15 đến 21: thử 2 cấu hình chia đoạn và 2 mô hình nhúng; thêm tìm từ khóa và xếp hạng lại; đo recall@k và tính trung thực.
- Ngày 22 đến 30: thêm lọc quyền và câu trả lời "không biết"; tính chi phí mỗi câu bằng số đo thật; cho nhóm nhỏ dùng thử rồi quyết định bước tiếp.
Những sai lầm thường gặp
- Đánh giá bằng vài câu thử tay thay vì bộ câu hỏi có đáp án, chạy lại sau mỗi thay đổi.
- Đổi sang mô hình lớn hơn khi lỗi nằm ở truy xuất hoặc chia đoạn.
- Nạp bản cũ, bản nháp và bản trùng vào chỉ mục mà không có ngày hiệu lực.
- Dựa vào lời dặn trong lời nhắc để giữ bí mật thay vì lọc quyền ở truy xuất.
- Bắt mô hình luôn phải trả lời, không có đường lui "không biết".
- Tin số liệu đo trên tiếng Anh mà không thử trên tiếng Việt.
- Tính chi phí chỉ bằng giá mô hình, bỏ qua nhúng lại, lưu trữ và nhân công.
Điều chưa biết
Chưa có số đo công khai về truy xuất tiếng Việt trên tài liệu doanh nghiệp, cũng như về tỷ lệ doanh nghiệp Việt Nam đã triển khai RAG. Số đo truy xuất của Anthropic do chính hãng thực hiện.
Click Star đọc trang của Anthropic, OpenAI và Microsoft qua công cụ tóm tắt, nên cần đối chiếu trên trang gốc. Click Star chưa đọc bảng giá Voyage AI. Nghĩa vụ pháp lý khi lưu dữ liệu cá nhân trong kho vector chưa được phân tích ở đây.
Bài liên quan



Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.