robots.txt, sitemap.xml và noindex: điều khiển Google đọc website
Mỗi công cụ trả lời câu hỏi riêng: thu thập, lập chỉ mục hay khám phá URL. Bài dựa trên tài liệu Google Search Central và RFC 9309.
robots.txt, sitemap.xml và thẻ noindex nghe như 3 việc gần giống nhau, nhưng mỗi thứ trả lời một câu hỏi khác nhau. Dùng lẫn chúng dễ dẫn tới việc trang không xuất hiện trên Google, hoặc xuất hiện ngoài ý muốn.
Bài dựa trên tài liệu Google Search Central, RFC 9309, giao thức sitemaps.org và tài liệu Next.js, WordPress, đối chiếu đến ngày 23/10/2026. Phạm vi là Google Search; công cụ tìm kiếm khác có thể xử lý khác.
Bài trả lời: mỗi công cụ điều khiển việc gì, chọn công cụ nào cho tình huống nào và kiểm tra thế nào. Click Star đã có bài riêng về Googlebot và về đọc báo cáo Search Console; bài này đi sâu vào 3 công cụ điều khiển.
Điểm chính
- robots.txt điều khiển việc thu thập (Googlebot có được tải URL hay không), không điều khiển việc lập chỉ mục. Google ghi rõ đây không phải cách giữ trang khỏi kết quả tìm kiếm.
- Muốn trang rời kết quả, dùng noindex (thẻ meta hoặc tiêu đề X-Robots-Tag) và không chặn trang đó bằng robots.txt, vì Google phải tải trang mới đọc được noindex.
- Sitemap chỉ là gợi ý về URL bạn muốn Google biết. Nó không bảo đảm thu thập hay lập chỉ mục.
- Trang riêng tư cần đăng nhập. RFC 9309 nói robots.txt không phải cơ chế cấp quyền truy cập, và liệt kê đường dẫn trong đó còn làm lộ chúng.
- Lỗi hay gặp: chặn robots.txt cộng noindex, quên rằng nhóm User-agent riêng của Googlebot thay nhóm dấu sao, và sitemap chứa URL bị chặn hoặc bị noindex.
- Kiểm bằng Search Console rồi chờ: noindex chỉ có hiệu lực sau khi Google thu thập lại trang.
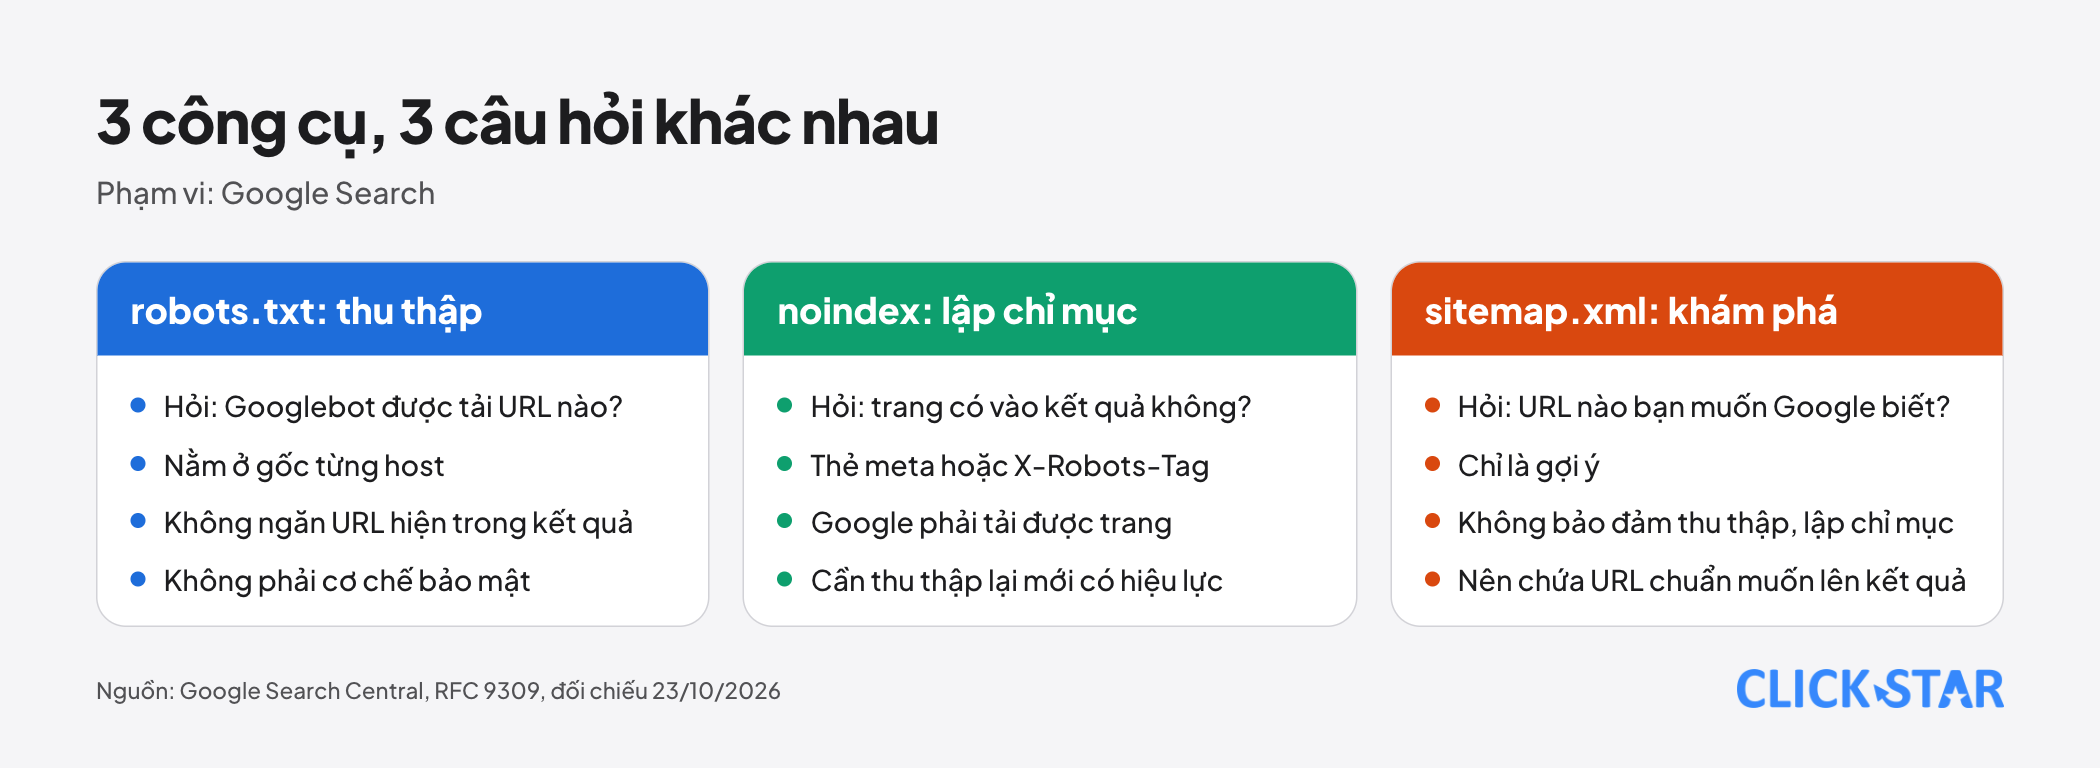
Thu thập, lập chỉ mục, hiển thị: 3 việc khác nhau
Thu thập (crawl) là việc Googlebot tải một URL. Lập chỉ mục (index) là việc Google lưu trang để dùng trong kết quả. Hiển thị là việc trang xuất hiện trên trang kết quả, có hoặc không có đoạn mô tả.
Theo trang What Is Googlebot (cập nhật 3/2/2026), ngăn thu thập thì dùng robots.txt, ngăn lập chỉ mục thì dùng noindex, không cho ai truy cập thì dùng cách khác như mật khẩu. Chặn thu thập không ngăn URL xuất hiện trong kết quả.
robots.txt: viết và đọc quy tắc đúng
Vị trí. Theo trang tạo robots.txt (cập nhật 21/11/2025), tệp nằm ở gốc từng host và chỉ áp dụng cho đúng giao thức, host và cổng đó. Quy tắc ở example.com không áp dụng cho m.example.com hay http://example.com.
Nhóm quy tắc. Mỗi nhóm bắt đầu bằng dòng User-agent, theo sau là Allow hoặc Disallow. Theo trang diễn giải đặc tả (cập nhật 31/8/2026), Google chỉ dùng nhóm khớp cụ thể nhất; nhóm riêng và nhóm dấu sao không được gộp với nhau.
Khớp đường dẫn. Giá trị đường dẫn phân biệt hoa thường và hỗ trợ ký tự đại diện * và $. Khi nhiều quy tắc khớp, quy tắc có đường dẫn dài hơn thắng; nếu xung đột, Google dùng quy tắc ít hạn chế hơn. Google chỉ hiểu user-agent, allow, disallow, sitemap; crawl-delay không được hỗ trợ.
Mã trạng thái của tệp. Theo trang đặc tả, mã 4xx (trừ 429) được coi như không có tệp, tức không có hạn chế. Mã 5xx thì khác: trong 12 giờ đầu Google ngừng thu thập website, sau đó tối đa 30 ngày dùng bản tốt gần nhất; nếu không có bản lưu thì coi như không hạn chế.
Hệ quả: lần triển khai làm robots.txt trả lỗi máy chủ có thể làm Google ngừng thu thập trong 12 giờ đầu. Google lưu bản robots.txt tới khoảng 24 giờ; báo cáo robots.txt có chức năng yêu cầu thu thập lại khi khẩn cấp.
Giới hạn. Tệp tối đa 500 KiB, phần vượt bị bỏ qua. Quy tắc không áp dụng cho trình lấy dữ liệu do người dùng kích hoạt.
Vì sao chặn robots.txt rồi noindex không có tác dụng
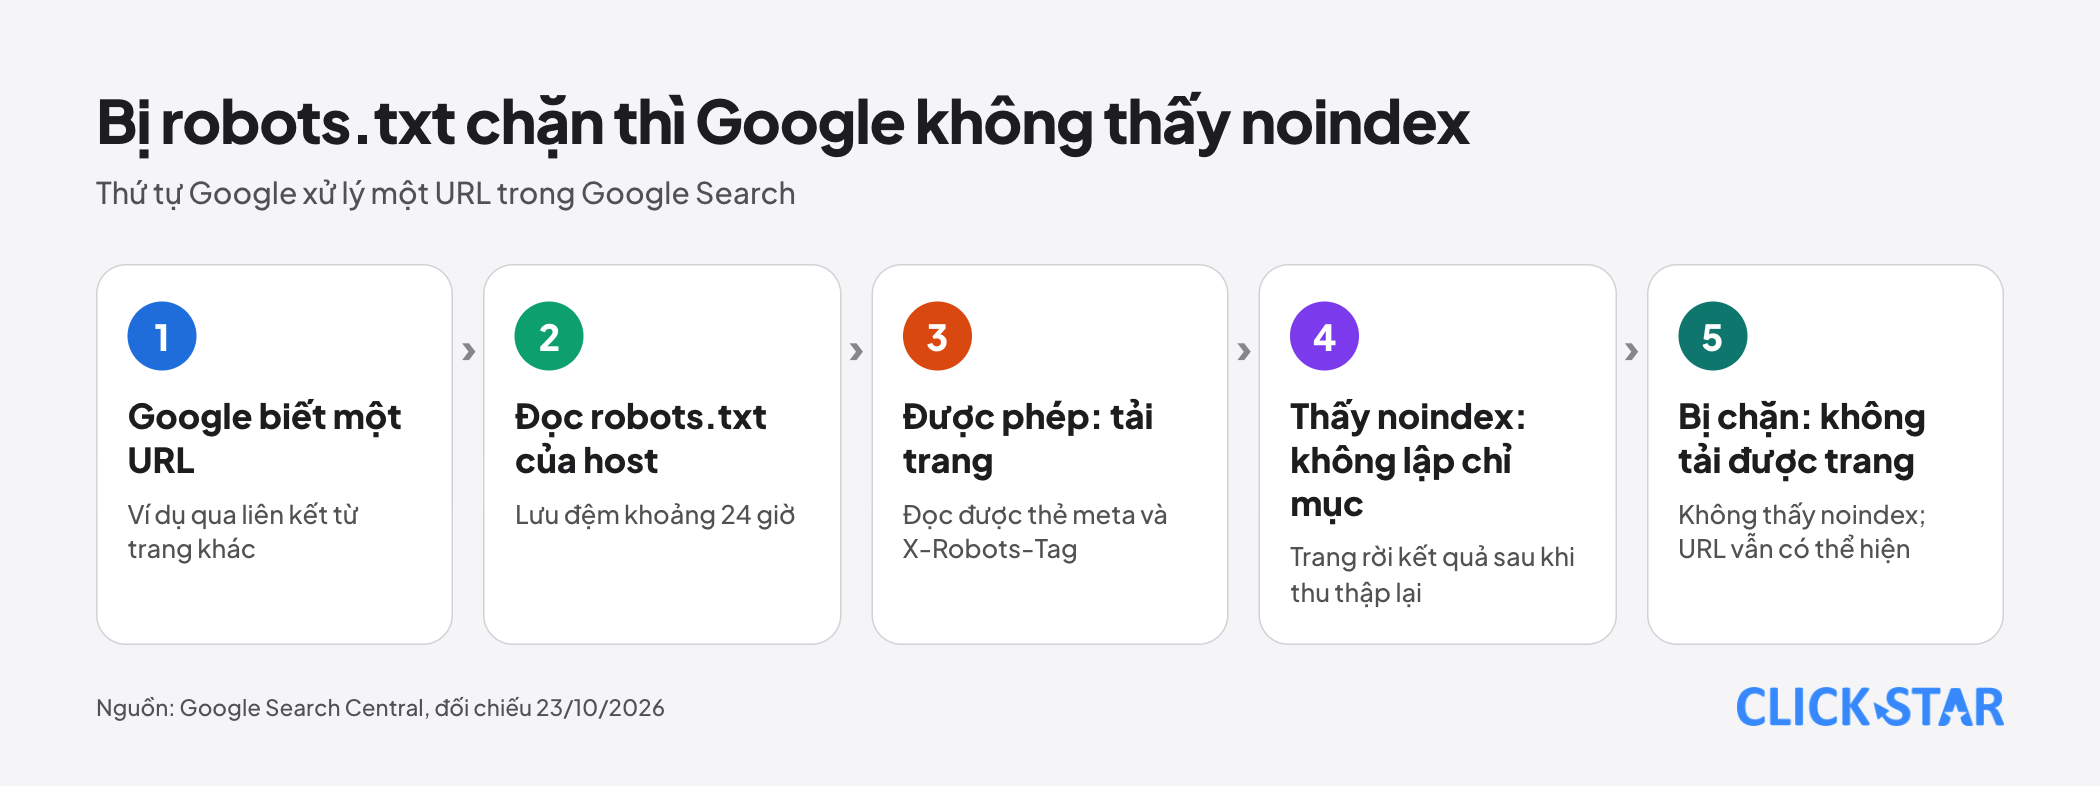
Thẻ noindex nằm trong trang, nên Google phải tải trang mới đọc được. Theo trang Block Search Indexing with noindex (cập nhật 10/12/2025), nếu robots.txt chặn trang thì trình thu thập không thấy noindex, và trang vẫn có thể xuất hiện, chẳng hạn khi trang khác liên kết tới.
URL bị chặn vẫn có thể được lập chỉ mục mà không cần tải trang. Trang giới thiệu robots.txt (cập nhật 10/12/2025) nói URL có thể hiện trong kết quả nhưng không có mô tả. Search Console gọi tình huống này là "Indexed, though blocked by robots.txt" và hướng dẫn bỏ chặn rồi dùng noindex (báo cáo Page indexing, không ghi ngày).
Vì vậy thứ tự đúng để gỡ một trang là: bỏ chặn robots.txt cho URL đó, thêm noindex, rồi chờ Google thu thập lại. Trang Block Search Indexing nói việc này có thể mất tới vài tháng tùy mức độ quan trọng của trang; công cụ Kiểm tra URL cho phép yêu cầu thu thập lại.
noindex: thẻ meta hay tiêu đề X-Robots-Tag
Google nói 2 cách có cùng tác dụng. Trang HTML dùng thẻ meta name="robots" content="noindex" trong phần head. Tệp không phải HTML như PDF, video, ảnh dùng tiêu đề phản hồi X-Robots-Tag: noindex, thường cấu hình ở máy chủ. Quy tắc noindex đặt trong robots.txt không được Google hỗ trợ.
Đổi name thành googlebot để nhắm riêng Google. Khi các quy tắc xung đột, quy tắc hạn chế hơn được áp dụng (trang Robots Meta Tags Specifications, cập nhật 24/3/2026).
JavaScript. Trang JavaScript SEO basics (cập nhật 4/3/2026) nói khi gặp noindex, Google có thể bỏ qua việc hiển thị. Vì thế gỡ noindex bằng JavaScript có thể không hiệu quả; muốn trang được lập chỉ mục, đừng đặt noindex trong mã gốc.
Gỡ khẩn cấp. Công cụ Removals ẩn URL khỏi kết quả khoảng 6 tháng nhưng không ngăn Google thu thập (Search Console, không ghi ngày). Muốn vĩnh viễn, hãy xóa nội dung, đặt mật khẩu hoặc dùng noindex (trang Remove Your Site Info from Google, cập nhật 10/12/2025).
sitemap.xml: khi nào cần và nên chứa gì
Theo trang What Is a Sitemap (cập nhật 10/12/2025), sitemap có thể cần cho website lớn, website mới ít liên kết từ ngoài, hoặc nhiều video, ảnh. Website khoảng 500 trang trở xuống và liên kết nội bộ đầy đủ có thể không cần. Sitemap không bảo đảm trang được thu thập hay lập chỉ mục.
Giới hạn. Trang Build and Submit a Sitemap (cập nhật 8/7/2026): mỗi tệp tối đa 50MB chưa nén hoặc 50.000 URL, mã hóa UTF-8, URL tuyệt đối. Vượt thì phải chia nhỏ; có thể gộp bằng tệp chỉ mục sitemap.
Nội dung. Chỉ đưa URL chuẩn bạn muốn thấy trong kết quả. Nếu cùng nội dung có nhiều địa chỉ, chọn 1 địa chỉ thay vì đưa tất cả.
Thẻ lastmod. Google bỏ qua priority và changefreq. Google dùng lastmod nếu nó nhất quán và kiểm chứng được là đúng, và nó phải phản ánh thay đổi đáng kể như nội dung chính, dữ liệu có cấu trúc, liên kết; đổi năm bản quyền thì không tính.
Giao thức sitemaps.org (cập nhật 21/11/2016) nói đó là ngày sửa trang, không phải ngày tạo sitemap.
Cách gửi. Gửi qua báo cáo Sitemaps, Search Console API hoặc dòng Sitemap trong robots.txt. Google đã ngừng điểm cuối ping (bài blog 26/6/2023). Báo cáo Sitemaps (không ghi ngày) chỉ liệt kê sitemap gửi qua báo cáo hoặc API, không liệt kê sitemap chỉ tìm thấy qua robots.txt.
Chọn công cụ theo tình huống
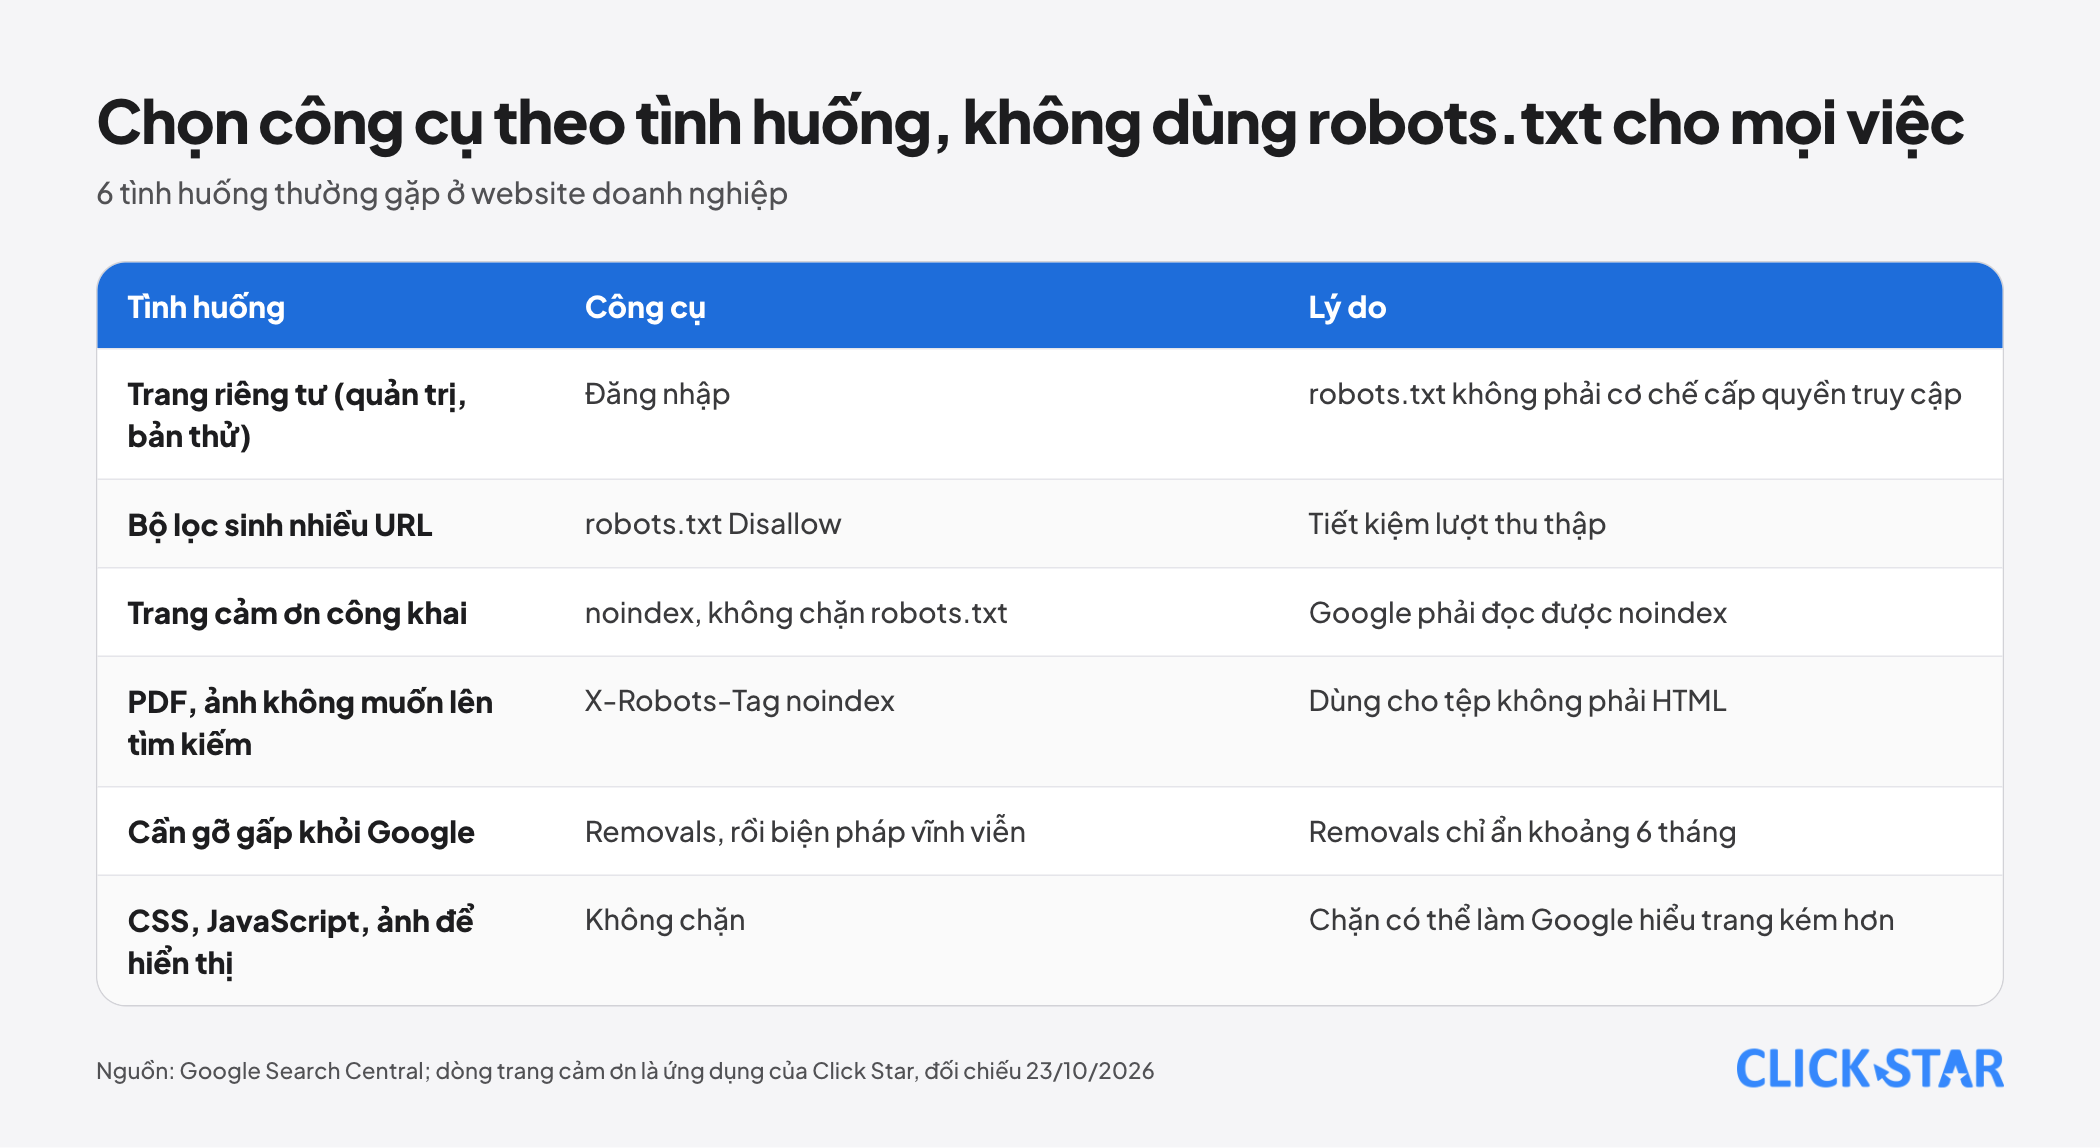
Bảng tóm tắt cách Click Star đọc các trang Google đã nêu. Dòng trang cảm ơn là ứng dụng của Click Star, không phải ví dụ trong tài liệu Google.
Trang riêng tư (quản trị, bản thử): dùng đăng nhập. Bộ lọc sinh nhiều URL: Google (Managing crawling of faceted navigation URLs, cập nhật 18/12/2025) nói nếu không cần chúng xuất hiện, có thể chặn thu thập, trong đó robots.txt là một cách.
Trang công khai nhưng không muốn lên Google, như trang cảm ơn sau biểu mẫu: dùng noindex và không chặn robots.txt. PDF hoặc ảnh: dùng X-Robots-Tag ở máy chủ.
Tệp CSS, JavaScript, ảnh cần để hiển thị trang: đừng chặn, vì Google có thể hiểu trang kém hơn (trang giới thiệu robots.txt).
Mẫu cấu hình cho website doanh nghiệp Việt Nam
Click Star không tìm thấy số đo về tỷ lệ website Việt Nam cấu hình sai các tệp này. Khung dưới đây do Click Star tự đề xuất, không lấy từ nguồn ngoài. Một robots.txt tối thiểu:
- User-agent: *
- Disallow: /tim-kiem
- Sitemap: https://www.example.com/sitemap.xml
Giữ dòng Disallow chỉ khi có trang tìm kiếm nội bộ sinh nhiều URL, và thay example.com bằng địa chỉ thật. Disallow khớp theo tiền tố, nên /tim-kiem cũng chặn /tim-kiem-dich-vu.
Không liệt kê đường dẫn quản trị nhạy cảm, vì RFC 9309 nói liệt kê làm đường dẫn bị lộ công khai.
Next.js và WordPress. Next.js cho đặt robots.txt tĩnh hoặc viết robots.ts, sitemap.ts (tài liệu cập nhật 1/5/2026 và 18/8/2026). WordPress có ô "Discourage search engines from indexing this site", thêm meta noindex từ bản 5.3 và chỉ là đề nghị (Settings Reading screen, cập nhật 8/6/2024). Hãy bỏ chọn khi ra mắt.
Đánh giá của Click Star. Cách nhớ gọn: robots.txt để tiết kiệm lượt thu thập, noindex để loại trang khỏi kết quả, đăng nhập để bảo vệ, sitemap để chỉ đường. Với website dưới vài trăm trang, robots.txt ngắn cộng sitemap tự sinh thường đủ.
Đây là nhận định kỹ thuật của Click Star, không phải số đo. Click Star có bán dịch vụ thiết kế website chuẩn SEO tải nhanh, nên có lợi ích liên quan khi người đọc cần hỗ trợ cấu hình.
Cách kiểm tra
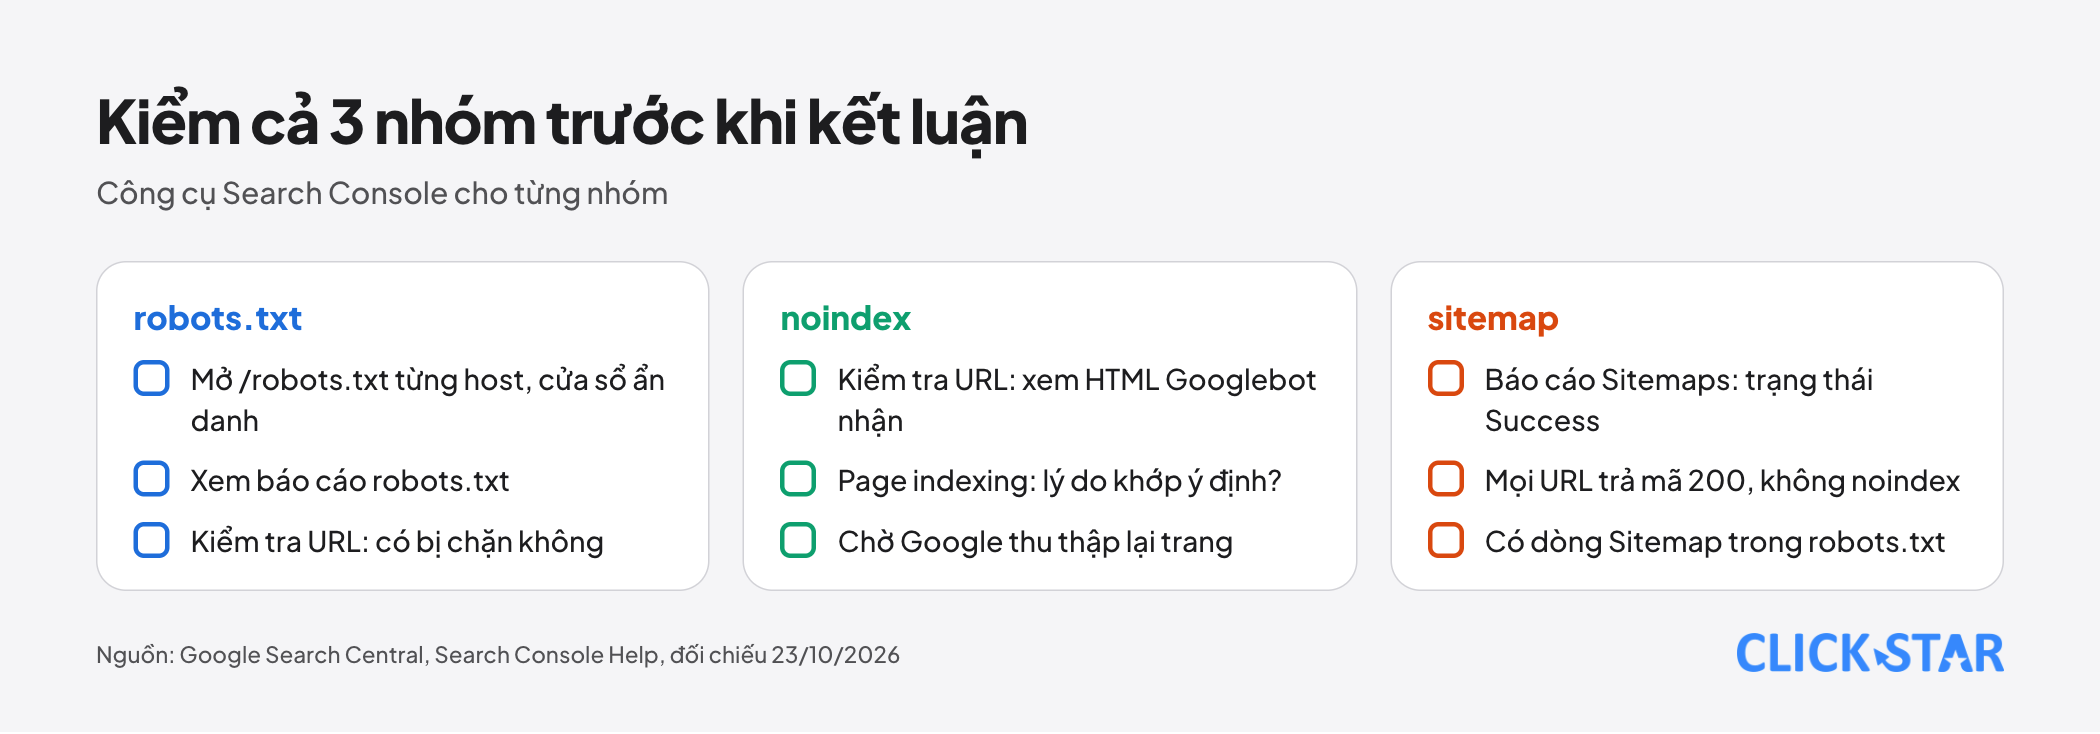
robots.txt. Mở /robots.txt của từng host trong cửa sổ ẩn danh. Báo cáo robots.txt trong Search Console cho thấy tệp Google tìm thấy, trạng thái tải và lỗi cú pháp, nhưng chỉ ở thuộc tính cấp tên miền hoặc URL-prefix không kèm đường dẫn.
Một URL. Công cụ Kiểm tra URL cho biết URL có bị robots.txt chặn không và cho xem HTML mà Googlebot nhận, giúp xác nhận noindex có thật sự hiện ra.
Lập chỉ mục trang. Báo cáo Page indexing có các lý do như "URL blocked by robots.txt" và "URL marked noindex". Không lập chỉ mục vì chặn có chủ ý là bình thường; chỉ sửa khi lý do không khớp ý định.
Sitemaps. Báo cáo Sitemaps có trạng thái Success, Has errors hoặc Couldn't fetch. Theo khuyến nghị của Click Star, mọi URL trong sitemap nên trả mã 200 và không bị noindex.
Việc nên làm: lộ trình 5 ngày
Lộ trình là khung tham khảo của Click Star, không phải số đo và không lấy từ nguồn ngoài.
- Ngày 1: chia URL thành 3 nhóm: cần lên Google, công khai nhưng không cần lên Google, riêng tư.
- Ngày 2: mở robots.txt của từng host (www, không www, tên miền con); gỡ quy tắc chặn trang thuộc nhóm cần lên Google.
- Ngày 3: gắn noindex cho nhóm công khai không cần lên Google, bỏ chặn robots.txt cho các URL đó, đặt đăng nhập cho nhóm riêng tư.
- Ngày 4: rà sitemap: chỉ URL chuẩn, lastmod đúng ngày sửa thật, thêm dòng Sitemap trong robots.txt và gửi trong Search Console.
- Ngày 5: Kiểm tra URL cho 5 trang mẫu, lưu báo cáo Page indexing làm mốc và hẹn xem lại sau 4 tuần (trang ít quan trọng có thể lâu hơn).
Những sai lầm thường gặp
- Để sót Disallow: / từ môi trường thử khi ra mắt.
- Chặn trang trong robots.txt rồi thêm noindex, kỳ vọng trang biến mất khỏi kết quả.
- Dùng robots.txt làm lớp bảo mật cho trang riêng tư.
- Thêm nhóm User-agent: Googlebot mà quên nó thay thế nhóm dấu sao.
- Chặn thư mục CSS, JavaScript hoặc ảnh cần để hiển thị trang.
- Đưa vào sitemap URL không muốn lên kết quả (chuyển hướng, bị noindex, bị chặn), hoặc ghi lastmod là ngày tạo sitemap.
- Đặt noindex trong mã gốc rồi dùng JavaScript để gỡ.
Điều chưa biết
Click Star không có số đo cho Việt Nam về tỷ lệ cấu hình sai. Google chỉ nói việc thu thập lại có thể mất tới vài tháng, không cam kết mốc cụ thể cho noindex. Tài liệu Google nói công cụ tìm kiếm khác có thể diễn giải khác; Click Star chưa đọc tài liệu của chúng.
RFC 9309 và Google khác nhau ở mã 5xx: RFC yêu cầu coi như cấm toàn bộ; Google dùng bản cũ tối đa 30 ngày, hoặc coi như không hạn chế nếu không có bản lưu.
Click Star không tìm thấy hướng dẫn về việc chặn lại bằng robots.txt sau khi noindex đã có hiệu lực; trang Remove Your Site Info from Google khuyên đừng dùng robots.txt để chặn trang, nên Click Star khuyên giữ noindex.
Các trang trợ giúp Search Console không ghi ngày. Click Star chưa kiểm từng plugin SEO của WordPress, cũng chưa kiểm mức tuân thủ robots.txt của các trình thu thập AI ngoài Google.
Bài liên quan



Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.