Chạy AI tại máy (local LLM) hay dùng đám mây: so sánh chi phí, bảo mật, chất lượng và công sức vận hành
Mô hình trọng số mở là gì, chạy tại máy cần bao nhiêu bộ nhớ, chi phí tính thế nào so với giá API, rủi ro bảo mật ra sao và khi nào nên dùng mô hình lai, dựa trên tài liệu chính thức.
Nhiều doanh nghiệp đang hỏi: nên tự chạy mô hình AI trên máy của mình để dữ liệu không rời công ty, hay tiếp tục gọi API đám mây. Câu trả lời phụ thuộc vào 4 thứ: chi phí thật, rủi ro dữ liệu, chất lượng trên việc cụ thể và người vận hành.
Bài dựa trên trang mô hình Hugging Face, tài liệu Ollama, llama.cpp và vLLM, trang giá của Anthropic, OpenAI và Google, phân tích của Epoch AI và nghiên cứu của Cisco, đối chiếu đến ngày 21/10/2026.
Bài trả lời khi nào nên chạy tại máy, khi nào nên dùng đám mây và khi nào nên lai. Click Star đã có bài riêng về tối ưu token, chọn model Claude, chatbot AI và bảo vệ dữ liệu khách hàng, nên không lặp lại. Click Star bán dịch vụ tích hợp AI, nên có lợi ích liên quan; bài nêu cả trường hợp không nên tự chạy.
Điểm chính
- Mô hình "trọng số mở" cho tải trọng số về chạy nhưng chưa chắc là mã nguồn mở: định nghĩa của OSI đòi thêm thông tin dữ liệu và mã huấn luyện. Giấy phép quyết định bạn được làm gì.
- Tháng 10/2026, gpt-oss, Gemma 4 và Qwen3.5 dùng Apache 2.0, DeepSeek V4.1 Flash dùng MIT, còn Llama 4 dùng giấy phép riêng của Meta với điều kiện ghi nhận và đặt tên.
- Bộ nhớ là giới hạn đầu tiên: trọng số xấp xỉ số tham số nhân số bit chia 8, cộng bộ nhớ đệm KV tăng theo ngữ cảnh và số người dùng.
- Chi phí không chỉ là GPU: phải cộng điện, nhân công, dự phòng, rồi so với giá API chính thức, nơi có mô hình giá 0,10 USD cho 1 triệu token đầu vào.
- Chạy tại máy giữ dữ liệu trong hạ tầng của bạn nhưng chuyển trách nhiệm bảo mật sang bạn: Cisco thấy 1.139 máy chủ Ollama mở ra internet, 214 máy trả lời không cần xác thực.
- Epoch AI ước tính mô hình mở chậm khoảng 4 tháng so với mô hình đóng tiên tiến (từ 1/2026). Chất lượng tiếng Việt phải tự đo trên mẫu thật.
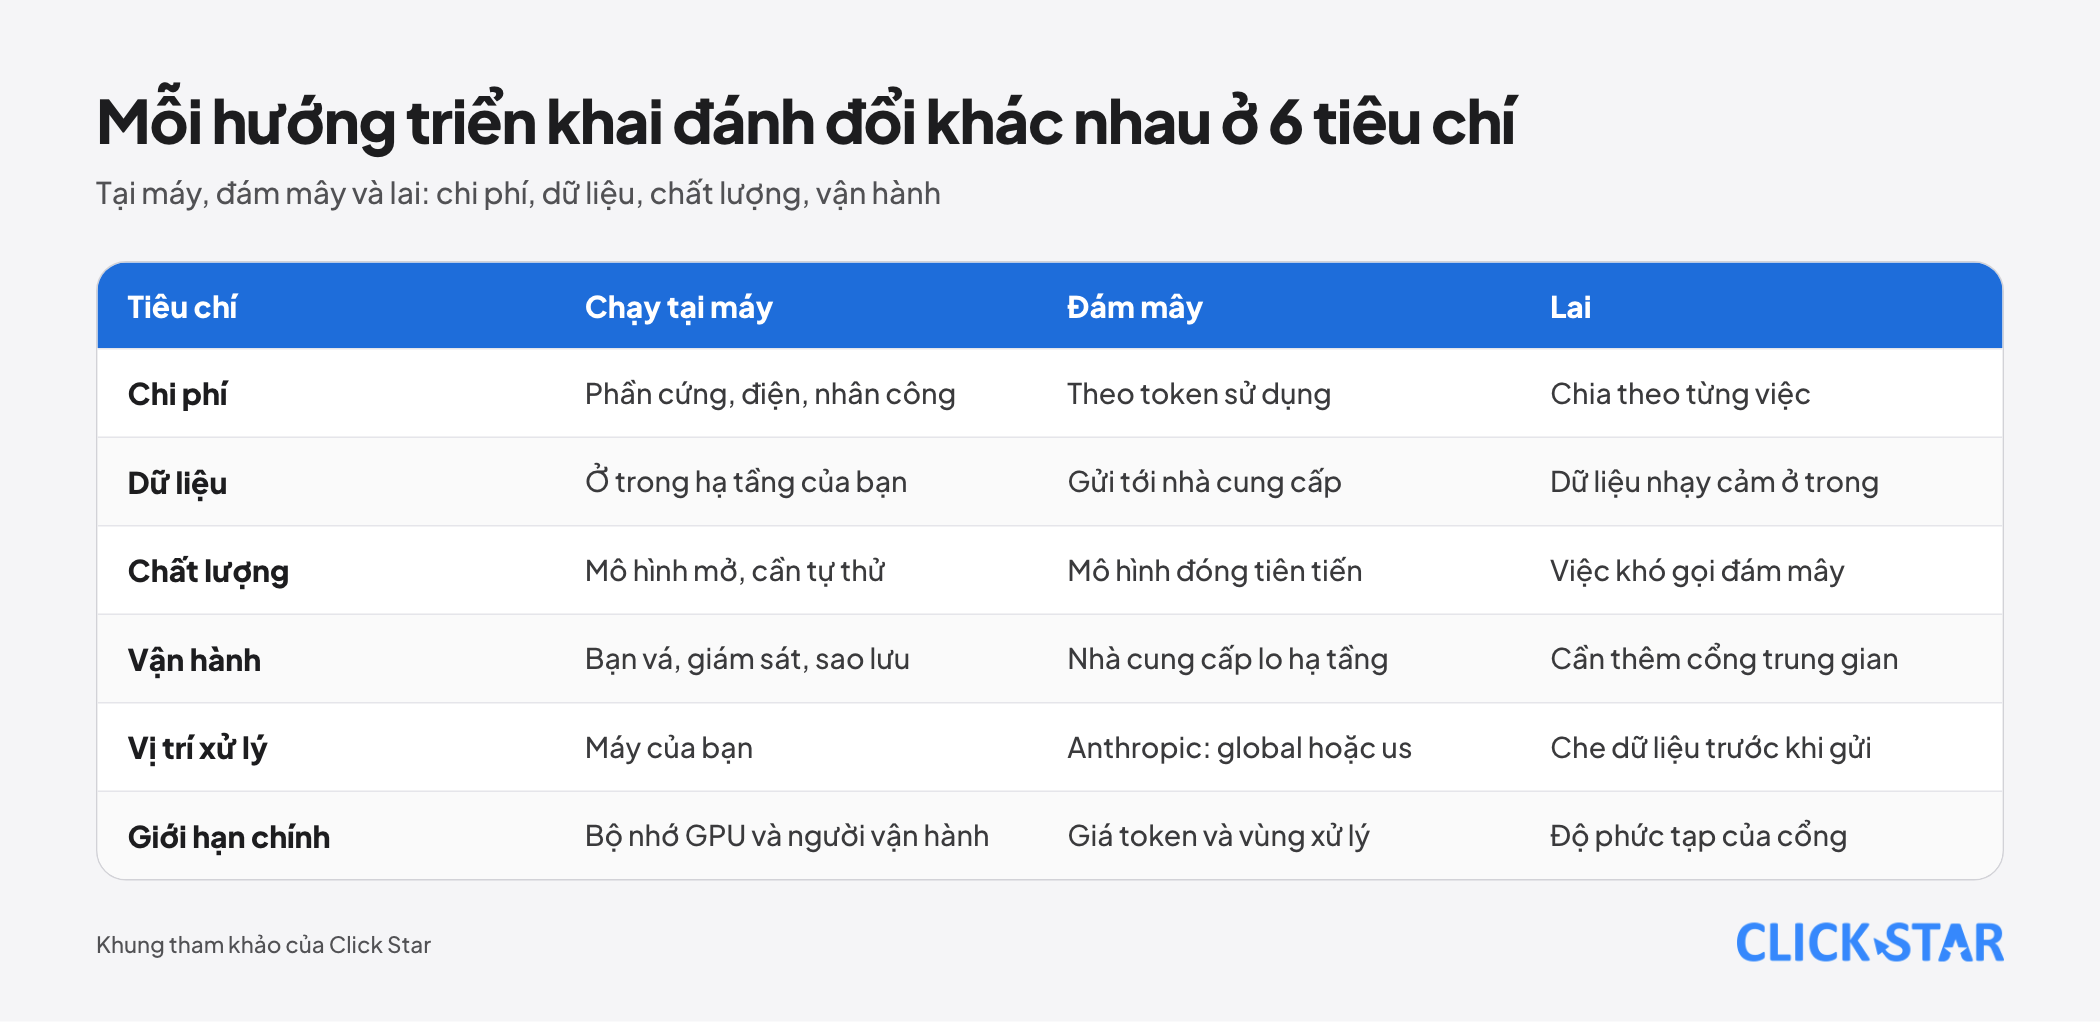
Mô hình trọng số mở là gì, khác mã nguồn mở thế nào
Mô hình trọng số mở là mô hình mà nhà phát hành công bố tệp trọng số (các tham số đã huấn luyện) để người khác tải về chạy. Điều bạn được làm với tệp đó do giấy phép quy định, không phải do việc tải được.
Theo Open Source Initiative (định nghĩa Open Source AI bản 1.0), AI mã nguồn mở phải cho phép 4 quyền: dùng, nghiên cứu, sửa đổi và chia sẻ. Muốn vậy cần 3 phần: thông tin dữ liệu huấn luyện, mã nguồn huấn luyện và chạy, và các tham số.
Mô hình chỉ công bố tham số, không công bố dữ liệu và mã huấn luyện, là trọng số mở nhưng không đạt định nghĩa của OSI. Click Star chưa kiểm từng mô hình theo định nghĩa này.
Với doanh nghiệp, câu hỏi thực tế là giấy phép cho dùng thương mại với điều kiện gì. Theo văn bản Apache 2.0 trên trang của Google, giấy phép không giới hạn lĩnh vực sử dụng; điều kiện là kèm giấy phép, giữ thông báo và không dùng nhãn hiệu.
Llama 4 khác hẳn. Theo Llama 4 Community License của Meta, sản phẩm trên 700 triệu người dùng hoạt động hàng tháng phải xin giấy phép riêng, phải hiển thị "Built with Llama", và mô hình phân phối được cải thiện bằng Llama phải có tên bắt đầu bằng "Llama". Hãy để pháp chế đọc bản gốc.
Các họ mô hình mở hiện có (tháng 10/2026)
Click Star chỉ nêu điều trang nhà phát hành hoặc thẻ mô hình xác nhận, không xếp hạng chất lượng.
- gpt-oss của OpenAI: gpt-oss-20b có 21B tham số (3,6B hoạt động) và chạy trong 16 GB bộ nhớ nhờ lượng tử hóa MXFP4; gpt-oss-120b có 117B (5,1B hoạt động) và vừa 1 GPU 80 GB. Giấy phép Apache 2.0.
- Gemma 4 của Google DeepMind: thẻ mô hình ghi Apache 2.0, bản 31B có 30,7B tham số, ngữ cảnh 256K token. Theo các bài báo công nghệ (nguồn thứ cấp), Gemma 4 ra mắt ngày 2/4/2026 và chuyển sang Apache 2.0.
- Qwen3.5 của Alibaba: thẻ Qwen3.5-9B ghi Apache 2.0, 201 ngôn ngữ và phương ngữ, ngữ cảnh 262.144 token.
- DeepSeek V4.1 Flash: thẻ ghi giấy phép MIT, 552B tham số lõi, ngữ cảnh đến 1 triệu token, không nêu yêu cầu GPU.
Số ngôn ngữ là tuyên bố của nhà phát hành, không phải số đo tiếng Việt; thẻ Gemma 4 còn ghi cả "hơn 140 ngôn ngữ" lẫn "35+ ngôn ngữ" hỗ trợ sẵn.
Công cụ chạy cục bộ: Ollama, llama.cpp, vLLM
Ollama hợp thử nghiệm nhanh trên 1 máy. Theo GitHub, Ollama theo giấy phép MIT, chạy trên macOS, Windows, Linux, Docker và dùng llama.cpp làm backend. Theo FAQ, mặc định Ollama chỉ lắng nghe 127.0.0.1; muốn mở ra mạng phải đặt OLLAMA_HOST.
llama.cpp hợp phần cứng đa dạng: giấy phép MIT, hỗ trợ Apple silicon (Metal), CUDA, Vulkan, chia việc giữa CPU và GPU, và llama-server có API tương thích OpenAI. vLLM hợp khi nhiều người dùng: giấy phép Apache 2.0, PagedAttention và gom lô liên tục; thẻ Qwen3.5 khuyến nghị vLLM hoặc SGLang cho môi trường sản xuất.
Một bẫy nhỏ: thư viện Ollama có các tag ":cloud" (ví dụ gemma4:cloud). Theo tài liệu Ollama, chúng chạy trên máy chủ của Ollama, không phải máy bạn, nên cần kiểm tra tag nếu dữ liệu không được rời hạ tầng.
Cần bao nhiêu bộ nhớ
Trọng số chiếm xấp xỉ số tham số nhân số bit chia 8. Bảng của Hugging Face về Llama 3.1 cho mô hình 8B cần 16 GB ở FP16, 8 GB ở FP8, 4 GB ở INT4; mô hình 70B cần 140, 70 và 35 GB, chưa gồm bộ nhớ dự trữ cho nhân tính toán.
Tệp thực tế lớn hơn số bit danh nghĩa. Theo README llama.cpp, Llama-3.1-8B ở Q4_K_M dùng 4,89 bit mỗi trọng số (4,58 GiB).
Bộ nhớ đệm KV là phần thứ hai. Cũng theo Hugging Face, mô hình 8B ở FP16 cần 0,125 GB cho 1.000 token ngữ cảnh và 15,62 GB cho 128.000 token. Mỗi người dùng đồng thời cần bộ nhớ đệm riêng.
Với mô hình MoE như gpt-oss, thẻ mô hình cho thấy toàn bộ 117B tham số vẫn phải nằm vừa 1 GPU 80 GB. Click Star suy ra: bộ nhớ theo tổng tham số, tốc độ theo tham số hoạt động.
Về phần cứng, Epoch AI ước tính ở 4 bit, card 24 GB chạy được mô hình đến khoảng 27B, card 32 GB đến khoảng 40B (ngữ cảnh 8K).
Chi phí: khung tính thay vì một con số
Không có con số đúng cho mọi doanh nghiệp, vì chi phí chạy tại máy phụ thuộc vào khối lượng dùng và người vận hành. Khung dưới đây cộng 5 lớp, rồi so với giá API cho cùng khối lượng.
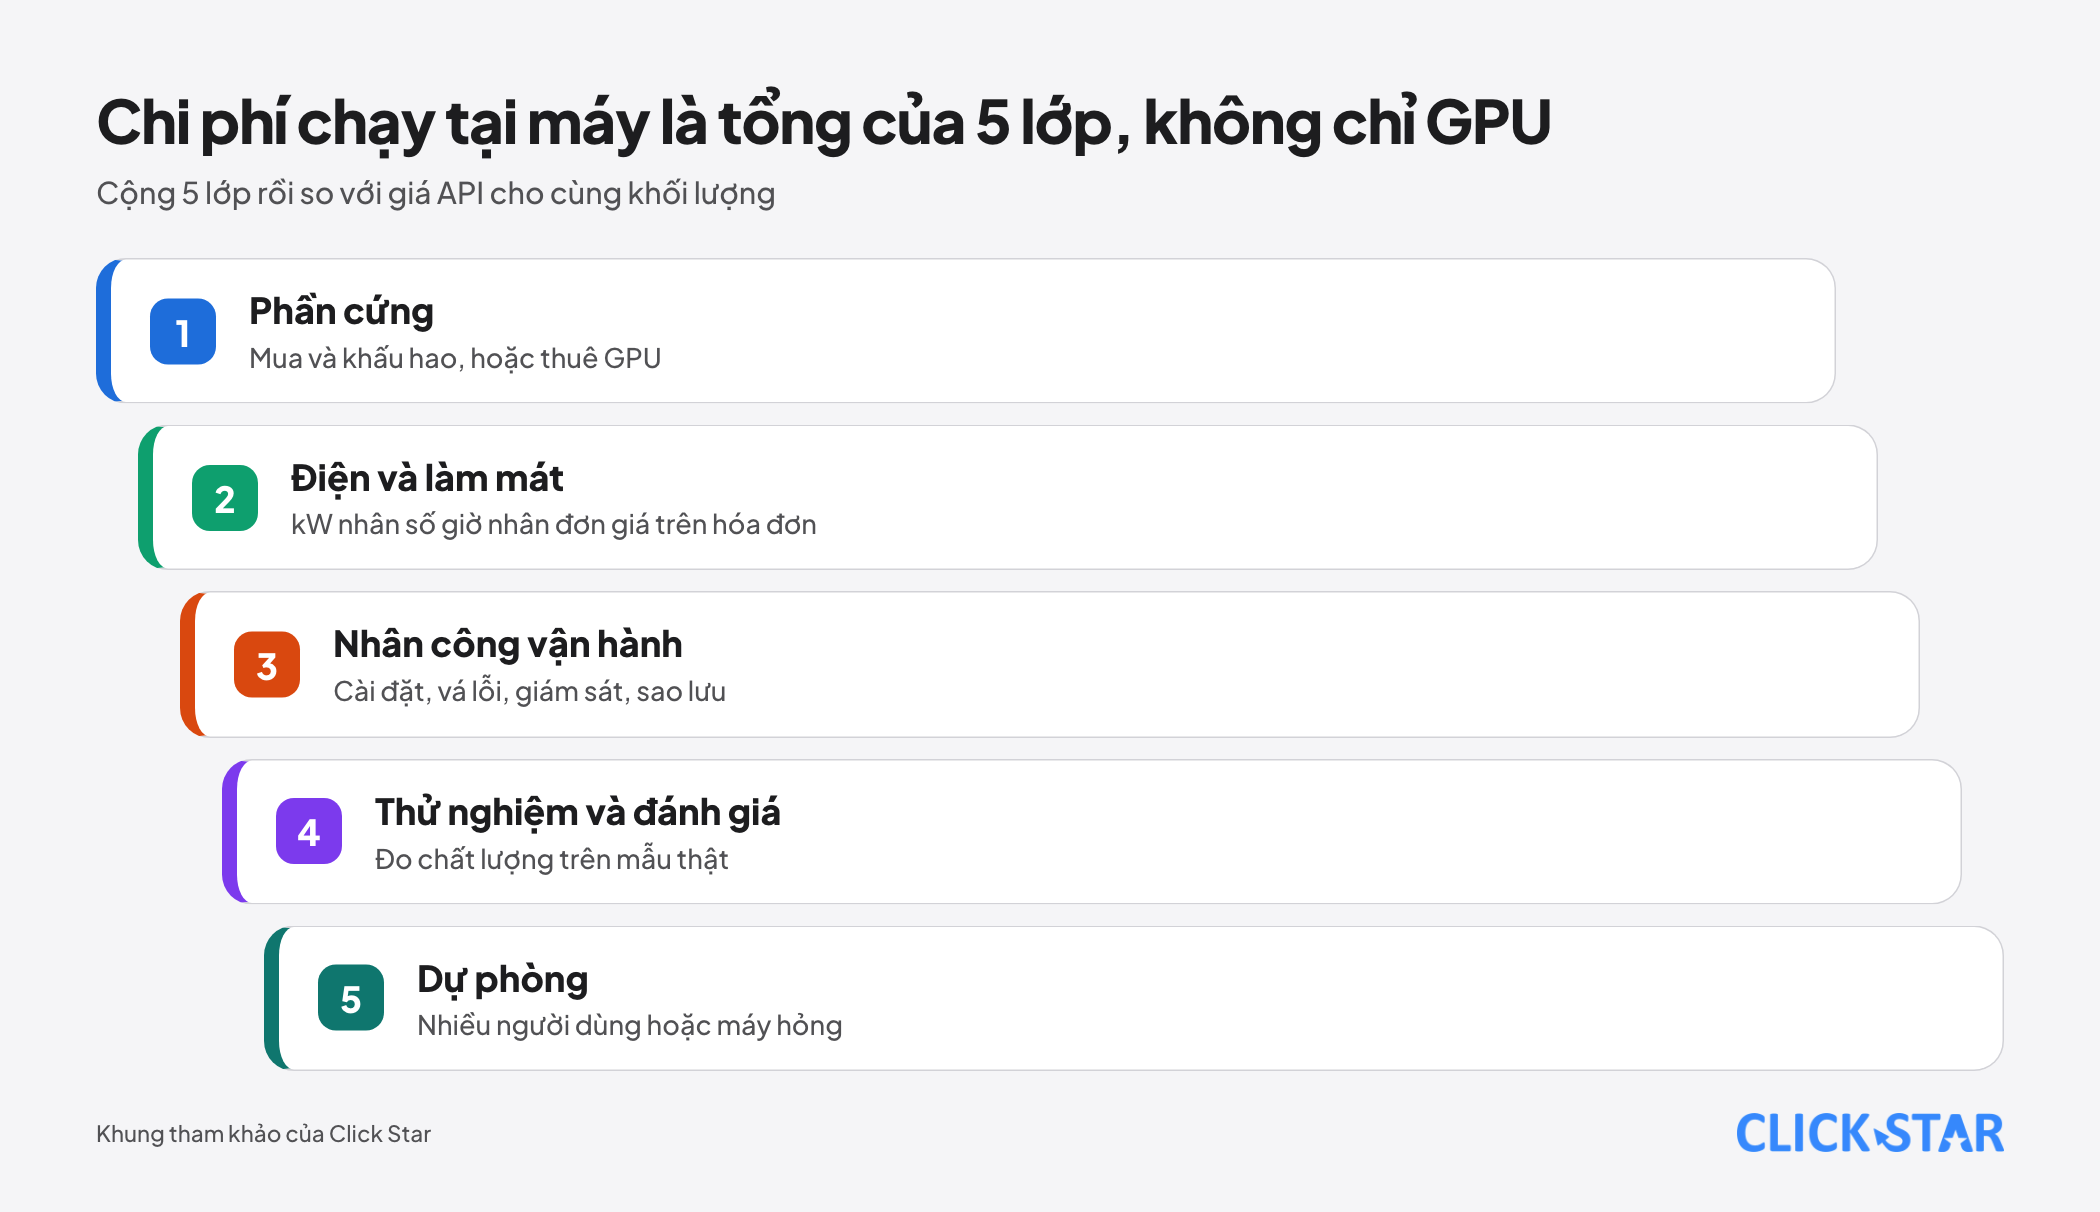
Lớp 1, phần cứng: mua và khấu hao, hoặc thuê GPU. Lớp 2, điện và làm mát: kW nhân số giờ nhân đơn giá trên hóa đơn của bạn. Lớp 3, nhân công: cài đặt, vá lỗi, giám sát, sao lưu. Lớp 4, thử nghiệm và đánh giá chất lượng. Lớp 5, dự phòng khi nhiều người dùng hoặc máy hỏng.
Theo Anthropic, Claude Haiku 5.5 là 0,10 USD đầu vào và 0,50 USD đầu ra cho 1 triệu token (prompt đến 100.000 token), Sonnet 5.5 là 2 và 10 USD, Opus 5.5 là 4 và 20 USD; Batch API giảm 50%. Theo OpenAI, gpt-6-luna là 0,10 và 0,50 USD; theo Google, Gemini 2.5 Flash-Lite là 0,10 và 0,40 USD.
Phép tính minh họa với khối lượng giả định, không phải số đo: 100 triệu token đầu vào và 20 triệu token đầu ra mỗi tháng ở 0,10 và 0,50 USD là 10 + 10 = 20 USD. Hòa vốn: chi phí cố định hàng tháng của máy tại chỗ chia giá API bình quân mỗi token.
Hệ quả: với khối lượng thấp hoặc vừa, API thường rẻ hơn máy GPU cộng người vận hành. Chạy tại chỗ có lợi về tiền khi khối lượng lớn, đều và máy dùng gần hết công suất.
Bảo mật và tuân thủ: dữ liệu ở lại, trách nhiệm cũng ở lại
Chạy tại máy giúp dữ liệu không đi qua nhà cung cấp bên ngoài, nhưng bạn thành bên chịu trách nhiệm vá lỗi, kiểm soát truy cập, ghi nhật ký và sao lưu.
Rủi ro lớn nhất là mở nhầm ra internet. Theo Cisco (đăng 1/9/2025), tìm bằng Shodan thấy 1.139 máy chủ Ollama mở công khai; 214 máy (khoảng 18,8%) đang chạy mô hình và trả lời không cần xác thực. Cisco khuyến nghị xác thực, đặt sau tường lửa hoặc VPN, và giới hạn tốc độ.
Tài liệu bảo mật của vLLM nêu rủi ro tương tự: --api-key chỉ bảo vệ một số đường dẫn, nên cần reverse proxy chỉ cho phép điểm cuối cần thiết.
Phía đám mây, Anthropic ghi đầu vào và đầu ra của sản phẩm thương mại (gồm API) không dùng để huấn luyện, trừ khi bạn gửi phản hồi hoặc cho phép. OpenAI ghi dữ liệu API mặc định không dùng để huấn luyện và nhật ký giám sát giữ đến 30 ngày.
Về vị trí xử lý, Anthropic chỉ có 2 giá trị inference_geo là "global" và "us", còn OpenAI liệt kê các vùng như Mỹ, châu Âu, Singapore, Nhật Bản, không có Việt Nam. Nếu yêu cầu là xử lý trong nước, đây là lý do chính để cân nhắc chạy tại chỗ.
Click Star đã có bài riêng về Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15 nên không phân tích điều khoản ở đây. Chạy tại máy không tự động đáp ứng pháp luật; hãy đối chiếu văn bản gốc và hỏi luật sư.
Chất lượng: mô hình mở chậm bao nhiêu so với đám mây
Mô hình mở đang đuổi sát nhưng chưa ngang ở mức tiên tiến nhất. Theo Epoch AI (đăng 29/5/2026), từ 1/2026 mô hình mở mạnh nhất chậm trung bình khoảng 4 tháng so với mô hình đóng tiên tiến trên chỉ số ECI, chênh trung bình 8 điểm (khoảng tin cậy 90%: 7 đến 11).
Nếu yêu cầu điểm mô hình mở phải cao hơn hẳn thì khoảng cách là 6 tháng, và bản trước (30/10/2025) cho khoảng 3 tháng. Với mô hình nhỏ chạy được trên 1 card tiêu dùng, Epoch (15/8/2025) ước tính chậm 6 đến 12 tháng tùy bài đo.
Với tiếng Việt, có bài đo công khai nhưng không có thước đo chuẩn cho công việc của bạn. VMLU (ACL 2025) là bộ đo tiếng Việt, và các tác giả nêu cách viết prompt làm đổi kết quả. SEA-HELM (arXiv, 2/2025) gồm tiếng Việt; bảng xếp hạng đề ngày 18/9/2026.
Click Star không đọc được điểm riêng cho tiếng Việt ở đó nên không nêu thứ hạng. Điểm chung cũng không thay được phép thử trên hợp đồng, email và hội thoại khách hàng của bạn.
Mô hình lai: dữ liệu nhạy cảm ở trong, việc khó gọi ra ngoài
Mô hình lai chia việc theo mức nhạy cảm và độ khó. Việc chạm dữ liệu nhạy cảm (phân loại, che thông tin định danh, tóm tắt nội bộ) dùng mô hình nhỏ tại chỗ. Việc khó cần suy luận mạnh gọi API đám mây, chỉ với dữ liệu đã che.
Điều kiện: quy tắc phân loại dữ liệu rõ, cổng trung gian quyết định yêu cầu đi đâu, nhật ký những gì gửi ra ngoài, và phép kiểm độ chính xác của bước che. Che sót làm lộ dữ liệu; che nhầm làm hỏng số liệu.
Khi nào chạy tại máy hợp lý, khi nào không
Chạy tại máy thường hợp lý khi dữ liệu bắt buộc ở lại hạ tầng, khối lượng lớn và đều, tác vụ chịu được mô hình cỡ vừa, và có người đủ năng lực vận hành. Click Star cho rằng điều kiện người vận hành hay bị bỏ qua nhất.
Chưa nên khi khối lượng thấp hoặc thất thường, cần chất lượng ở mức tiên tiến, chưa có người lo bảo mật, hoặc chỉ muốn tiết kiệm mà chưa tính nhân công.
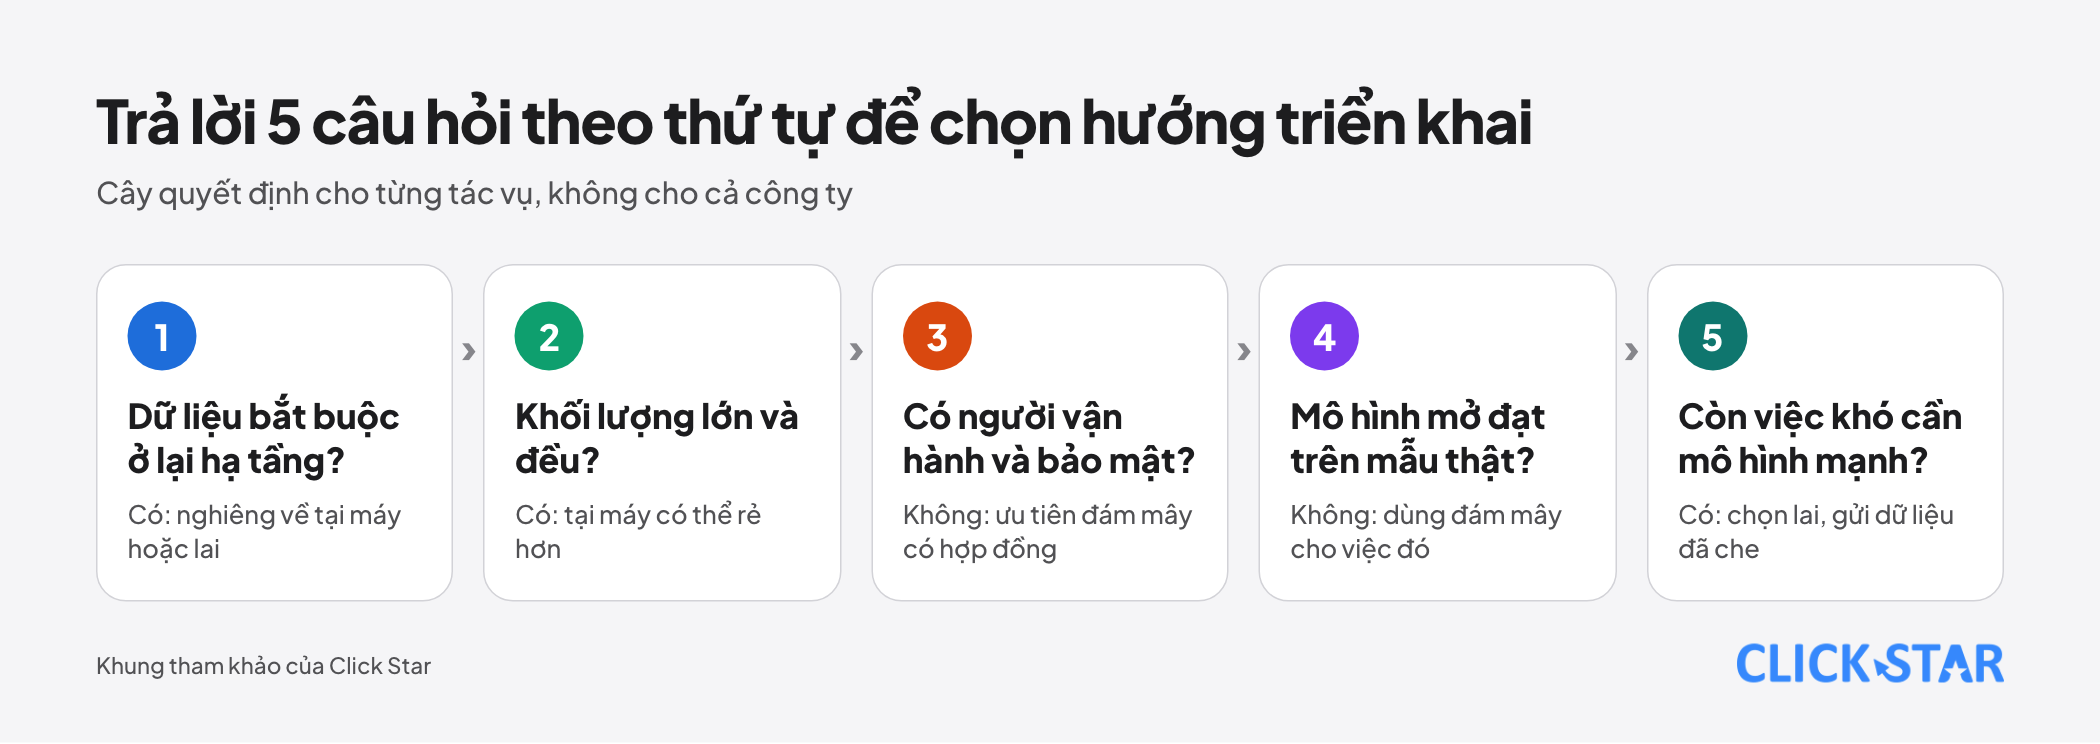
Đánh giá của Click Star. Câu hỏi nên đặt là "việc nào chạy ở đâu", không phải "local hay đám mây" cho cả công ty. Mỗi tác vụ có mức nhạy cảm, khối lượng và yêu cầu chất lượng khác nhau, nên kết quả thường là lai.
Về quản trị, chạy tại máy biến AI thành hệ thống phải có chủ sở hữu, quy trình vá, kiểm soát truy cập và dự phòng. Nếu chưa có, rủi ro có thể cao hơn dùng đám mây có hợp đồng rõ ràng.
Kế hoạch thử nghiệm 2 tuần
Mục tiêu là quyết định bằng số đo của chính bạn. Chọn 1 tác vụ, ví dụ phân loại email hỗ trợ.
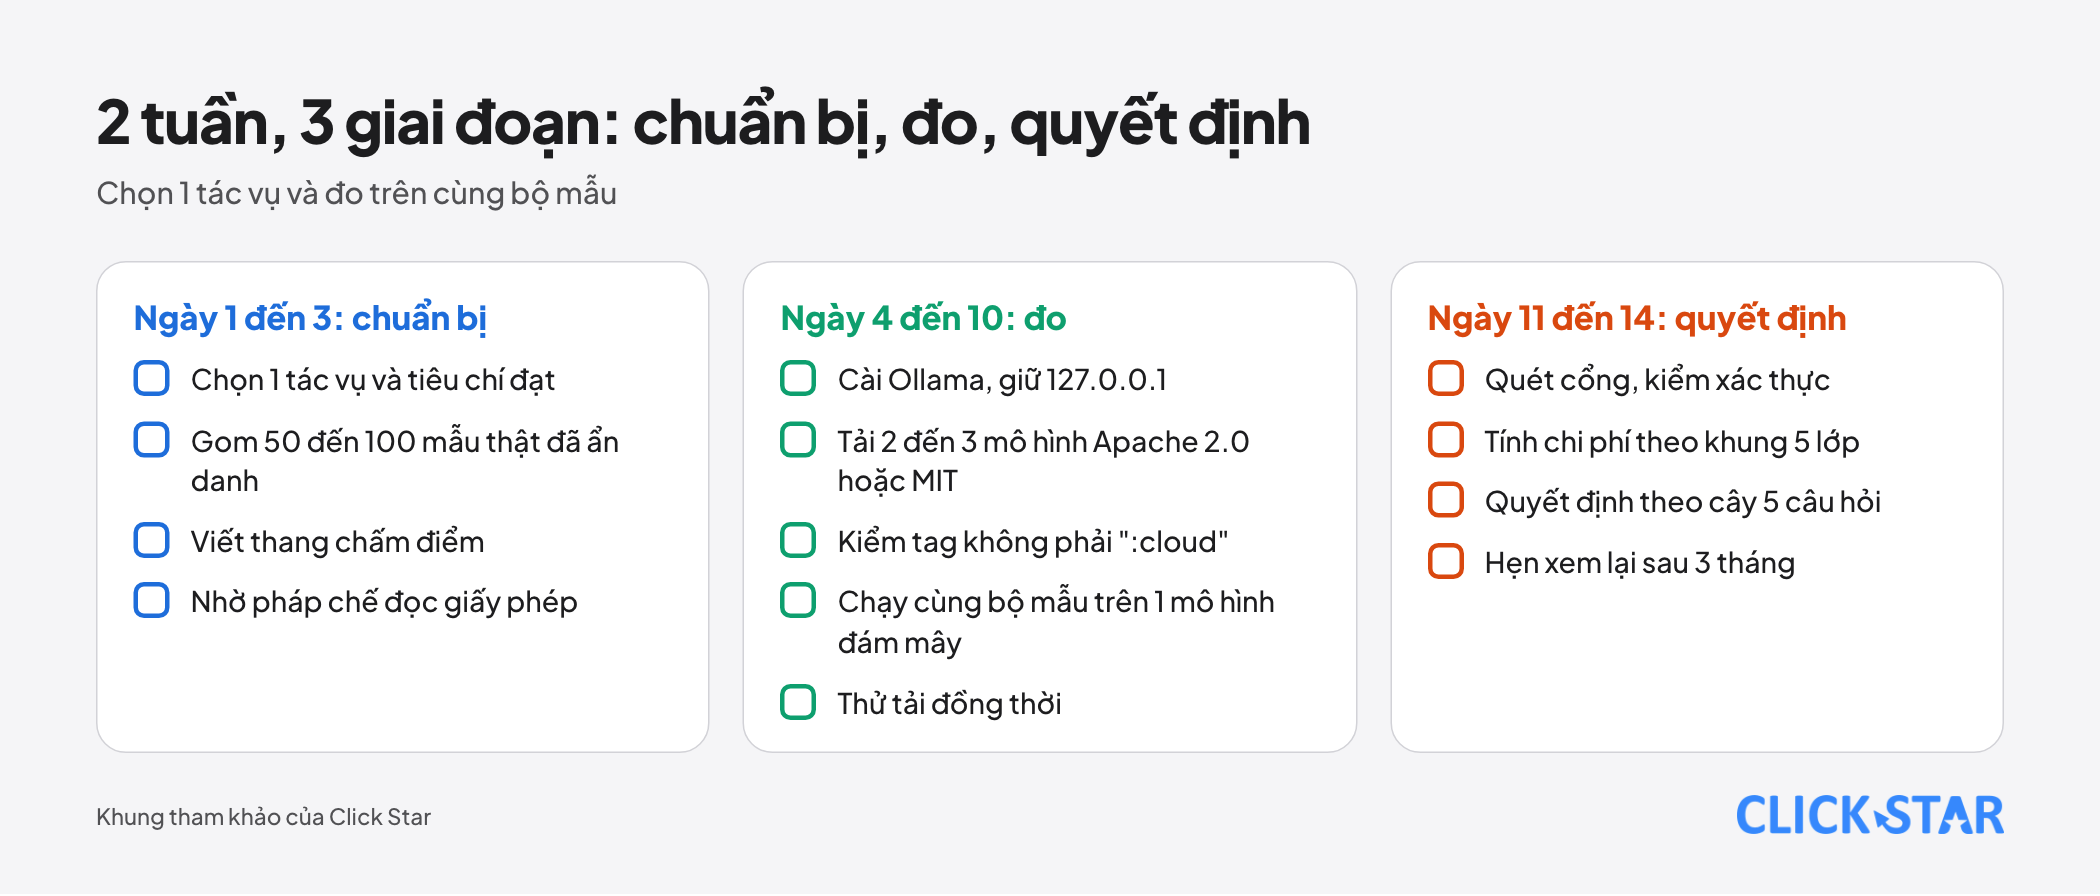
Đo 5 chỉ số trên cùng bộ mẫu và prompt cho cả hai phương án: chất lượng theo thang cố định, độ trễ, tốc độ sinh token, bộ nhớ khi nhiều người dùng đồng thời, và chi phí thực cho 1 triệu token (gồm điện và công vận hành).
- Ngày 1 đến 3 (chuẩn bị): chọn tác vụ và tiêu chí đạt; gom 50 đến 100 mẫu thật đã ẩn danh; viết thang chấm; nhờ pháp chế đọc giấy phép mô hình.
- Ngày 4 đến 10 (đo): cài Ollama trên 1 máy, giữ 127.0.0.1, tải 2 đến 3 mô hình Apache 2.0 hoặc MIT và kiểm tag không phải ":cloud"; chạy bộ mẫu, rồi chạy cùng bộ mẫu trên 1 mô hình đám mây; thử tải đồng thời.
- Ngày 11 đến 14 (quyết định): quét cổng, kiểm xác thực qua reverse proxy; tính chi phí theo khung 5 lớp; quyết định theo cây 5 câu hỏi; hẹn xem lại sau 3 tháng.
Những sai lầm thường gặp
- Cho rằng "tải được trọng số" là "mã nguồn mở" và dùng thương mại khi chưa đọc giấy phép.
- Chỉ tính tiền GPU, bỏ qua điện, nhân công, vá lỗi và dự phòng.
- Chọn mô hình theo bảng xếp hạng chung mà không thử trên tài liệu tiếng Việt của mình.
- Mở cổng Ollama hoặc vLLM ra mạng khi chưa có xác thực và tường lửa.
- Quên bộ nhớ đệm KV khi tăng ngữ cảnh hoặc số người dùng, dẫn đến hết bộ nhớ.
- Chạy tag ":cloud" mà tưởng dữ liệu vẫn nằm trên máy mình.
Điều chưa biết
Click Star không có số đo độc lập về chất lượng tiếng Việt của từng mô hình mở trên tác vụ doanh nghiệp, và chưa đọc được điểm tiếng Việt riêng trên bảng SEA-HELM. Bài không nêu giá điện hay giá GPU tại Việt Nam vì chưa có nguồn chính thức đã kiểm.
Ngày ra mắt Gemma 4 lấy từ nguồn thứ cấp, và các phân tích của Epoch AI có khoảng tin cậy rộng.
Bài liên quan



Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.