Giám sát website: uptime, nhật ký và cảnh báo để biết lỗi trước khách
Giám sát website gồm những lớp nào, 4 tín hiệu cần đo, cách ghi nhật ký và đặt cảnh báo có hành động, dựa trên sách Google SRE, OWASP và tài liệu Vercel, Supabase.
Giả sử website ngừng phục vụ lúc 2 giờ sáng. Nếu không có giám sát, người biết đầu tiên có thể là khách nhắn tin hoặc nhân viên bán hàng báo biểu mẫu không gửi được. Giám sát là việc làm cho chính hệ thống báo lỗi trước khi người ngoài báo.
Bài này trình bày giám sát gồm những lớp nào, 4 tín hiệu nên theo dõi theo sách Google SRE, cách ghi nhật ký (log) mà không ghi thừa dữ liệu nhạy cảm, và cách đặt cảnh báo ít nhưng có người hành động. Nguồn gồm sách Google SRE, tài liệu của Google, Vercel, Supabase, OWASP và DORA, đối chiếu ngày 23/10/2026.
Click Star đã có bài riêng về sao lưu và khôi phục (RPO, RTO), webhook, CI/CD và bảo mật website; bài này tập trung vào việc biết website đang hỏng. Bài không nêu giá dịch vụ giám sát nào.
Điểm chính
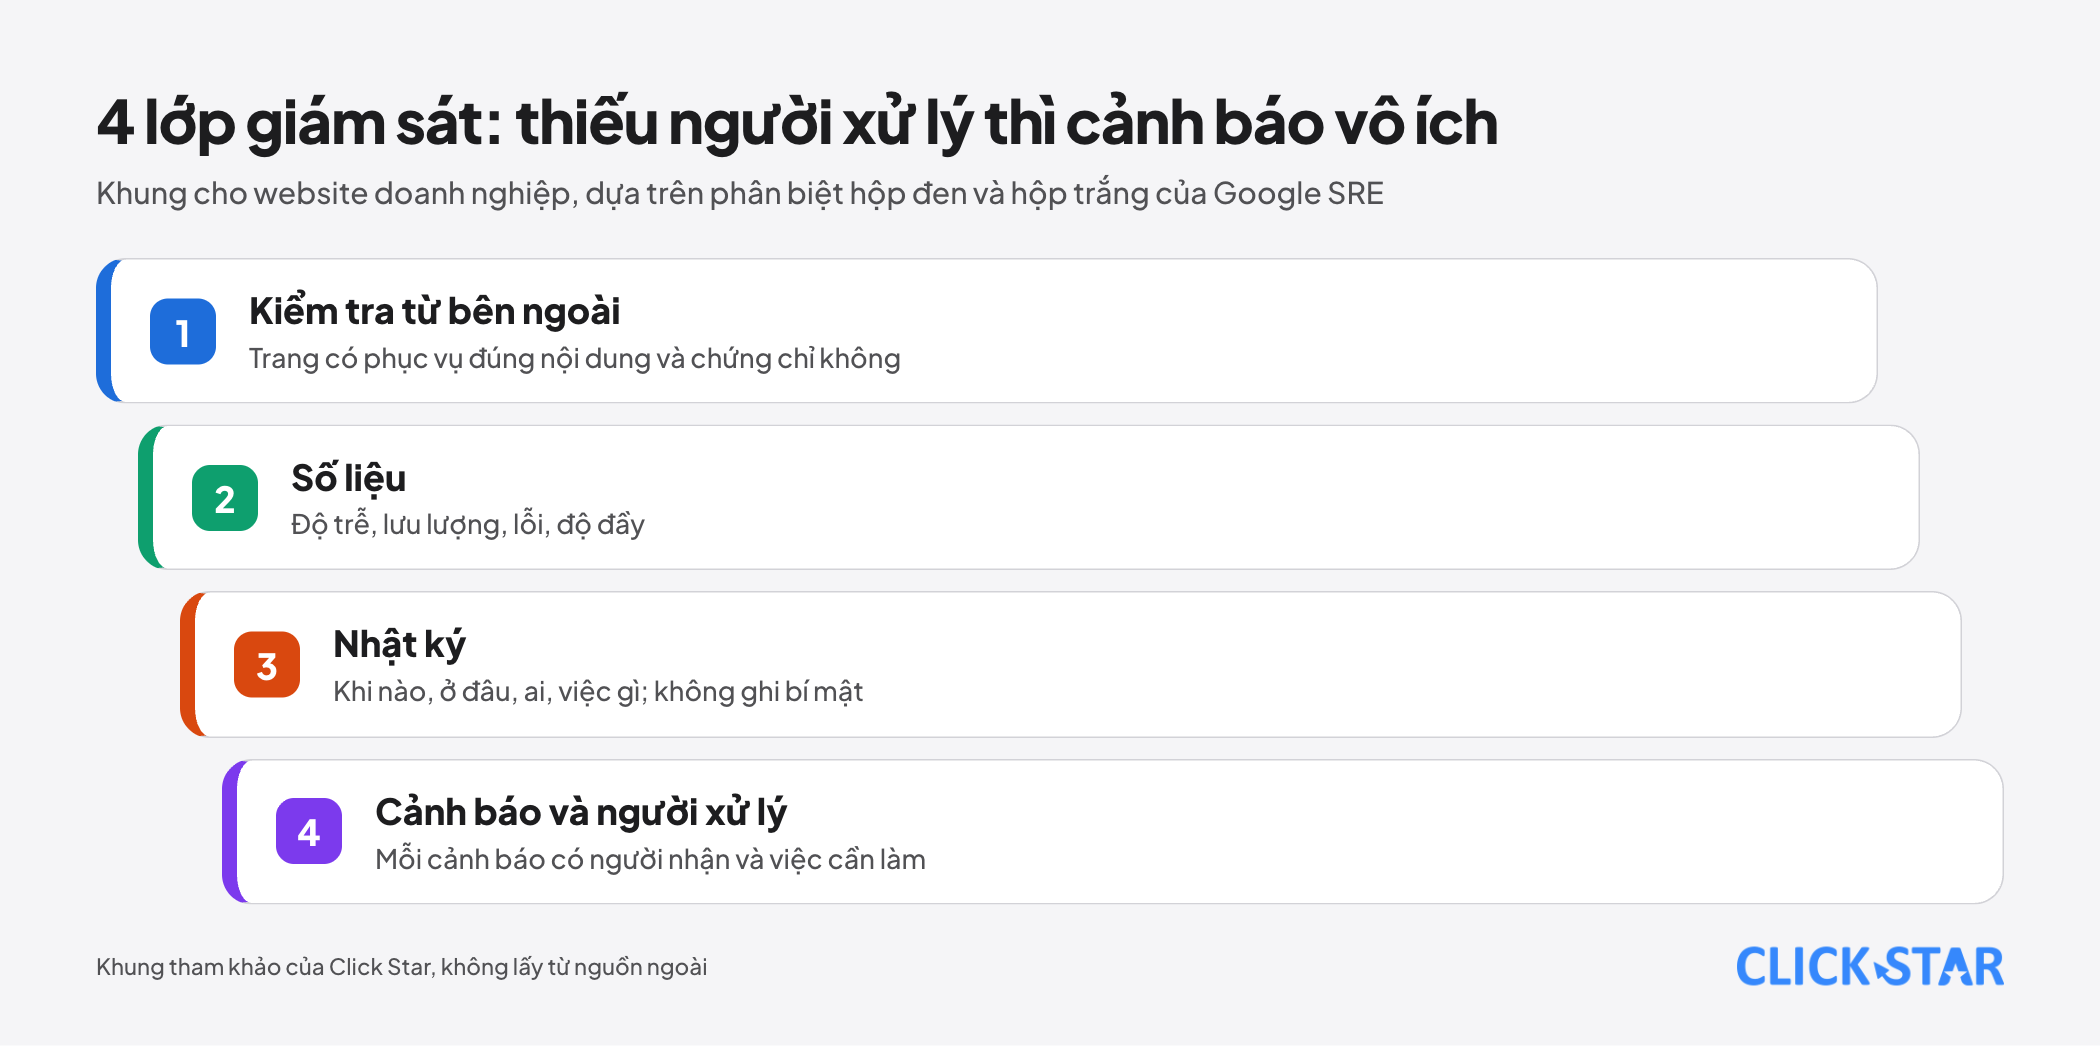
- Giám sát gồm 4 lớp trong khung của Click Star: kiểm tra từ bên ngoài, số liệu, nhật ký, và cảnh báo kèm người xử lý. Thiếu lớp cuối thì 3 lớp đầu chỉ là những màn hình không ai nhìn.
- Sách Google SRE chọn 4 tín hiệu: độ trễ, lưu lượng, lỗi và độ đầy. Cảnh báo nên bám triệu chứng người dùng thấy; nguyên nhân dùng để chẩn đoán.
- Mã 200 chưa chắc là khỏe: sách nêu lỗi có thể là trang trả 200 nhưng sai nội dung. Kiểm tra từ bên ngoài cần so khớp nội dung và hạn chứng chỉ.
- Nhật ký nên có cấu trúc, ghi đủ khi nào, ở đâu, ai, việc gì; theo OWASP thường không ghi trực tiếp mật khẩu, token, dữ liệu thẻ hay dữ liệu cá nhân nhạy cảm.
- Theo tài liệu Vercel (cập nhật 28/8/2026), nhật ký chạy gói Hobby giữ 1 giờ và gói Pro giữ 1 ngày; muốn điều tra sự cố cũ thường cần nơi lưu ngoài nền tảng.
- Google SRE đề nghị mỗi cảnh báo đánh thức người phải hành động được; quá nhiều cảnh báo khiến người trực bỏ qua cả cảnh báo thật.
Giám sát website gồm những lớp nào
Theo chương 6 sách Google SRE (bản 1, 2016), giám sát là thu thập, xử lý và hiển thị dữ liệu định lượng theo thời gian thực về hệ thống, như số yêu cầu, số lỗi, thời gian xử lý. Sách phân biệt giám sát hộp đen (kiểm tra hành vi nhìn từ ngoài như người dùng) với hộp trắng (dựa trên số liệu và nhật ký bên trong).
Hộp đen báo vấn đề đang xảy ra; hộp trắng giúp thấy vấn đề sắp xảy ra và lỗi bị che bởi cơ chế thử lại.
Từ đó Click Star dùng khung 4 lớp (khung tham khảo của Click Star, không lấy từ nguồn ngoài): kiểm tra từ bên ngoài, số liệu, nhật ký, cảnh báo cùng người xử lý. Lớp cuối dễ bị bỏ quên: cảnh báo gửi vào hộp thư không ai đọc thì không khác gì không có.
4 tín hiệu vàng: nên đo gì trước
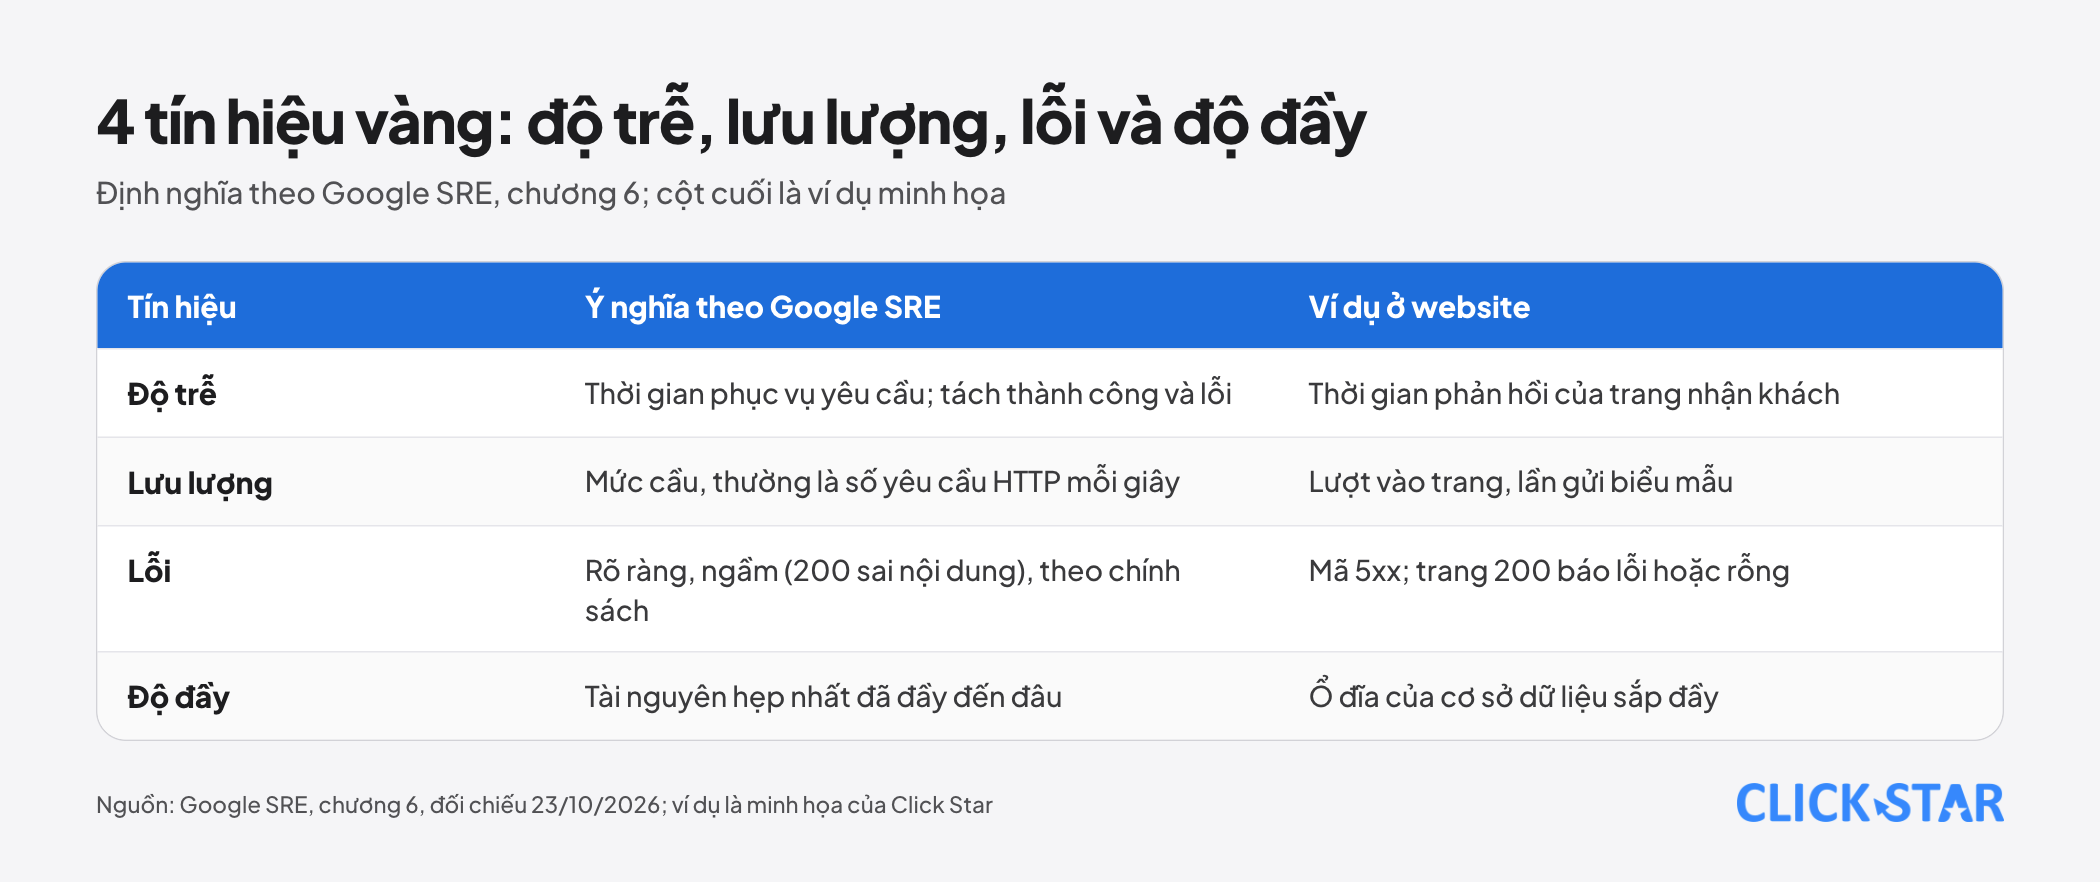
Nếu chỉ đo được 4 chỉ số cho hệ thống hướng tới người dùng, sách Google SRE chọn độ trễ, lưu lượng, lỗi và độ đầy (saturation).
Độ trễ nên tách yêu cầu thành công khỏi yêu cầu lỗi, vì lỗi 500 có thể trả về rất nhanh và làm phép tính độ trễ sai lệch; lỗi chậm còn tệ hơn lỗi nhanh. Lưu lượng là mức cầu đặt lên hệ thống, với website thường là số yêu cầu HTTP mỗi giây.
Lỗi gồm 3 loại: rõ ràng (như 500), ngầm (mã 200 nhưng sai nội dung) và theo chính sách (đã cam kết phản hồi trong 1 giây thì quá 1 giây là lỗi). Lỗi ngầm chỉ lộ ra khi kiểm tra từ đầu đến cuối.
Độ đầy cho biết tài nguyên hẹp nhất đã đầy đến đâu; sách lấy ví dụ cảnh báo ổ đĩa của cơ sở dữ liệu sẽ đầy sau 4 giờ nữa.
Sách cảnh báo đừng dựa vào số trung bình: dịch vụ có độ trễ trung bình 100 mili giây ở 1.000 yêu cầu mỗi giây vẫn có thể có 1% yêu cầu mất 5 giây.
Sách cũng tách triệu chứng khỏi nguyên nhân: "trả lỗi 500" là triệu chứng, "cơ sở dữ liệu từ chối kết nối" là nguyên nhân. Cảnh báo nên bám triệu chứng, còn nguyên nhân dành cho bảng chẩn đoán.
Kiểm tra từ bên ngoài và dữ liệu người dùng thật
Cả 2 cách này trả lời 2 câu hỏi khác nhau: "trang có phục vụ được không" và "khách thật trải nghiệm ra sao".
Tài liệu Create public uptime checks của Google Cloud (cập nhật 22/10/2026) là ví dụ về chức năng, không phải khuyến nghị sản phẩm. Kiểm tra gửi yêu cầu HTTP, HTTPS hoặc TCP định kỳ từ nhiều vị trí; thành công khi mã HTTP khớp tiêu chí và, nếu bật so khớp nội dung, phản hồi chứa nội dung yêu cầu.
Với HTTPS, công cụ mặc định xác thực chứng chỉ (hết hạn, tự ký hoặc sai tên miền thì báo hỏng) và có số liệu để cảnh báo trước ngày hết hạn. Kiểm tra không tải tài nguyên trang hay chạy JavaScript.
Website ít khách có bài toán riêng. Theo sách Google SRE Workbook (chương Alerting on SLOs, in 2018), hệ thống nhận 10 yêu cầu mỗi giờ thì 1 yêu cầu lỗi đã là 10% tỷ lệ lỗi của giờ đó. Sách gợi ý tạo lưu lượng nhân tạo, nhưng cảnh báo mặt trái: yêu cầu nhân tạo thành công có thể che lỗi chỉ khách thật gặp.
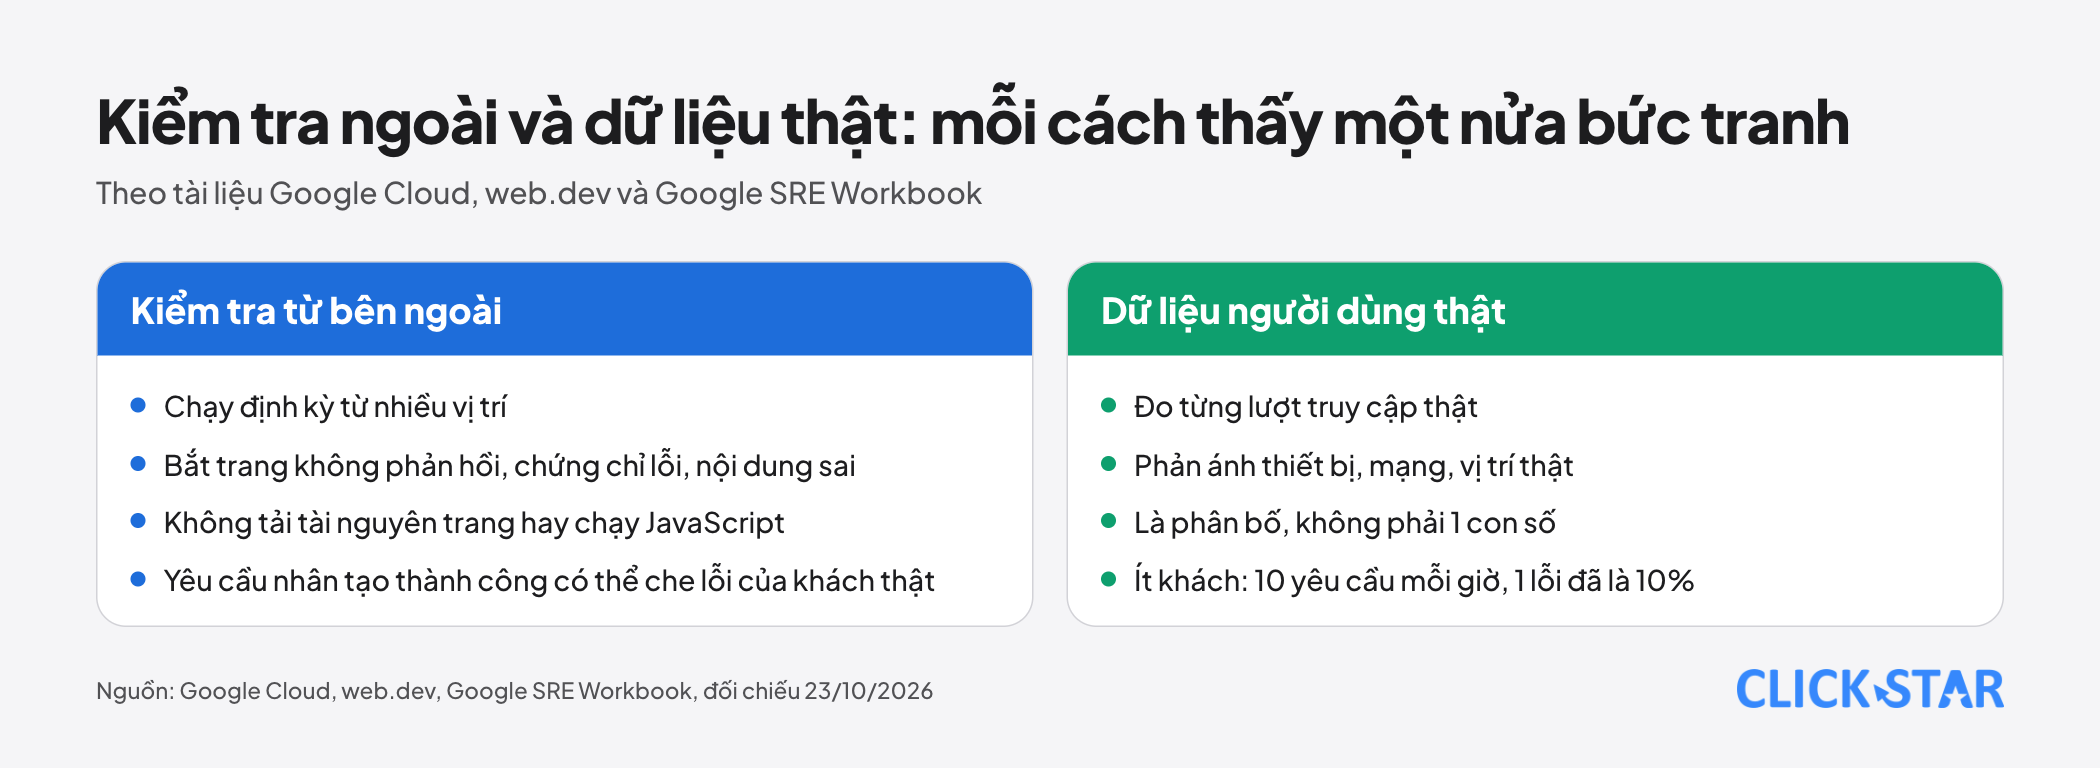
Theo web.dev (cập nhật 18/7/2022), dữ liệu người dùng thật (field data, hay RUM) đo từng lượt truy cập nên phản ánh thiết bị, mạng, vị trí thật, và là 1 phân bố chứ không phải 1 con số. Dữ liệu phòng thí nghiệm chạy trên 1 thiết bị, 1 mạng, 1 vị trí và hợp để gỡ lỗi.
Lưu ý (suy luận của Click Star): lượt kiểm tra tự động lẫn vào số liệu truy cập nếu không gắn nhãn (OWASP khuyên gắn nhãn, không loại bỏ), và biểu mẫu thử sẽ tạo khách giả trong CRM.
Google thấy sự cố của website thế nào
Theo tài liệu How HTTP Status Codes Affect Google's Crawlers (Google Crawling Infrastructure, cập nhật 4/2/2026), mã 5xx và 429 khiến trình thu thập tạm giảm tốc độ; URL liên tục trả lỗi máy chủ bị loại khỏi chỉ mục; khi máy chủ trả 2xx trở lại, tốc độ thu thập tăng dần. Trang trả 200 nhưng là thông báo lỗi hoặc rỗng có thể bị ghi là soft 404.
Nhật ký (log): ghi gì và đừng ghi gì
Theo Logging Cheat Sheet của OWASP (không ghi ngày, đọc 23/10/2026), mỗi dòng nhật ký nên trả lời "khi nào, ở đâu, ai, việc gì", kèm mã tương tác nối các sự kiện của 1 yêu cầu. Nên ghi đăng nhập, lỗi phân quyền, lỗi ứng dụng và hệ thống, thay đổi cấu hình; làm theo danh sách kiểm máy móc dẫn đến "alarm fog" làm vấn đề thật chìm đi.
Để chống chèn dòng giả (log injection), OWASP khuyên dùng định dạng có cấu trúc như JSON và giới hạn độ dài giá trị người dùng nhập. Ví dụ minh họa của Click Star, không phải định dạng bắt buộc:
{"time":"2026-10-23T08:15:02Z","level":"error","route":"/api/lead","status":500,"actor":"anon","request_id":"req-8f21","message":"CRM timeout"}
OWASP liệt kê những thứ thường không nên ghi trực tiếp mà cần xóa, che, băm hoặc mã hóa: mật khẩu, token truy cập, mã phiên, chuỗi kết nối cơ sở dữ liệu, khóa mã hóa, dữ liệu thẻ, dữ liệu cá nhân nhạy cảm. Tên, số điện thoại, email có thể cần xử lý đặc biệt. Bài không nêu điều luật Việt Nam; hãy đối chiếu văn bản gốc.
Giới hạn của nền tảng, theo tài liệu hiện hành:
- Vercel Runtime Logs (cập nhật 28/8/2026) giữ Hobby 1 giờ, Pro 1 ngày, Pro có Observability Plus 30 ngày (xem tối đa 14 ngày liên tiếp), Enterprise 3 ngày. Chi tiết nhật ký gồm cả tham số tìm kiếm của URL, nên đừng đặt dữ liệu cá nhân vào URL.
- Vercel Drains (cập nhật 1/9/2026, gói Pro và Enterprise) chuyển nhật ký sang dịch vụ ngoài để lưu lâu. Supabase có log drains cho gói Pro, Team và Enterprise; thời gian giữ phụ thuộc gói.
Cảnh báo ít nhưng có hành động
Theo chương 6, đánh thức 1 người là việc tốn kém; khi cảnh báo dồn dập, người trực lướt qua hoặc bỏ qua, kể cả cảnh báo thật. Sách khuyên không bao giờ bật cảnh báo chỉ vì "có vẻ hơi lạ" (trừ kiểm toán bảo mật ở phạm vi rất hẹp). Câu hỏi trước khi tạo luật cảnh báo, Click Star rút gọn:
- Luật có phát hiện tình trạng khẩn cấp, hành động được và đang hoặc sắp ảnh hưởng người dùng không?
- Có trường hợp lành tính nào khiến luật kêu mà người dùng không bị ảnh hưởng không?
- Người nhận có làm được gì ngay không, hay việc đó chờ đến sáng được?
Sách thêm: nếu phản ứng chỉ là thao tác máy móc thì không nên là cảnh báo đánh thức người.
Với đội có mục tiêu độ tin cậy (SLO), Workbook mô tả cách báo động theo tốc độ tiêu hao ngân sách lỗi. Sách nói nhiều tham số khiến luật khó quản lý; Click Star thấy doanh nghiệp nhỏ chưa cần bắt đầu từ đây.
Người trực và quy trình xử lý sự cố
Chương Managing Incidents của sách Google SRE chia 4 vai: điều phối, thao tác kỹ thuật, liên lạc và lên kế hoạch. Chỉ nhóm thao tác được đổi hệ thống trong sự cố, và chỉ huy sự cố khi đổi người phải bàn giao rõ ràng, có xác nhận.
Đội nhỏ có thể để 1 người giữ nhiều vai, miễn có tên người cho từng vai trước khi sự cố xảy ra. Khung 5 bước của Click Star: phát hiện, xác nhận, giảm thiểu, thông báo, hậu kiểm.
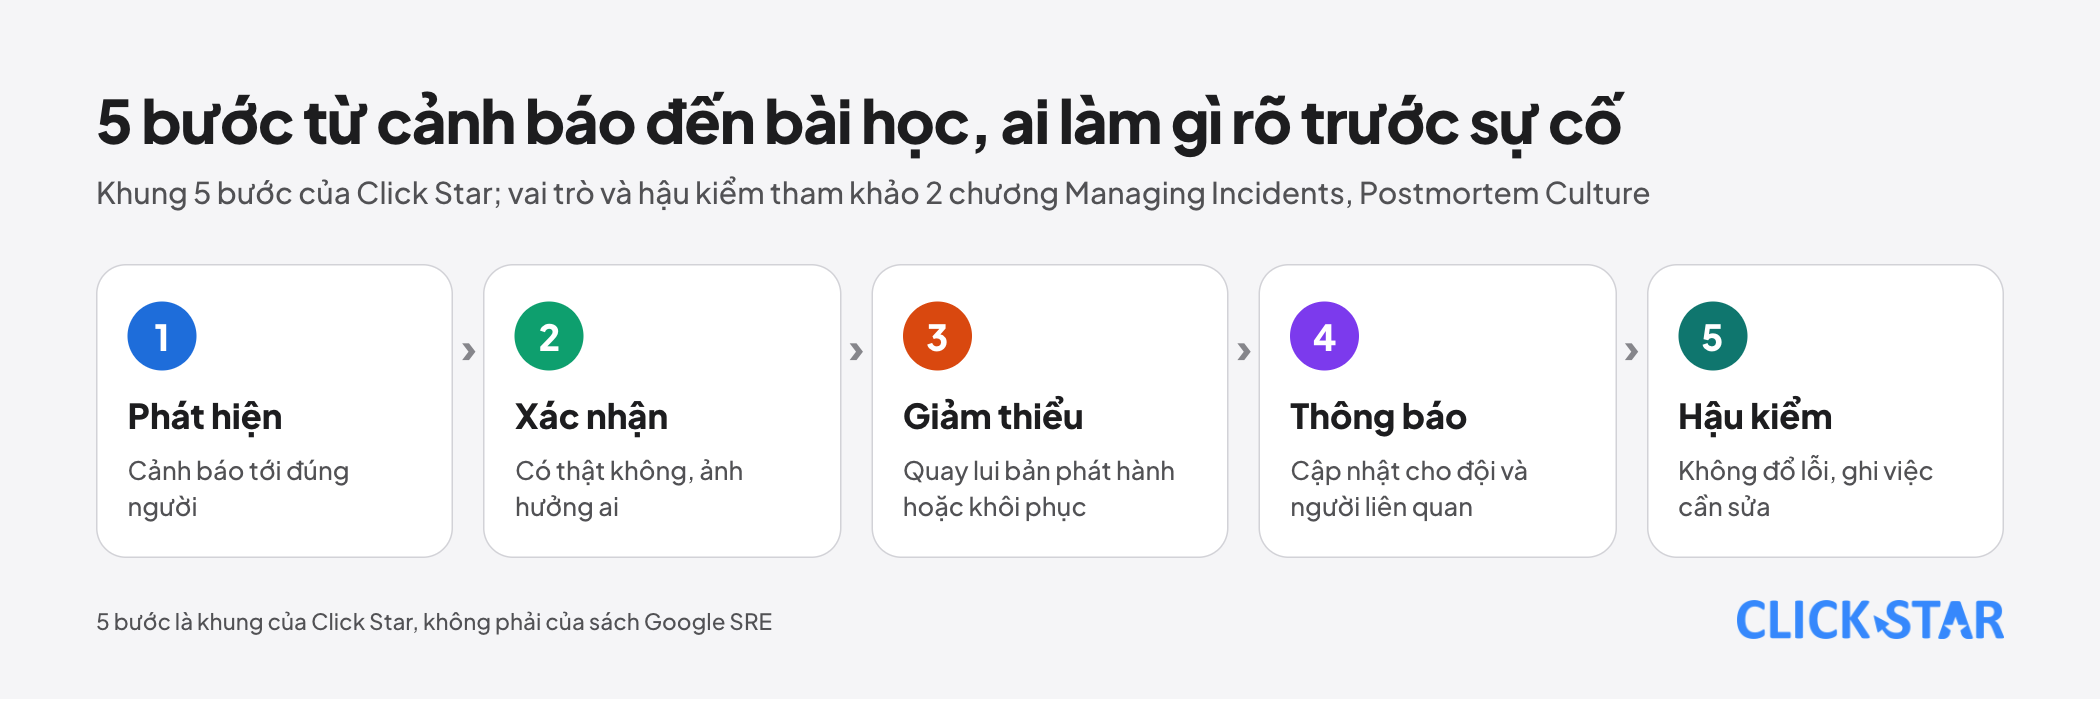
Chương Postmortem Culture khuyên viết hậu kiểm không đổ lỗi và đặt điều kiện kích hoạt từ trước, như mất dữ liệu, kỹ sư phải can thiệp (quay lui bản phát hành), thời gian xử lý vượt ngưỡng, và lỗi giám sát (thường nghĩa là sự cố được phát hiện thủ công).
Nếu khách báo trước hệ thống, đó là 1 tín hiệu cần sửa (suy luận của Click Star).
Với doanh nghiệp Việt Nam: bắt đầu từ đâu
Khung dưới đây là của Click Star, không lấy từ nguồn ngoài. Lỗi ở biểu mẫu, đặt lịch hay thanh toán đáng ưu tiên hơn lỗi ở trang giới thiệu vì đó là nơi nhận khách (suy luận).
- Mức 1, tối thiểu: kiểm tra từ bên ngoài cho trang chủ và trang nhận khách (có so khớp nội dung), cảnh báo chứng chỉ sắp hết hạn, báo tới ít nhất 2 người.
- Mức 2, vừa: thêm nơi lưu nhật ký ngoài nền tảng, bảng 4 tín hiệu, cảnh báo tỷ lệ lỗi, dữ liệu người dùng thật.
- Mức 3, nâng cao: có SLO, lịch trực, diễn tập và hậu kiểm bắt buộc sau sự cố đạt điều kiện.
Đánh giá của Click Star. Giám sát có hiệu quả khi nó đổi được hành vi của đội: ai nhận báo, làm gì, trong bao lâu. Công cụ không thay được việc đó, và cảnh báo nhiều không đồng nghĩa với an toàn.
Điểm khởi đầu hợp lý là mức 1 cho đường dẫn tạo khách. Click Star làm dịch vụ thiết kế website chuẩn SEO tải nhanh, phần mềm theo yêu cầu và dashboard dữ liệu, nên có lợi ích liên quan đến chủ đề này.
Lộ trình 30 ngày và cách đo
Khung tham khảo của Click Star, không lấy từ nguồn ngoài:
- Tuần 1: liệt kê 3 đến 5 đường dẫn sống còn, chọn người nhận báo và người dự phòng, lập kiểm tra từ bên ngoài có so khớp nội dung và hạn chứng chỉ.
- Tuần 2: xác định nơi xem nhật ký, thời gian giữ, cách xuất ra ngoài; rà nhật ký để loại dữ liệu cá nhân và bí mật.
- Tuần 3: đặt cảnh báo cho triệu chứng (tỷ lệ lỗi, đường dẫn tạo khách) và viết hướng dẫn xử lý 1 trang cho mỗi cảnh báo.
- Tuần 4: diễn tập 1 sự cố giả, đo thời gian từ lỗi đến có người xử lý, cắt cảnh báo không hành động được.
Cách đo (cũng là khung của Click Star): thời gian phát hiện, thời gian khôi phục từng sự cố, tỷ lệ sự cố do khách báo trước hệ thống, và số cảnh báo mỗi tuần cùng tỷ lệ cần hành động.
Với sự cố do bản phát hành lỗi, DORA (cập nhật 5/1/2026) đo thời gian khôi phục sau triển khai lỗi, thay cho chỉ số MTTR cũ.
Những sai lầm thường gặp
- Chỉ kiểm tra "máy chủ có trả lời không" mà không so khớp nội dung hay đi qua biểu mẫu.
- Báo động theo nguyên nhân chưa chắc ảnh hưởng người dùng (CPU cao) thay vì triệu chứng người dùng thấy.
- Dựa vào số trung bình, bỏ sót phần đuôi chậm.
- Gửi mọi cảnh báo về 1 kênh chung không ai nhận trách nhiệm.
- Không biết nhật ký giữ bao lâu, đến khi cần điều tra thì đã mất.
- Ghi vào nhật ký mật khẩu, token, dữ liệu thẻ hay thông tin cá nhân của khách.
- Không diễn tập, nên lần đầu đọc hướng dẫn xử lý là lúc sự cố thật.
Điều chưa biết
Click Star chưa có số đo công khai về tần suất, thời gian và thiệt hại của sự cố website ở doanh nghiệp Việt Nam, cũng như mức áp dụng giám sát.
Khung 4 lớp, 3 mức và lộ trình 30 ngày là đề xuất của Click Star. Sách Google SRE viết cho hệ thống quy mô lớn; Click Star chưa có nguồn công khai về áp nguyên tham số vào website nhỏ, và chưa đọc tài liệu giám sát của nền tảng ngoài Vercel, Supabase và Google Cloud.
Bài liên quan


Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.