Giao phần mềm xong mới thấy lỗi? Kiểm thử tự động nên bắt đầu từ đâu
Bài giải thích 3 tầng kiểm thử, cách chọn việc kiểm theo rủi ro, chạy trong CI và xử lý bài lúc đạt lúc không, dựa trên Martin Fowler, Google Testing Blog và tài liệu Playwright.
Công ty nọ nhận bản cập nhật website từ đơn vị làm phần mềm. 2 tuần sau, phòng kinh doanh mới thấy biểu mẫu liên hệ không còn lưu số điện thoại của khách. Đây là tình huống giả định, nhưng kiểu lỗi này quen thuộc: không ai sửa biểu mẫu, lỗi đến từ thay đổi ở chỗ khác.
Kiểm thử tự động là các bài kiểm tra viết sẵn để máy chạy lại mỗi khi mã thay đổi và báo đạt hay không đạt. Bài này giải thích 3 tầng kiểm thử, cách chọn việc kiểm trước và cách chạy tự động. Nguồn là tài liệu Playwright, Vitest, GitHub, các bài của Martin Fowler và Google Testing Blog, đối chiếu đến ngày 24/10/2026.
Click Star đã có bài riêng về CI/CD, môi trường preview và làm phần mềm theo yêu cầu; bài này đi vào kiểm thử.
Điểm chính
- Theo Fowler, kiểm thử tự động giá trị nhất ở chỗ bắt lỗi hồi quy: lỗi làm hỏng thứ vốn đang chạy đúng.
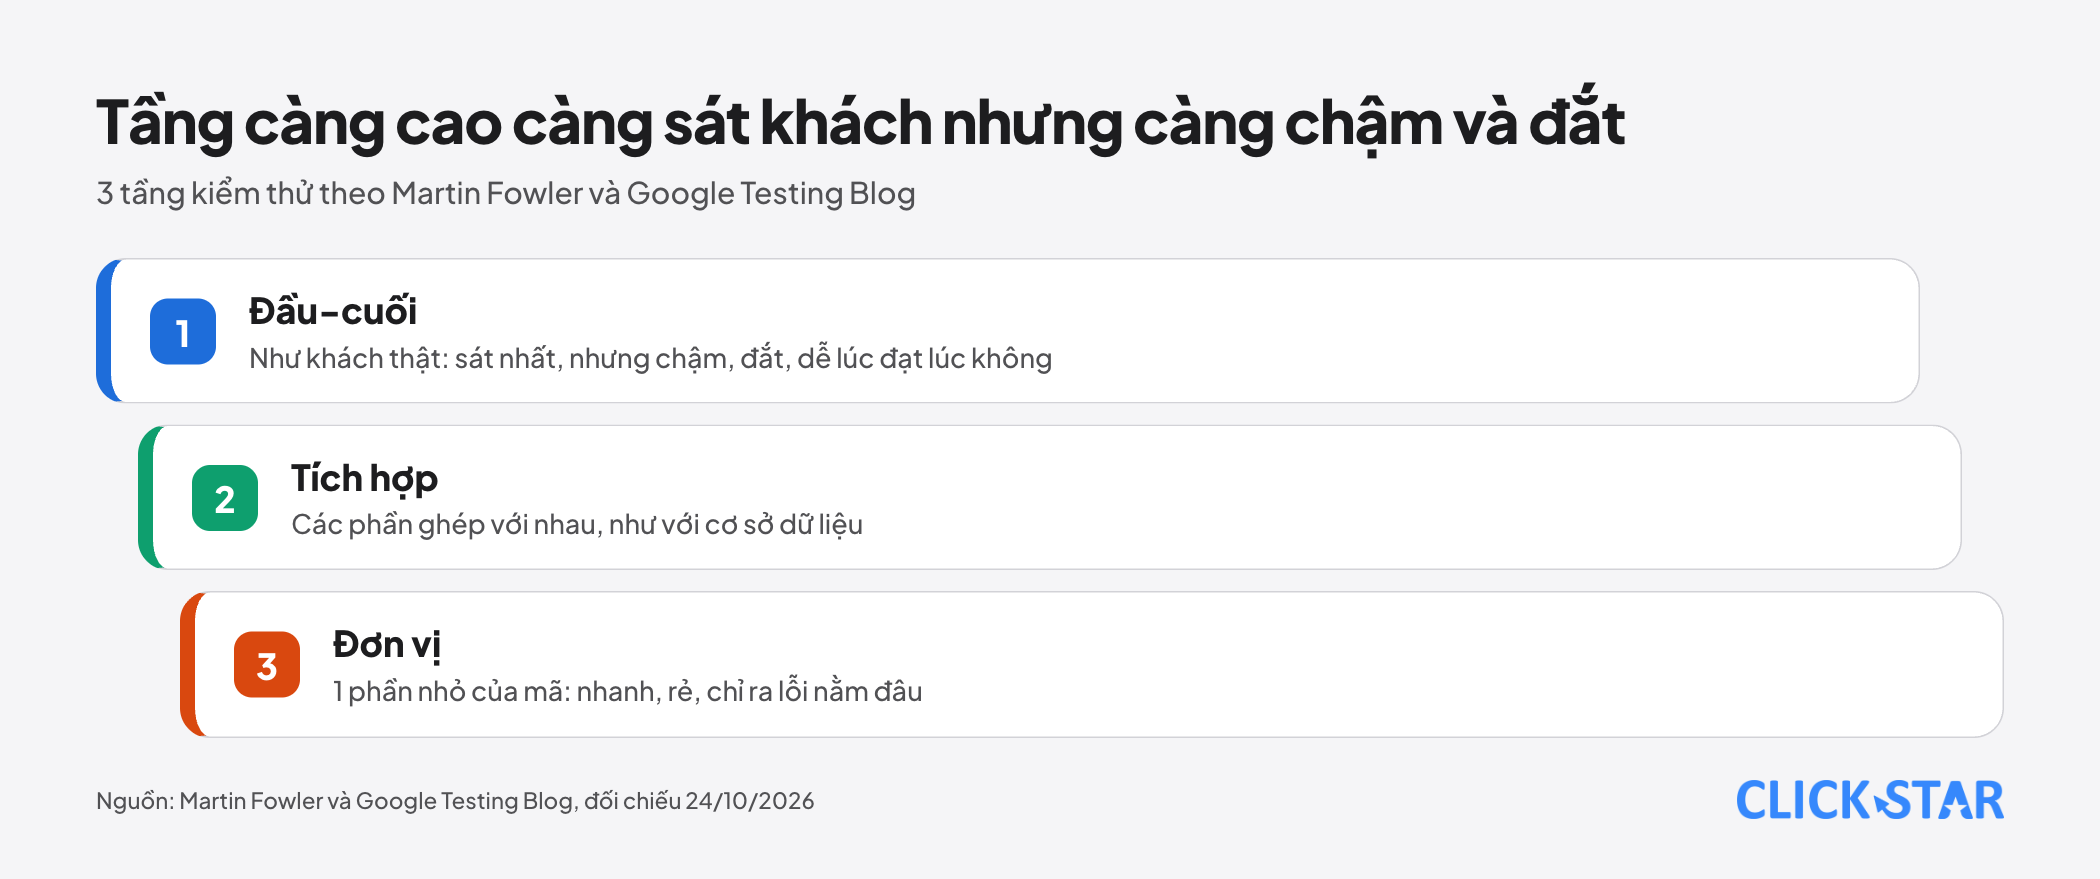
- Có 3 tầng: đơn vị (một phần nhỏ của mã), tích hợp (các phần ghép với nhau) và đầu-cuối (cả hệ thống như khách dùng). Tầng càng cao càng sát thực tế nhưng càng chậm, đắt, dễ lúc đạt lúc không.
- Tỷ lệ 70/20/10 chỉ là phỏng đoán ban đầu Google từng nêu năm 2015, không phải chuẩn. Hãy chọn theo rủi ro: đăng nhập, thanh toán, biểu mẫu nhận khách đi trước.
- Chạy bộ kiểm thử trong CI (hệ thống tự chạy mỗi khi mã đổi): bài nhanh chạy trước, có giới hạn thời gian.
- Bài lúc đạt lúc không (flaky) làm cả bộ mất uy tín. Hãy tách riêng và sửa trong thời hạn, đừng chỉ chạy lại.
- Dùng dữ liệu thử, không dùng dữ liệu khách thật. Độ phủ mã giúp tìm chỗ chưa kiểm, không phải điểm số để đạt.
Kiểm thử tự động khác bấm thử bằng tay ở đâu?
Thay vì 1 người bấm qua từng màn hình sau mỗi lần cập nhật, máy làm việc đó thay. Theo bài "The Practical Test Pyramid" của Ham Vocke trên trang Martin Fowler (26/2/2018), nhờ vậy nhóm biết phần mềm có hỏng hay không trong vài giây hoặc vài phút, thay vì vài ngày hoặc vài tuần.
Martin Fowler (14/4/2011) xem giá trị lớn nhất là kiểm thử hồi quy (regression test) và gọi bộ kiểm thử này là "máy dò lỗi": khi nó báo đỏ, lỗi vừa lọt vào cùng những thay đổi còn mới nên dễ tìm, và nhóm dám sửa mã lớn hơn.
3 tầng kiểm thử khác nhau thế nào?
Hình dung kiểm tra 1 chiếc xe: thử riêng phanh là đơn vị, thử phanh cùng bánh xe là tích hợp, lái cả quãng đường là đầu-cuối.
Đơn vị (unit test) kiểm tra 1 phần nhỏ của mã, tách riêng, như hàm tính giá sau giảm. Martin Fowler (5/5/2014) viết rằng chữ "unit" không có định nghĩa chặt, nhưng thường có 3 điểm chung: nhỏ, do lập trình viên viết, và chạy nhanh hơn hẳn các loại khác.
Tích hợp (integration test) kiểm tra phần mềm ghép đúng với thứ bên ngoài như cơ sở dữ liệu. Theo Vocke, muốn thử việc đọc ghi dữ liệu thì phải chạy 1 cơ sở dữ liệu thật.
Đầu-cuối (end-to-end) điều khiển trình duyệt như khách thật: mở trang, bấm, nhập, kiểm kết quả. Theo Vocke, loại này cho mức yên tâm lớn nhất, nhưng nổi tiếng hay lúc đạt lúc không vì trình duyệt, thời gian chờ và hộp thoại bất ngờ.
Có phải cứ nhiều bài đơn vị, ít bài đầu-cuối là đúng?
Phần lớn là đúng, kèm điều kiện. Mike Wacker (Google Testing Blog, 22/4/2015) cho rằng vòng phản hồi tốt phải nhanh, đáng tin và chỉ ra được lỗi nằm đâu. Bài đơn vị đáp ứng cả 3; bài đầu-cuối phải đợi cả hệ thống dựng xong mới chạy và khó chỉ ra lỗi nằm đâu.
Wacker viết rằng Google thường gợi ý tỷ lệ 70% đơn vị, 20% tích hợp, 10% đầu-cuối làm phỏng đoán đầu tiên, và mỗi nhóm sẽ khác.
Fowler (đăng 1/5/2012, có sửa sau đó) thêm ngoại lệ: tháp giả định bài tầng cao chậm, đắt, dễ vỡ. Nếu chúng nhanh, đáng tin và rẻ để sửa thì chưa cần nhiều bài tầng thấp.
Nên kiểm cái gì trước?
Hãy bắt đầu từ chỗ lỗi làm mất tiền hoặc mất khách nhanh nhất, không phải chỗ dễ viết nhất. Google Testing Blog (7/8/2020) nói mức kiểm thử cần có phụ thuộc vào tác động kinh doanh của mã, mức độ mã hay bị sửa và tuổi thọ của mã.
Vocke khuyên giữ bài đầu-cuối ở mức tối thiểu, dành cho hành trình cốt lõi. Dưới đây là khung tham khảo của Click Star, không lấy từ nguồn ngoài.
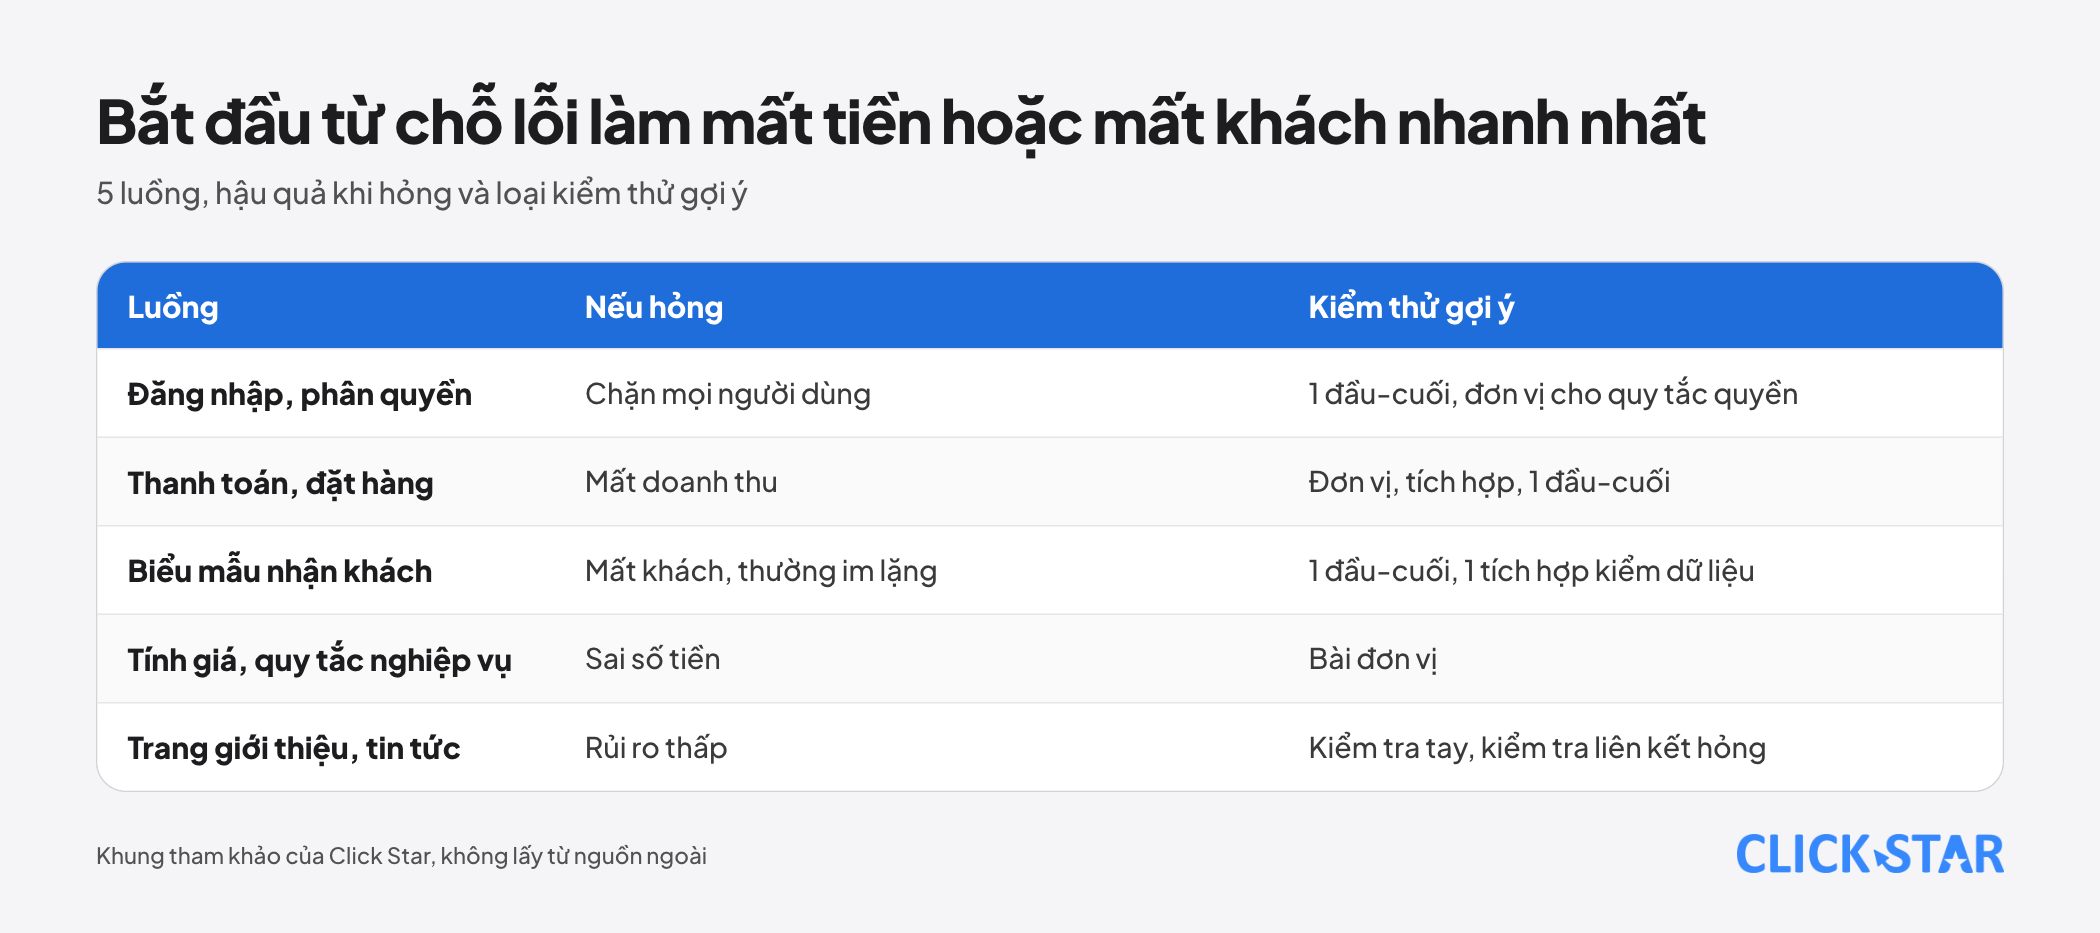
- Đăng nhập và phân quyền: lỗi chặn mọi người dùng. Gợi ý: 1 bài đầu-cuối cho đường chính, bài đơn vị cho quy tắc quyền.
- Thanh toán và đặt hàng: lỗi mất doanh thu. Gợi ý: bài đơn vị cho phần tính tiền, bài tích hợp với môi trường thử của cổng thanh toán, 1 bài đầu-cuối.
- Biểu mẫu nhận khách: lỗi thường im lặng, khách tưởng đã gửi còn doanh nghiệp không nhận được gì. Gợi ý: 1 bài đầu-cuối, 1 bài tích hợp kiểm tra dữ liệu đã lưu.
- Tính giá, giảm giá, quy tắc nghiệp vụ: lỗi sai số tiền. Gợi ý: bài đơn vị.
- Trang giới thiệu, tin tức: rủi ro thấp. Gợi ý: kiểm tra tay khi sửa lớn, kiểm tra liên kết hỏng.
Bài kiểm thử đầu tiên trông như thế nào?
Tài liệu hướng dẫn thực hành của Playwright (công cụ điều khiển trình duyệt; không ghi ngày, đọc 24/10/2026) đặt nguyên tắc: kiểm hành vi người dùng nhìn thấy, không kiểm chi tiết bên trong như tên hàm, và mỗi bài phải độc lập. Ví dụ dưới đây là bài đầu-cuối cho biểu mẫu liên hệ, dùng dữ liệu giả.
import { test, expect } from '@playwright/test';
test('khách gửi biểu mẫu liên hệ thành công', async ({ page }) => {
  await page.goto('http://localhost:3000/lien-he');
  await page.getByLabel('Họ tên').fill('Khách Thử Nghiệm');
  await page.getByLabel('Số điện thoại').fill('0900000000');
  await page.getByRole('button', { name: 'Gửi' }).click();
  await expect(page.getByText('Cảm ơn bạn')).toBeVisible();
});
Nhãn, nút và địa chỉ là giả định và Click Star chưa chạy thử; hãy thay bằng trang của bạn. Chạy bài này trên bản thử, không chạy trên trang thật, vì nó tạo ra 1 khách tiềm năng. Bài này chỉ kiểm lời cảm ơn có hiện ra, chưa kiểm số điện thoại có được lưu; việc đó cần bài tích hợp.
Chạy kiểm thử tự động ở đâu và khi nào?
Hãy chạy mỗi khi mã thay đổi, trong CI (continuous integration), tức hệ thống tự build và kiểm thử khi có người đẩy mã lên kho.
Theo GitHub Docs (trang "Understanding GitHub Actions", không ghi ngày, đọc 24/10/2026), workflow là quy trình tự động mô tả trong tệp YAML, dùng được để build và kiểm thử mọi pull request (yêu cầu gộp thay đổi vào nhánh chính).
Tài liệu thực hành của Playwright viết rằng lý tưởng là chạy ở mỗi lần lưu thay đổi và mỗi pull request, trên Linux vì rẻ hơn. Trang "Continuous Integration" khuyên đặt workers bằng 1 cho ổn định, và luôn đặt globalTimeout vì mặc định lượt chạy không có giới hạn trên.
Về thứ tự, Vocke viết rằng các giai đoạn của pipeline (chuỗi bước tự động từ mã đến sản phẩm) nên chia theo tốc độ và phạm vi, không theo loại bài, nên bài nhanh chạy trước.
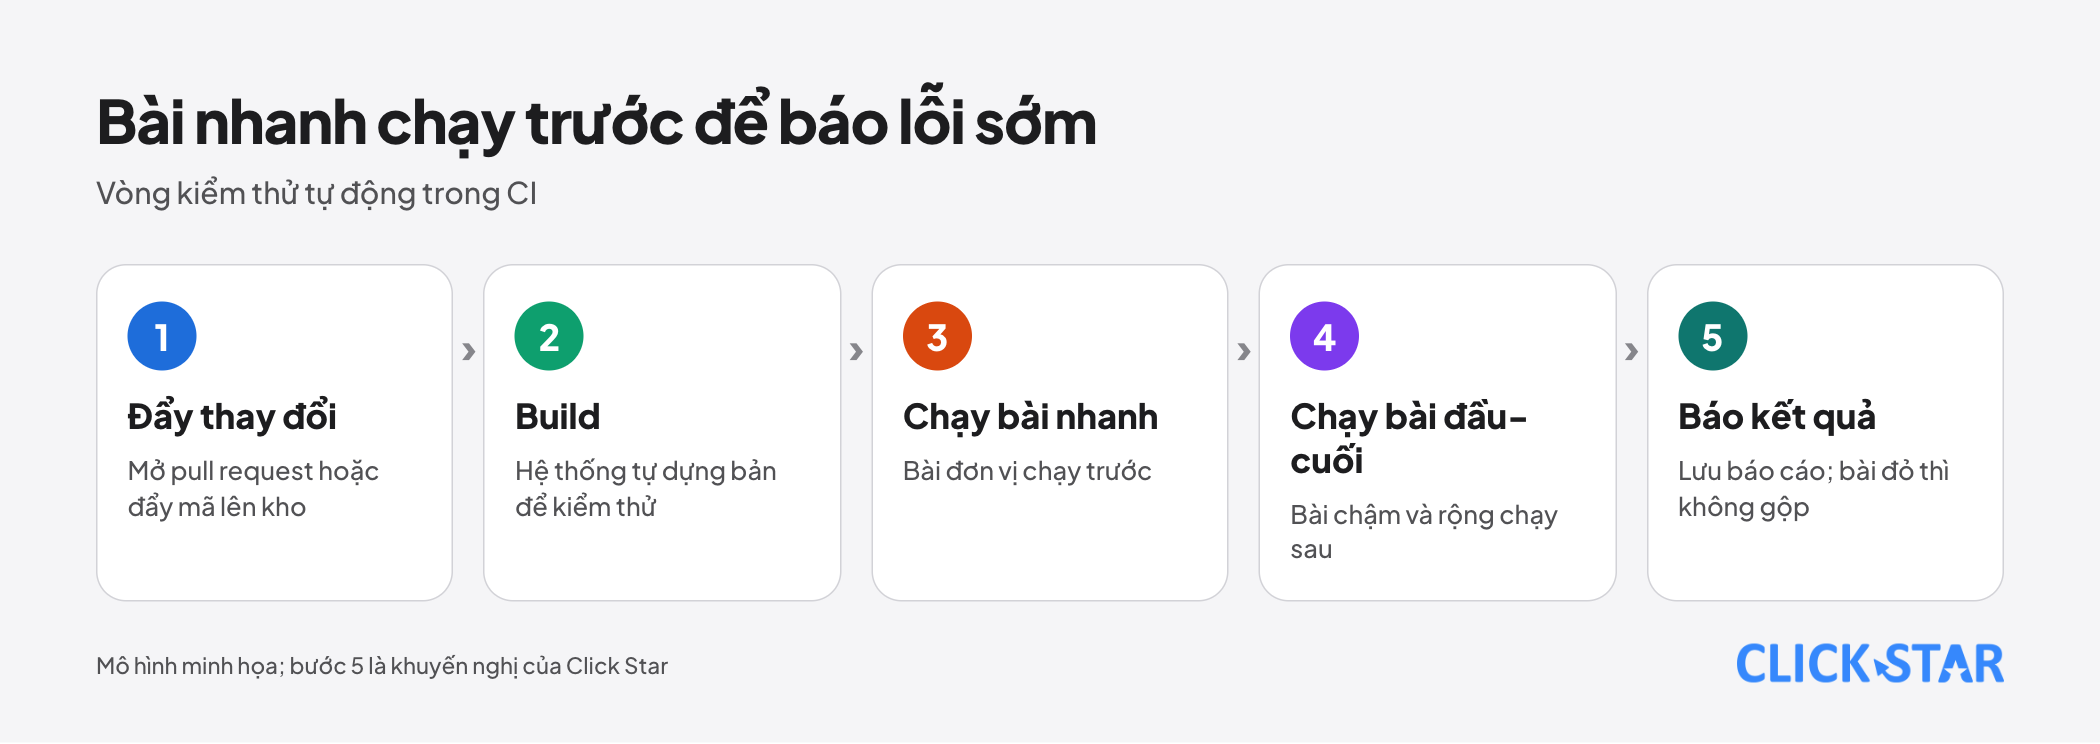
Khuyến nghị của Click Star (nhận định, không phải nguồn): cấu hình để thay đổi làm bài đỏ thì không được gộp vào nhánh chính.
Bài lúc đạt lúc không (flaky) xử lý ra sao?
Hãy tách chúng khỏi bộ chính và sửa trong thời hạn. Fowler (14/4/2011) định nghĩa bài không tất định là bài lúc đạt lúc không dù mã, bài kiểm thử và môi trường không đổi. Theo ông, loại này vô dụng và còn "lây": bộ 100 bài có 10 bài như vậy thì cả bộ thường đỏ, nhóm dần quen bỏ qua báo đỏ, kể cả khi đó là lỗi thật.
Ông đề xuất đưa chúng vào bộ riêng (quarantine) nhưng vẫn phải sửa nhanh, ví dụ đặt trần 8 bài hoặc trần 1 tuần để bài không bị bỏ quên. Ông liệt kê 5 nguyên nhân thường gặp: thiếu cô lập giữa các bài, hành vi bất đồng bộ, dịch vụ ở xa, thời gian và rò rỉ tài nguyên.
Playwright mặc định không chạy lại bài lỗi. Khi bật retries, bài lỗi lần đầu nhưng đạt khi chạy lại được xếp vào nhóm "flaky" trong báo cáo. Nhận định của Click Star: chạy lại giúp nhìn ra bài flaky, nhưng chỉ để cho xanh thì nguyên nhân vẫn còn đó; mỗi bài flaky nên là 1 việc cần sửa, có người nhận.
Dữ liệu thử và tài khoản thử
Không dùng dữ liệu khách thật trong kiểm thử. Dùng tên, số điện thoại, email giả, trong môi trường thử có dữ liệu bạn kiểm soát. Tài liệu thực hành của Playwright cũng khuyên không kiểm thử dịch vụ bên thứ ba mà mình không điều khiển được; hãy giả lập phản hồi của chúng.
Tài liệu "Authentication" của Playwright (không ghi ngày, đọc 24/10/2026) hướng dẫn lưu trạng thái đăng nhập vào tệp và thêm thư mục chứa nó vào .gitignore. Tệp này có thể chứa cookie nhạy cảm, đủ để mạo danh tài khoản thử, nên tài liệu đặc biệt khuyên không đưa nó lên kho mã.
Click Star đã có bài riêng về quản lý khóa API và bí mật. Nếu cần dữ liệu thật để tái hiện lỗi, hãy hỏi bộ phận pháp lý trước; bài này không tư vấn pháp lý.
Độ phủ mã: dùng để tìm chỗ hổng, không để đạt điểm
Độ phủ mã (code coverage) là tỷ lệ dòng hoặc nhánh mã đã được bài kiểm thử chạy qua. Google Testing Blog (7/8/2020) gọi đây là thước đo "lossy and indirect": nén nhiều thông tin vào 1 con số, nên không nên là nguồn sự thật duy nhất.
Theo bài đó, độ phủ cao không bảo đảm bài kiểm thử tốt vì nó chỉ cho biết mã đã được chạy, không cho biết đã được kiểm đúng, và không có con số lý tưởng chung. Phần lớn giá trị của nó là chỉ ra chỗ chưa được kiểm.
Google nêu hướng dẫn chung: 60% chấp nhận được, 75% đáng khen, 90% mẫu mực, nhưng tránh áp mức bắt buộc từ trên xuống. Fowler (17/4/2012) viết rằng nếu kiểm thử có suy nghĩ, ông mong độ phủ nằm ở dải gần 90% hoặc hơn và nghi ngờ con số 100%; theo ông, dưới một nửa là dấu hiệu có vấn đề.
Cả hai là gợi ý của một công ty hoặc một người, không phải chuẩn chung. Công cụ Vitest có cờ --coverage để đo và cần gói @vitest/coverage-v8, được nhắc cài tự động hoặc cài tay bằng npm i -D (trang Getting Started và Coverage của Vitest, không ghi ngày, đọc 24/10/2026).
Cách đo bộ kiểm thử có đáng tin hay không
Đừng chỉ nhìn độ phủ. Fowler (17/4/2012) nêu 2 dấu hiệu đã kiểm đủ: hiếm khi có lỗi lọt ra môi trường thật, và ít ngại sửa mã vì sợ gây lỗi. Click Star thêm 2 chỉ số (khung tham khảo riêng, không lấy từ nguồn ngoài).
- Số bài flaky và số bài đang bị cách ly: báo cáo HTML của Playwright cho lọc riêng nhóm flaky.
- Độ phủ của mã hay thay đổi: Google nói mã hay đổi cần được phủ.
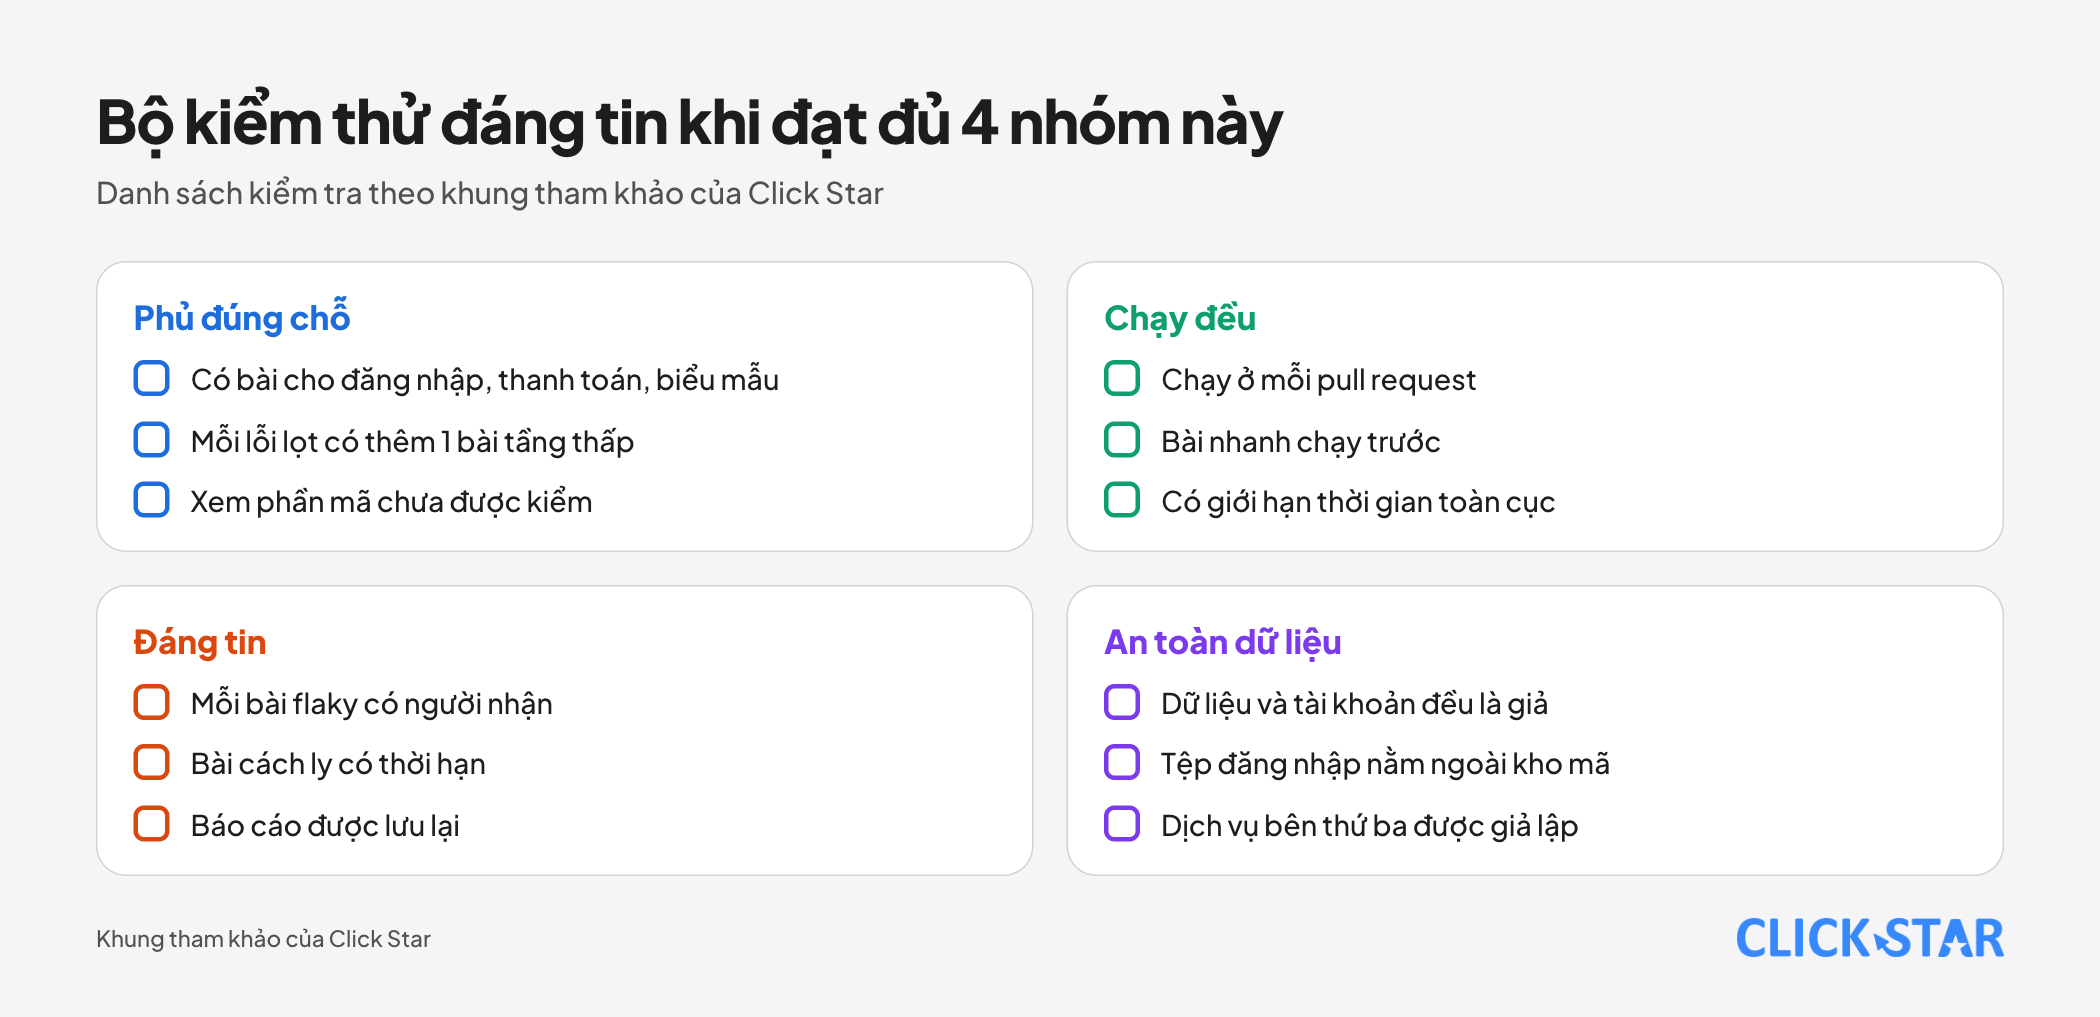
Nghiệm thu kiểm thử từ bên làm phần mềm
Đánh giá của Click Star. Đây là nhận định kỹ thuật và quản trị, không dựa trên số đo của Click Star. Click Star làm phần mềm và website theo yêu cầu, nên có lợi ích liên quan đến chủ đề này.
Với phần mềm chưa có kiểm thử, cách vào việc hợp lý là viết vài bài đầu-cuối cho các luồng sinh tiền, rồi mỗi khi bài tầng cao bắt được lỗi, viết thêm 1 bài đơn vị tái hiện lỗi đó trước khi sửa, như Fowler khuyên trong bài Test Pyramid.
Khi nghiệm thu phần mềm từ bên làm thuê, hãy hỏi 4 điều: luồng nào đã có kiểm thử, chạy ở đâu và khi nào, ai sửa khi bài đỏ, báo cáo gần nhất ra sao. Đòi mức độ phủ cố định trong hợp đồng dễ khiến bên làm viết bài cho đủ số.
Việc nên làm trong 30 ngày đầu (khung tham khảo của Click Star)
- Tuần 1: liệt kê 3 đến 5 luồng sinh tiền hoặc sinh khách; dựng môi trường thử có dữ liệu giả.
- Tuần 2: viết 1 bài đầu-cuối cho mỗi luồng.
- Tuần 3: đưa bộ kiểm thử vào CI, chạy ở mỗi pull request, đặt
globalTimeout, lưu báo cáo. - Tuần 4: rà bài flaky, đặt người nhận từng bài; thêm bài đơn vị cho phần tính tiền; chốt các chỉ số đo.
Những sai lầm thường gặp
- Dồn toàn bộ vào bài đầu-cuối vì chúng "giống khách thật", rồi chịu bộ kiểm thử chậm và hay đỏ ngẫu nhiên.
- Coi tỷ lệ 70/20/10 hay mức 60%, 75%, 90% độ phủ là chuẩn, trong khi nguồn gọi đó là phỏng đoán ban đầu hoặc hướng dẫn để mỗi nhóm tự chọn.
- Đặt mục tiêu độ phủ cao rồi viết bài không có phép kiểm chỉ để lấy số.
- Chạy bài đầu-cuối trên trang thật hoặc bằng dữ liệu khách thật.
- Bật chạy lại để bài flaky thành xanh mà không tìm nguyên nhân.
- Đưa tệp trạng thái đăng nhập hay mật khẩu tài khoản thử lên kho mã.
Điều chưa biết
Click Star chưa có số đo độc lập cho Việt Nam về mức giảm lỗi hay chi phí khi doanh nghiệp nhỏ áp dụng kiểm thử tự động. Các nguồn là kinh nghiệm của chuyên gia và hãng, nhiều bài đăng từ 2011 đến 2020, nên là nguyên tắc chứ không phải số đo.
Google Testing Blog (7/8/2020) tự nói còn là câu hỏi nghiên cứu mở khi độ phủ riêng nó có làm giảm lỗi hay không. Chưa rõ Google còn dùng tỷ lệ 70/20/10 và các mức 60%, 75%, 90% hiện nay không.
Bài liên quan



Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.