Phân tích các model Claude: Fable 5.1, Opus 5.5, Sonnet 5.5, Haiku 5.5 và cách chọn
So sánh 4 model Claude hiện hành theo giá, mức nỗ lực, bộ nhớ đệm và vòng đời, ví dụ chi phí một yêu cầu, quy trình thử 14 ngày và những điều cần kiểm khi chuyển model, dựa trên tài liệu chính thức của Anthropic.
Bài này phân tích danh mục model Claude đang dùng được tính đến ngày 20/10/2026: model nào khác model nào ở điểm quan trọng với chi phí và vận hành, mỗi việc nên bắt đầu thử ở model nào, và cần kiểm gì khi đổi model.
Một điều cần nói thẳng ngay từ đầu: theo trang ghi chú phát hành của Anthropic, mục mới nhất là ngày 15/10/2026, và không có mục nào ghi ngày 20/10/2026; trang tin tức của Anthropic cũng không có thông báo model nào trong những ngày này.
Vì vậy "cập nhật 20/10/2026" trong bài là trạng thái đã đối chiếu vào ngày đó, không phải một bản phát hành mới. Số liệu lấy từ tài liệu chính thức của Anthropic (tổng quan model, bảng giá, tài liệu về mức nỗ lực, bộ nhớ đệm prompt và đếm token).
Click Star đã có bài riêng về các thay đổi từ 22/9 đến 15/10 với số liệu benchmark do Anthropic công bố; bài này không lặp lại các số đó mà đi vào cách so sánh và chọn.
Điểm chính
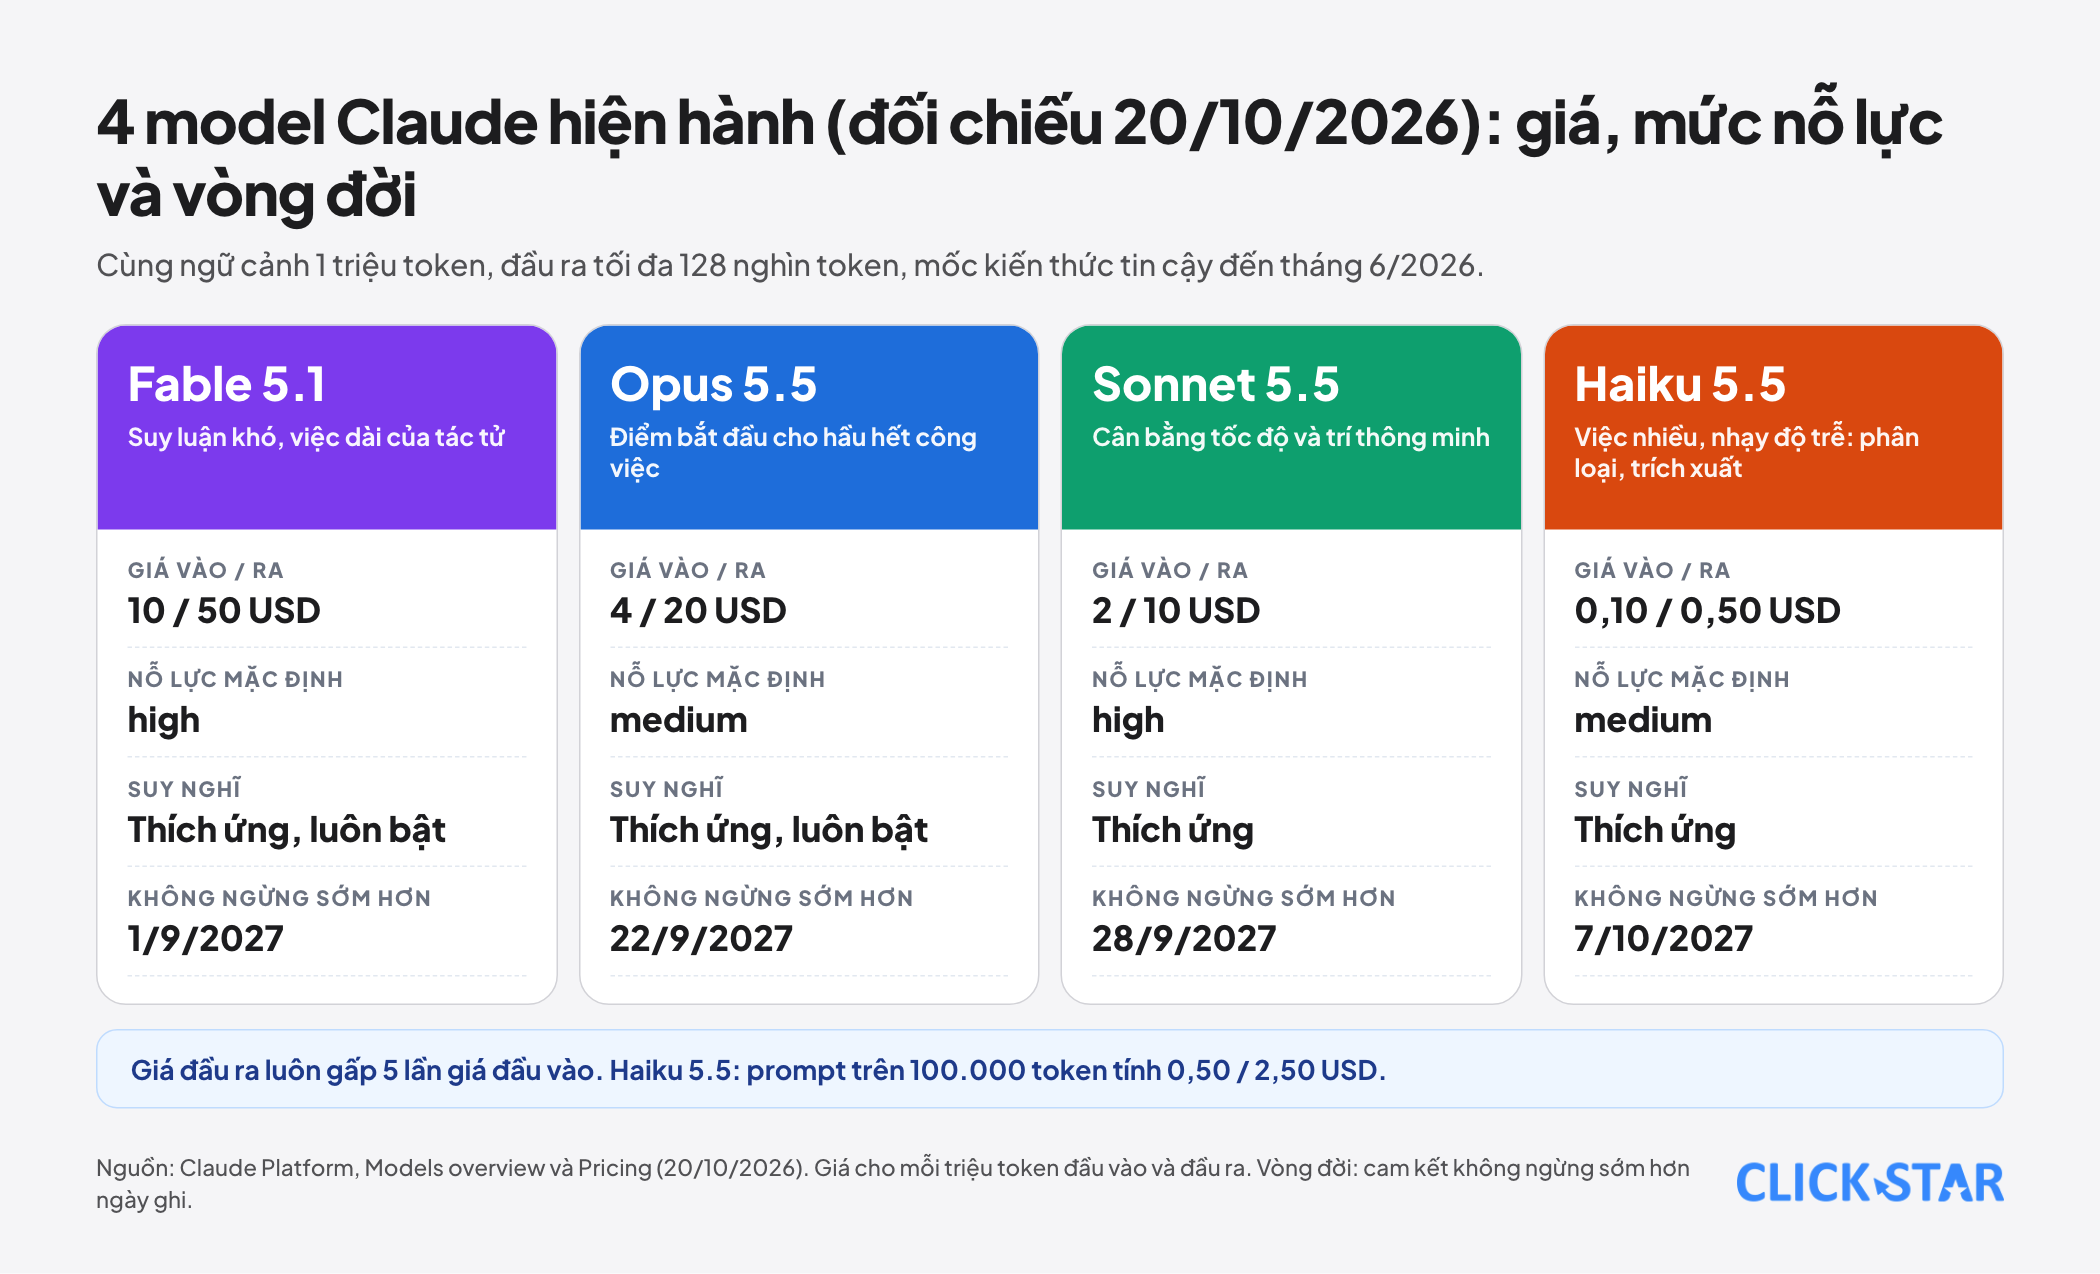
- Danh mục hiện hành gồm 4 model: Fable 5.1 (10 và 50 USD cho mỗi triệu token đầu vào và đầu ra), Opus 5.5 (4 và 20 USD), Sonnet 5.5 (2 và 10 USD) và Haiku 5.5 (0,10 và 0,50 USD với prompt đến 100.000 token); cả 4 đều có ngữ cảnh 1 triệu token, đầu ra tối đa 128 nghìn token và mốc kiến thức tin cậy đến tháng 6/2026.
- Ở cả 4 model, giá đầu ra gấp đúng 5 lần giá đầu vào, nên khi dùng bộ nhớ đệm (cache) để giảm phần đầu vào thì đầu ra trở thành khoản chi chính.
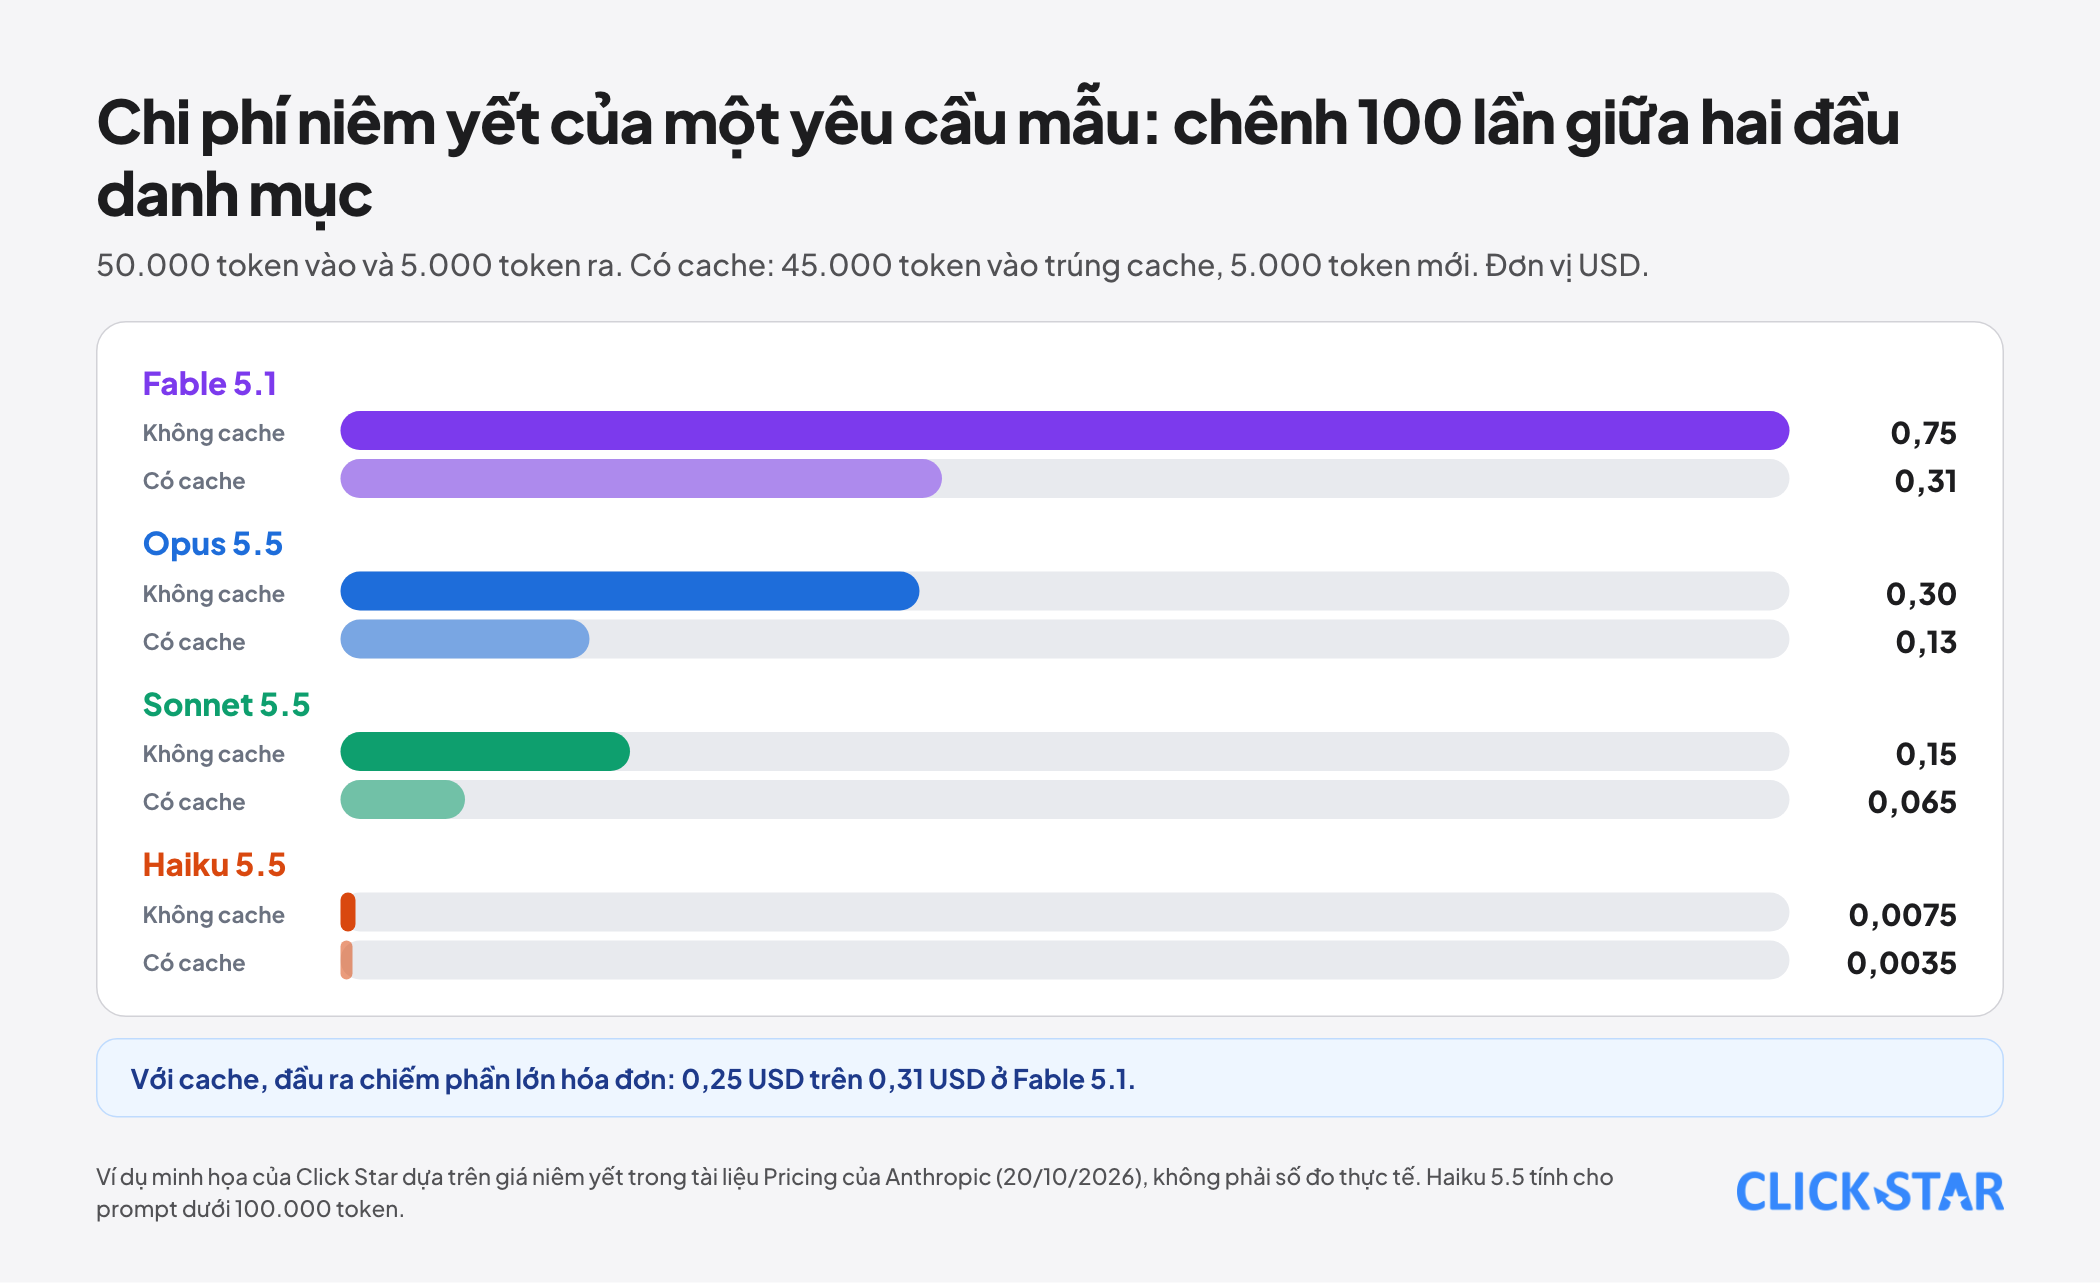
- Một yêu cầu mẫu 50.000 token vào và 5.000 token ra có giá niêm yết khoảng 0,75 USD ở Fable 5.1, 0,30 USD ở Opus 5.5, 0,15 USD ở Sonnet 5.5 và 0,0075 USD ở Haiku 5.5: chênh lệch tới 100 lần giữa hai đầu danh mục.
- Mức nỗ lực mặc định khác nhau: Fable 5.1 và Sonnet 5.5 mặc định "high", còn Opus 5.5 và Haiku 5.5 mặc định "medium", nên cùng một yêu cầu không có tham số effort sẽ chạy ở mức suy nghĩ khác nhau giữa các model.
- Phần chuyển model hay gây lỗi hơn phần chọn model: tham số cũ như budget_tokens, temperature, top_p, top_k và prefill có thể trả lỗi 400 khi chuyển từ Haiku 4.5 sang Haiku 5.5, và bộ mã hóa văn bản từ Claude 4.7 trở đi cho nhiều hơn khoảng 30% token trên cùng một văn bản.
- Cam kết vòng đời của Anthropic cho 4 model hiện hành là "không sớm hơn" các ngày từ 1/9/2027 đến 7/10/2027, nên kế hoạch chọn model nên tính cả việc chuyển tiếp trong vòng khoảng 1 năm.
"Cập nhật 20/10/2026": điều đã đối chiếu
Click Star đã đọc ghi chú phát hành của Claude Platform và trang tin tức của Anthropic vào ngày 20/10/2026. Ghi chú phát hành có các mục ngày 1/10, 5/10, 6/10, 7/10, 8/10, 9/10, 14/10 và 15/10; không có mục ngày 20/10 và không có mục nào ghi ngừng cung cấp model trong tháng 10.
Trang tin tức có các thông báo ngày 14/10 (văn phòng ở Singapore và biên bản ghi nhớ với Chính phủ Singapore), 15/10, 18/10 và các ngày trước, không có thông báo model mới. Nếu sau ngày này có bản phát hành, bài sẽ cần cập nhật; hãy kiểm tra trang ghi chú phát hành trước khi quyết định.
Danh mục model đang dùng được
4 model hiện hành. Anthropic định vị Opus 5.5 là điểm bắt đầu cho hầu hết công việc, Fable 5.1 cho suy luận khó và việc dài của tác tử khi kết quả ở Opus 5.5 mức nỗ lực cao vẫn chưa đủ, Sonnet 5.5 là cân bằng giữa tốc độ và trí thông minh, và Haiku 5.5 cho việc khối lượng lớn, nhạy độ trễ như phân loại, trích xuất, định tuyến.
Cả 4 hỗ trợ đầu vào chữ và ảnh, đầu ra chữ, nhiều ngôn ngữ và gọi công cụ.
Claude Mythos 5.1. Có cùng giá với Fable 5.1 nhưng chỉ dành cho tổ chức đã được xác minh qua các chương trình của Anthropic như Cyber Verification Program, nên không phải lựa chọn thông thường cho doanh nghiệp.
Các model cũ còn dùng được. Fable 5, Opus 5, Opus 4.8, 4.7, 4.6, 4.5, Sonnet 5, Sonnet 4.6 và Haiku 4.5. Một số model đời cũ (Opus 4.1, Opus 4, Sonnet 4, Haiku 3.5) đã ngừng trên nền tảng của Anthropic và chỉ còn trên một số đám mây đối tác.
Opus 5 và Sonnet 5 có giá cao hơn hoặc bằng thế hệ 5.5; riêng Sonnet 5 từng có giá giới thiệu 2 và 10 USD đến hết 31/8/2026 và Anthropic cho biết mức tăng lên 3 và 15 USD dự kiến ngày 1/9/2026 sẽ không xảy ra.
5 điểm khác nhau thật sự giữa các model
1. Mức suy nghĩ và nỗ lực mặc định. Cả 4 model dùng suy nghĩ thích ứng (adaptive thinking), trong đó model tự quyết định nghĩ bao nhiêu, và mức nỗ lực (effort) là cách chính để điều chỉnh. Anthropic ghi nhận effort ảnh hưởng tới mọi token đầu ra, gồm cả lời giải thích, tham số công cụ và nội dung suy nghĩ.
Mặc định: Fable 5.1 là high, Opus 5.5 là medium, Sonnet 5.5 là high, Haiku 5.5 là medium. Với Opus 5.5 và Fable 5.1, suy nghĩ luôn bật, và yêu cầu tắt suy nghĩ trên Opus 5.5 trả lỗi 400 ở mọi mức; với Sonnet 5.5, tùy chọn thấp nhất là "between_tools" (tắt suy nghĩ ban đầu), còn Haiku 5.5 cho phép tắt hẳn ở mức high trở xuống.
2. Cấu trúc giá chứ không chỉ đơn giá. Giá đầu ra luôn gấp 5 lần giá đầu vào. Giá đọc từ bộ nhớ đệm bằng 0,025 lần giá đầu vào ở Fable 5.1 (0,25 USD cho mỗi triệu token), 0,05 lần ở Opus 5.5 (0,20 USD) và Sonnet 5.5 (0,10 USD), và 0,1 lần ở Haiku 5.5 (0,01 USD).
Batch API giảm 50% cho cả đầu vào và đầu ra, và theo trang giá, các hệ số bộ nhớ đệm và batch cộng dồn được. Haiku 5.5 tính giá theo độ dài prompt: trên 100.000 token giá lên 0,50 USD đầu vào và 2,50 USD đầu ra.
Chế độ nhanh (fast mode) của Opus 5.5 ra khỏi bản thử nghiệm ngày 15/10/2026 với giá 8 và 40 USD, gấp đôi giá chuẩn, và không dùng được cùng Batch API.
3. Ngưỡng prompt tối thiểu để dùng bộ nhớ đệm. Cả 4 model chỉ cần prompt từ 512 token (trong khi các model đời trước thường cần 1.024 đến 4.096), nên các prompt hệ thống ngắn hơn cũng tận dụng được cache.
4. Bộ mã hóa văn bản. Từ Claude 4.7, Anthropic dùng bộ mã hóa mới cho cùng một văn bản ra nhiều hơn khoảng 30% token so với các model trước (mức tăng thực tế phụ thuộc nội dung). Nghĩa là số token của một việc có thể tăng khi chuyển lên model mới dù đơn giá một token không đổi hoặc giảm; hãy đếm lại token bằng model bạn định dùng.
Anthropic nói rõ việc đếm token miễn phí, có giới hạn số yêu cầu mỗi phút theo bậc sử dụng.
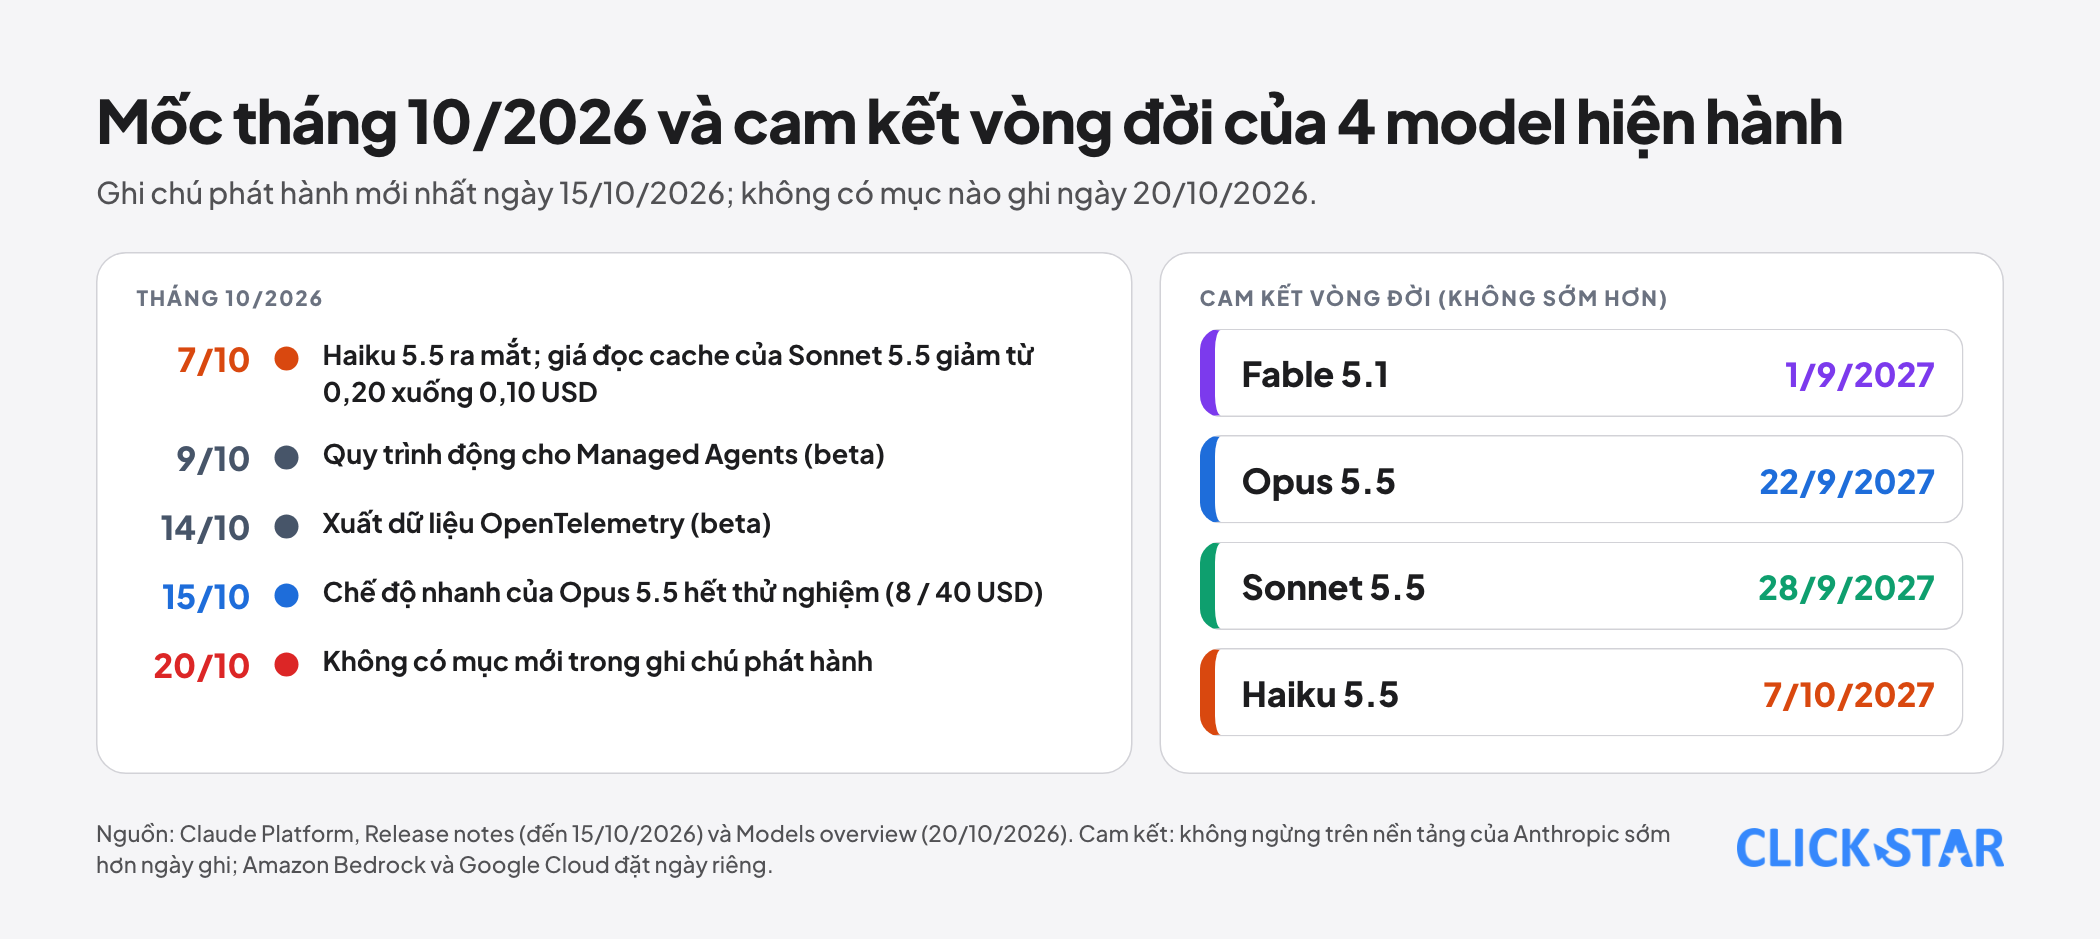
5. Vòng đời. Anthropic cam kết không ngừng các model trên nền tảng của mình sớm hơn: Fable 5.1 ngày 1/9/2027, Opus 5.5 ngày 22/9/2027, Sonnet 5.5 ngày 28/9/2027 và Haiku 5.5 ngày 7/10/2027. Amazon Bedrock và Google Cloud đặt ngày của riêng họ.
Chi phí một việc: bộ nhớ đệm làm đảo cơ cấu chi phí
Ví dụ minh họa của Click Star dựa trên giá niêm yết, không phải số đo thực tế, và chưa tính chênh lệch số token giữa các lần chạy. Một yêu cầu có 50.000 token vào và 5.000 token ra.
- Không cache: Fable 5.1 khoảng 0,75 USD (0,50 cho đầu vào và 0,25 cho đầu ra); Opus 5.5 khoảng 0,30 USD; Sonnet 5.5 khoảng 0,15 USD; Haiku 5.5 khoảng 0,0075 USD (prompt dưới 100.000 token).
- Có cache, 45.000 token đầu vào trúng cache và 5.000 token mới: Fable 5.1 khoảng 0,31 USD; Opus 5.5 khoảng 0,13 USD; Sonnet 5.5 khoảng 0,065 USD; Haiku 5.5 khoảng 0,0035 USD.
Hai nhận xét. Một, chênh lệch giữa Fable 5.1 và Haiku 5.5 là 100 lần khi không cache và khoảng 90 lần khi có cache, nên việc chọn model thường có tác động lớn hơn mọi mẹo tối ưu khác. Hai, với cache trúng, đầu ra chiếm phần lớn hóa đơn (0,25 USD trên 0,31 USD ở Fable 5.1), nên giới hạn độ dài đầu ra và chọn mức nỗ lực thấp hơn có giá trị hơn việc cắt thêm đầu vào.
Đánh giá của Click Star. Câu hỏi đúng không phải "model nào mạnh nhất" mà là "việc này cần mức chất lượng tối thiểu nào, và model rẻ nhất đạt mức đó là model nào". Với phần lớn việc lặp lại (phân loại, trích xuất, trả lời tầng một), Haiku 5.5 hoặc Sonnet 5.5 là điểm bắt đầu thử hợp lý; Opus 5.5 và Fable 5.1 nên dành cho việc mà kết quả sai tốn nhiều hơn chênh lệch chi phí.
Cách chọn: quy trình thử 14 ngày
- Ngày 1 đến 2: chọn 30 đến 50 mẫu việc thật (đã ẩn dữ liệu cá nhân), kèm tiêu chí đạt rõ ràng và người chấm.
- Ngày 3 đến 7: chạy bộ mẫu trên 3 model (một nhỏ, một vừa, một lớn) ở mức nỗ lực mặc định; ghi số token thực, thời gian và chi phí cho mỗi việc đạt.
- Ngày 8 đến 10: với model rẻ nhất đạt tiêu chí, thử hạ mức nỗ lực; với model đắt nhất, thử mức cao hơn nếu còn việc trượt.
- Ngày 11 đến 13: thêm cache cho phần prompt cố định và đo lại; thêm Batch API cho việc không gấp.
- Ngày 14: chốt model theo từng loại việc, ghi lại tiêu chí để quay lại đánh giá khi có model mới.
Anthropic khuyến nghị chạy một đợt quét mức nỗ lực trên bộ kiểm tra của riêng mình thay vì mang cài đặt từ model cũ sang, vì mức nỗ lực của từng model được hiệu chỉnh khác nhau.
Những thay đổi cần kiểm khi chuyển model
- Tham số cũ gây lỗi 400: khi chuyển từ Haiku 4.5 sang Haiku 5.5, Anthropic cảnh báo budget_tokens, temperature, top_p, top_k và điền sẵn câu trả lời của trợ lý (prefill) có thể trả lỗi 400; công cụ computer_20250124 cũng vậy.
- Mức nỗ lực mặc định thấp hơn: Opus 5.5 mặc định medium trong khi Opus 5 và các Opus trước mặc định high, nên yêu cầu không ghi effort chạy thấp hơn một mức so với trước.
- Tắt suy nghĩ: yêu cầu thinking disabled trên Opus 5.5 trả lỗi 400 ở mọi mức, Fable 5.1 luôn bật suy nghĩ thích ứng; với Sonnet 5.5 dùng between_tools.
- Số token tăng: đếm lại bằng đúng ID model mới trước khi ước tính chi phí hoặc kiểm tra ngữ cảnh.
- Cache bị vô hiệu: đổi định nghĩa công cụ, prompt hệ thống, tốc độ (fast hoặc chuẩn) hoặc mức nỗ lực ở cấp yêu cầu giữa các lần gọi làm mất bộ nhớ đệm; chọn mức nỗ lực ở đầu phiên và giữ nguyên, hoặc dùng cách đổi mức nỗ lực theo từng tin nhắn (đang ở bản beta) trên model hỗ trợ.
Vòng đời và các thay đổi trong tháng 10
Các mốc trong ghi chú phát hành tháng 10/2026 liên quan trực tiếp đến chi phí và vận hành: ngày 7/10 Haiku 5.5 ra mắt và giá đọc cache của Sonnet 5.5 giảm từ 0,20 xuống 0,10 USD; ngày 9/10 quy trình động (dynamic workflows) cho Managed Agents ở bản beta; ngày 14/10 xuất dữ liệu OpenTelemetry ở bản beta; ngày 15/10 chế độ nhanh của Opus 5.5 hết thử nghiệm.
Về dài hạn, 4 model hiện hành có cam kết vòng đời đến ít nhất tháng 9 và 10/2027, nên một kế hoạch dùng cố định một model sẽ cần chuyển tiếp trong khoảng 1 năm.
Việc nên làm trong tuần này
- Liệt kê mọi nơi bạn gọi model Claude (ứng dụng, tự động hóa, công cụ) và model đang dùng ở mỗi nơi.
- Với mỗi nơi, ghi ngày cam kết vòng đời của model đang dùng và quyết định có cần chuyển tiếp hay không.
- Chạy quy trình thử 14 ngày cho 1 việc có chi phí lớn nhất, thay vì thử mọi việc cùng lúc.
- Rà các tham số cũ (temperature, top_p, top_k, budget_tokens, prefill) trong mã nếu có kế hoạch chuyển model.
- Ghi số token thực và chi phí mỗi việc đạt vào bảng theo dõi để so sánh khi có model mới.
Những sai lầm thường gặp
- Chọn model theo bảng xếp hạng chung thay vì thử trên mẫu việc thật.
- So sánh chi phí chỉ theo đơn giá mà bỏ qua chênh lệch số token do bộ mã hóa khác nhau.
- Không đặt mức nỗ lực rõ ràng, nên cùng một mã chạy ở mức khác nhau trên các model khác nhau.
- Giữ nguyên tham số cũ khi chuyển model và gặp lỗi 400 ở môi trường chạy thật.
- Đổi mức nỗ lực hoặc công cụ giữa các yêu cầu của cùng một phiên làm mất bộ nhớ đệm.
- Không theo dõi ngày cam kết vòng đời nên bị động khi một model được thông báo ngừng.
- Dùng model lớn nhất cho mọi việc vì "an toàn", rồi trả chi phí gấp 100 lần cho việc phân loại đơn giản.
Bài liên quan



Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.