Prompt injection và bảo mật ứng dụng AI: các kiểu tấn công, cách phòng thủ nhiều lớp và cách kiểm thử
Bài giải thích prompt injection trực tiếp và gián tiếp theo OWASP và NIST, các vụ việc đã công bố, 6 lớp phòng thủ và cách kiểm thử, dựa trên tài liệu của OWASP, NIST, NCSC, Anthropic, OpenAI và Google.
Ứng dụng AI ngày càng đọc nhiều thứ doanh nghiệp không tự soạn: email của khách, trang web, tài liệu tải lên, kết quả từ công cụ. Mỗi nguồn có thể chứa câu chữ nhằm điều khiển mô hình, và kiểu tấn công này gọi là prompt injection (chèn lệnh vào lời nhắc).
Bài này tổng hợp định nghĩa của OWASP và NIST, các vụ việc đã công bố, hướng dẫn của Anthropic, OpenAI, Google, Microsoft, cơ quan an ninh mạng Anh (NCSC) và cách kiểm thử, đối chiếu đến ngày 21/10/2026.
Bài trả lời 3 câu hỏi: vì sao khó dứt điểm, phòng thủ nhiều lớp gồm gì, cần kiểm tra gì trước khi ra mắt. Click Star đã có bài riêng về chatbot AI trên website và về bảo vệ dữ liệu khách hàng khi phân tích bằng AI; bài này tập trung vào tấn công và kiểm thử.
Điểm chính
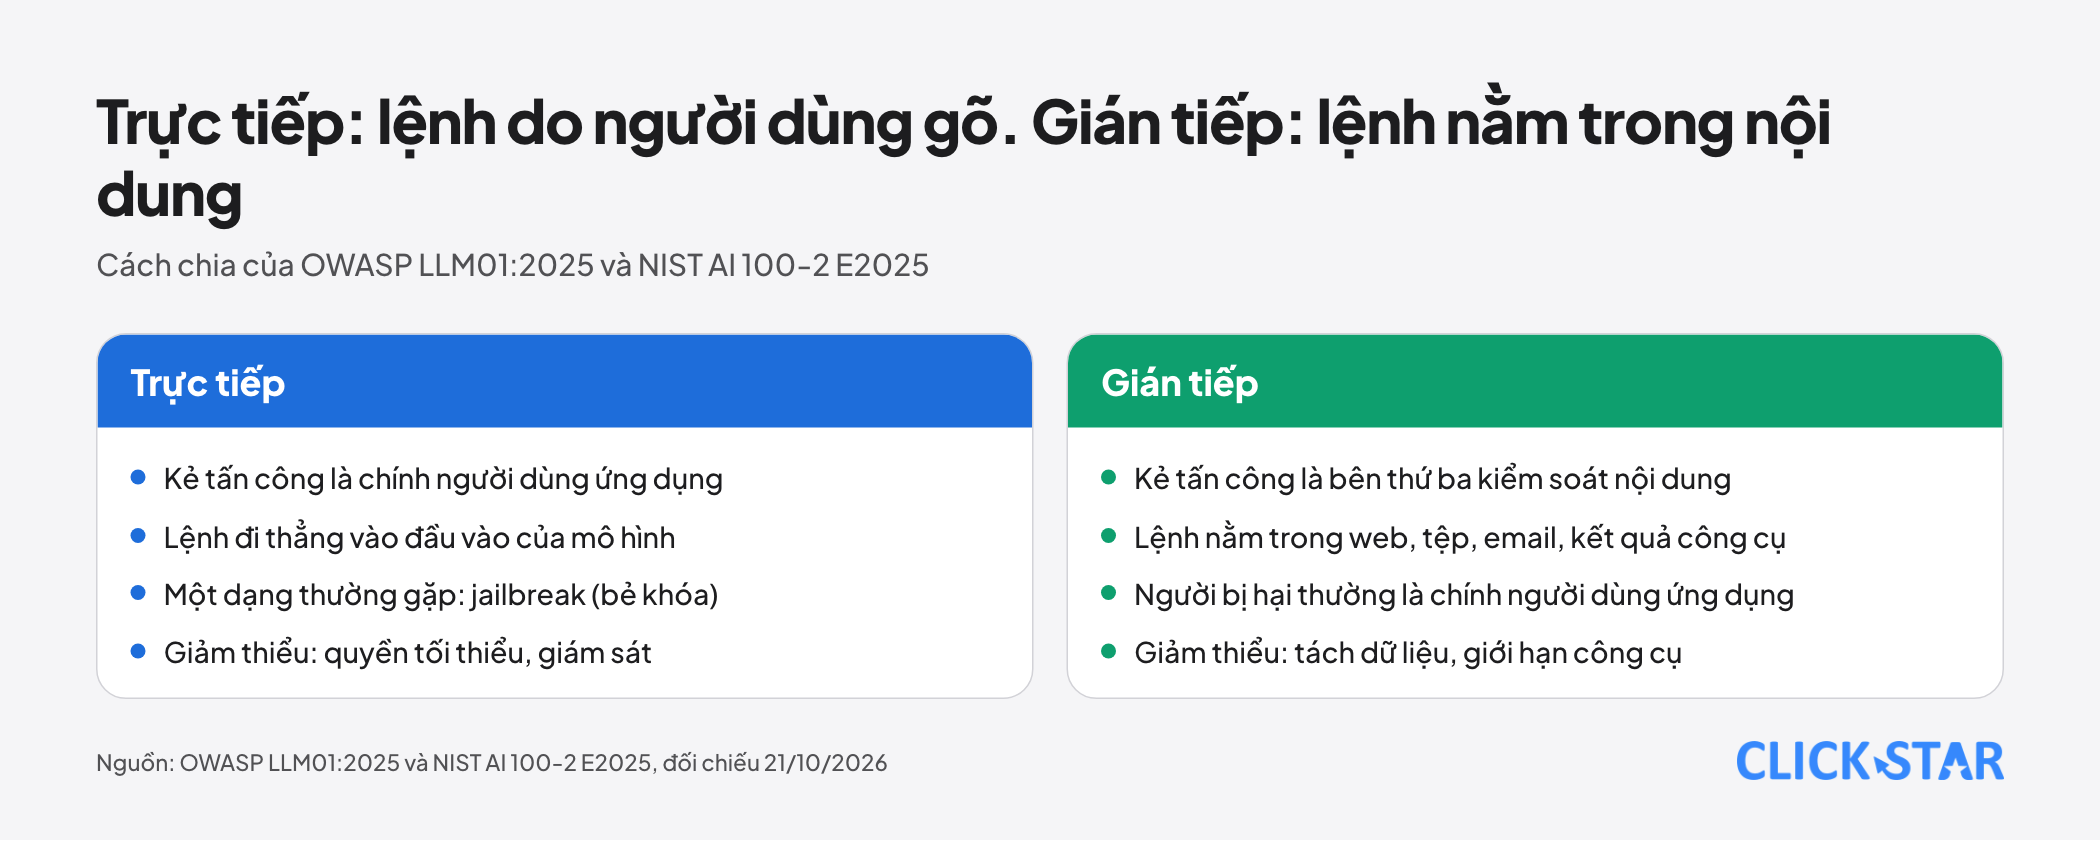
- OWASP xếp prompt injection là rủi ro LLM01 (bản 2025) và chia 2 loại: trực tiếp (người dùng gõ lệnh) và gián tiếp (lệnh nằm trong web, tệp, email mà mô hình đọc).
- Gốc vấn đề: NIST (3/2025) ghi nhận dữ liệu và chỉ dẫn không đi qua kênh riêng; NCSC (8/12/2025) cho rằng lỗi này có thể không bao giờ được chặn hoàn toàn như SQL injection.
- Các hãng đều nói chưa giải quyết xong: Anthropic coi tỷ lệ tấn công thành công 1% vẫn là rủi ro đáng kể.
- Vụ việc đã công bố (EchoLeak, GitHub MCP, Comet) chủ yếu là nghiên cứu trình diễn; chưa có thống kê thiệt hại thực tế.
- Không lớp nào đủ một mình: câu dặn trong prompt chỉ là lớp mềm, cần thêm quyền tối thiểu, tách dữ liệu, người duyệt, giới hạn công cụ, giám sát và cách ly.
- Rủi ro tăng khi AI vừa đọc nội dung lạ, vừa chạm dữ liệu riêng, vừa gửi được ra ngoài; bộ ca tấn công phải chạy lại mỗi khi đổi model, prompt hoặc công cụ.
Prompt injection là gì: trực tiếp và gián tiếp
Theo trang LLM01:2025 của OWASP GenAI Security Project (đọc 21/10/2026), prompt injection xảy ra khi lời nhắc làm đổi hành vi của mô hình theo cách không định trước. Lệnh chèn có thể là chữ mắt người không thấy, ví dụ chữ ẩn trên trang web mà công cụ tóm tắt đọc phải.
Trực tiếp là đầu vào của người dùng tác động thẳng lên mô hình. Gián tiếp là mô hình nhận dữ liệu từ nguồn ngoài như trang web hoặc tệp, và nội dung đó làm đổi hành vi khi được đọc. Jailbreak (bẻ khóa) là 1 dạng, khi kẻ tấn công muốn mô hình bỏ mọi quy tắc an toàn.
NIST, trong báo cáo AI 100-2 E2025 (bản cuối 24/3/2025, đọc 21/10/2026), chia tương tự. Với kiểu gián tiếp, kẻ tấn công là bên thứ ba, còn người bị hại thường lại là chính người dùng ứng dụng. Chatbot của doanh nghiệp vì vậy có thể bị dùng để hại chính khách của mình.
Vì sao khó dứt điểm
NIST viết rằng dưới nhiều lỗ hổng của ứng dụng dùng mô hình ngôn ngữ là việc dữ liệu và chỉ dẫn không đi qua các kênh riêng, tương tự lỗi nằm sau SQL injection. SQL injection chữa dứt điểm được bằng truy vấn có tham số vì cơ sở dữ liệu không hiểu dữ liệu như lệnh.
NCSC (bài ngày 8/12/2025 của Dave Chismon) nhận định mô hình hiện nay không có ranh giới bảo mật giữa chỉ dẫn và dữ liệu, gọi nó là "inherently confusable deputy" (người đại diện vốn dễ bị nhầm). Mục tiêu thực tế là giảm xác suất và tác động; nếu không chịu nổi rủi ro còn lại thì mô hình có thể không phù hợp.
NIST cũng ghi các mô hình hiện tại vẫn rất dễ bị tấn công trực tiếp, nên khuyến nghị thiết kế theo giả định mô hình có thể bị điều khiển. Anthropic (24/11/2025) viết prompt injection còn xa mới được giải quyết; Google (2/4/2026) coi đây là việc phải giảm thiểu liên tục.
Số đo cho thấy tiến bộ nhưng không về 0. Theo báo cáo model của Anthropic (đọc 21/10/2026), xác suất kẻ tấn công thành công trong 15 lần thử trên bộ kiểm tra của Gray Swan, Viện An ninh AI Anh và CAISI (Mỹ) giảm từ 83,2% (Haiku 4.5) xuống 7,1% (Haiku 5.5); cùng báo cáo ghi Opus 5.5 là 1,0%.
Giới hạn: model được đo khi chưa bật lớp bảo vệ của sản phẩm, Haiku 5.5 còn 24,4% ở tác vụ điều khiển máy tính qua màn hình, và đây là 1 bộ kiểm tra, không phải cam kết cho ứng dụng của doanh nghiệp.
Một cuộc thi công khai (bài arXiv ngày 16/3/2026) ghi 464 người gửi 272.000 lần thử vào 13 model thuộc nhóm frontier, ra 8.648 đòn thành công trên 41 kịch bản. Mọi model đều bị vượt qua, tỷ lệ từ 0,5% (Claude Opus 4.5) đến 8,5% (Gemini 2.5 Pro); model là bản tại thời điểm thi.
Những vụ việc đã được công bố
Hãy đọc các vụ dưới đây như bằng chứng về cách đòn tấn công vận hành, không phải thống kê thiệt hại; Click Star chưa tìm thấy nguồn công khai đếm số vụ thật.
EchoLeak, CVE-2025-32711. Bài phân tích học thuật (arXiv, 6/9/2025) mô tả lỗ hổng không cần bấm chuột trong Microsoft 365 Copilot: 1 email soạn sẵn đủ để lấy dữ liệu ra ngoài, qua chuỗi vượt bộ lọc XPIA, che liên kết bằng Markdown dạng tham chiếu và ảnh tự tải.
GitHub MCP, 26/5/2025. Invariant Labs trình diễn một Issue độc hại trong kho công khai có thể khiến agent đọc dữ liệu kho riêng và đăng lên kho công khai. Họ nhận định đây là lỗi kiến trúc ở mức agent, không phải lỗi mã máy chủ; chế độ "Always Allow" khiến khó nhận ra hành động lạ.
Comet, 20/8/2025. Brave trình diễn lệnh ẩn trong bình luận Reddit khiến trợ lý của trình duyệt Comet lấy email và mã đăng nhập một lần của người dùng. Brave ghi nhận kiểu tấn công này chưa được khắc phục triệt để sau lần báo đầu.
Quét web, 23/4/2026. Google quét kho Common Crawl: phần lớn lệnh chèn là đùa, thao túng SEO hoặc cản agent, số ít nhắm vào đánh cắp hoặc xóa dữ liệu, mức tinh vi thấp. Nhóm độc hại tăng 32% (tương đối) từ 11/2025 đến 2/2026. Kho này chủ yếu là web tĩnh tiếng Anh, nên đây là mối đe dọa tăng từ mức thấp.
Phòng thủ nhiều lớp
Microsoft (MSRC, 29/7/2025) kết hợp biện pháp xác suất và xác định qua 3 giai đoạn: ngăn chèn lệnh, phát hiện, giảm tác động. Họ không dựa vào việc chặn được mọi lần chèn, nên lớp giảm tác động giới hạn thiệt hại cả khi đòn đã thành công.
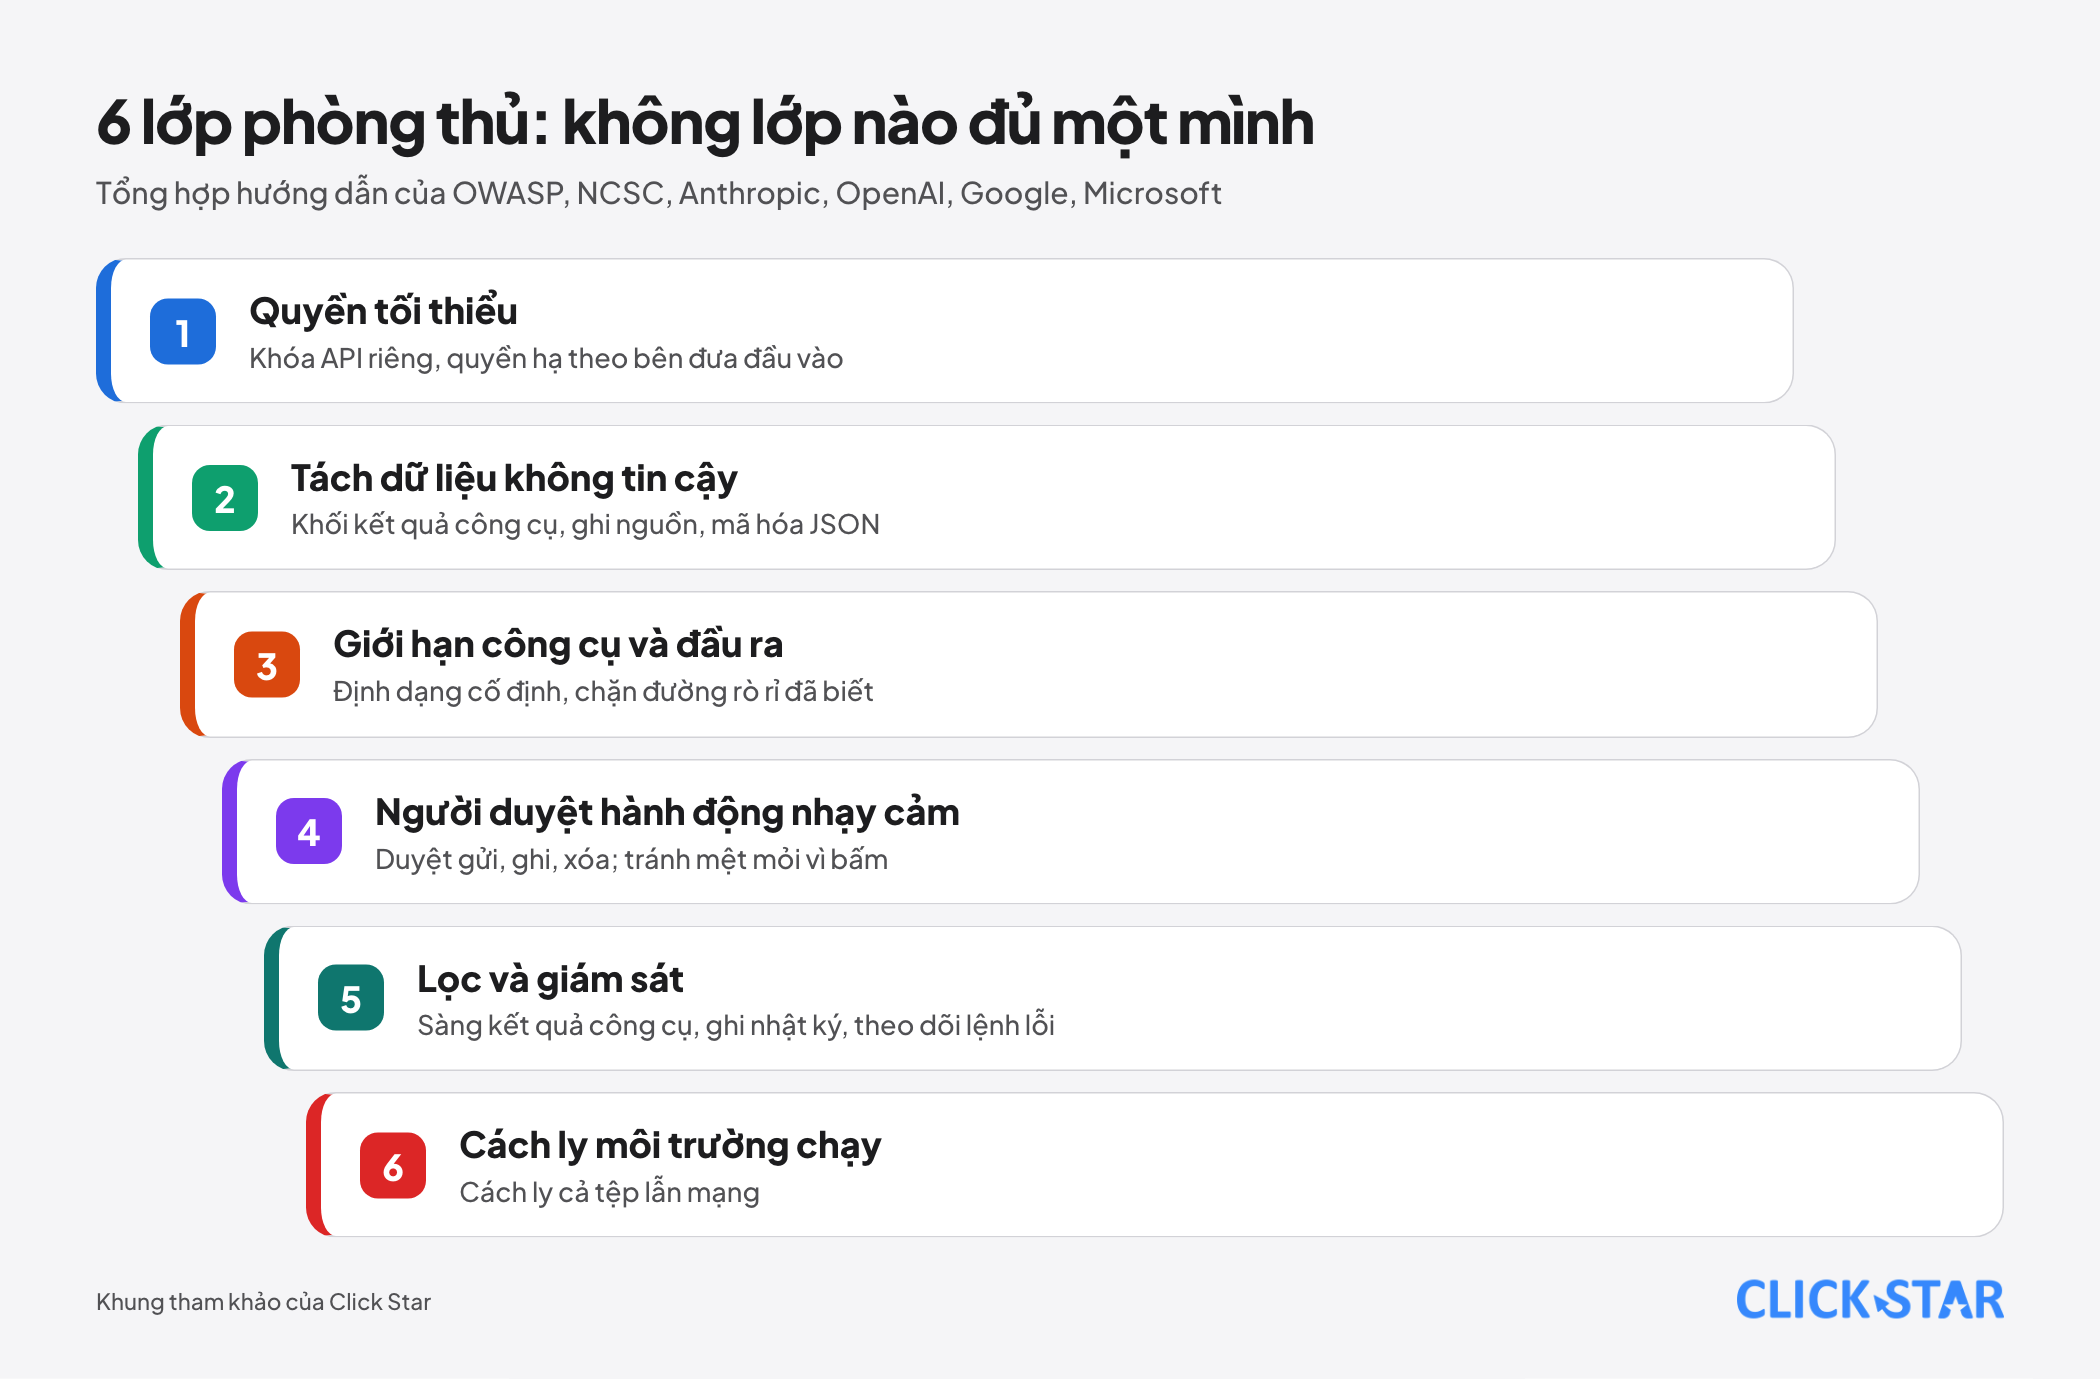
Lớp 1, quyền tối thiểu. OWASP khuyên cấp khóa API riêng cho ứng dụng và giới hạn quyền ở mức cần thiết. NCSC nêu nguyên tắc: khi mô hình xử lý đầu vào của một bên, quyền của nó hạ xuống bằng quyền bên đó, ví dụ mô hình đọc email ngoài không nên có công cụ đặc quyền.
Lớp 2, tách dữ liệu không tin cậy. Tài liệu Claude Platform khuyên đặt nội dung bên thứ ba chỉ trong khối kết quả công cụ, ghi rõ nguồn, mã hóa JSON và không đặt chỉ dẫn của mình vào đó. OpenAI khuyên đưa đầu vào lạ qua tin nhắn người dùng, không qua tin nhắn nhà phát triển. Microsoft dùng Spotlighting (đóng khung, đánh dấu, mã hóa).
Lớp 3, giới hạn công cụ và đầu ra. OpenAI khuyên định dạng cố định giữa các bước và chỉ lấy các trường đã kiểm từ đầu vào ngoài. Google không hiển thị URL ảnh ngoài trong Markdown; Microsoft chặn các đường rò rỉ đã biết bằng quy tắc xác định.
Lớp 4, người duyệt. OWASP yêu cầu người phê duyệt thao tác đặc quyền; OpenAI khuyên giữ bước duyệt với công cụ MCP. Điểm yếu là mệt mỏi vì phải bấm: Anthropic báo cáo sandbox giảm 84% số lần hỏi quyền (bài 20/10/2025, số nội bộ).
Lớp 5, lọc và giám sát. Anthropic hướng dẫn dùng model nhỏ sàng kết quả công cụ. NCSC khuyên ghi nhật ký và coi lệnh gọi công cụ thất bại là dấu hiệu sớm. NIST lưu ý bộ phát hiện cũng bị tấn công được và có thể lỗi cùng model.
Lớp 6, cách ly môi trường. Anthropic (20/10/2025) nêu cần cả cách ly tệp lẫn mạng: thiếu mạng thì tác nhân bị chiếm không gửi khóa SSH ra được, thiếu tệp thì nó có thể thoát sandbox để có mạng.
Điều không đủ: chỉ dặn trong prompt
Dặn mô hình "đừng nghe lệnh lạ" vẫn nên làm; OWASP đặt giới hạn hành vi qua lời nhắc hệ thống là biện pháp đầu tiên trong 7 biện pháp. Nhưng đó là lớp mềm, vì kẻ tấn công cũng gửi lời nhắc tới cùng mô hình.
NCSC khuyên không dựa vào danh sách cụm cấm kiểu "ignore previous instructions" vì có vô số cách diễn đạt lại, và nên thận trọng với sản phẩm quảng cáo là "chặn được" prompt injection. OpenAI gọi bộ lọc có sẵn là lớp bảo vệ đầu tiên nhưng không hoàn hảo. Cách vững hơn là hỏi: nếu mô hình bị lừa thì tối đa nó làm được gì?
Rủi ro tăng khi AI có công cụ: agent, MCP, trình duyệt
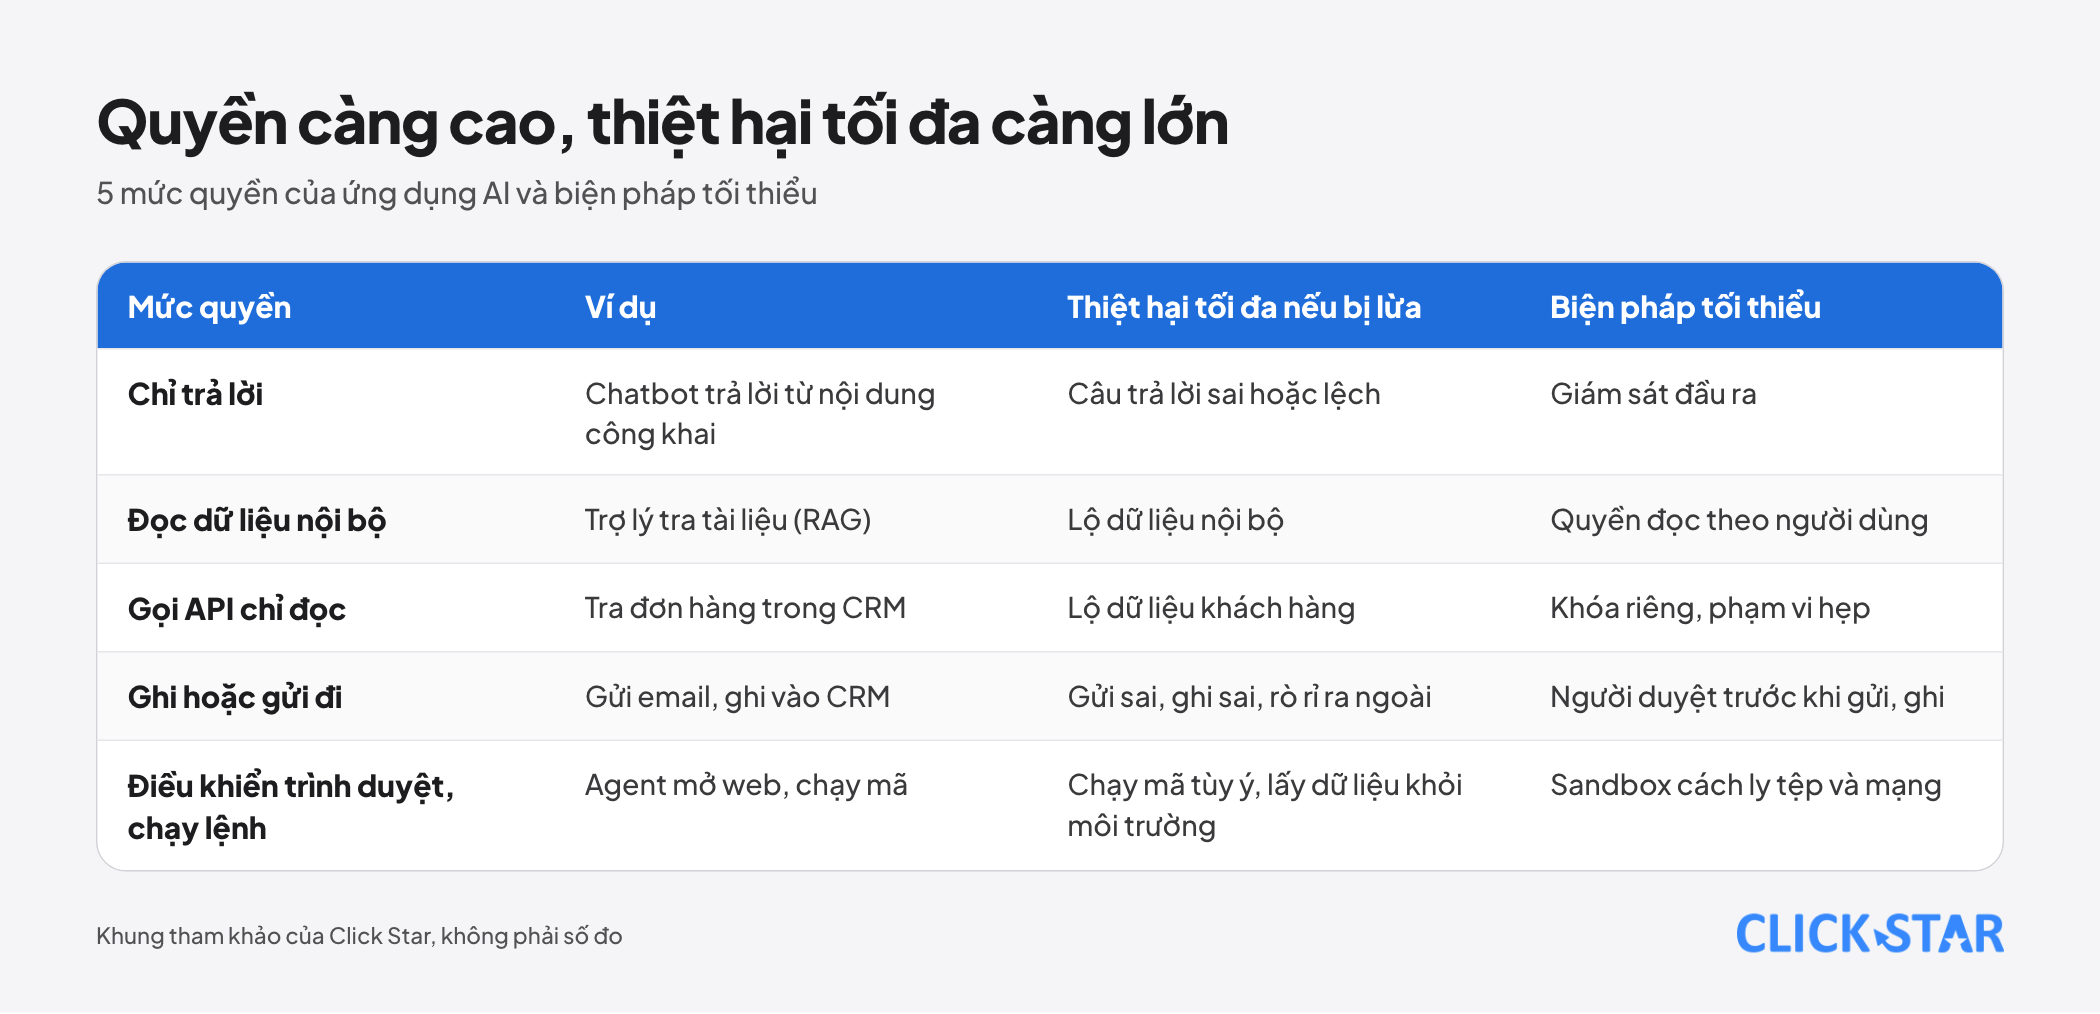
NIST ghi agent dùng công cụ nên tấn công chèn lệnh có thể dẫn đến chạy mã tùy ý hoặc lấy dữ liệu khỏi môi trường. Simon Willison (16/6/2025, nguồn thứ cấp, blog cá nhân) gọi tổ hợp nguy hiểm là "bộ ba": dữ liệu riêng, nội dung không tin cậy và khả năng liên lạc ra ngoài.
Meta (31/10/2025) đề xuất Agents Rule of Two: trong 1 phiên, agent chỉ nên có tối đa 2 trong 3 đặc tính là xử lý đầu vào không tin cậy, truy cập dữ liệu nhạy cảm, và đổi trạng thái hoặc liên lạc ra ngoài. Cần cả 3 thì phải có người duyệt.
Về MCP (giao thức nối công cụ cho AI), tài liệu bảo mật của Claude Code khuyên dùng máy chủ tự viết hoặc của nhà cung cấp đáng tin, và nói Anthropic không kiểm toán từng máy chủ. Bảng trên là khung của Click Star: quyền càng cao, thiệt hại tối đa càng lớn.
Ý nghĩa với doanh nghiệp Việt Nam
Click Star chưa tìm thấy số đo công khai về prompt injection nhằm vào ứng dụng AI ở Việt Nam, nên khuyến nghị dưới đây dựa trên hướng dẫn quốc tế và suy luận kiến trúc.
Ví dụ: chatbot website nối CRM để tra đơn và gửi email xác nhận. Nó đọc chữ khách gõ, tra được dữ liệu đơn hàng và gửi được email, tức đủ cả 3 cạnh của bộ ba. Với doanh nghiệp nhỏ chưa có đội bảo mật, cách rẻ nhất là cắt quyền từ thiết kế, nhất là bỏ quyền gửi tự động.
Cách kiểm thử và chỉ số
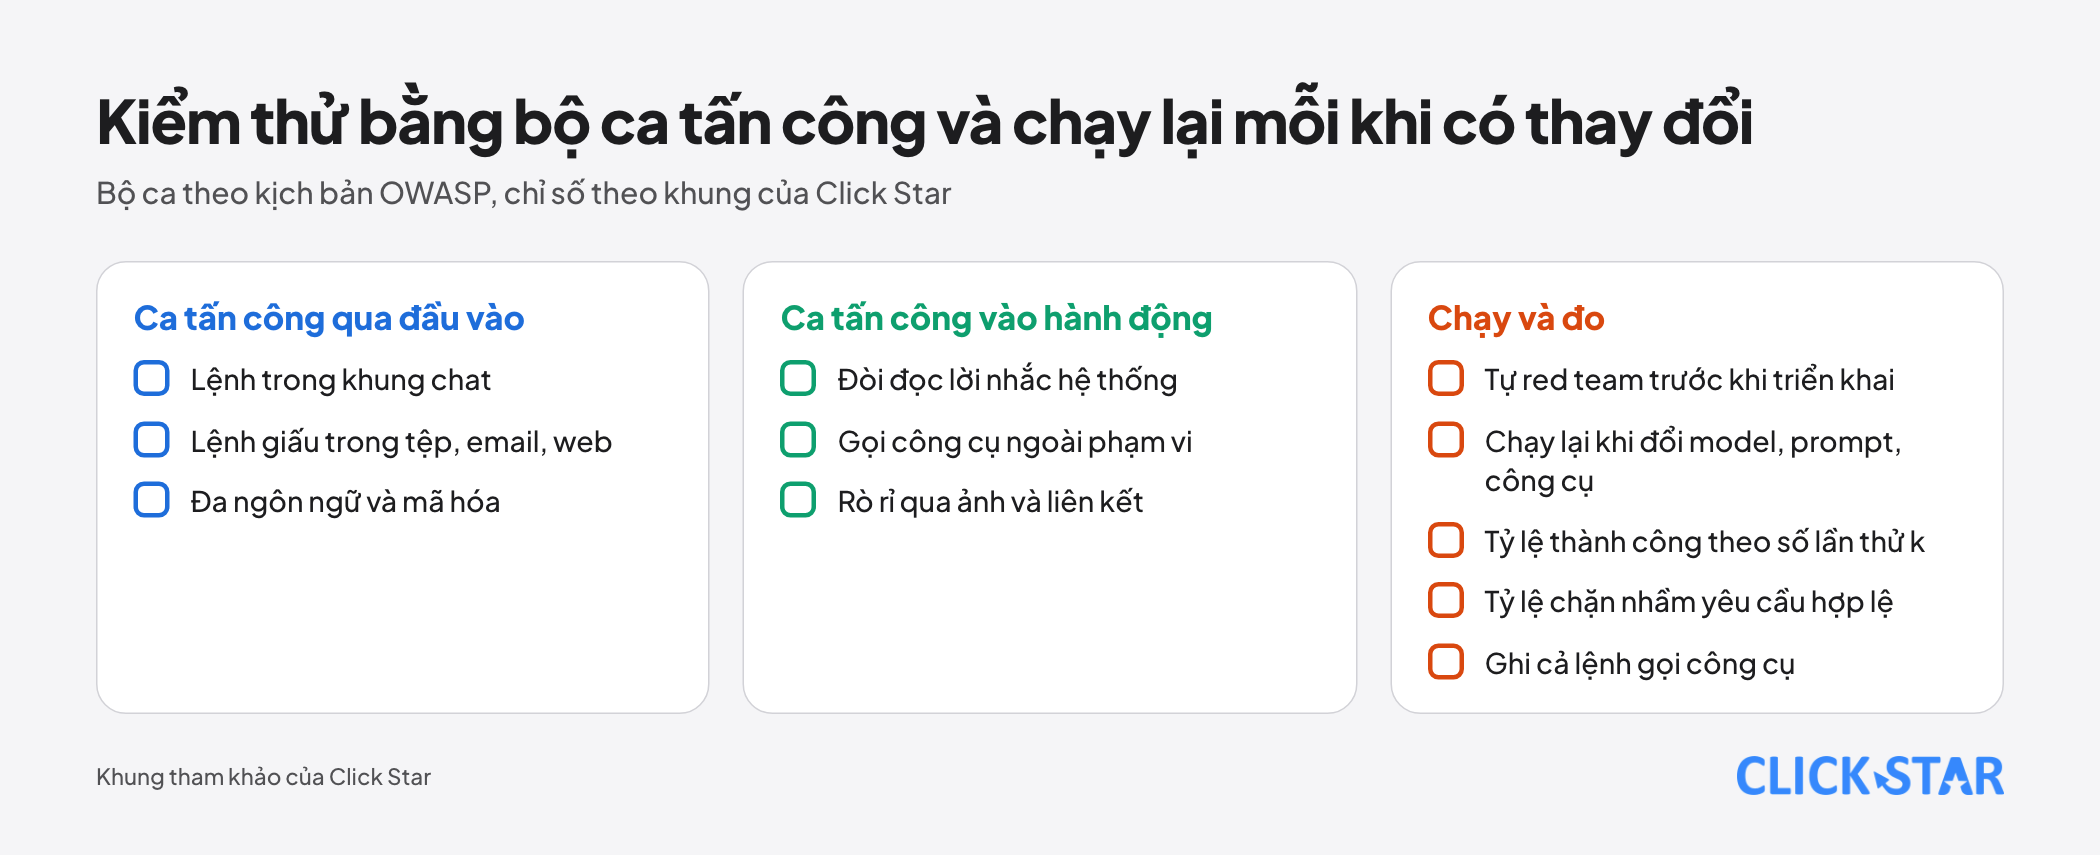
Tài liệu của Anthropic khuyên tự red team agent trước khi triển khai bằng tài liệu, email và kết quả công cụ cố tình chứa lệnh chèn. Bộ ca nên chia nhóm theo kịch bản OWASP: lệnh trong khung chat; lệnh giấu trong tệp, email, web; đòi đọc lời nhắc hệ thống; gọi công cụ ngoài phạm vi; rò rỉ qua ảnh và liên kết; đa ngôn ngữ và mã hóa.
NIST nêu các công cụ mở để tự động hóa: AgentDojo (97 tác vụ, 629 ca kiểm tra bảo mật, theo bài arXiv tháng 6/2024), garak (NVIDIA) và PyRIT (Microsoft).
Chỉ số nên theo dõi (khung của Click Star): tỷ lệ ca tấn công thành công theo số lần thử k; tỷ lệ chặn nhầm yêu cầu hợp lệ; số lệnh gọi công cụ ngoài danh sách cho phép.
NIST nhắc đánh giá chỉ đo tại 1 thời điểm và có thể đánh giá thấp lỗ hổng, nên cần đo liên tục sau triển khai. Bài cuộc thi tháng 3/2026 còn ghi có đòn gây hại mà câu trả lời cuối không để lại dấu vết, nên phải ghi cả lệnh gọi công cụ.
Việc nên làm trước khi ra mắt
- Liệt kê nguồn nội dung AI đọc, công cụ và dữ liệu AI chạm tới; bỏ mọi thứ chưa cần.
- Kiểm bộ ba: nếu AI có đủ 3, bỏ bớt 1 hoặc thêm người duyệt.
- Dùng khóa riêng, phạm vi hẹp, thu hồi nhanh được.
- Đặt bước duyệt cho gửi, ghi, xóa, thanh toán.
- Ghi nhật ký lời nhắc, kết quả và lệnh gọi công cụ, có phân quyền người xem.
- Chạy bộ ca tấn công, lưu kết quả làm mốc, chạy lại khi đổi model hoặc công cụ.
Đánh giá của Click Star. Về kỹ thuật, nên coi mô hình như một người dùng không đáng tin ngồi trong hệ thống: hữu ích, nhưng quyền không được vượt mức doanh nghiệp chấp nhận khi nó bị lừa. Quyết định quan trọng nằm ở việc cấp quyền, không ở câu prompt.
Công khai lợi ích: Click Star làm dịch vụ tích hợp AI và AI automation nên có lợi ích khi bài khuyến nghị thiết kế an toàn. Doanh nghiệp có thể tự áp dụng danh sách trên.
Những sai lầm thường gặp
- Tin rằng câu dặn trong prompt hệ thống là đủ.
- Cấp chatbot quyền ghi CRM, gửi email hoặc xem dữ liệu mọi khách ngay từ đầu.
- Chỉ thử vài câu "bỏ qua hướng dẫn trước" gõ tay, bỏ qua lệnh giấu trong tệp, email, web.
- Trộn công cụ từ nhiều máy chủ MCP mà không rà quyền từng nguồn.
- Bật tự động duyệt mọi hành động cho đỡ phiền.
- Đo một lần khi ra mắt rồi không chạy lại sau khi đổi model.
- Chỉ đọc câu trả lời cuối, không kiểm tra lệnh gọi công cụ.
Điều chưa biết
- Chưa có số đo công khai về mức phổ biến của prompt injection ở Việt Nam, và chưa tìm thấy thống kê thiệt hại thực tế trên thế giới.
- Tỷ lệ tấn công thành công của các hãng phụ thuộc bộ kiểm tra, số lần thử và lớp bảo vệ nên không so trực tiếp được.
- Bài của OpenAI về thiết kế agent chống prompt injection (đăng 11/3/2026) chưa đọc được do trang chặn công cụ, nên bài chỉ dựa trên tài liệu OpenAI đã mở được.
- Khuyến nghị cho doanh nghiệp nhỏ là suy luận từ hướng dẫn quốc tế, chưa có nghiên cứu đo riêng.
Bài liên quan



Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.