Truy vấn PostgreSQL chậm: đọc EXPLAIN và đặt chỉ mục đúng
Cách đọc EXPLAIN, chọn loại chỉ mục và chẩn đoán an toàn truy vấn PostgreSQL chậm, dựa trên tài liệu PostgreSQL 18, Supabase và ví dụ chạy trên dữ liệu giả.
Truy vấn chậm là nguyên nhân quen thuộc khiến ứng dụng, báo cáo hay trang quản trị đứng hình. Phản xạ thường gặp là thêm chỉ mục lên mọi cột, nhưng mỗi chỉ mục đều làm các lệnh ghi tốn thêm chi phí.
Bài dựa trên tài liệu PostgreSQL 18 (bản hiện hành, các trang dẫn không ghi ngày cập nhật), tài liệu Supabase và ví dụ Click Star tự chạy trên PostgreSQL 16.2 với dữ liệu giả, đối chiếu đến ngày 23/10/2026. Ví dụ chỉ minh họa hình dạng kế hoạch, không phải số đo hiệu năng.
Điểm chính
- EXPLAIN cho thấy kế hoạch dự kiến, EXPLAIN ANALYZE chạy truy vấn thật và thêm số liệu thực. Hãy so số dòng ước tính với số dòng thực trước tiên.
- Chi phí (cost) là đơn vị tùy ý, không phải mili giây. Với lệnh ghi, EXPLAIN ANALYZE sửa dữ liệu thật nên phải bọc trong BEGIN và ROLLBACK.
- B-tree phục vụ so sánh bằng, khoảng và LIKE neo ở đầu chuỗi (tùy locale); GIN phục vụ mảng, jsonb, LIKE có % ở đầu (qua pg_trgm); BRIN hợp cột theo thứ tự vật lý.
- Chỉ mục có giá: ví dụ minh họa cho thấy thêm 4 chỉ mục làm lượng WAL khi chèn 50.000 dòng tăng gấp hơn 2 lần (tùy loại chỉ mục).
- Nguyên nhân hay gặp: hàm bọc cột, LIKE bắt đầu bằng %, khóa ngoại thiếu chỉ mục, thống kê cũ.
- Tìm truy vấn tốn nhất bằng pg_stat_statements, mỗi lần đổi 1 thứ, tạo chỉ mục trên hệ thống thật bằng CONCURRENTLY.
Vì sao truy vấn trở nên chậm
Theo tài liệu PostgreSQL 18, không có chỉ mục thì hệ thống quét cả bảng từng dòng; có chỉ mục, nó chỉ đi qua vài tầng của cây tìm kiếm. Bộ lập kế hoạch (planner) chọn cách đọc dựa trên ước tính số dòng khớp từ thống kê của ANALYZE, luôn là số gần đúng.
Theo mục Using EXPLAIN, bảng chỉ chiếm 1 trang đĩa gần như luôn bị quét tuần tự, nên kết quả thử trên bảng nhỏ không suy ra được cho bảng lớn.
Cách đọc EXPLAIN và EXPLAIN ANALYZE
Theo mục EXPLAIN của tài liệu PostgreSQL 18, kế hoạch là cây các nút: nút đáy đọc bảng (quét tuần tự, quét chỉ mục, quét bitmap), nút trên nối, gộp hoặc sắp xếp. Mỗi nút có chi phí khởi động, tổng chi phí, số dòng ước tính và độ rộng dòng. Chi phí tính bằng đơn vị tùy ý, không đổi ra mili giây.
Khi thêm ANALYZE, mỗi nút có thêm thời gian thực, số dòng thực và loops. Tài liệu nói điều thường quan trọng nhất là số dòng ước tính có gần số dòng thực không. Với nút chạy nhiều lần, thời gian và số dòng là trung bình mỗi lần, phải nhân với loops.
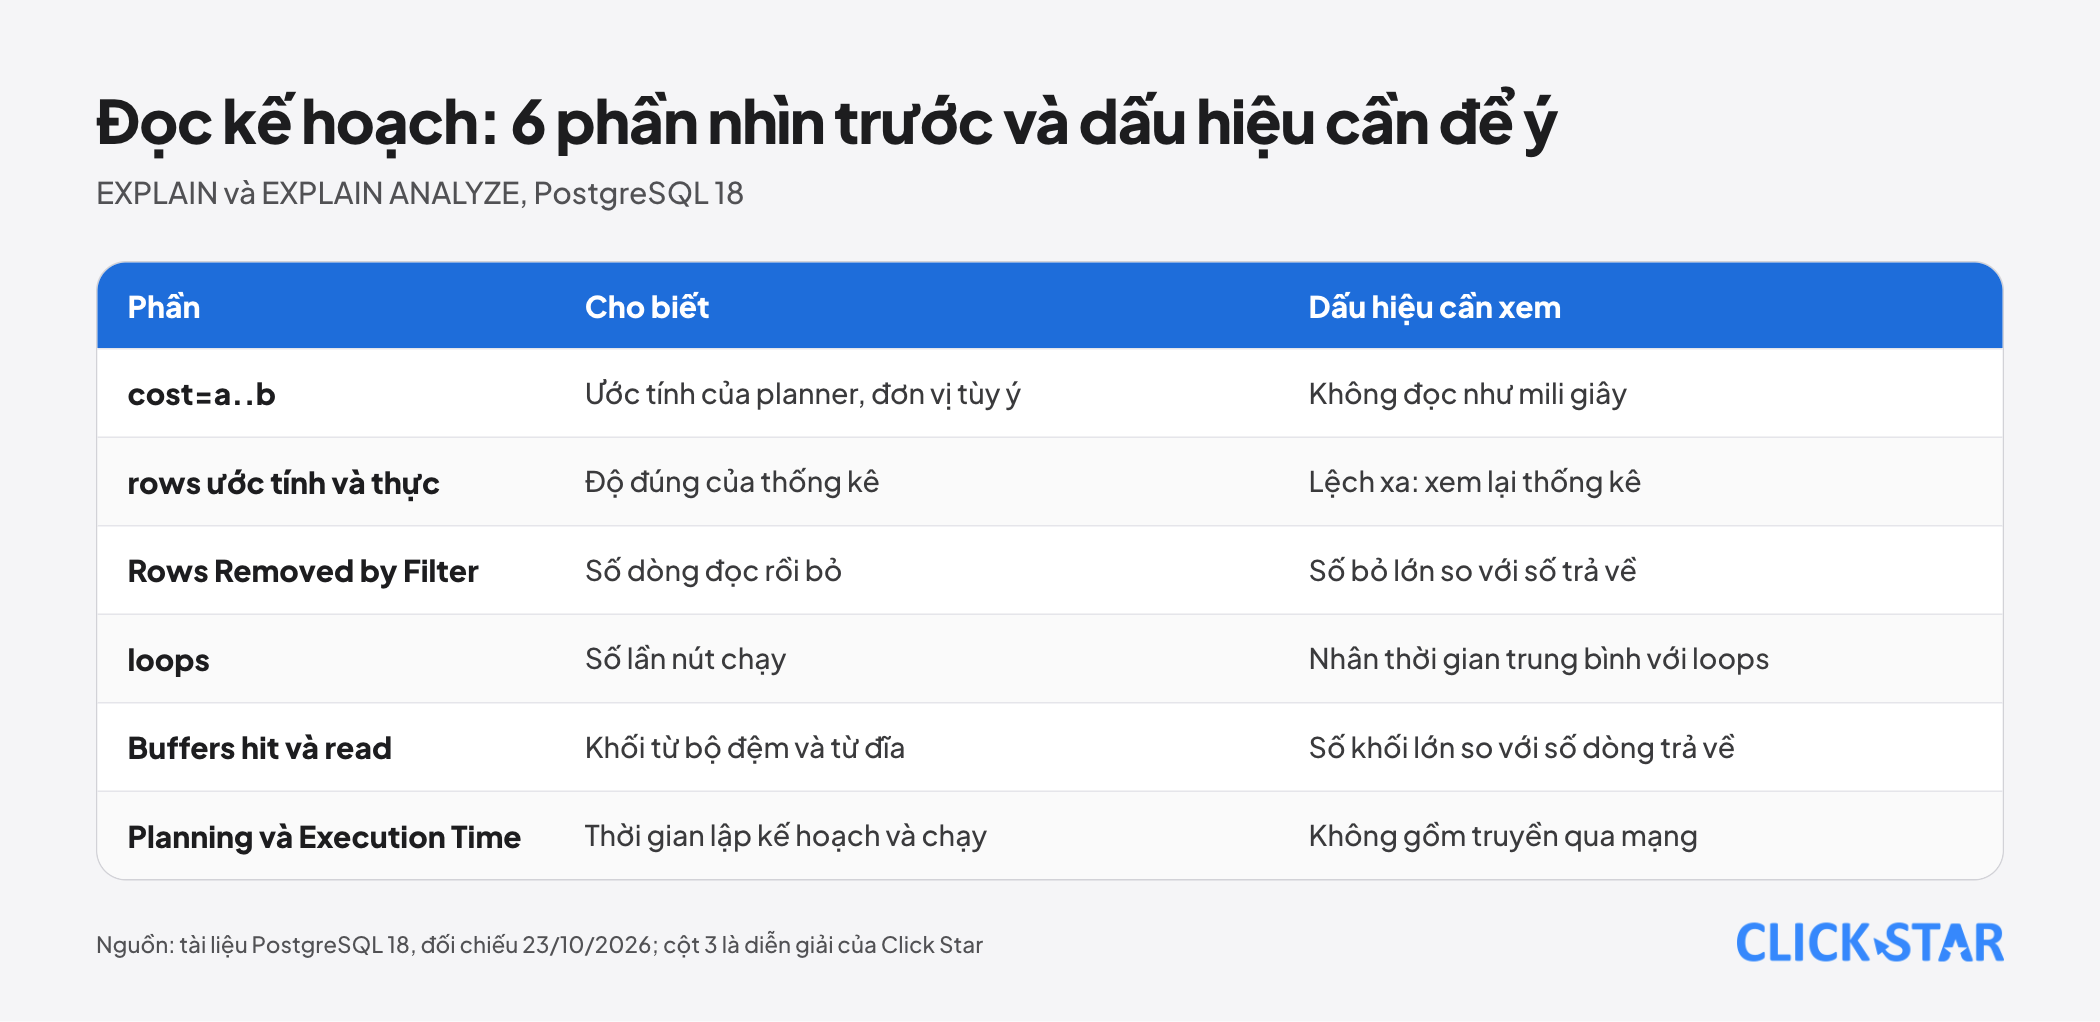
"Rows Removed by Filter" cho biết nút đã đọc rồi bỏ bao nhiêu dòng; Buffers cho biết số khối lấy từ bộ đệm (hit) hay từ đĩa (read). Cuối kế hoạch là Planning Time và Execution Time, không gồm truyền qua mạng. Theo ghi chú phát hành PostgreSQL 18 (25/9/2025), EXPLAIN ANALYZE từ bản này tự bật BUFFERS.
EXPLAIN ANALYZE thực sự chạy lệnh. Với INSERT, UPDATE, DELETE hoặc MERGE, tài liệu hướng dẫn bọc trong giao dịch rồi hoàn tác:
- BEGIN;
- EXPLAIN ANALYZE UPDATE orders SET status = 'paid' WHERE id = 10;
- ROLLBACK;
Dữ liệu được hoàn tác nhưng lệnh vẫn tốn tài nguyên khi chạy, và việc đo thời gian từng nút có thể tốn đáng kể trên máy đọc đồng hồ chậm.
Ví dụ: từ quét tuần tự đến chỉ mục
Ví dụ minh họa của Click Star, không phải số đo hiệu năng: PostgreSQL 16.2, bảng orders 200.000 dòng và customers 20.000 dòng sinh bằng generate_series. Truy vấn lấy đơn của 1 khách:
- EXPLAIN (ANALYZE, BUFFERS) SELECT id, total_vnd FROM orders WHERE customer_id = 1234;
Khi chưa có chỉ mục, kế hoạch quét tuần tự: bỏ 199.990 dòng, chạm 2.667 khối để trả 10 dòng. Sau khi tạo chỉ mục dưới đây, kế hoạch quét bitmap theo chỉ mục và chỉ chạm 15 khối.
- CREATE INDEX orders_customer_id_idx ON orders (customer_id);
Chọn loại chỉ mục theo toán tử trong WHERE
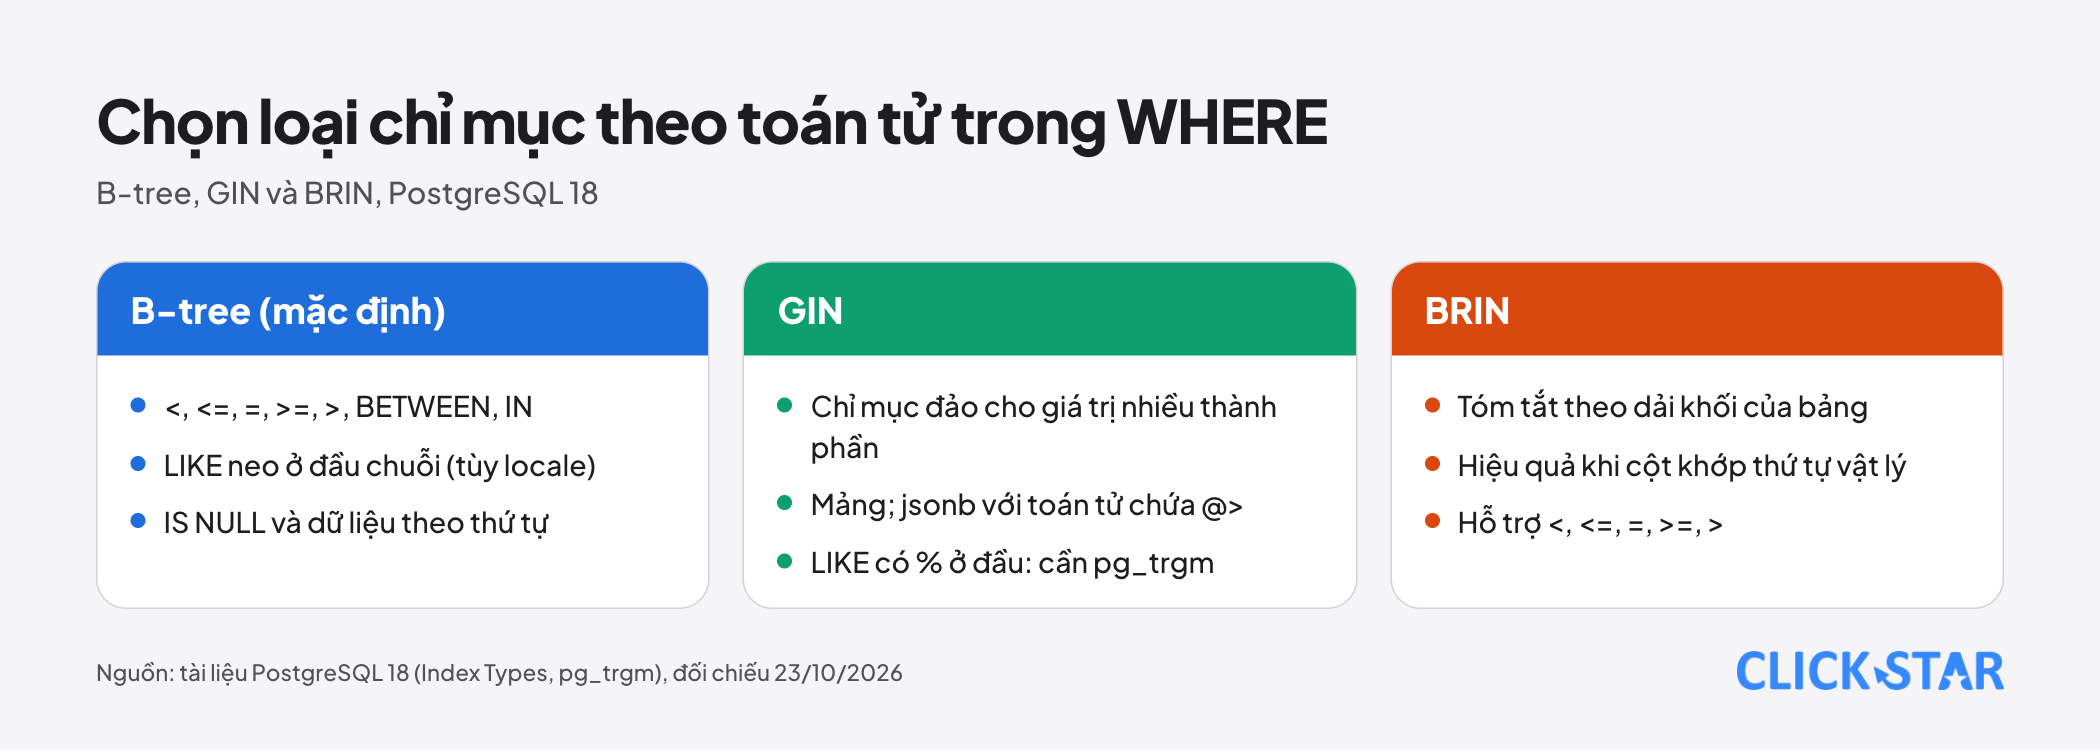
Theo mục Index Types, CREATE INDEX mặc định tạo B-tree; loại chỉ mục quyết định toán tử nào dùng được. Tài liệu liệt kê 6 loại có sẵn, Click Star tóm tắt 3 loại thường gặp (Hash chỉ so sánh bằng):
- B-tree: <, <=, =, >=, >, BETWEEN, IN, IS NULL, LIKE neo ở đầu chuỗi (ngoài locale C cần operator class riêng), và trả dữ liệu theo thứ tự.
- GIN: chỉ mục đảo cho giá trị nhiều thành phần như mảng; với jsonb hỗ trợ toán tử chứa @>.
- BRIN: tóm tắt theo dải khối, hiệu quả với cột khớp thứ tự vật lý của bảng, hỗ trợ <, <=, =, >=, >.
Chỉ mục nhiều cột hiệu quả nhất khi có điều kiện ở cột trái nhất, và hiếm khi có ích khi trên 3 cột. PostgreSQL 18 thêm skip scan, chủ yếu có ích khi cột đầu có ít giá trị khác nhau.
Chỉ mục có điều kiện lọc (partial index) chỉ chứa dòng thỏa điều kiện WHERE của nó. Trong ví dụ, 1% đơn có trạng thái pending; chỉ mục riêng cho nhóm này nặng 64 kB, so với 4.408 kB cho chỉ mục toàn bảng trên created_at. Truy vấn phải có điều kiện khớp mới dùng được.
- CREATE INDEX orders_pending_idx ON orders (created_at) WHERE status = 'pending';
Chỉ mục có giá: ghi chậm hơn, tốn chỗ
Theo tài liệu, giữ chỉ mục đồng bộ với bảng thêm chi phí cho mọi lệnh ghi và có thể ngăn tạo heap-only tuple, nên chỉ mục hiếm dùng cần bị xóa. Trong ví dụ minh họa, chèn 50.000 dòng vào bảng chỉ có khóa chính tạo khoảng 9,4 triệu byte WAL; thêm 4 chỉ mục thì khoảng 26,2 triệu byte, và dung lượng chỉ mục tăng từ 1.112 kB lên 6.880 kB.
Để tìm chỉ mục thừa, xem pg_stat_user_indexes (cột idx_scan, và last_idx_scan từ PostgreSQL 16); Advisors của Supabase cũng cảnh báo unused index, duplicate index và unindexed foreign keys.
Theo mục CREATE INDEX, lệnh thường chặn ghi (đọc vẫn được) đến khi xong. Với CONCURRENTLY, ghi không bị chặn nhưng phải quét bảng 2 lần và lâu hơn đáng kể; lệnh không chạy trong khối giao dịch, và nếu lỗi sẽ để lại chỉ mục INVALID cần xóa rồi tạo lại.
- CREATE INDEX CONCURRENTLY orders_customer_id_idx ON orders (customer_id);
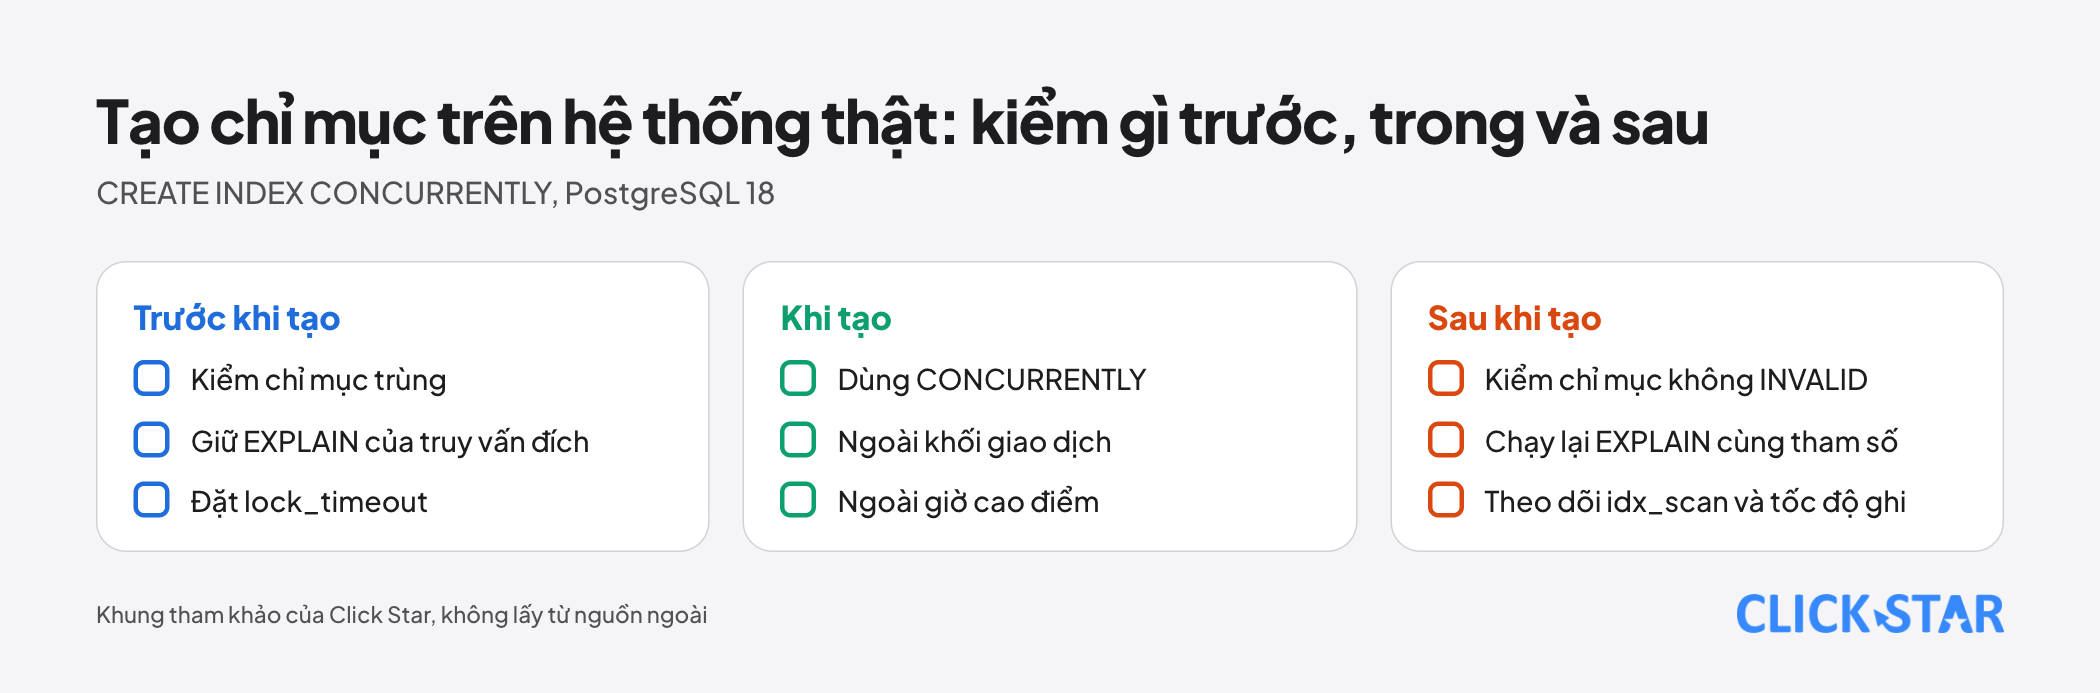
Khung tham khảo của Click Star, không lấy từ nguồn ngoài. Trước khi tạo: kiểm chỉ mục trùng, giữ EXPLAIN của truy vấn đích, đặt lock_timeout. Khi tạo: dùng CONCURRENTLY, ngoài khối giao dịch, ngoài giờ cao điểm. Sau khi tạo: kiểm không INVALID, chạy lại EXPLAIN cùng tham số, theo dõi idx_scan và tốc độ ghi.
Những lỗi khiến chỉ mục không được dùng
Chỉ mục phục vụ điều kiện dạng cột, toán tử, giá trị; chỉ mục biểu thức thì truy vấn phải khớp biểu thức (phần giới thiệu chỉ mục). Dưới đây là 5 lỗi Click Star tái hiện trên PostgreSQL 16.2 hoặc có trong tài liệu.
1. Hàm hoặc ép kiểu bọc cột. Điều kiện created_at::date = DATE '2026-03-15' bị quét tuần tự (2.667 khối). Viết thành khoảng nửa mở trên cột gốc thì dùng được chỉ mục B-tree trên created_at, chỉ chạm 27 khối:
- SELECT count(*) FROM orders WHERE created_at >= '2026-03-15' AND created_at < '2026-03-16';
Lập chỉ mục trên (created_at::date) bị từ chối với lỗi "functions in index expression must be marked IMMUTABLE": danh mục hệ thống 16.2 xếp date(timestamptz) là STABLE (phụ thuộc múi giờ phiên). Viết rõ múi giờ thì chạy được, và truy vấn phải dùng đúng biểu thức đó:
- CREATE INDEX orders_created_date_vn_idx ON orders (((created_at AT TIME ZONE 'Asia/Ho_Chi_Minh')::date));
2. So sánh không phân biệt hoa thường. lower(email) = '[email protected]' bị quét tuần tự (bỏ 19.999 dòng) cho đến khi có chỉ mục biểu thức:
- CREATE INDEX customers_lower_email_idx ON customers (lower(email));
3. LIKE bắt đầu bằng %. B-tree chỉ dùng khi mẫu neo ở đầu chuỗi. Trong thử nghiệm, LIKE '%[email protected]' vẫn quét tuần tự dù cột email có chỉ mục B-tree. Tài liệu pg_trgm nói chỉ mục trigram hỗ trợ LIKE không cần neo; Click Star chưa chạy thử vì máy kiểm tra thiếu mô-đun này, cú pháp lấy từ tài liệu:
- CREATE EXTENSION pg_trgm;
- CREATE INDEX customers_email_trgm_idx ON customers USING gin (email gin_trgm_ops);
4. Khóa ngoại thiếu chỉ mục ở bảng con. Tài liệu nói khóa ngoại không tự tạo chỉ mục cho cột tham chiếu, trong khi xóa dòng ở bảng cha phải quét bảng con. Trong ví dụ, xóa 1 khách chưa có đơn mất vài mili giây khi thiếu chỉ mục và dưới 1 mili giây khi đã có (minh họa; chạy lặp dao động mạnh).
5. Thống kê cũ. Autovacuum chạy ANALYZE khi số dòng thay đổi vượt ngưỡng mặc định 50 dòng cộng 10% kích thước bảng. Trong ví dụ, bảng tắt autovacuum đã ANALYZE khi có 50.000 dòng kind = 'view', rồi chèn thêm 50.000 dòng 'purchase'; truy vấn ước tính 1 dòng so với 50.000 thực; sau ANALYZE, ước tính thành 49.987 và kế hoạch đổi sang quét bitmap.
Tìm truy vấn đáng sửa bằng pg_stat_statements
Theo tài liệu, pg_stat_statements theo dõi thống kê lập kế hoạch và thực thi của mọi câu lệnh. Phải thêm vào shared_preload_libraries (cần khởi động lại), rồi chạy CREATE EXTENSION trong từng cơ sở dữ liệu. Trên Supabase, bật qua Dashboard, mục Extensions.
Truy vấn dưới đây sắp theo tổng thời gian để thấy truy vấn tốn nhất (cú pháp đã kiểm trên bảng giả); sắp theo mean_exec_time sẽ thấy truy vấn chậm từng lần.
- SELECT queryid, calls, round(total_exec_time::numeric, 1) AS total_ms, round(mean_exec_time::numeric, 2) AS mean_ms, rows, left(query, 80) AS query_start FROM pg_stat_statements ORDER BY total_exec_time DESC LIMIT 10;
Hằng số được thay bằng $1, $2, nhưng tài liệu nói chúng vẫn có thể hiện ra khi các mục bị thay thế nhiều. Ngoài ra, log_min_duration_statement ghi nhật ký câu lệnh chậm, còn auto_explain ghi kế hoạch của câu lệnh chậm và mặc định ghi đầy đủ giá trị tham số (auto_explain.log_parameter_max_length), có thể chứa dữ liệu khách hàng.
Bối cảnh Việt Nam và Supabase
Click Star không tìm thấy số đo công khai về truy vấn chậm của doanh nghiệp Việt Nam; kết luận ở đây dựa trên tài liệu kỹ thuật và ví dụ giả.
Hướng dẫn tối ưu truy vấn của Supabase (không ghi ngày, đọc 23/10/2026) khớp với tài liệu PostgreSQL và khuyên bỏ chỉ mục nếu nó không giảm chi phí kế hoạch. Với chính sách bảo mật hàng (RLS), hướng dẫn RLS của Supabase khuyên lập chỉ mục cho mọi cột chính sách lọc, và nêu khóa chính (team_id, user_id) chủ yếu phục vụ team_id.
Đánh giá của Click Star. Chỉ mục mạnh nhưng không miễn phí; thứ tự hợp lý là đo trước, sửa truy vấn hoặc thống kê, rồi mới thêm chỉ mục. Click Star làm phần mềm theo yêu cầu, CRM, CDP và dashboard dữ liệu nên có lợi ích kinh doanh khi doanh nghiệp cần các dịch vụ đó; nhận định này chỉ dựa trên tài liệu công khai.
Việc nên làm: 5 bước và cách đo
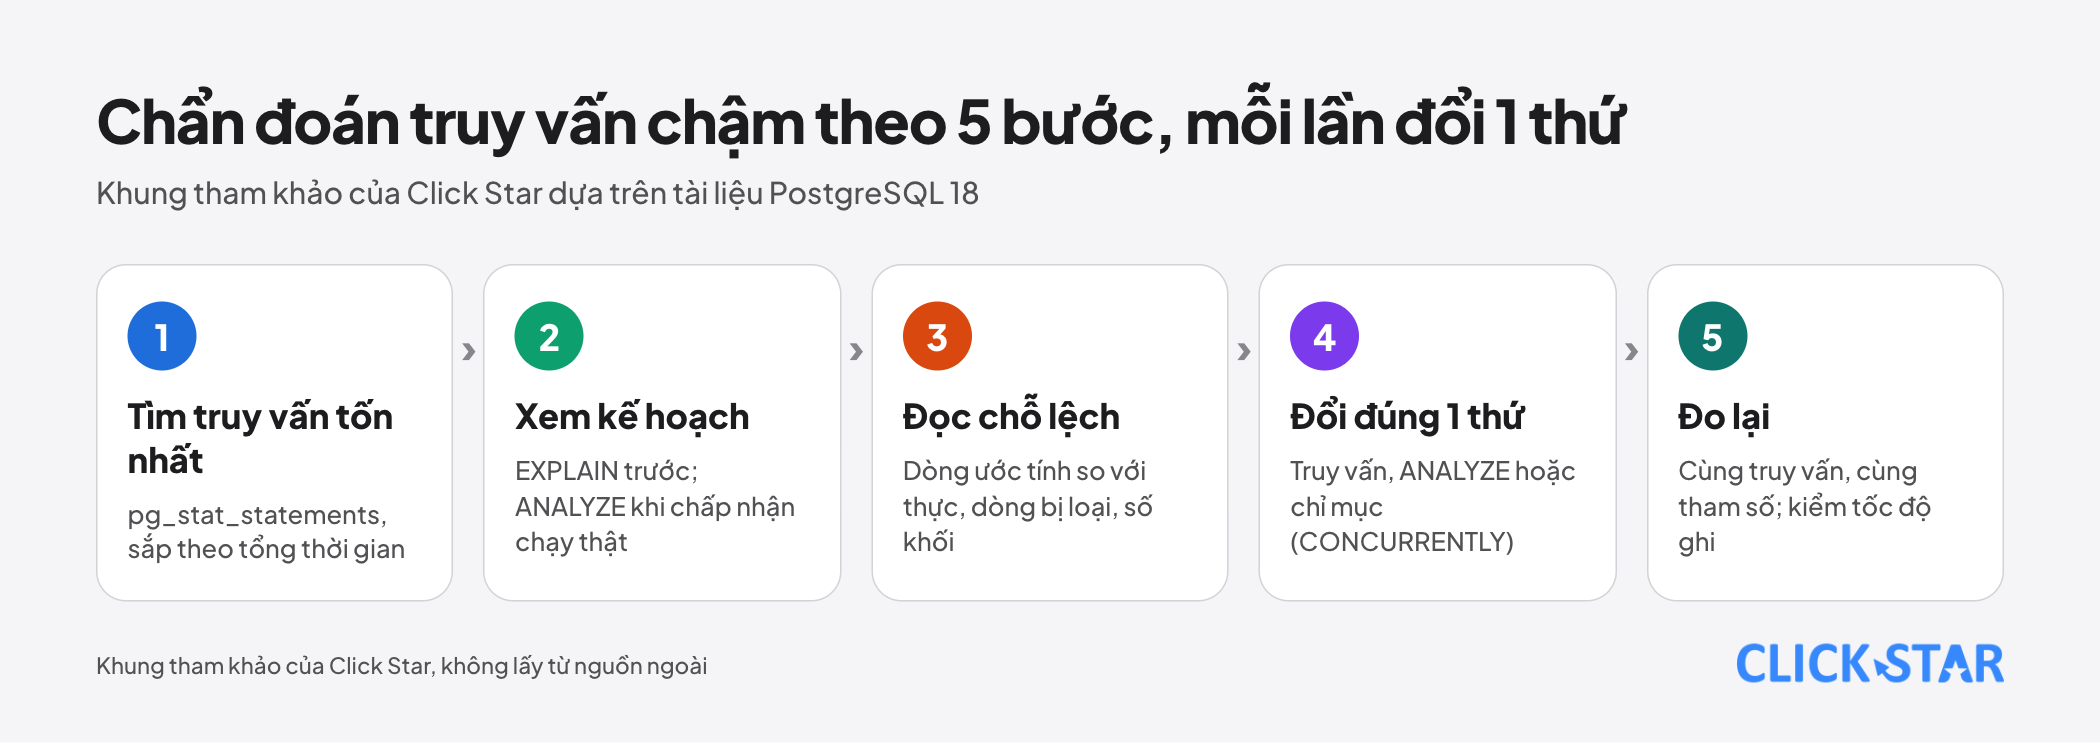
Khung tham khảo của Click Star, không lấy từ nguồn ngoài, tương ứng hình đầu bài:
- Bước 1: tìm truy vấn tốn nhất bằng pg_stat_statements thay vì đoán.
- Bước 2: chạy EXPLAIN trước, chỉ thêm ANALYZE khi chấp nhận để lệnh chạy thật; đặt giới hạn thời gian cho phiên.
- Bước 3: đọc chỗ lệch: số dòng ước tính so với thực, dòng bị loại, số khối chạm.
- Bước 4: đổi đúng 1 thứ (sửa truy vấn, ANALYZE hoặc chỉ mục) và tạo chỉ mục bằng CONCURRENTLY.
- Bước 5: đo lại cùng truy vấn, cùng tham số, rồi kiểm tốc độ ghi.
Đặt giới hạn thời gian theo phiên (tài liệu không khuyên đặt trong postgresql.conf):
- SET statement_timeout = '30s';
- SET lock_timeout = '5s';
Hãy RESET statement_timeout trước khi tạo chỉ mục dài: lệnh CONCURRENTLY bị hủy giữa chừng có thể để lại chỉ mục INVALID.
Cách đo: tổng thời gian và số lần gọi trong pg_stat_statements trước và sau, số khối chạm và dòng bị loại trong EXPLAIN, và WAL qua tùy chọn WAL của EXPLAIN.
Những sai lầm thường gặp
- Thêm chỉ mục lên mọi cột "cho chắc".
- Đọc chi phí trong EXPLAIN như mili giây, hoặc kết luận từ bảng thử quá nhỏ.
- Chạy EXPLAIN ANALYZE cho lệnh ghi mà không bọc BEGIN và ROLLBACK.
- Tạo chỉ mục trên bảng đang ghi mà không dùng CONCURRENTLY.
- Bọc cột trong hàm hoặc ép kiểu rồi thắc mắc vì sao chỉ mục không được dùng.
- Quên chỉ mục cho khóa ngoại và cột trong chính sách RLS, hoặc dán kế hoạch chứa dữ liệu khách hàng lên công cụ bên ngoài.
Điều chưa biết
Click Star không có số đo cải thiện trên hệ thống thật của doanh nghiệp Việt Nam; các ví dụ là 1 đến 2 lần chạy trên dữ liệu giả, không đại diện cho tải thật. pg_trgm và pg_stat_statements chỉ được đối chiếu với tài liệu.
Chưa có nguồn công khai về ngưỡng chung cho "truy vấn chậm" hay số chỉ mục nên có. Hãy hỏi chuyên gia khi bảng rất lớn hoặc dùng phân vùng.
Bài liên quan



Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.