Cách sử dụng AI tối ưu token: 9 kỹ thuật giảm chi phí mà không giảm chất lượng
9 kỹ thuật tối ưu token đã được tài liệu Anthropic xác nhận, từ chọn model, mức nỗ lực, bộ nhớ đệm đến Batch API, kèm ví dụ tính chi phí từng bước cho một bot hỗ trợ khách và kế hoạch 14 ngày.
Chi phí dùng AI qua API và giới hạn dùng trong ứng dụng đều tính bằng token, nhưng hầu hết đội ngũ chỉ phát hiện mình tốn token khi hóa đơn đến hoặc khi bị chạm giới hạn.
Bài này gom 9 kỹ thuật tối ưu token đã được tài liệu chính thức của Anthropic xác nhận, kèm một ví dụ tính chi phí từng bước để thấy mỗi kỹ thuật tiết kiệm được bao nhiêu và rủi ro đi kèm là gì.
Giá và tham số lấy từ tài liệu Pricing, Prompt caching, Effort, Token counting và Context editing của Claude Platform, đối chiếu đến ngày 20/10/2026; nhiều nhà cung cấp khác có cơ chế tương tự nhưng tên gọi, giá và điều kiện khác nhau, nên cần đối chiếu tài liệu của từng hãng.
Click Star đã có bài về cách sử dụng GPT tối ưu và bài phân tích các model Claude; bài này tập trung vào token.
Điểm chính
- Token là đơn vị tính tiền và tính giới hạn, và số token của cùng một nội dung phụ thuộc vào model, ngôn ngữ và loại nội dung: Anthropic nêu rõ bộ mã hóa văn bản từ Claude 4.7 cho nhiều hơn khoảng 30% token trên cùng một văn bản, nên hãy đếm thử bằng chính văn bản tiếng Việt của bạn thay vì giả định.
- Đo trước khi tối ưu: việc đếm token của Anthropic miễn phí và trả về số token đầu vào trước khi gửi yêu cầu; phản hồi của API cũng cho biết số token đọc từ bộ nhớ đệm, ghi vào bộ nhớ đệm và không nằm trong bộ nhớ đệm.
- Kỹ thuật có tác động lớn nhất thường là chọn đúng model: ở cùng thời điểm, giá đầu vào của Opus 5.5 là 4 USD, Sonnet 5.5 là 2 USD và Haiku 5.5 là 0,10 USD cho mỗi triệu token, tức chênh tới 40 lần giữa hai đầu.
- Bộ nhớ đệm prompt (prompt caching) giảm giá phần đầu vào lặp lại xuống còn 5% giá chuẩn ở Opus 5.5 và Sonnet 5.5 (10% ở Haiku 5.5, 2,5% ở Fable 5.1), và Batch API giảm 50% cho việc không gấp; theo trang giá của Anthropic, 2 mức giảm này cộng dồn được.
- Sau khi dùng cache, đầu ra thành khoản chi lớn nhất (giá đầu ra gấp 5 lần giá đầu vào ở cả 4 model hiện hành), nên giới hạn độ dài đầu ra và chọn mức nỗ lực phù hợp quan trọng ngang việc cắt đầu vào.
- Trong ví dụ minh họa của Click Star (một bot hỗ trợ khách 100.000 yêu cầu mỗi tháng), cache giảm chi phí niêm yết khoảng 68% trên Sonnet 5.5, và đổi sang Haiku 5.5 kèm cache giảm thêm, với điều kiện chất lượng vẫn đạt trên bộ kiểm tra của chính bạn.
Token là gì và vì sao hóa đơn thường lệch dự tính
Token là mẩu văn bản (từ, một phần của từ, dấu câu) mà model xử lý; mỗi yêu cầu tính tiền theo số token đầu vào và số token đầu ra, với đơn giá khác nhau. Đầu vào gồm mọi thứ bạn gửi: chỉ dẫn hệ thống, định nghĩa công cụ, tài liệu đính kèm, toàn bộ lịch sử hội thoại và câu hỏi mới.
Đầu ra gồm câu trả lời và, với model có suy nghĩ, cả phần suy nghĩ. Anthropic nêu rõ phần suy nghĩ tính vào giới hạn max_tokens và vào token đầu ra.
Có 4 nguồn gây lệch. Một, lịch sử hội thoại được gửi lại ở mỗi lượt nên chi phí tăng dần theo độ dài cuộc trò chuyện. Hai, đầu ra đắt gấp 5 lần đầu vào ở các model Claude hiện hành. Ba, phần suy nghĩ cũng là token đầu ra. Bốn, ảnh và PDF cũng quy ra token và có thể rất lớn.
Bước 0: đo trước khi tối ưu
- Đếm token trước khi gửi. Điểm cuối đếm token nhận cùng đầu vào như yêu cầu tạo tin nhắn (chỉ dẫn hệ thống, công cụ, ảnh, PDF dạng base64) và trả về số token đầu vào; đây là ước lượng, có thể lệch nhỏ, miễn phí và có giới hạn số yêu cầu mỗi phút theo bậc sử dụng (5.000 ở bậc Start). Nó không dùng bộ nhớ đệm và không hỗ trợ một số công cụ phía máy chủ.
- Đọc trường usage của phản hồi. Tổng token đầu vào bằng token đọc từ cache cộng token ghi vào cache cộng token đầu vào không nằm trong cache; nếu hai trường về cache đều bằng 0 thì prompt không được cache (thường vì ngắn hơn ngưỡng tối thiểu).
- Đo chi phí cho mỗi việc đạt, không chỉ cho mỗi yêu cầu. Một model rẻ nhưng phải làm lại 3 lần có thể đắt hơn model vừa.
Kỹ thuật 1. Chọn đúng model cho từng việc
Giá đầu vào hiện hành cho mỗi triệu token: Fable 5.1 là 10 USD, Opus 5.5 là 4 USD, Sonnet 5.5 là 2 USD, Haiku 5.5 là 0,10 USD (đến 100.000 token mỗi prompt). Anthropic gợi ý dùng Haiku cho việc đơn giản, Sonnet cho hầu hết khối lượng sản xuất và Opus cho suy luận phức tạp nhất.
Cách làm: chạy cùng bộ mẫu việc thật trên 2 đến 3 model, chọn model rẻ nhất đạt tiêu chí cho từng loại việc; Click Star mô tả quy trình thử 14 ngày trong bài phân tích các model Claude.
Kỹ thuật 2. Hạ mức nỗ lực khi việc đơn giản
Tham số effort điều chỉnh lượng token model dùng cho toàn bộ phản hồi: lời giải thích, tham số gọi công cụ và suy nghĩ. Có 5 mức: low, medium, high, xhigh, max. Mặc định là medium ở Opus 5.5 và Haiku 5.5, high ở các model còn lại.
Anthropic mô tả low là mức hiệu quả nhất, hợp với việc đơn giản cần nhanh và rẻ, và với công cụ thì mức thấp thường gộp nhiều thao tác vào ít lần gọi hơn và bỏ lời dẫn.
Lưu ý: effort là tín hiệu hành vi, không phải ngân sách token cứng; và trên Opus 5, Anthropic nói đổi effort không chắc rút ngắn câu trả lời hiển thị, nên muốn câu ngắn phải yêu cầu độ dài trong prompt.
Kỹ thuật 3. Giới hạn đầu ra: độ dài và định dạng
Vì đầu ra gấp 5 lần giá đầu vào, nên mỗi câu trả lời dài thừa tốn nhiều hơn mỗi tài liệu đính kèm thừa. Hãy yêu cầu độ dài và định dạng cụ thể (ví dụ "tối đa 120 từ, 3 gạch đầu dòng"), yêu cầu bỏ phần nhắc lại câu hỏi và bỏ lời mở đầu, và dùng định dạng có cấu trúc (JSON gọn) khi kết quả đi vào hệ thống khác.
Đặt max_tokens như giới hạn cứng nhưng đủ chỗ cho cả suy nghĩ và câu trả lời, vì khi suy nghĩ tốn hết giới hạn thì câu trả lời bị cắt cụt; Anthropic khuyên đặt giá trị lớn ở mức nỗ lực cao.
Kỹ thuật 4. Bộ nhớ đệm prompt cho phần lặp lại
Bộ nhớ đệm dùng lại phần đầu prompt đã xử lý. Có 2 cách bật: tự động (một trường cache_control ở cấp cao nhất, điểm cache dịch theo cuộc hội thoại) và thủ công (đặt cache_control trên từng khối, tối đa 4 điểm).
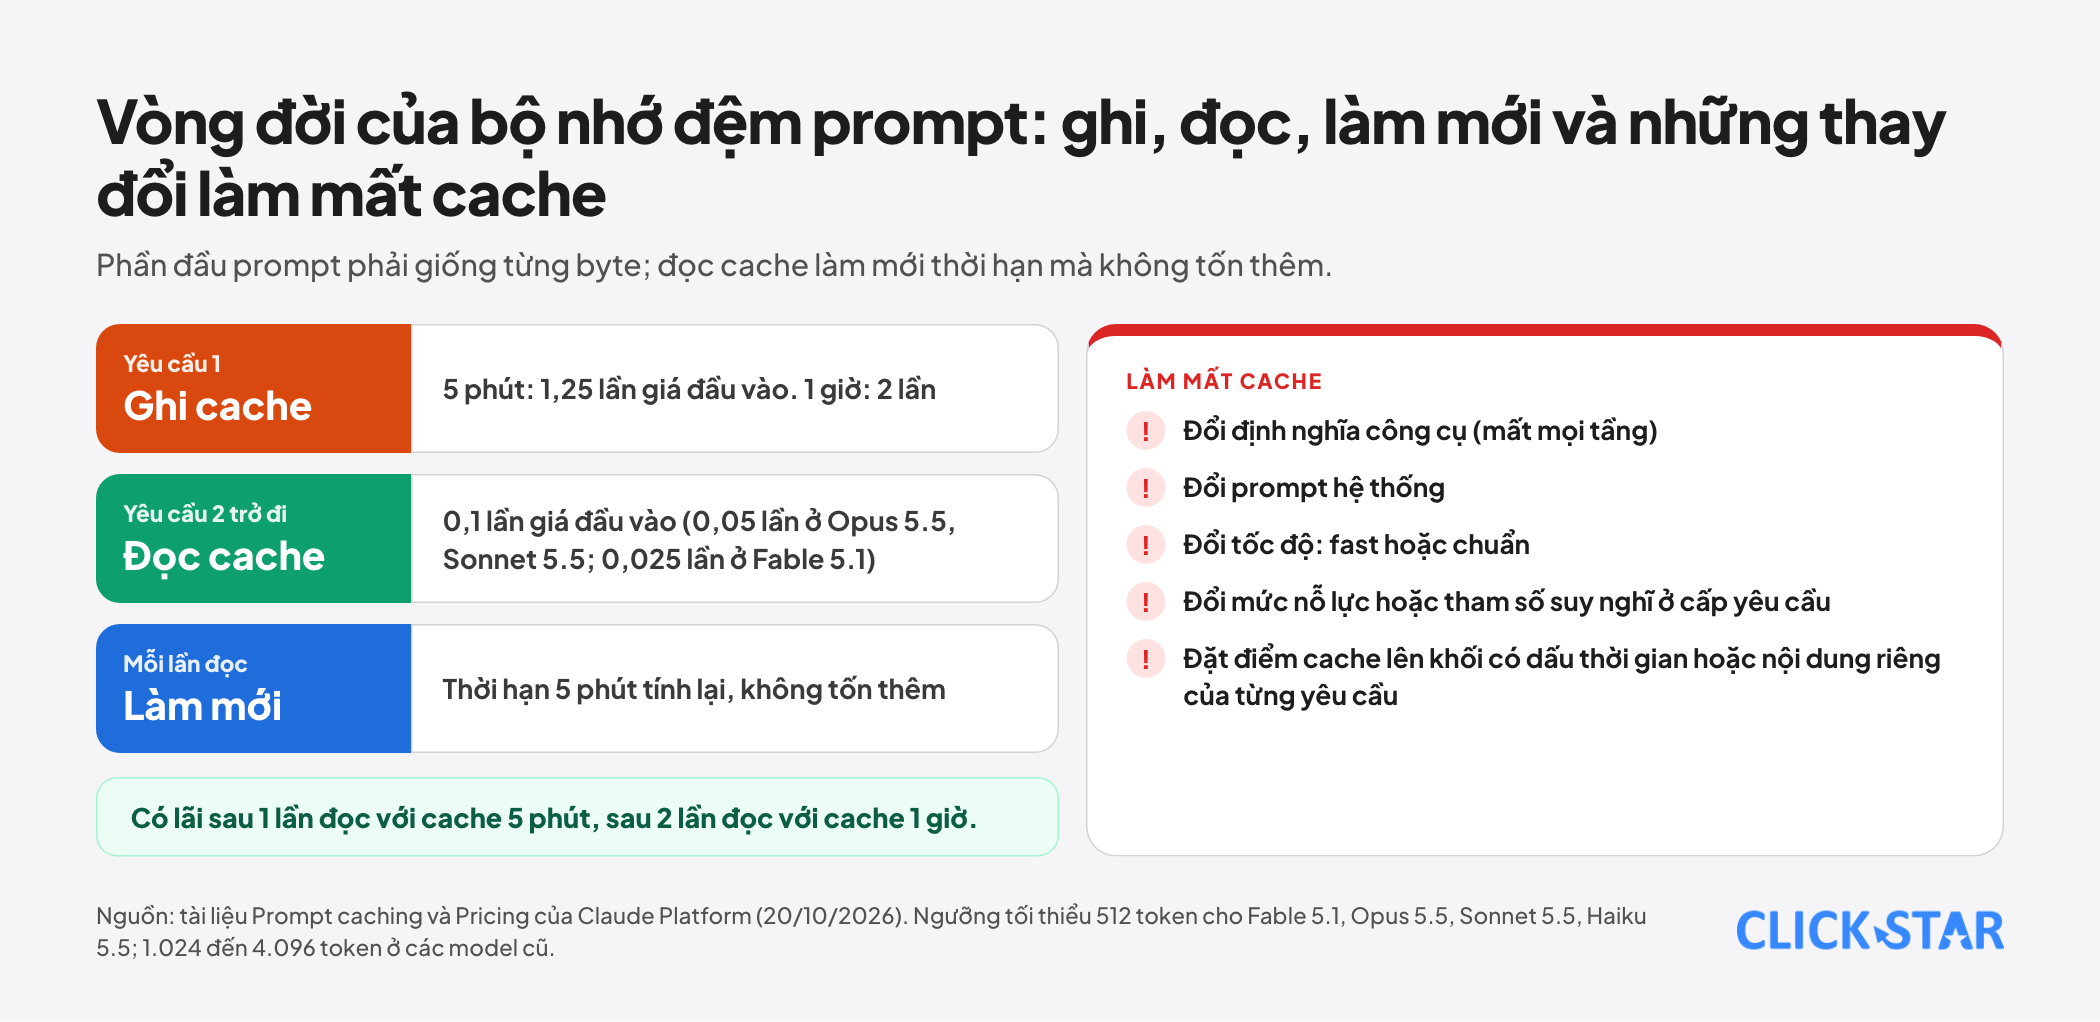
Quy tắc tính tiền so với giá đầu vào chuẩn: ghi cache 5 phút là 1,25 lần, ghi cache 1 giờ là 2 lần, đọc cache là 0,1 lần (0,05 lần ở Opus 5.5 và Sonnet 5.5, 0,025 lần ở Fable 5.1). Nghĩa là cache 5 phút có lãi sau 1 lần đọc, cache 1 giờ có lãi sau 2 lần đọc.
Điều kiện để hiệu quả. Prompt phải đạt ngưỡng tối thiểu (512 token cho cả 4 model hiện hành, 1.024 đến 4.096 ở các model cũ); phần đầu prompt phải giống từng byte, và điểm cache phải đặt ở khối cuối cùng không đổi giữa các yêu cầu.
Lỗi hay gặp nhất là đặt điểm cache lên khối có dấu thời gian hoặc nội dung riêng của từng yêu cầu: khi đó mỗi yêu cầu đều ghi cache và không bao giờ đọc được. Thời hạn mặc định là 5 phút và được làm mới miễn phí mỗi lần dùng; dùng 1 giờ khi khoảng cách giữa các lần dùng từ 5 phút đến 1 giờ.
Gửi các yêu cầu song song trước khi lần đầu hoàn thành sẽ không trúng cache, vì mục cache chỉ tồn tại sau khi phản hồi đầu bắt đầu.
Những thay đổi làm mất cache: đổi định nghĩa công cụ (làm mất mọi tầng), đổi prompt hệ thống, đổi tốc độ (fast hoặc chuẩn), đổi tham số suy nghĩ hoặc mức nỗ lực ở cấp yêu cầu. Vì vậy hãy giữ công cụ và chỉ dẫn hệ thống ổn định, đặt phần cố định ở đầu và phần thay đổi ở cuối.
Kỹ thuật 5. Batch API cho việc không gấp
Batch API xử lý bất đồng bộ với mức giảm 50% cho cả đầu vào và đầu ra, hợp với việc như phân loại hàng loạt, tóm tắt kho tài liệu hay chấm điểm dữ liệu cũ. Theo trang giá của Anthropic, mức giảm này cộng dồn với hệ số bộ nhớ đệm. Giới hạn: không dùng được cùng chế độ nhanh; và không phải việc nào cũng chờ được.
Kỹ thuật 6. Quản lý ngữ cảnh khi hội thoại dài
Với tác tử hoặc cuộc hội thoại dài, ngữ cảnh phình lên ở mỗi lượt. Anthropic khuyến nghị tóm tắt phía máy chủ (compaction) cho hội thoại dài, và cung cấp thêm chỉnh sửa ngữ cảnh: xóa kết quả công cụ cũ khi prompt vượt ngưỡng (mặc định 100.000 token, giữ 3 lần dùng công cụ gần nhất) và xóa khối suy nghĩ cũ.
Cơ chế này ở bản beta, cần tiêu đề beta, và việc xóa kết quả công cụ làm mất cache ở phần bị xóa, nên cần đặt mức xóa tối thiểu để đáng giá. Với cách tóm tắt ở phía SDK, Anthropic nêu kết quả điển hình là từ khoảng 100.000 token xuống còn 2.000 đến 3.000 token, nhưng cách này đã bị đánh dấu không khuyến khích trong một số SDK.
Kỹ thuật 7. Giữ định nghĩa công cụ và kết quả công cụ gọn
Định nghĩa công cụ là token đầu vào ở mỗi yêu cầu, và đổi chúng làm mất cache ở mọi tầng. Hãy chỉ đưa công cụ cần dùng cho tác vụ, viết mô tả ngắn và chính xác, và để công cụ trả về phần dữ liệu cần thiết thay vì cả bản ghi. Kết quả công cụ dài là nguồn phình ngữ cảnh phổ biến nhất ở tác tử.
Kỹ thuật 8. Làm sạch đầu vào
Đừng dán cả tài liệu khi chỉ cần một phần: trích đoạn liên quan (có thể bằng bước tìm kiếm trước), bỏ phần lặp, bỏ chữ ký, đường dẫn dài và dữ liệu thừa. Ảnh và PDF quy ra nhiều token; chỉ gửi trang hoặc vùng ảnh cần thiết. Với tiếng Việt, đếm thử vì số token phụ thuộc ngôn ngữ và loại nội dung, và Anthropic nói rõ đếm lại khi đổi model.
Kỹ thuật 9. Chia việc, không nhồi một prompt khổng lồ
Việc phức tạp chia thành các bước nhỏ cho phép dùng model rẻ cho bước đơn giản (phân loại, trích xuất) và model mạnh cho bước khó. Đây là cách dùng Haiku làm tầng đầu và chỉ chuyển lên Sonnet hoặc Opus khi cần. Đổi lại cần thiết kế luồng và kiểm tra lỗi ở từng bước.
Ví dụ tính chi phí: một bot hỗ trợ khách
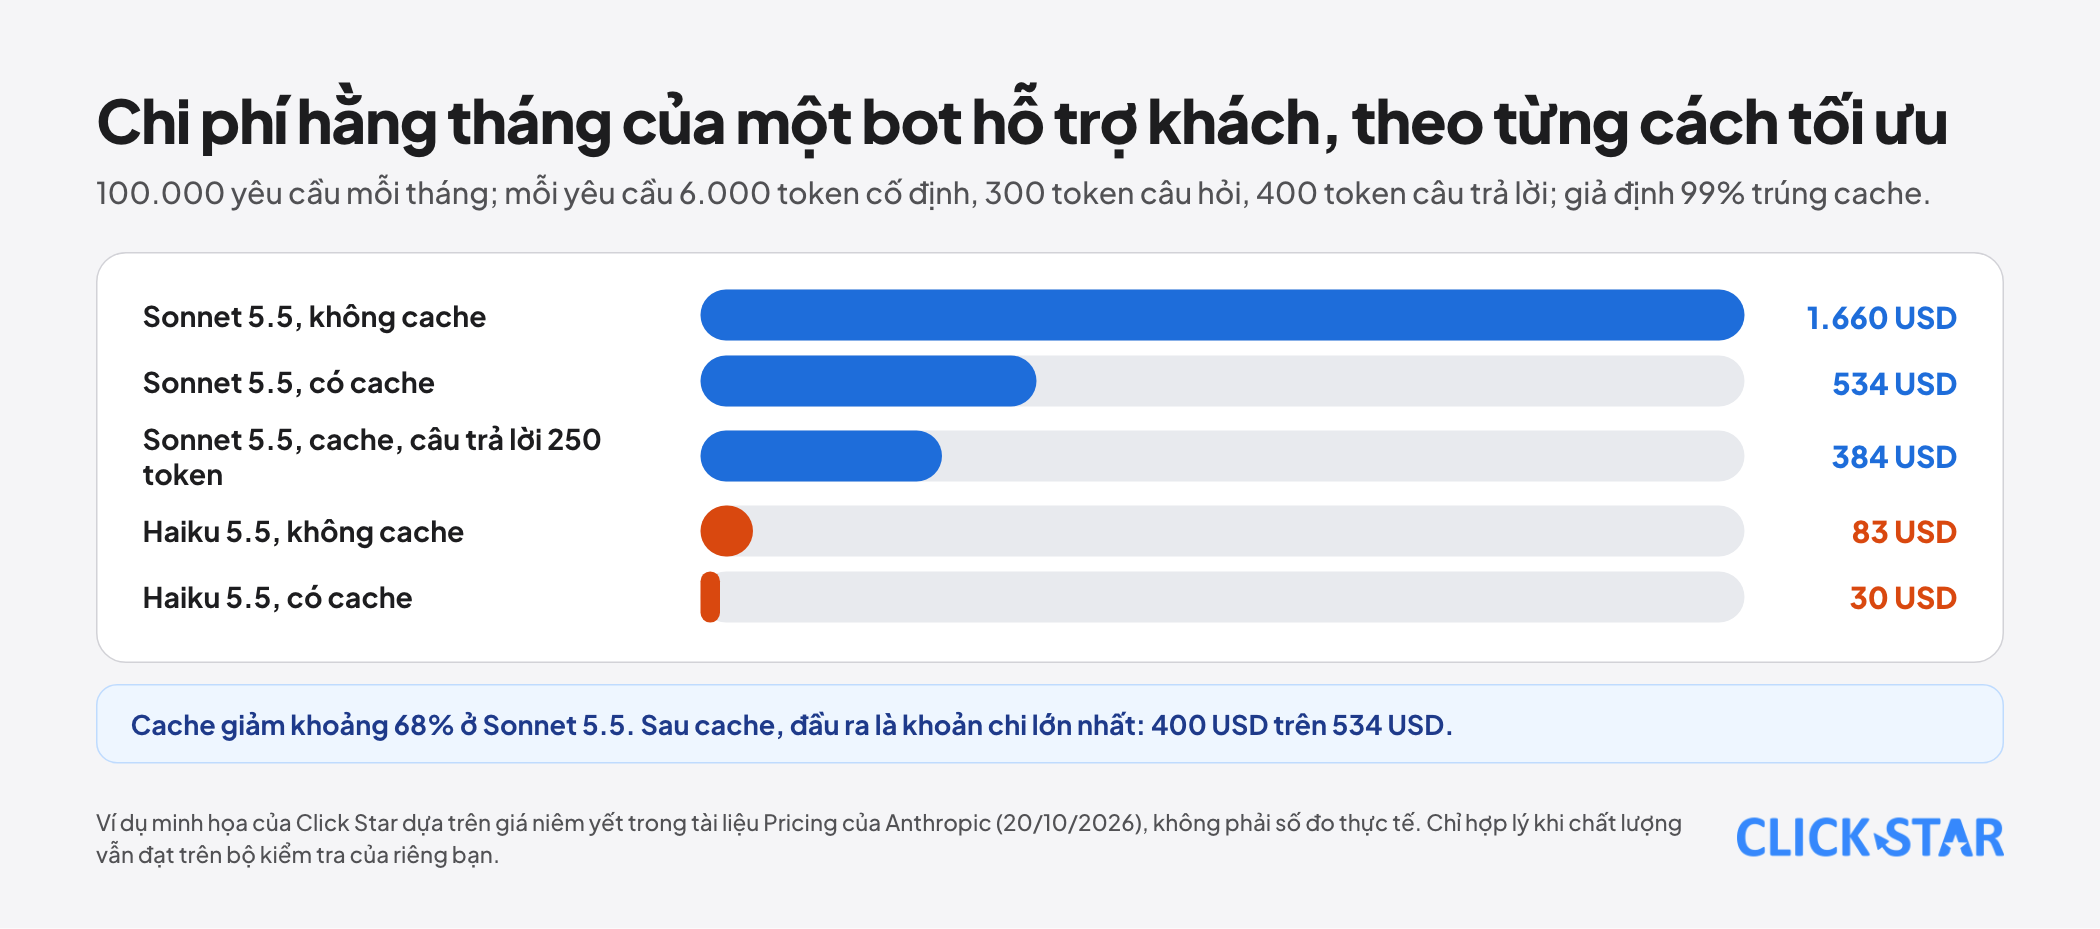
Đây là ví dụ minh họa của Click Star dựa trên giá niêm yết, không phải số đo thực tế. Giả định: 100.000 yêu cầu mỗi tháng; mỗi yêu cầu có 6.000 token cố định (chỉ dẫn hệ thống và kiến thức), 300 token câu hỏi mới và 400 token câu trả lời; prompt dưới 100.000 token; với cache giả định 1% yêu cầu phải ghi lại cache và 99% đọc cache.
- Sonnet 5.5, không cache: đầu vào 630 triệu token nhân 2 USD là 1.260 USD; đầu ra 40 triệu token nhân 10 USD là 400 USD; tổng khoảng 1.660 USD.
- Sonnet 5.5, có cache: ghi cache 6 triệu token nhân 2,50 USD là 15 USD; đọc cache 594 triệu token nhân 0,10 USD là 59,40 USD; đầu vào mới 30 triệu token nhân 2 USD là 60 USD; đầu ra 400 USD; tổng khoảng 534 USD, giảm khoảng 68%.
- Sonnet 5.5, có cache, câu trả lời rút từ 400 xuống 250 token: đầu ra còn 250 USD; tổng khoảng 384 USD, giảm thêm khoảng 28%.
- Haiku 5.5, không cache: đầu vào 630 triệu token nhân 0,10 USD là 63 USD; đầu ra 40 triệu token nhân 0,50 USD là 20 USD; tổng khoảng 83 USD.
- Haiku 5.5, có cache: khoảng 30 USD (ghi 0,75 USD, đọc 5,94 USD, đầu vào mới 3 USD, đầu ra 20 USD).
Hai nhận xét. Cache giảm mạnh phần đầu vào nhưng đầu ra vẫn là 400 USD, nên sau cache thì độ dài câu trả lời là đòn bẩy lớn nhất. Và đổi model chỉ hợp lý khi bộ kiểm tra của bạn cho thấy chất lượng vẫn đạt; chênh lệch từ 534 xuống 30 USD không có nghĩa gì nếu model rẻ trả lời sai nhiều hơn.
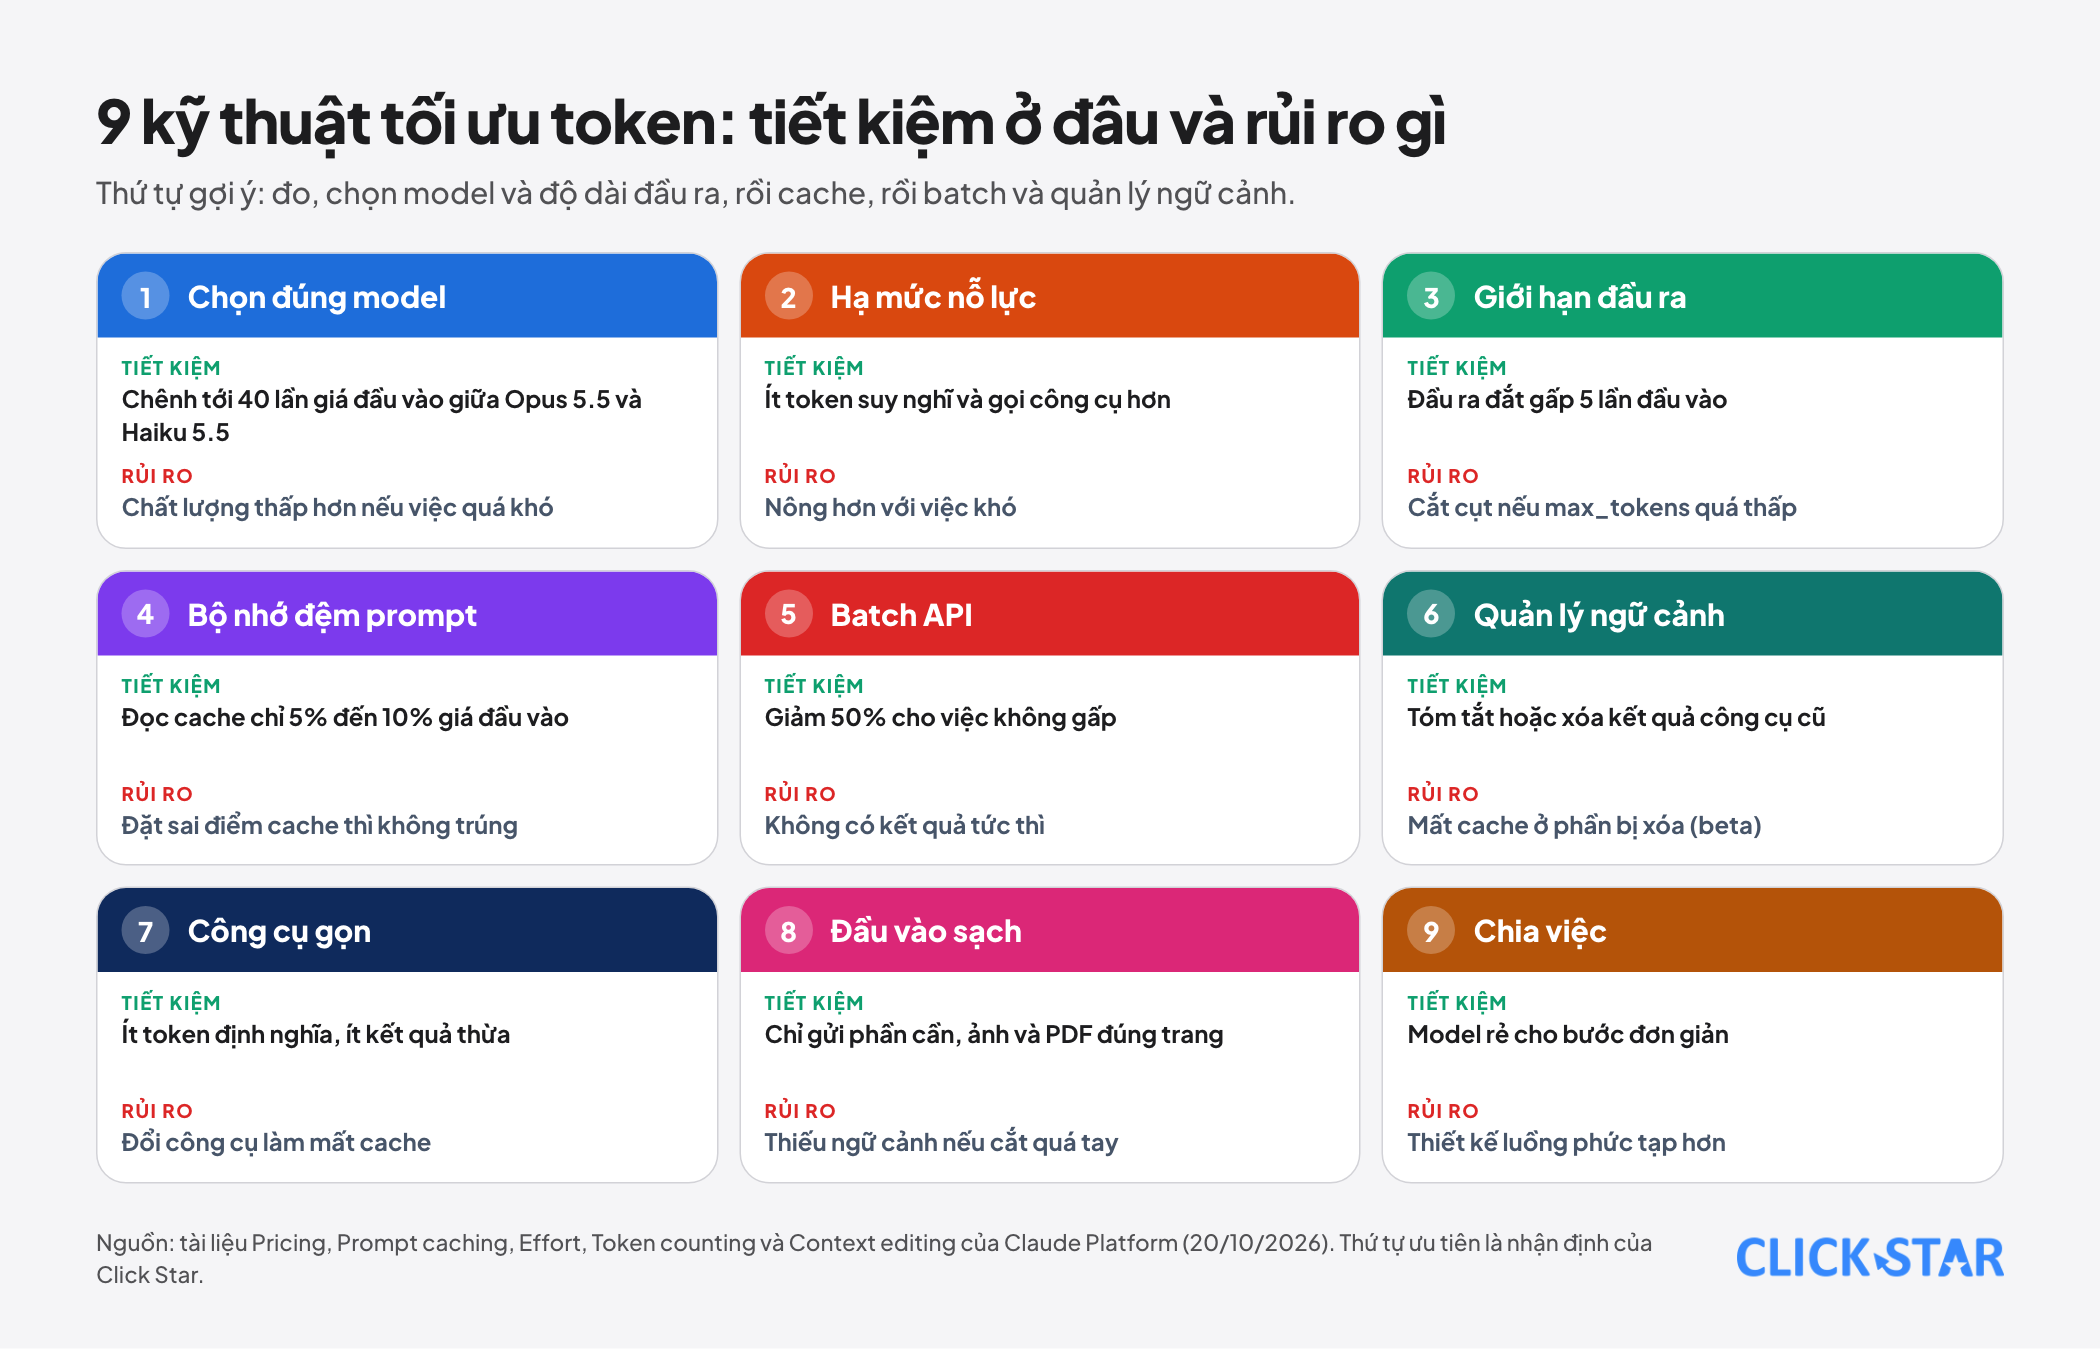
Đánh giá của Click Star. Thứ tự ưu tiên hợp lý cho hầu hết đội ngũ: đo, rồi chọn model và độ dài đầu ra, rồi cache, rồi batch và quản lý ngữ cảnh. Mỗi kỹ thuật thêm vào làm hệ thống phức tạp hơn, nên chỉ thêm khi phép đo cho thấy khoản đó đáng kể.
Dành cho người dùng ứng dụng chat
Phần này là nguyên tắc chung, không dựa vào tính năng riêng của một ứng dụng, vì tính năng và giới hạn từng ứng dụng khác nhau và thay đổi thường xuyên.
- Mở cuộc trò chuyện mới cho mỗi việc khác nhau thay vì kéo dài một cuộc trò chuyện, vì lịch sử dài bị gửi lại ở mỗi lượt.
- Dán đúng phần cần thiết của tài liệu thay vì cả tệp, và nói rõ phần nào cần đọc.
- Yêu cầu định dạng và độ dài trả lời ngay từ đầu để tránh phải hỏi lại.
- Soạn một đoạn chỉ dẫn ổn định cho việc lặp lại (vai trò, giọng văn, định dạng) và dùng lại, thay vì viết lại mỗi lần.
- Kiểm chứng kết quả theo cách rẻ: yêu cầu liệt kê nguồn hoặc điểm cần kiểm thay vì yêu cầu viết lại cả bài.
Kế hoạch 14 ngày
- Ngày 1 đến 3: đo hiện trạng bằng token thực và chi phí cho mỗi việc đạt ở 3 việc tốn nhất.
- Ngày 4 đến 6: viết lại prompt để có phần cố định ở đầu, giới hạn độ dài đầu ra, đặt mức nỗ lực rõ ràng.
- Ngày 7 đến 9: bật bộ nhớ đệm, đo tỷ lệ trúng cache qua trường usage, sửa điểm đặt cache nếu tỷ lệ thấp.
- Ngày 10 đến 12: thử model nhỏ hơn cho việc đơn giản trên bộ mẫu của bạn; chuyển việc không gấp sang Batch API.
- Ngày 13 đến 14: đặt cảnh báo chi phí và đưa số token, chi phí mỗi việc đạt vào báo cáo hằng tuần.
Chỉ số theo dõi
- Chi phí cho mỗi việc đạt (không chỉ cho mỗi yêu cầu).
- Tỷ lệ token đầu vào đọc từ cache trên tổng token đầu vào.
- Số token đầu ra trung bình mỗi yêu cầu và tỷ lệ câu trả lời bị cắt do max_tokens.
- Tỷ lệ việc phải làm lại hoặc sửa tay sau khi giảm model hoặc mức nỗ lực.
- Số token đầu vào trung bình theo độ dài hội thoại.
- Tỷ lệ việc chuyển sang Batch API.
Những sai lầm thường gặp
- Tối ưu đầu vào mà quên đầu ra, trong khi sau cache đầu ra là khoản chi lớn nhất.
- Đặt điểm cache lên khối có dấu thời gian hoặc nội dung riêng của từng yêu cầu nên không bao giờ trúng cache.
- Đổi định nghĩa công cụ hoặc chỉ dẫn hệ thống liên tục và làm mất cache.
- Hạ model hoặc mức nỗ lực mà không có bộ kiểm tra chất lượng.
- Đặt max_tokens quá thấp khi dùng suy nghĩ, nên câu trả lời bị cắt cụt.
- Dùng một cuộc hội thoại kéo dài cho nhiều việc khác nhau.
- Giả định số token tiếng Việt bằng số token tiếng Anh thay vì đếm thử.
- Gửi toàn bộ tài liệu hoặc ảnh khi chỉ cần một phần.
Bài liên quan


Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.