Cách chấm chất lượng cuộc gọi tư vấn: bộ tiêu chí và bảng điểm mẫu
Hướng dẫn dựng phiếu chấm cuộc gọi tư vấn: lấy mẫu, nhóm tiêu chí, trọng số, điểm liệt, hiệu chuẩn bằng kappa và cách đo phiếu có hữu ích, dựa trên tài liệu Amazon Connect, Google Cloud và các nghiên cứu đã công bố.
Phiếu chấm cuộc gọi tư vấn thường được dựng vội: vài chục tiêu chí chung chung, mỗi người chấm hiểu khác nhau, rồi điểm bị đem ra xếp hạng nhân viên. Con số trông khách quan nhưng phản ánh người chấm nhiều hơn người được chấm.
Phạm vi bài là việc chấm cuộc gọi của đội kinh doanh và chăm sóc khách. Nguồn chính gồm tài liệu của Amazon Connect và Google Cloud, bài của McHugh (2012) về độ đồng thuận giữa người chấm, tổng quan của Kluger và DeNisi (1996) về phản hồi, và bài báo Whisper của OpenAI, đối chiếu đến ngày 21/10/2026.
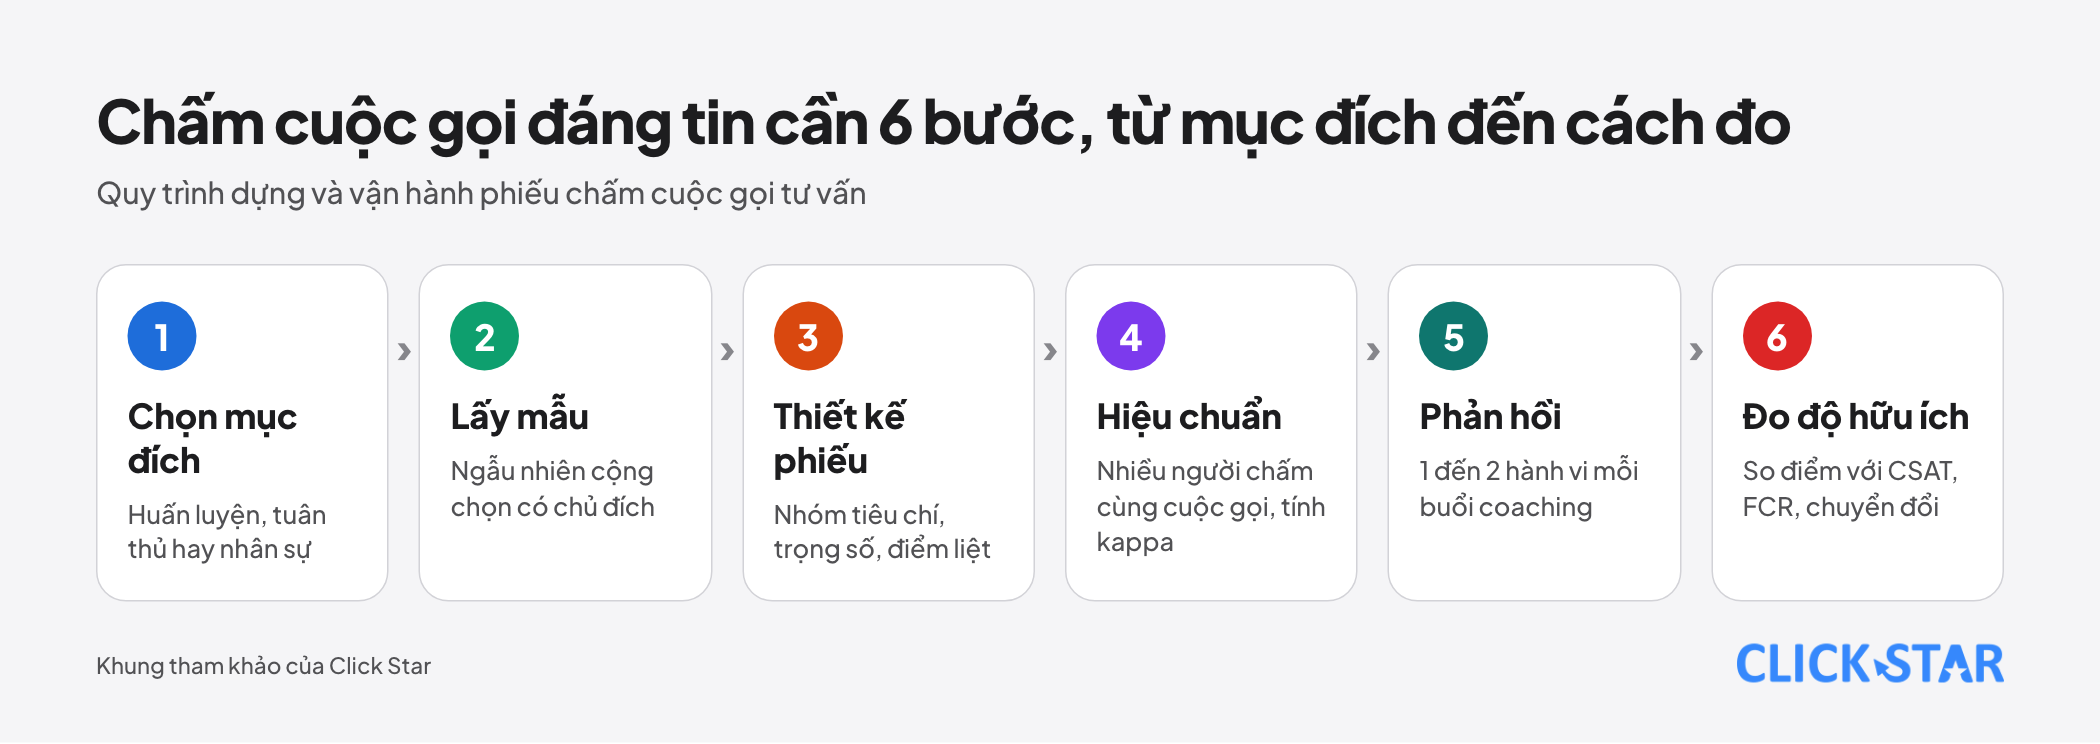
Bài trả lời 6 câu hỏi: chấm để làm gì, lấy mẫu thế nào, thiết kế phiếu ra sao, hiệu chuẩn thế nào, phản hồi cho nhân viên ra sao, và làm sao biết phiếu hữu ích. Click Star đã có bài riêng về phân tích cuộc gọi bằng AI là gì; bài này tập trung vào phiếu chấm.
Điểm chính
- Chấm cuộc gọi để huấn luyện và sửa quy trình, không để phạt: hơn 1/3 can thiệp phản hồi làm giảm hiệu suất (Kluger và DeNisi, 1996).
- Mỗi tiêu chí là hành vi quan sát được, trả lời bằng đạt, không đạt hoặc không áp dụng, kèm hướng dẫn trả lời rõ.
- Trọng số là lựa chọn quản trị, không phải chuẩn ngành. Amazon Connect yêu cầu tổng trọng số bằng 100%. Lỗi nghiêm trọng nên tách thành điểm liệt.
- Độ đồng thuận giữa người chấm nên đo bằng kappa. McHugh coi kappa dưới 0,60 là chưa đủ, Google Cloud nêu mục tiêu không dưới 0,2: hai ngưỡng lệch nhau.
- AI chỉ nên hỗ trợ chấm. Amazon Connect ghi AI không chính xác 100%, và theo bảng ngôn ngữ của hãng, tiếng Việt chưa có đánh giá hiệu suất tự động.
- Phiếu hữu ích hay không phải kiểm bằng dữ liệu: so điểm với CSAT, FCR hoặc tỷ lệ chuyển đổi, và không suy ra nhân quả từ tương quan.
Chấm cuộc gọi để làm gì
Chấm cuộc gọi là xem một mẫu cuộc gọi theo cùng một phiếu để biết nhân viên làm tốt gì, thiếu gì và quy trình nào gây lỗi lặp lại. Phiếu huấn luyện cần chi tiết hành vi, phiếu kiểm tra tuân thủ cần ít câu và ranh giới đúng sai rõ.
Huấn luyện, kiểm soát tuân thủ và đánh giá nhân sự là 3 mục đích hay bị trộn lẫn. Click Star khuyên không dùng điểm phiếu một mình để quyết định lương thưởng khi phiếu chưa được hiệu chuẩn.
Lấy mẫu cuộc gọi thế nào cho đáng tin
Nên chấm theo mẫu ngẫu nhiên để có bức tranh công bằng, cộng cuộc gọi chọn có chủ đích (khiếu nại, deal thua) để lấy bài học. Khung tham khảo của Click Star, không lấy từ nguồn ngoài: mỗi nhân viên mỗi tháng 5 cuộc, gồm 3 ngẫu nhiên và 2 chọn có chủ đích.
Theo phép tính xấp xỉ chuẩn cho tỷ lệ (Click Star tự tính), 30 cuộc ngẫu nhiên với tỷ lệ đạt 80% cho sai số khoảng 14 điểm phần trăm ở mức tin cậy 95%; với 100 cuộc là khoảng 8. Vì vậy vài cuộc mỗi tháng chỉ để chọn cuộc gọi cần coaching, chưa đủ để xếp hạng.
Thiết kế phiếu chấm: nhóm tiêu chí, trọng số và điểm liệt
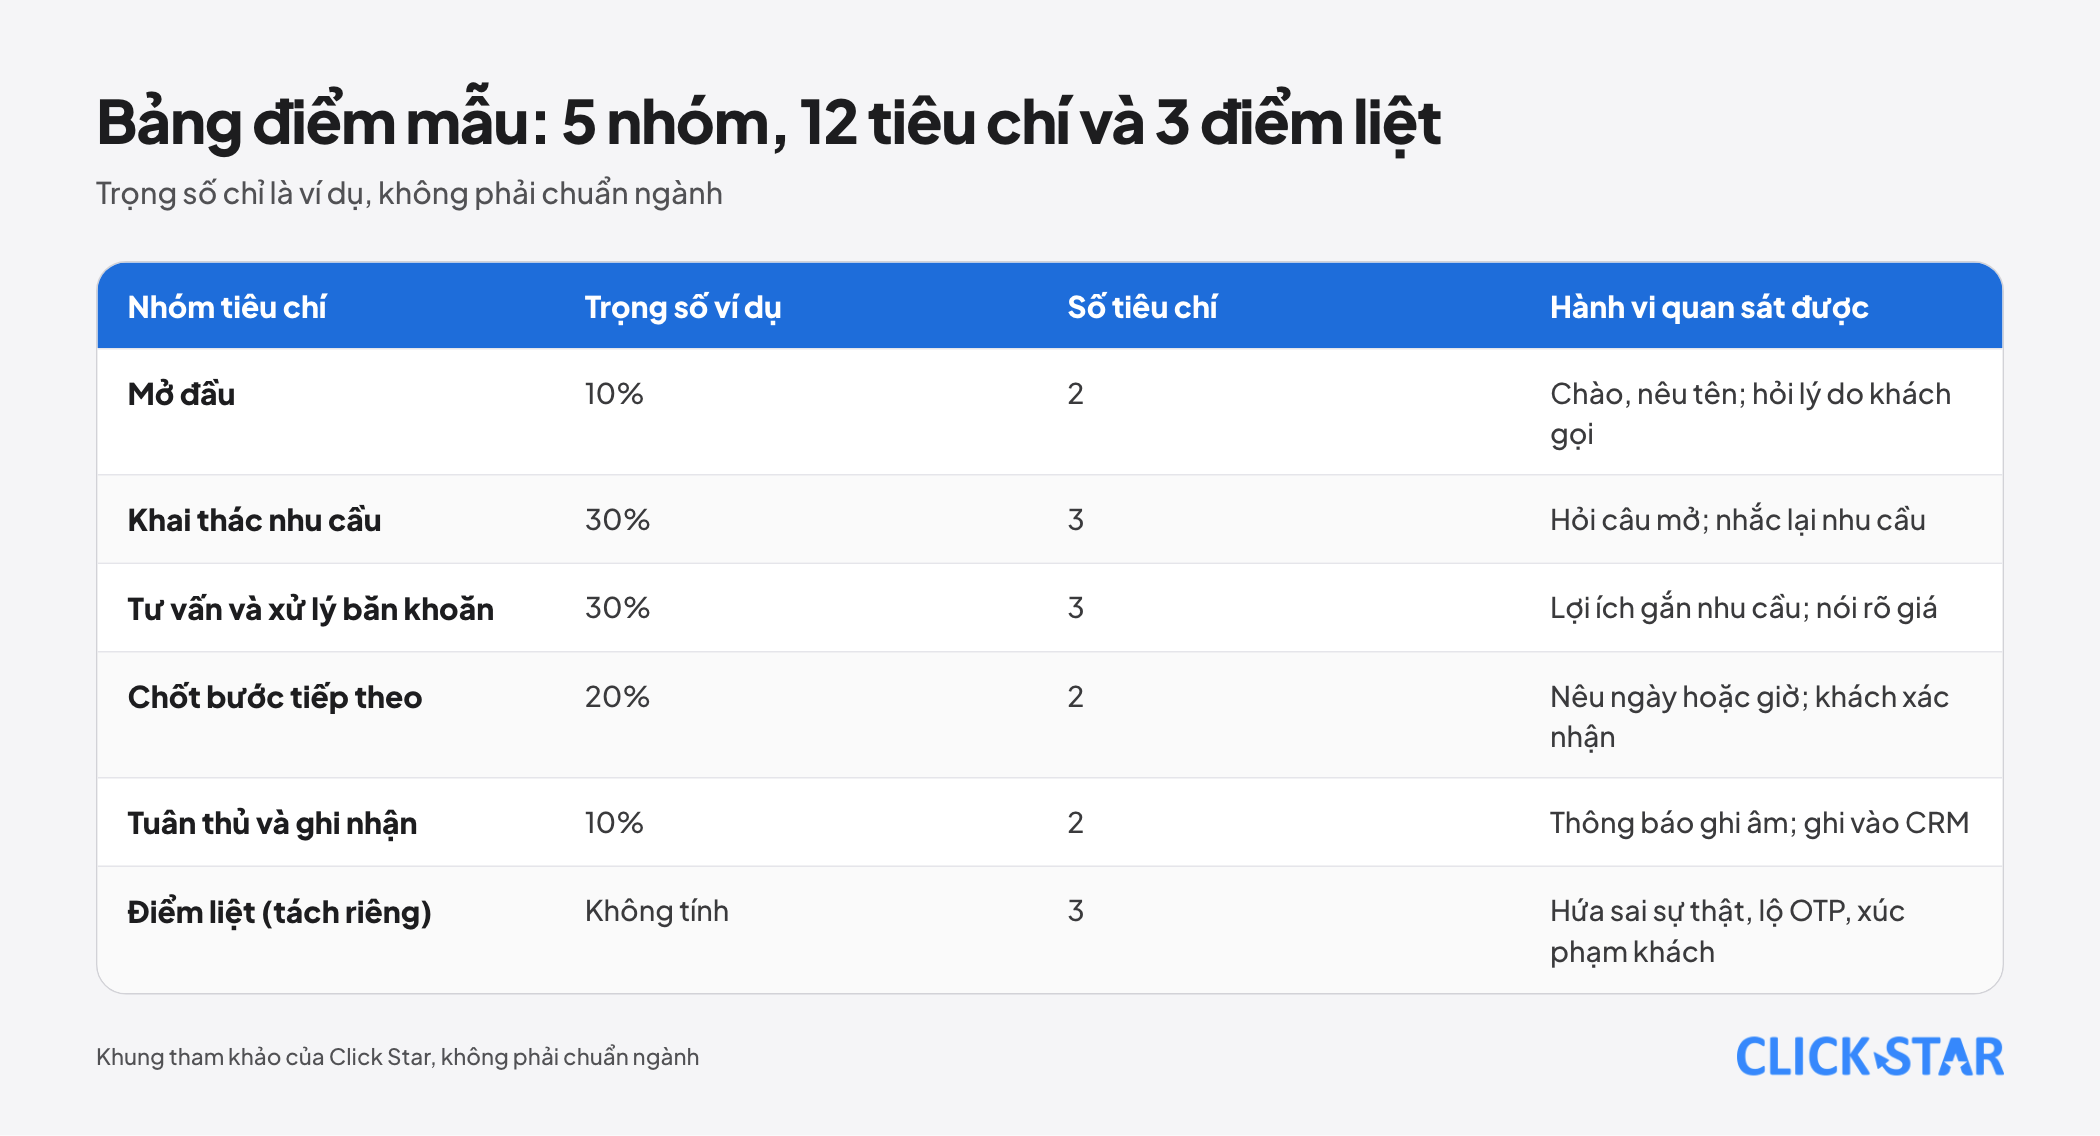
Mỗi tiêu chí có câu hỏi, hướng dẫn trả lời và trọng số. Theo Amazon Connect, trọng số cho biết câu hoặc mục ảnh hưởng bao nhiêu đến điểm tổng, và tổng luôn bằng 100%.
Bảng điểm mẫu sau là khung tham khảo của Click Star, trọng số chỉ là ví dụ, không phải chuẩn ngành. Phiếu có 12 tiêu chí trong 5 nhóm và 3 điểm liệt:
- Nhóm 1, Mở đầu (10%): chào và nêu tên doanh nghiệp, tên mình ngay câu đầu; hỏi lý do khách gọi hoặc xác nhận khách tiện nói.
- Nhóm 2, Khai thác nhu cầu (30%): hỏi ít nhất 1 câu mở về mục tiêu của khách; hỏi 1 điều kiện quyết định như ngân sách hoặc thời điểm; nhắc lại nhu cầu trước khi đề xuất.
- Nhóm 3, Tư vấn và xử lý băn khoăn (30%): nêu lợi ích gắn với nhu cầu vừa nghe; ghi nhận ý kiến khi khách phản đối rồi mới trả lời; nói rõ giá hoặc điều kiện khi được hỏi.
- Nhóm 4, Chốt bước tiếp theo (20%): nêu bước tiếp theo kèm ngày hoặc giờ; nhắc lại thỏa thuận để khách xác nhận.
- Nhóm 5, Tuân thủ và ghi nhận (10%): làm đúng quy trình thông báo ghi âm; ghi thông tin chính vào CRM sau cuộc gọi.
Điểm liệt tách khỏi trọng số: hứa hoặc nói sai sự thật về giá, kết quả, điều kiện; hỏi hoặc để lộ thông tin nhạy cảm như mã OTP, số thẻ; xúc phạm hoặc đe dọa khách.
Amazon Connect có tùy chọn "tự động trượt": chọn đáp án đó thì điểm của mục hoặc cả phiếu về 0. Click Star ưu tiên ghi điểm bình thường và gắn cờ điểm liệt riêng để quản lý nghe lại, tránh mất thông tin về phần còn lại.
Viết tiêu chí thành hành vi quan sát được
Mỗi tiêu chí tốt chỉ có 1 hành vi và trả lời được bằng tai hoặc bản gỡ băng. Google Cloud khuyên viết hướng dẫn "không để chỗ cho diễn giải" và kèm ví dụ cho từng lựa chọn. Ví dụ trong khung của Click Star, tiêu chí "Nhân viên nêu bước tiếp theo kèm ngày hoặc giờ":
- Đạt khi: nhân viên nói điều như "Tôi gửi báo giá qua Zalo trước 5 giờ chiều nay, sáng mai tôi gọi lại".
- Không đạt khi: nhân viên chỉ nói "Có gì anh chị liên hệ lại nhé".
- Không áp dụng khi: khách từ chối ngay đầu cuộc gọi hoặc gọi nhầm số.
Thang điểm và cách tính
Với phần lớn tiêu chí, Click Star khuyên 3 đáp án: đạt, không đạt, không áp dụng. Amazon Connect khuyên dùng ít lựa chọn ngắn, vì danh sách dài từ "Rất tốt" đến "Tệ" làm giảm độ chính xác của AI.
Điểm cuộc gọi bằng tổng trọng số tiêu chí đạt chia cho tổng trọng số tiêu chí áp dụng. Amazon Connect chia lại trọng số theo tỷ lệ khi 1 câu chuyển sang không áp dụng, ví dụ từ 60% lên 75%.
Ví dụ với khung của Click Star (số tự dựng): nhóm 1 được 10, nhóm 2 được 20, nhóm 3 được 20, nhóm 4 được 10, nhóm 5 có 1 tiêu chí đạt và 1 không áp dụng nên được 5 trên 5. Tổng 65 trên 95 điểm áp dụng, tức 68,4%.
Click Star không tìm thấy ngưỡng điểm đạt chuẩn ngành nào có nguồn. Amazon Connect cho doanh nghiệp tự đặt ngưỡng phân loại, nên hãy đặt sau khi hiệu chuẩn. Đừng sửa phiếu giữa kỳ mà vẫn so điểm.
Hiệu chuẩn giữa người chấm
Hiệu chuẩn là cho nhiều người chấm cùng một cuộc gọi, độc lập, rồi so kết quả và thống nhất cách hiểu. Google Cloud khuyên tính kappa của Cohen.
Kappa đo mức đồng thuận sau khi trừ phần trùng hợp ngẫu nhiên. Theo McHugh (Biochemia Medica, 2012), giá trị chạy từ -1 đến 1 và 0 là mức ngẫu nhiên. Nguồn gốc là bài của Jacob Cohen năm 1960; Click Star chưa mở được bài gốc nên dựa vào mô tả của McHugh.
Ví dụ minh họa (số tự dựng): 2 người chấm 20 cuộc cho 1 tiêu chí. Cả hai cùng chấm đạt 14 cuộc, cùng chấm không đạt 3 cuộc, bất đồng ở 3 cuộc (2 cuộc A đạt B không đạt, 1 cuộc ngược lại). Tỷ lệ đồng ý là 85% nhưng kappa chỉ khoảng 0,57, vì phần lớn cuộc gọi vốn dễ cùng đạt.
McHugh (viết cho y tế) coi kappa dưới 0,60 là chưa đủ. Google Cloud nêu mục tiêu không dưới 0,2 cho người gán nhãn. Click Star không tìm thấy ngưỡng riêng cho chấm cuộc gọi tư vấn, nên khuyên tính kappa theo từng tiêu chí và sửa lời tiêu chí nào thấp.
Phản hồi cho nhân viên và nhịp coaching
Phản hồi phải nói về hành vi cụ thể, không nói về con người. Kluger và DeNisi (Psychological Bulletin, 1996) tổng hợp 607 hiệu ứng: phản hồi tăng hiệu suất trung bình (d = 0,41) nhưng hơn 1/3 can thiệp làm giảm hiệu suất. Click Star chỉ đọc phần tóm tắt (toàn văn có tường phí).
Khung coaching tham khảo của Click Star:
- Mỗi buổi chọn 1 đến 2 hành vi, không đọc cả 12 tiêu chí.
- Cho nhân viên tự chấm cuộc gọi của mình trước.
- Nêu điều làm tốt, rồi 1 hành vi cần sửa kèm câu nói thay thế, rồi hẹn kiểm lại.
Nhịp tham khảo: coaching 1 kèm 1 mỗi 2 tuần, hiệu chuẩn mỗi tháng, rà phiếu mỗi quý. Đây là đề xuất của Click Star, chưa có nguồn nêu chuẩn.
Dùng AI hỗ trợ chấm: giới hạn và người duyệt cuối
AI có thể điền sẵn câu trả lời dựa trên bản gỡ băng, nhưng người vẫn phải duyệt. Theo Amazon Connect, AI trả về câu trả lời kèm lý do và điểm dẫn chứng. Tài liệu ghi đánh giá do AI tạo không chính xác 100%, khuyên xem mẫu trước khi thưởng hay coaching và giữ chấm tay để bắt lệch theo thời gian.
Giới hạn cần biết:
- Nhận dạng giọng nói: Amazon Connect nói chất lượng bản gỡ băng ảnh hưởng độ chính xác chấm, và không gỡ chính xác cuộc gọi nhiều ngôn ngữ hoặc nhiều người nói cùng lúc.
- Chỉ dùng cho tiêu chí chỉ cần lời nói: Amazon Connect và Google Cloud nói AI không đánh giá giọng điệu.
- Tiếng Việt: bảng ngôn ngữ của Amazon Connect (đọc 21/10/2026) cho vi-VN có phân tích sau cuộc gọi nhưng cột đánh giá hiệu suất tự động bỏ trống.
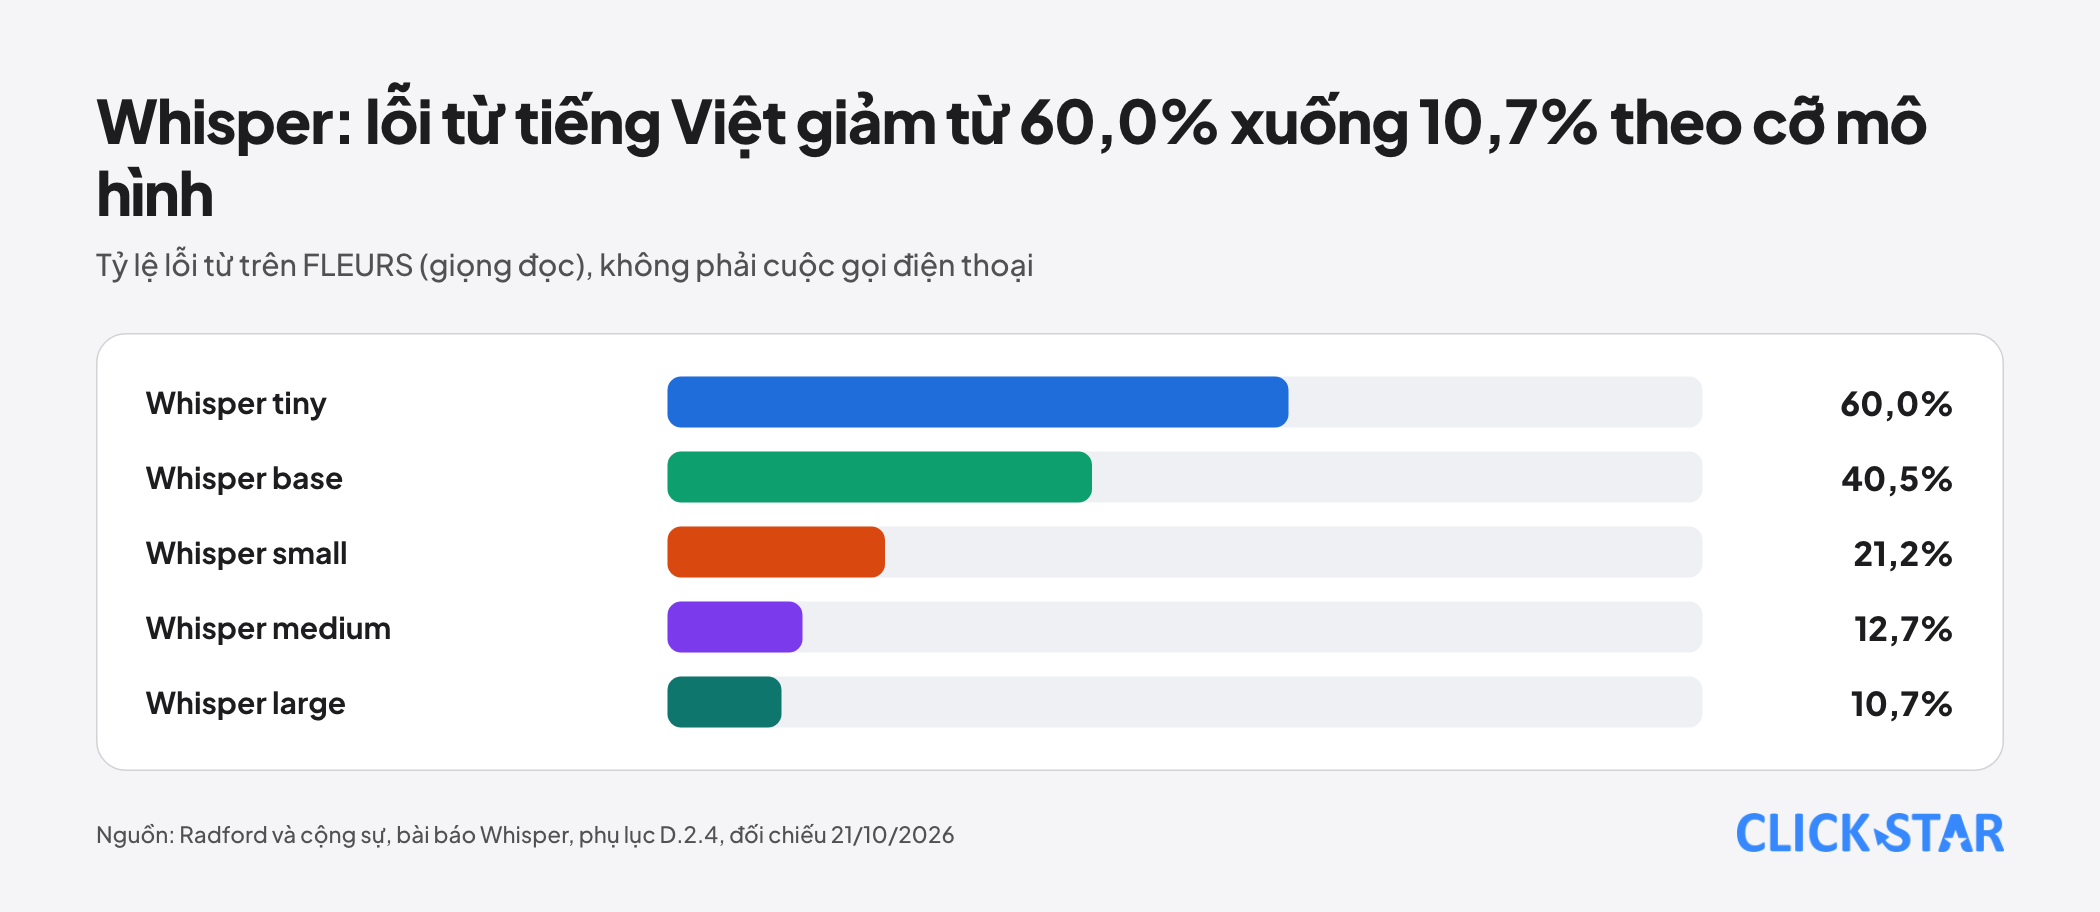
- Số đo công khai: theo bài báo Whisper (2022, phụ lục D.2.4), tỷ lệ lỗi từ tiếng Việt trên FLEURS là 60,0% (tiny), 40,5% (base), 21,2% (small), 12,7% (medium), 10,7% (large). FLEURS là giọng đọc, không phải điện thoại nhiễu.
- Phiên bản mô hình: Amazon Connect nói bản mới có thể hành xử khác; hãy cố định phiên bản khi so điểm theo thời gian.
Click Star chưa thấy số đo công khai cho cuộc gọi tư vấn tiếng Việt, hay nghiên cứu về thiên lệch theo giọng vùng miền. Hãy tự so điểm AI với điểm người theo nhóm giọng, và để người duyệt cuối nghe lại mọi điểm liệt do AI nêu.
Phiếu chấm có hữu ích không: cách đo
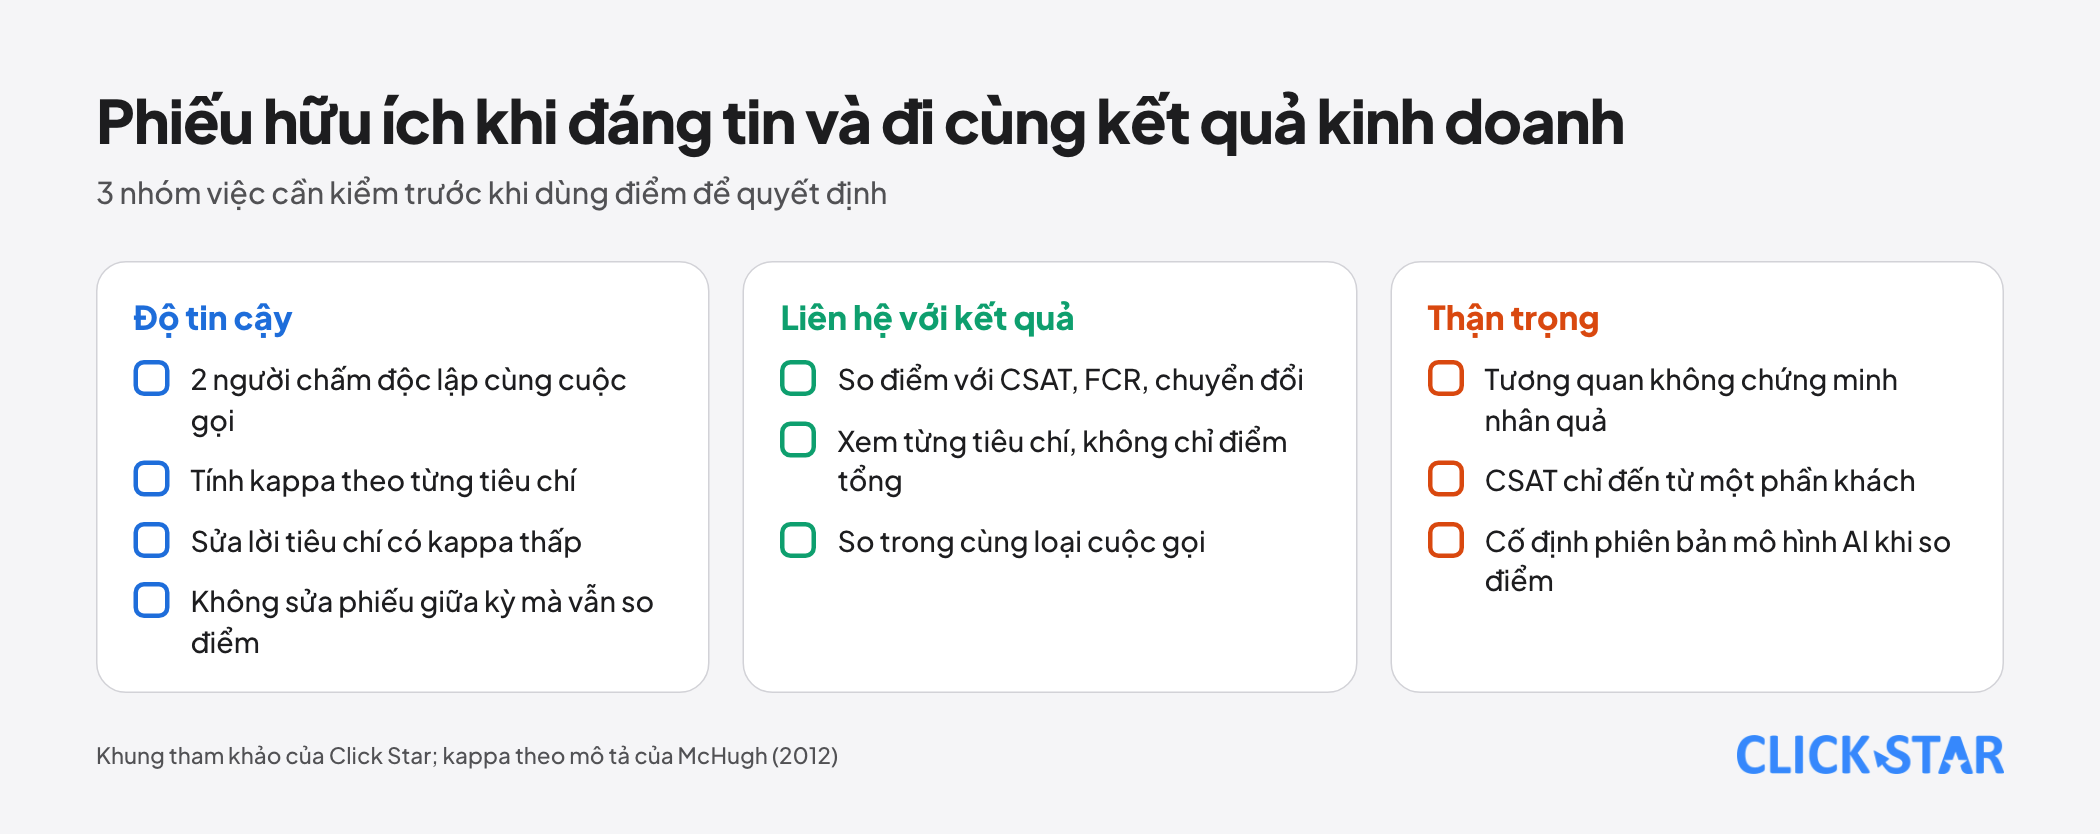
Phiếu hữu ích khi các người chấm cho điểm giống nhau và điểm đó đi cùng điều doanh nghiệp quan tâm. Phép kiểm đầu là kappa; phép kiểm sau là xem điểm tổng và điểm từng tiêu chí có liên hệ với CSAT, FCR hoặc tỷ lệ chuyển đổi trên cùng tập cuộc gọi không.
Cần cẩn trọng với nhân quả: nhân viên giỏi vừa điểm cao vừa chốt tốt, và khảo sát CSAT thường chỉ phản ánh nhóm khách chịu trả lời. Hãy so trong cùng loại cuộc gọi, nhìn từng tiêu chí, và bỏ hoặc sửa tiêu chí không liên hệ kết quả.
Ghi âm cuộc gọi và dữ liệu cá nhân
Chấm cuộc gọi cần ghi âm, và việc này chạm đến luật dữ liệu cá nhân. Theo bản chép trên ketoananpha.vn (đọc 21/10/2026), Luật số 91/2025/QH15 có hiệu lực từ 01/01/2026. Click Star chưa tìm thấy quy định riêng về ghi âm cuộc gọi tư vấn trong các nguồn đã đọc.
Click Star đã có bài riêng về luật bảo vệ dữ liệu cá nhân. Bài này không tư vấn pháp lý: hãy đối chiếu văn bản gốc. Về vận hành, Click Star khuyên thông báo cho khách đầu cuộc gọi và che số thẻ, mã OTP.
Ý nghĩa với đội kinh doanh Việt Nam
Đánh giá của Click Star. Giá trị lớn nhất của phiếu chấm là ép đội thống nhất thế nào là một cuộc gọi tốt, hơn là con số cuối. Đội nhỏ nên bắt đầu bằng phiếu ngắn, chấm tay, rồi mới cân nhắc AI; với tiếng Việt, số điện thoại và số tiền cần người nghe lại.
Công khai lợi ích: Click Star có dịch vụ Speech Insight AI (phân tích cuộc gọi bằng AI). Theo trang dịch vụ đã công bố, dịch vụ chấm điểm theo phiếu riêng của doanh nghiệp, con người quyết định tiêu chí và ngưỡng đạt, còn độ chính xác được đo trên cuộc gọi của khách trong giai đoạn thử.
Lộ trình 30 ngày
- Tuần 1: chốt mục đích, loại cuộc gọi và 8 đến 12 tiêu chí; kiểm tra việc ghi âm hiện có.
- Tuần 2: 2 người chấm độc lập 20 cuộc, tính kappa từng tiêu chí, sửa tiêu chí lệch.
- Tuần 3: hiệu chuẩn lần 2, chốt phiên bản 1, chấm mẫu thật, coaching lần đầu.
- Tuần 4: so điểm với CSAT, FCR hoặc tỷ lệ chuyển đổi; nếu thử AI, so AI với người trên cùng 20 cuộc.
Điều chưa biết
Click Star không tìm thấy ngưỡng điểm đạt chuẩn ngành có nguồn. Ngưỡng kappa thì các nguồn mâu thuẫn và không có chuẩn riêng cho chấm cuộc gọi tư vấn.
Chưa có số đo công khai về độ chính xác nhận dạng giọng nói và chấm bằng AI trên cuộc gọi tư vấn tiếng Việt; chỉ có số FLEURS trên giọng đọc. Chưa có bằng chứng ở Việt Nam rằng dùng phiếu chấm làm tăng tỷ lệ chuyển đổi.
Click Star chưa mở được bài Cohen (1960) và định nghĩa gốc của CSAT, FCR.
Những sai lầm thường gặp
- Viết tiêu chí mơ hồ như "thái độ tốt", khiến mỗi người chấm hiểu khác nhau.
- Đặt trọng số theo cảm tính rồi coi là chuẩn ngành.
- Không có điểm liệt, để lỗi nghiêm trọng bị pha loãng trong điểm trung bình.
- Bỏ hiệu chuẩn, hoặc chỉ nhìn tỷ lệ đồng ý.
- Xếp hạng nhân viên từ vài cuộc gọi.
- Tin điểm AI mà không so với người, hoặc đổi phiên bản mô hình giữa kỳ.
- Dùng điểm cho lương thưởng khi phiếu chưa kiểm chứng, hoặc chấm xong mà không phản hồi.
Bài liên quan


Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.