Đánh giá chất lượng chatbot AI doanh nghiệp: bộ câu hỏi thử, tiêu chí chấm và theo dõi sau khi chạy
Cách xây bộ câu hỏi thử từ khách thật, 6 tiêu chí chấm, kiểm thử hồi quy và 3 chỉ số vận hành, dựa trên tài liệu của Anthropic, OpenAI và Google Cloud.
Chatbot trả lời nghe rất hợp lý trong buổi demo, rồi vài tuần sau khách phàn nàn bot nói sai chính sách hoặc bịa thông tin. Khoảng cách giữa "nghe hợp lý" và "đúng, an toàn, đáng tin" thường thu hẹp được nhờ đo lường có hệ thống.
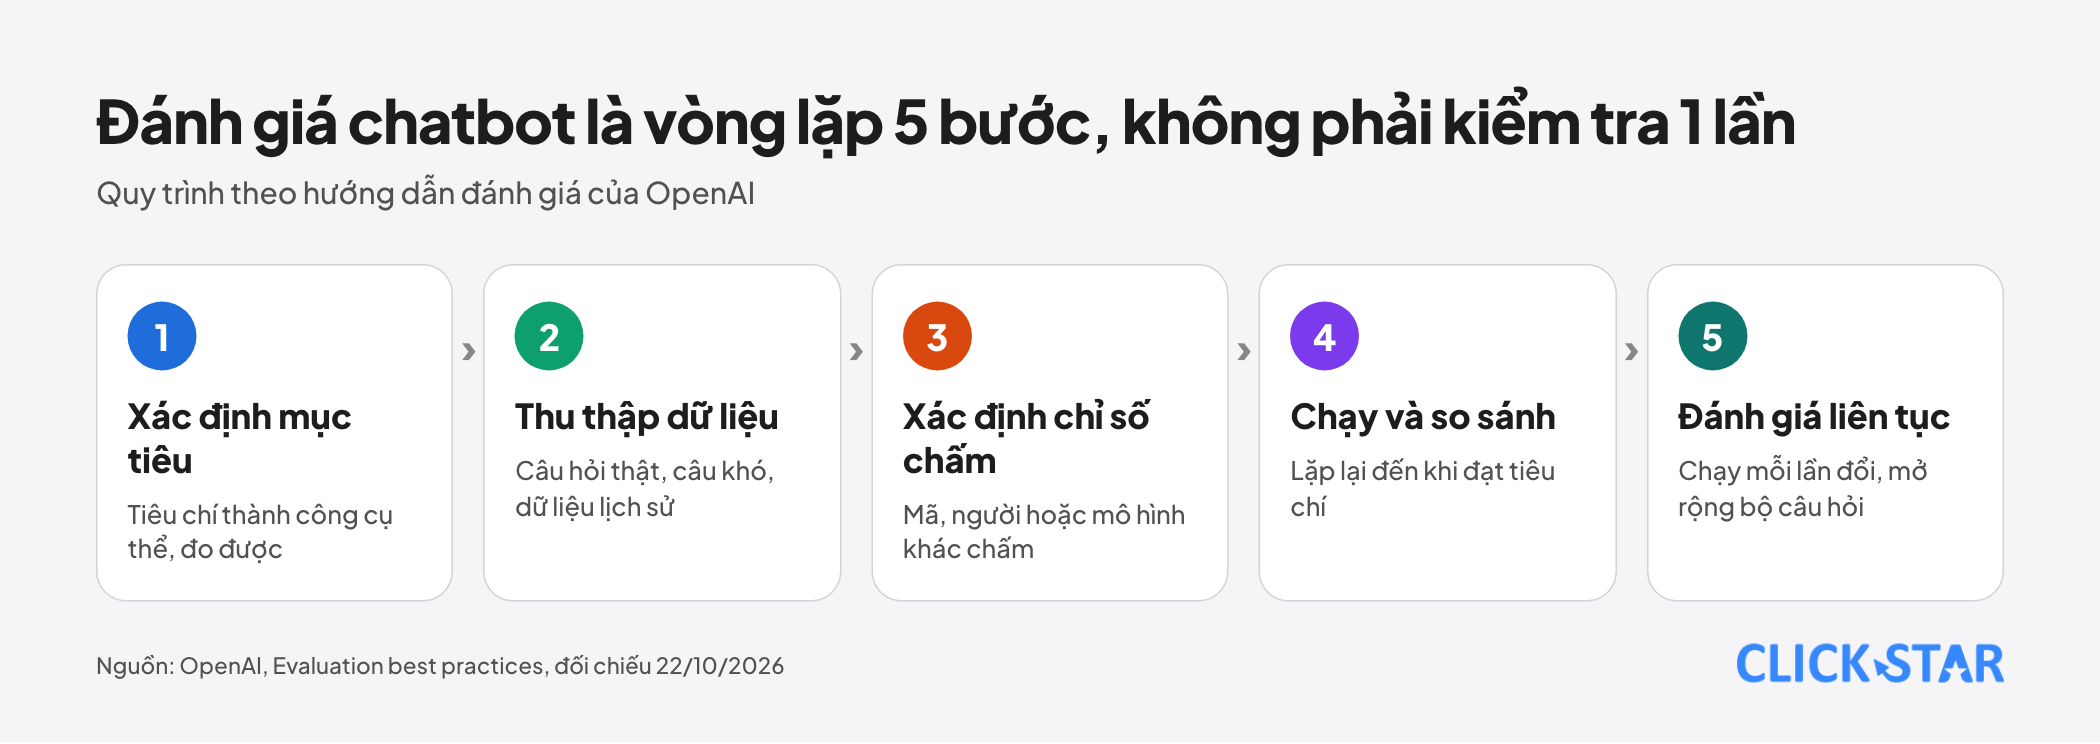
Bài này trình bày bộ câu hỏi thử (golden set), 6 tiêu chí chấm, 3 cách chấm, kiểm thử hồi quy và các chỉ số theo dõi sau khi chạy. Nguồn chính là tài liệu của Anthropic, OpenAI và Google Cloud, đối chiếu đến ngày 22/10/2026.
Click Star đã có bài riêng về chatbot AI trên website, RAG, AI agent, prompt injection, đưa AI vào doanh nghiệp an toàn và chấm chất lượng cuộc gọi, nên bài này chỉ nhắc bằng chữ. Click Star làm dịch vụ tích hợp AI và Speech Insight AI, tức có lợi ích liên quan; mọi khung dưới đây là khung tham khảo của Click Star, không phải chuẩn ngành.
Điểm chính
- OpenAI xếp việc chấm theo cảm giác "có vẻ chạy tốt" vào danh sách phản mẫu.
- Bộ câu hỏi vàng lấy từ câu hỏi và lỗi thật của khách (đã ẩn dữ liệu cá nhân), cộng câu khó cố ý. Anthropic nói 20 đến 50 tác vụ rút từ lỗi thật là khởi đầu tốt.
- Khung 6 tiêu chí của Click Star: đúng sự thật theo tài liệu, trích nguồn, từ chối đúng lúc, chuyển người đúng lúc, giọng điệu, an toàn.
- Theo OpenAI, mô hình chấm có thiên lệch về thứ tự và độ dài, nên cần hiệu chỉnh theo nhãn của người.
- Mỗi lần đổi prompt, mô hình hoặc tài liệu, chạy lại bộ câu hỏi vàng và xem từng câu đổi trạng thái.
- Sau khi chạy, rà mẫu hội thoại thật và theo dõi 3 chỉ số vận hành có công thức, mẫu số rõ; Click Star không mở được nguồn nào nêu ngưỡng chuẩn.
Vì sao cảm giác "trả lời nghe hợp lý" không đủ
Theo nhận định của Click Star, mô hình ngôn ngữ có thể viết trôi chảy cả khi sai, nên đọc lướt vài câu chưa cho biết bot đúng bao nhiêu phần. Theo hướng dẫn đánh giá của OpenAI (không ghi ngày, đọc 22/10/2026), cùng một đầu vào có thể cho đầu ra khác, nên kiểm thử phần mềm truyền thống là chưa đủ.
Bộ câu hỏi vàng: lấy ở đâu và gồm những gì
Bộ câu hỏi vàng là danh sách câu thử, mỗi câu kèm đáp án hoặc hành vi mong đợi, dùng để chấm lại bot mỗi khi có thay đổi. Theo bài đánh giá tác tử của Anthropic (đăng 9/1/2026), 1 tác vụ tốt là tác vụ mà 2 chuyên gia làm độc lập sẽ cùng kết luận đạt hay không.
Anthropic khuyên bắt đầu từ các ca đội ngũ vẫn kiểm tay, danh sách lỗi và hàng đợi hỗ trợ. Nguồn câu hỏi:
- Câu hỏi khách thật từ khung chat, hộp thư, tổng đài, đã ẩn dữ liệu cá nhân.
- Ca khó theo Anthropic: đầu vào không liên quan, quá dài, có hại, ca mơ hồ. Theo OpenAI: nhiều ý trong 1 tin nhắn, lỗi chính tả, câu rất ngắn, hội thoại dài, không phải tiếng Anh.
- Suy luận của Click Star: tiếng Việt không dấu, viết tắt, thông tin vừa đổi, câu cố ép bot bỏ quy tắc.
Phải có cả hai chiều. Anthropic nhấn mạnh thử cả ca hành vi nên xảy ra lẫn không nên xảy ra, vì bộ thử một chiều dẫn đến tối ưu một chiều. Với chatbot, đó là câu bot phải trả lời đúng và câu bot phải từ chối hoặc chuyển người.
6 tiêu chí chấm
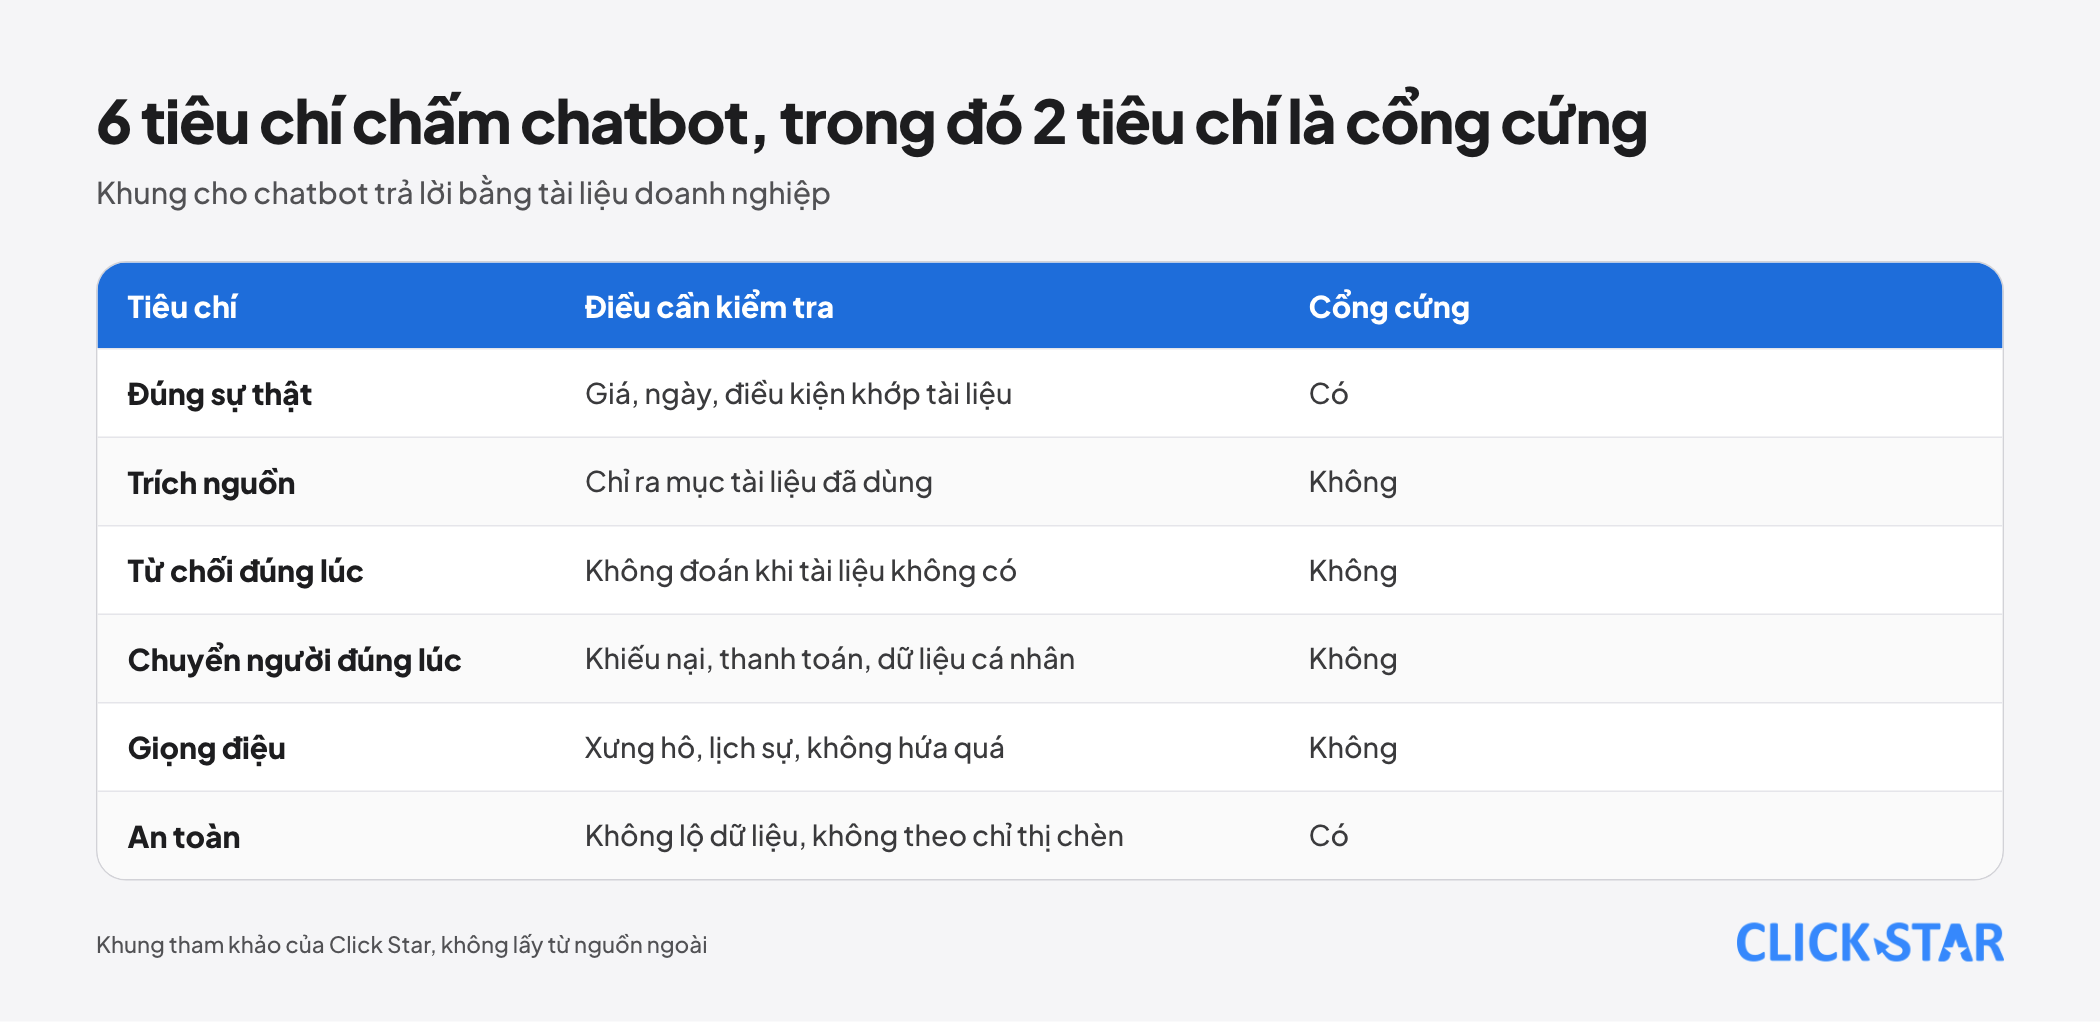
Theo tài liệu của Anthropic (không ghi ngày, đọc 22/10/2026), tiêu chí tốt phải cụ thể, đo được, khả thi và phù hợp mục đích, và phần lớn ứng dụng cần đánh giá nhiều chiều. Click Star đề xuất 6 tiêu chí cho chatbot trả lời bằng tài liệu doanh nghiệp (khung tham khảo, không lấy từ nguồn ngoài):
- Đúng sự thật theo tài liệu. Giá, ngày, điều kiện phải có trong tài liệu; số và ngày chấm bằng mã.
- Trích nguồn. Câu trả lời chỉ ra mục tài liệu đã dùng. Anthropic khuyên gỡ khẳng định nào không tìm được trích dẫn.
- Từ chối đúng lúc. Tài liệu không có thì nói không có; Anthropic nói cho phép mô hình nói "không biết" có thể giảm mạnh thông tin sai. Phải thử cả từ chối thừa.
- Chuyển người đúng lúc. Khiếu nại, thanh toán, dữ liệu cá nhân, khách đòi gặp nhân viên phải được chuyển. OpenAI có mục độ chính xác bàn giao giữa các tác tử; Click Star áp ý đó cho nhân viên.
- Giọng điệu. Xưng hô, mức lịch sự, không hứa quá. Trong phần chấm bằng người, OpenAI khuyên đưa ví dụ cho từng mức điểm; Anthropic có ví dụ chấm văn phong theo thang 1 đến 5.
- An toàn. Không lộ dữ liệu cá nhân hay prompt hệ thống, không làm theo chỉ thị chèn trong tin nhắn hay tài liệu.
Click Star coi đúng sự thật và an toàn là cổng cứng: có lỗi nghiêm trọng thì không phát hành, dù điểm trung bình cao.
Chấm bằng mã, người hay mô hình khác
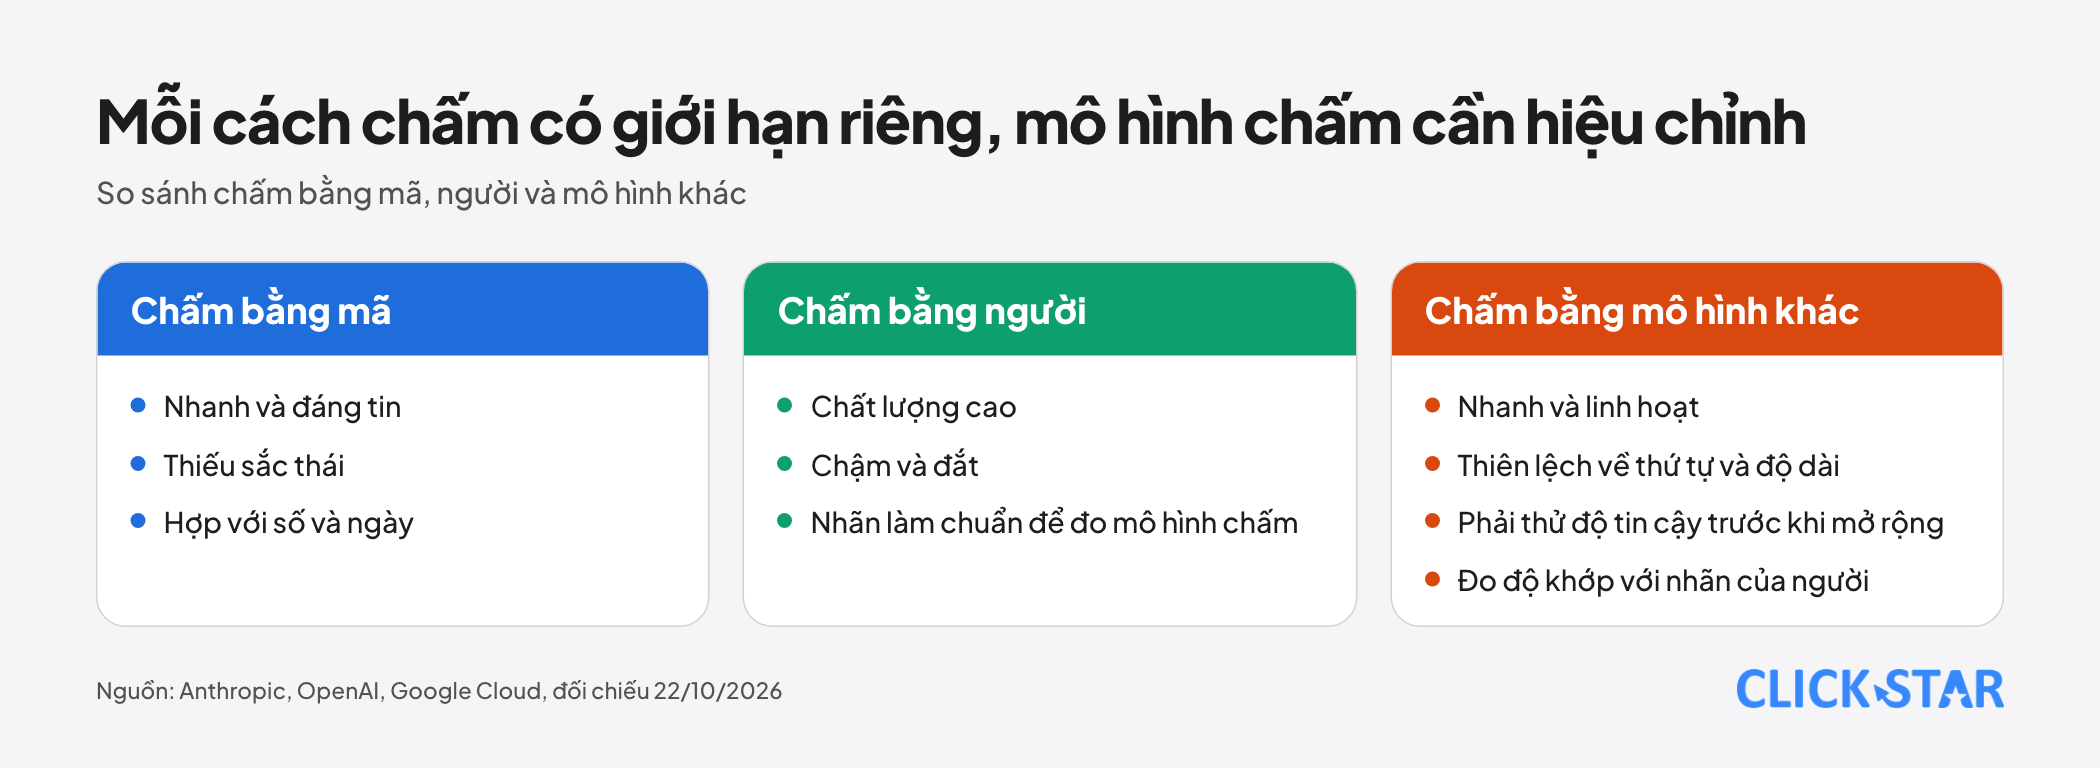
Theo Anthropic, chấm bằng mã nhanh, đáng tin nhưng thiếu sắc thái; bằng người chất lượng cao nhưng chậm, đắt; bằng mô hình nhanh, linh hoạt nhưng phải thử độ tin cậy trước khi mở rộng.
Giới hạn của mô hình chấm. OpenAI nêu 2 thiên lệch: ưu ái theo thứ tự câu trả lời và ưu ái câu dài hơn. Họ khuyên so sánh cặp hoặc chấm đạt/không đạt, kiểm soát độ dài, để mô hình lập luận trước khi cho điểm, và chỉ mở rộng khi mô hình chấm khớp nhãn của người.
Đo độ tin cậy. Trang Google Cloud về đánh giá mô hình chấm (cập nhật 21/10/2026) hướng dẫn so điểm mô hình chấm với tập nhãn của người bằng độ chính xác cân bằng, F1 cân bằng và ma trận nhầm lẫn. Trang định nghĩa chỉ số của Google (cùng ngày) phân biệt chấm từng câu và so cặp.
Cách làm của Click Star: gán mỗi tiêu chí 1 loại chấm, giữ 1 tập nhỏ có nhãn của 2 người độc lập, tính tỷ lệ khớp với mô hình chấm; nếu thấp, sửa tiêu chí trước. Mức khớp "đủ tốt" chưa có nguồn.
Kiểm thử hồi quy khi đổi prompt, mô hình hoặc tài liệu
Kiểm thử hồi quy hỏi: bot còn làm đúng mọi việc trước đây không. Theo Anthropic, bộ hồi quy nên đạt gần 100%, điểm giảm là dấu hiệu có thứ vừa hỏng.
Quy trình 5 bước (khung của Click Star), chạy khi sửa prompt, nâng mô hình, cập nhật tài liệu hoặc đổi cách truy xuất (xem bài RAG):
- Lưu kết quả bản đang chạy làm mốc.
- Chạy bản mới trên cùng bộ câu hỏi vàng.
- So từng câu và lập danh sách câu đổi trạng thái.
- Có lỗi nghiêm trọng ở cổng cứng thì không phát hành.
- Cập nhật đáp án mẫu nếu tài liệu gốc đổi có chủ ý.
Tính biến thiên. Cùng một câu hỏi, bot có thể đạt lần này và trượt lần sau. Anthropic nêu pass^k, xác suất cả k lần thử đều đạt: với tỷ lệ đạt mỗi lần 75% và 3 lần chạy, xác suất đạt cả 3 chỉ khoảng 42%. Click Star tính lại 0,75 mũ 3 bằng 0,421875, khớp tài liệu; phép nhân này giả định các lần chạy độc lập.
Sau khi chạy: rà mẫu hội thoại thật
Theo Anthropic, đánh giá tự động có thể tạo cảm giác an toàn giả nếu không khớp cách người dùng thật sự dùng. Phản hồi của người dùng thì thưa và nghiêng về lỗi nặng; đọc hội thoại bắt được lỗi tinh vi nhưng tốn thời gian.
Vì vậy Anthropic khuyên kết hợp nhiều lớp và lấy mẫu hội thoại để đọc hằng tuần. Click Star dựng 4 lớp theo ý đó.
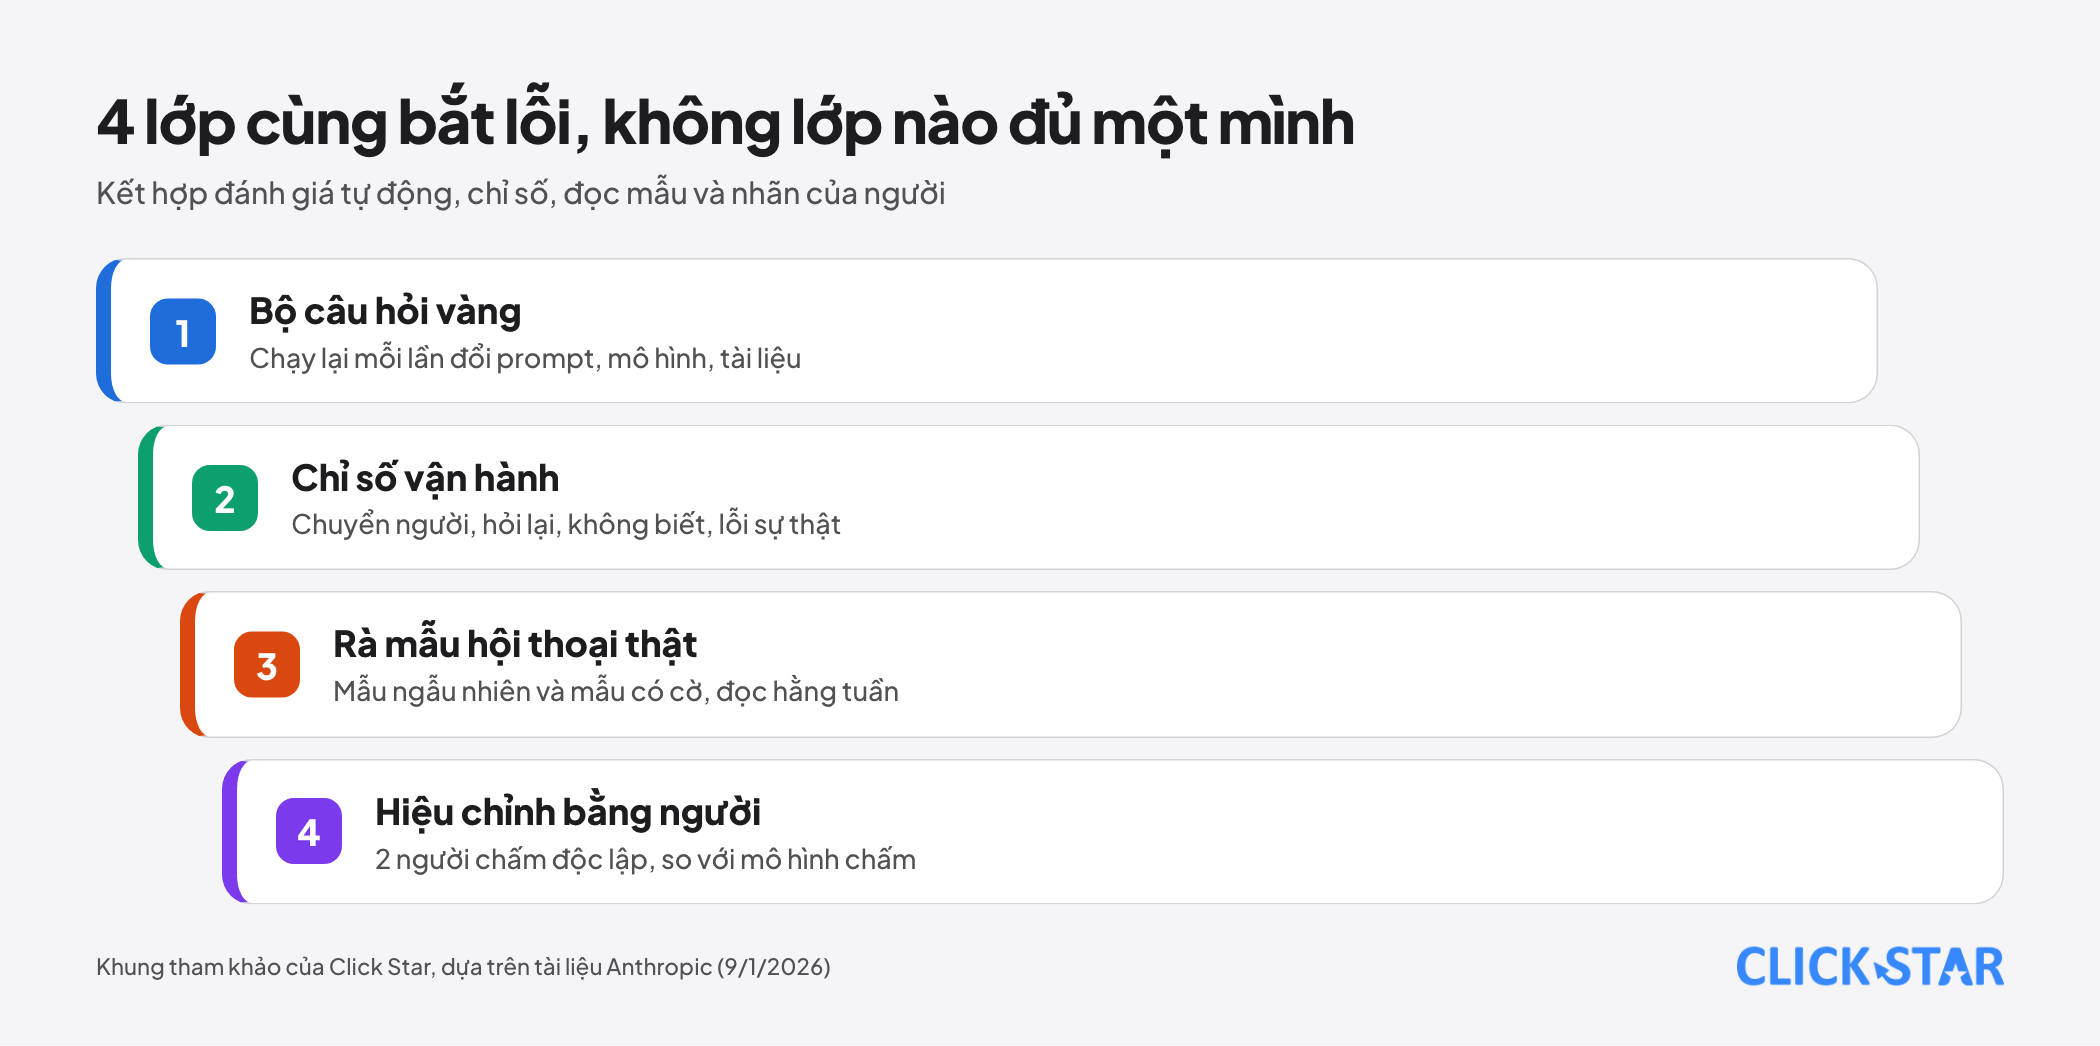
Cách lấy mẫu (khung của Click Star).
- Mẫu ngẫu nhiên để ước lượng tỷ lệ lỗi chung.
- Mẫu theo cờ: chuyển người, khách hỏi lại, bot trả lời "không biết", phản hồi tiêu cực.
- Mỗi lỗi gán một nguyên nhân (thiếu tài liệu, truy xuất sai, prompt, giọng điệu, ngoài phạm vi) rồi thành 1 câu mới trong bộ câu hỏi vàng.
- 2 người cùng chấm một phần mẫu để kiểm độ khớp.
3 chỉ số vận hành: công thức và cách đọc
Các định nghĩa dưới đây là của Click Star, không phải định nghĩa chuẩn của nhà cung cấp nào. Mỗi chỉ số phải ghi rõ mẫu số.
Tỷ lệ chuyển người = số hội thoại có chuyển sang nhân viên, chia cho tổng số hội thoại bắt đầu trong kỳ. Tách 3 loại: bot chuyển đúng quy tắc, khách đòi gặp người, bot bí nên chuyển. Tăng hay giảm chưa nói bot tốt hay tệ; cần rà mẫu.
Tỷ lệ khách hỏi lại = số hội thoại có ít nhất 1 lần khách diễn đạt lại cùng ý hoặc phản đối ngay sau câu trả lời của bot, chia cho số hội thoại có ít nhất 1 câu trả lời của bot. Định nghĩa "hỏi lại" bằng chữ và gán nhãn trên mẫu.
Tỷ lệ "không biết" = số câu trả lời nói không có thông tin hoặc từ chối, chia cho tổng số câu trả lời của bot. Thấp có thể là bot đoán bừa, cao có thể là thiếu tài liệu hoặc từ chối thừa. Luôn đọc cùng tỷ lệ lỗi sự thật trên mẫu rà (số câu chấm sai chia cho số câu được rà).
Không có ngưỡng chuẩn. Click Star không nêu mức tốt hay xấu vì không có nguồn mở được. Con số mục tiêu trong ví dụ của OpenAI chỉ là minh họa. Hãy lấy mức nền của chính bot trong vài tuần đầu rồi theo dõi chênh lệch theo phiên bản prompt, mô hình và nhóm câu hỏi (khung của Click Star).
Bảng điểm mẫu (khung tham khảo của Click Star)
Mỗi câu chấm đạt hoặc không đạt trên các tiêu chí liên quan; trong phần chấm bằng người, OpenAI khuyên có ngưỡng đạt/không đạt bên cạnh điểm số. Ví dụ minh họa, không phải dữ liệu thật: "Cửa hàng có giao ngoại tỉnh không?", mong đợi trả lời đúng mục chính sách giao hàng và chỉ ra mục đó.
Bảng mỗi lần phát hành gồm phiên bản prompt, mô hình, tài liệu; số câu đạt theo tiêu chí; câu đổi trạng thái; kết quả cổng cứng; quyết định phát hành.
Nhật ký và quyền riêng tư
Anthropic định nghĩa bản ghi hội thoại (transcript) là bản ghi đầy đủ 1 lần chạy, gồm đầu ra và lệnh gọi công cụ. Click Star đề xuất ghi thêm phiên bản prompt, mô hình, tài liệu, đoạn truy xuất và cờ chuyển người để tái hiện lỗi.
Ẩn dữ liệu cá nhân trước khi dùng lại. Số điện thoại, email, địa chỉ, mã đơn cần được che trước khi đưa vào bộ câu hỏi vàng hay gửi cho mô hình chấm, vì theo Click Star, đó là 1 bên xử lý dữ liệu nữa. Click Star đã có bài về đưa AI vào doanh nghiệp an toàn, nêu phân loại dữ liệu và nhật ký. Hãy thử việc che bằng dữ liệu giả.
Quyền riêng tư là 1 tiêu chí cần thử. Anthropic liệt kê bảo vệ quyền riêng tư là tiêu chí, kèm ví dụ dùng mô hình phân loại kiểm đầu ra có lộ thông tin sức khỏe cá nhân không. Click Star áp ý đó: thử xem bot có lộ thông tin khách khác khi bị hỏi khéo không. Chuẩn thời hạn lưu nhật ký AI chưa tìm thấy, và bài không tư vấn pháp lý.
Đánh giá của Click Star. Đánh giá chất lượng là hạng mục của dự án, không phải việc làm thêm sau khi bot đã chạy. Giá trị lớn nhất nằm ở 2 thói quen: đọc hội thoại thật đều đặn và biến mỗi lỗi thành một câu thử mới.
Khung này tự làm được bằng bảng tính, không cần dịch vụ của Click Star.
Việc nên làm trong 30 ngày (khung tham khảo của Click Star)
- Tuần 1: chọn 6 tiêu chí; thu 20 đến 50 câu từ khách thật và lỗi đã biết, ẩn dữ liệu cá nhân; thêm câu khó và câu cần từ chối hoặc chuyển người.
- Tuần 2: gán loại chấm cho từng tiêu chí; cho 2 người chấm độc lập một phần bộ câu hỏi rồi so với mô hình chấm.
- Tuần 3: chạy bộ câu hỏi vàng làm mốc; đổi 1 yếu tố rồi so từng câu đổi trạng thái.
- Tuần 4: bật nhật ký có phiên bản, tính 3 chỉ số vận hành, rà mẫu hội thoại thật, đưa lỗi tìm được vào bộ câu hỏi vàng.
Những sai lầm thường gặp
- Chấm bằng cảm giác sau vài câu demo.
- Bộ câu hỏi chỉ gồm câu dễ do đội làm bot tự nghĩ.
- Quên thử lúc bot phải từ chối hoặc chuyển người.
- Tin điểm của mô hình chấm khi chưa so với nhãn của người.
- Chỉ nhìn điểm trung bình sau khi đổi prompt, mô hình hay tài liệu.
- Ép giảm tỷ lệ chuyển người hoặc "không biết" mà không đọc hội thoại.
- Đưa nhật ký thô chứa dữ liệu cá nhân vào bộ câu hỏi vàng hoặc gửi cho mô hình chấm.
Điều chưa biết
Click Star không tìm thấy số đo độc lập về chất lượng chatbot doanh nghiệp tại Việt Nam, cũng không có ngưỡng chuẩn ngành cho 3 chỉ số vận hành. Click Star chưa đọc được nghiên cứu về độ khớp giữa mô hình chấm và người chấm riêng cho tiếng Việt; thiên lệch về thứ tự và độ dài là điều OpenAI nêu, chưa đo cho tiếng Việt.
Các trang tài liệu của Anthropic (trừ bài kỹ thuật đăng 9/1/2026) và trang OpenAI không ghi ngày đăng. OpenAI thông báo nền tảng Evals chuyển sang chỉ đọc cho người dùng hiện có ngày 31/10/2026 và dự kiến ngừng ngày 30/11/2026, nên hãy coi cách làm trong bài là phương pháp độc lập với công cụ. Chưa có nguồn nào nêu cỡ mẫu rà soát.
Bài liên quan


Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.