Cách sử dụng GPT tối ưu nhất: chọn model, viết prompt, kiểm chứng và dùng API đúng cách
Họ GPT-6 có 3 model cho 3 loại việc. Bài này chỉ cách chọn model, viết prompt theo khuôn năm phần, kiểm chứng kết quả và thiết lập API cho đội kỹ thuật, dựa trên tài liệu chính thức của OpenAI.
GPT không phải một công cụ duy nhất mà là một họ model, mỗi model hợp một loại việc, và cùng một model cho kết quả rất khác nhau tùy cách bạn yêu cầu.
Bài này dành cho 2 nhóm: người dùng ChatGPT hằng ngày và đội kỹ thuật tích hợp qua API. Phần model, tham số và API dựa trên tài liệu chính thức của OpenAI cho họ GPT-6, đối chiếu ngày 19/10/2026. Phần cách viết yêu cầu, kiểm chứng và quy trình là kinh nghiệm của Click Star.
Tên model và tùy chọn thay đổi nhanh, nên hãy mở lại tài liệu trước khi triển khai.
Điểm chính
- Theo tài liệu của OpenAI, họ GPT-6 có 3 model: Astra (trí tuệ cao nhất), 6.1 Sol (cân bằng) và Luna (nhanh nhất, chi phí thấp nhất). Chọn theo từng loại việc, không phải lúc nào cũng chọn model mạnh nhất.
- Prompt tốt mô tả kết quả cần đạt, tiêu chí thành công và ràng buộc, thay vì liệt kê từng bước. Prompt cũ nên được rút gọn thay vì chép sang model mới.
- Mức suy luận (reasoning effort) là núm điều chỉnh giữa chất lượng, độ trễ và chi phí. Chỉ tăng khi bộ kiểm tra của bạn cho thấy kết quả tốt hơn rõ rệt.
- Với API: dùng Responses API, Structured Outputs cho đầu ra cố định, đặt phần dùng lại lên đầu prompt để tận dụng bộ nhớ đệm, ghim phiên bản model và đo bằng bộ kiểm tra riêng.
- Luôn kiểm chứng đầu ra quan trọng, và không đưa dữ liệu nhạy cảm vào khi chưa rà chính sách dữ liệu của dịch vụ.
Chọn đúng model trước khi viết prompt
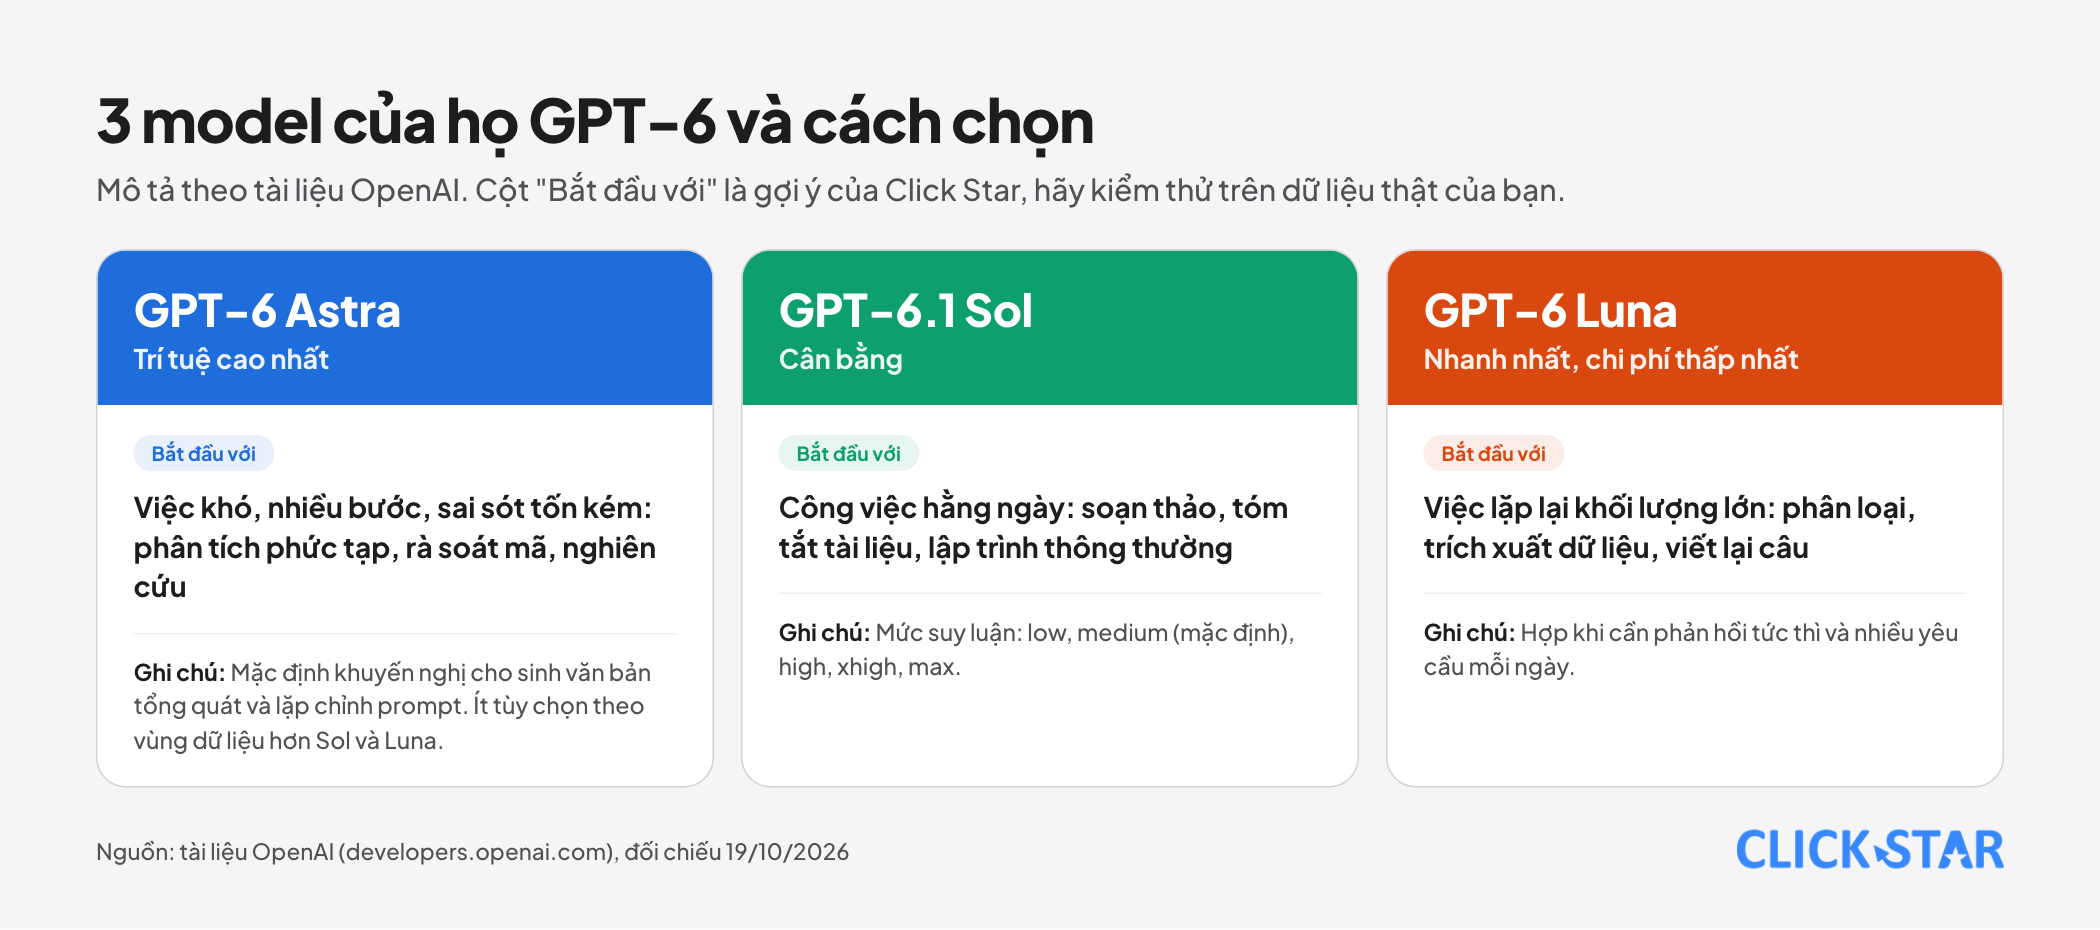
Tài liệu OpenAI mô tả 3 model trong họ GPT-6. GPT-6 Astra là model có trí tuệ cao nhất và là lựa chọn mặc định được khuyến nghị cho sinh văn bản tổng quát và lặp chỉnh prompt. GPT-6.1 Sol cân bằng giữa chất lượng và tốc độ. GPT-6 Luna nhanh nhất và rẻ nhất.
Tài liệu cũng chia chung hơn: model suy luận hợp việc phức tạp nhiều bước và phản hồi tốt với mục tiêu ở mức cao, còn model GPT thường nhanh, tiết kiệm và hưởng lợi từ chỉ dẫn tường minh.
Cách chọn thực dụng của Click Star:
- Việc lặp lại, khối lượng lớn, đơn giản như phân loại, trích xuất trường dữ liệu, viết lại câu: bắt đầu với Luna.
- Công việc hằng ngày cần cân bằng như soạn thảo, tóm tắt tài liệu, lập trình thông thường: Sol là điểm xuất phát hợp lý.
- Việc khó, nhiều bước, sai sót tốn kém như phân tích phức tạp, rà soát mã, nghiên cứu: thử Astra, hoặc Sol ở mức suy luận cao.
Điều quan trọng hơn bảng gợi ý: OpenAI khuyên bạn tự kiểm thử và so sánh các model, ví dụ Astra với Sol, trên chính công việc của mình. Hãy lấy 20 ví dụ thật, chạy trên 2 model, chấm điểm theo cùng một tiêu chí rồi mới quyết định.
Với doanh nghiệp có yêu cầu về nơi lưu trữ dữ liệu, cần lưu ý Astra có ít tùy chọn Fast và Ultrafast theo vùng dữ liệu hơn Sol và Luna, nên kiểm tra điều kiện trước khi triển khai.
Viết prompt theo kết quả cần đạt
Hướng dẫn của OpenAI cho họ model này nhấn mạnh việc nói rõ đích đến và giao quyền chủ động cho model, thay vì điều khiển từng bước. Một vài điểm đáng áp dụng:
- Nêu quyền chủ động: cho model hoàn thành phần việc đã được phép, và chỉ xin phê duyệt sau khi đã chuẩn bị một kết quả cụ thể để bạn xem.
- Nêu thứ tự ưu tiên: chỉ dẫn của người dùng thắng hướng dẫn trong các tệp kỹ năng.
- Nêu định dạng và độ dài, vì model nghiêng về câu trả lời dài và nhiều định dạng nếu bạn không giới hạn.
- Nêu mức kiểm tra cân xứng với thay đổi, tránh chạy toàn bộ bộ kiểm thử cho một sửa đổi nhỏ.
- Rà lại các tệp ngữ cảnh như AGENTS.md hay skill để tìm câu có thể vô tình làm model dừng lại hỏi hoặc đổi hành vi.
Simon Willison, tóm tắt hướng dẫn cho GPT-5.5, mô tả cùng tinh thần: bắt đầu từ prompt nhỏ nhất vẫn giữ được hợp đồng của sản phẩm, rồi mới chỉnh mức suy luận, độ dài, mô tả công cụ và định dạng đầu ra, thay vì mang nguyên bộ chỉ dẫn cũ sang model mới.
Khuôn năm phần
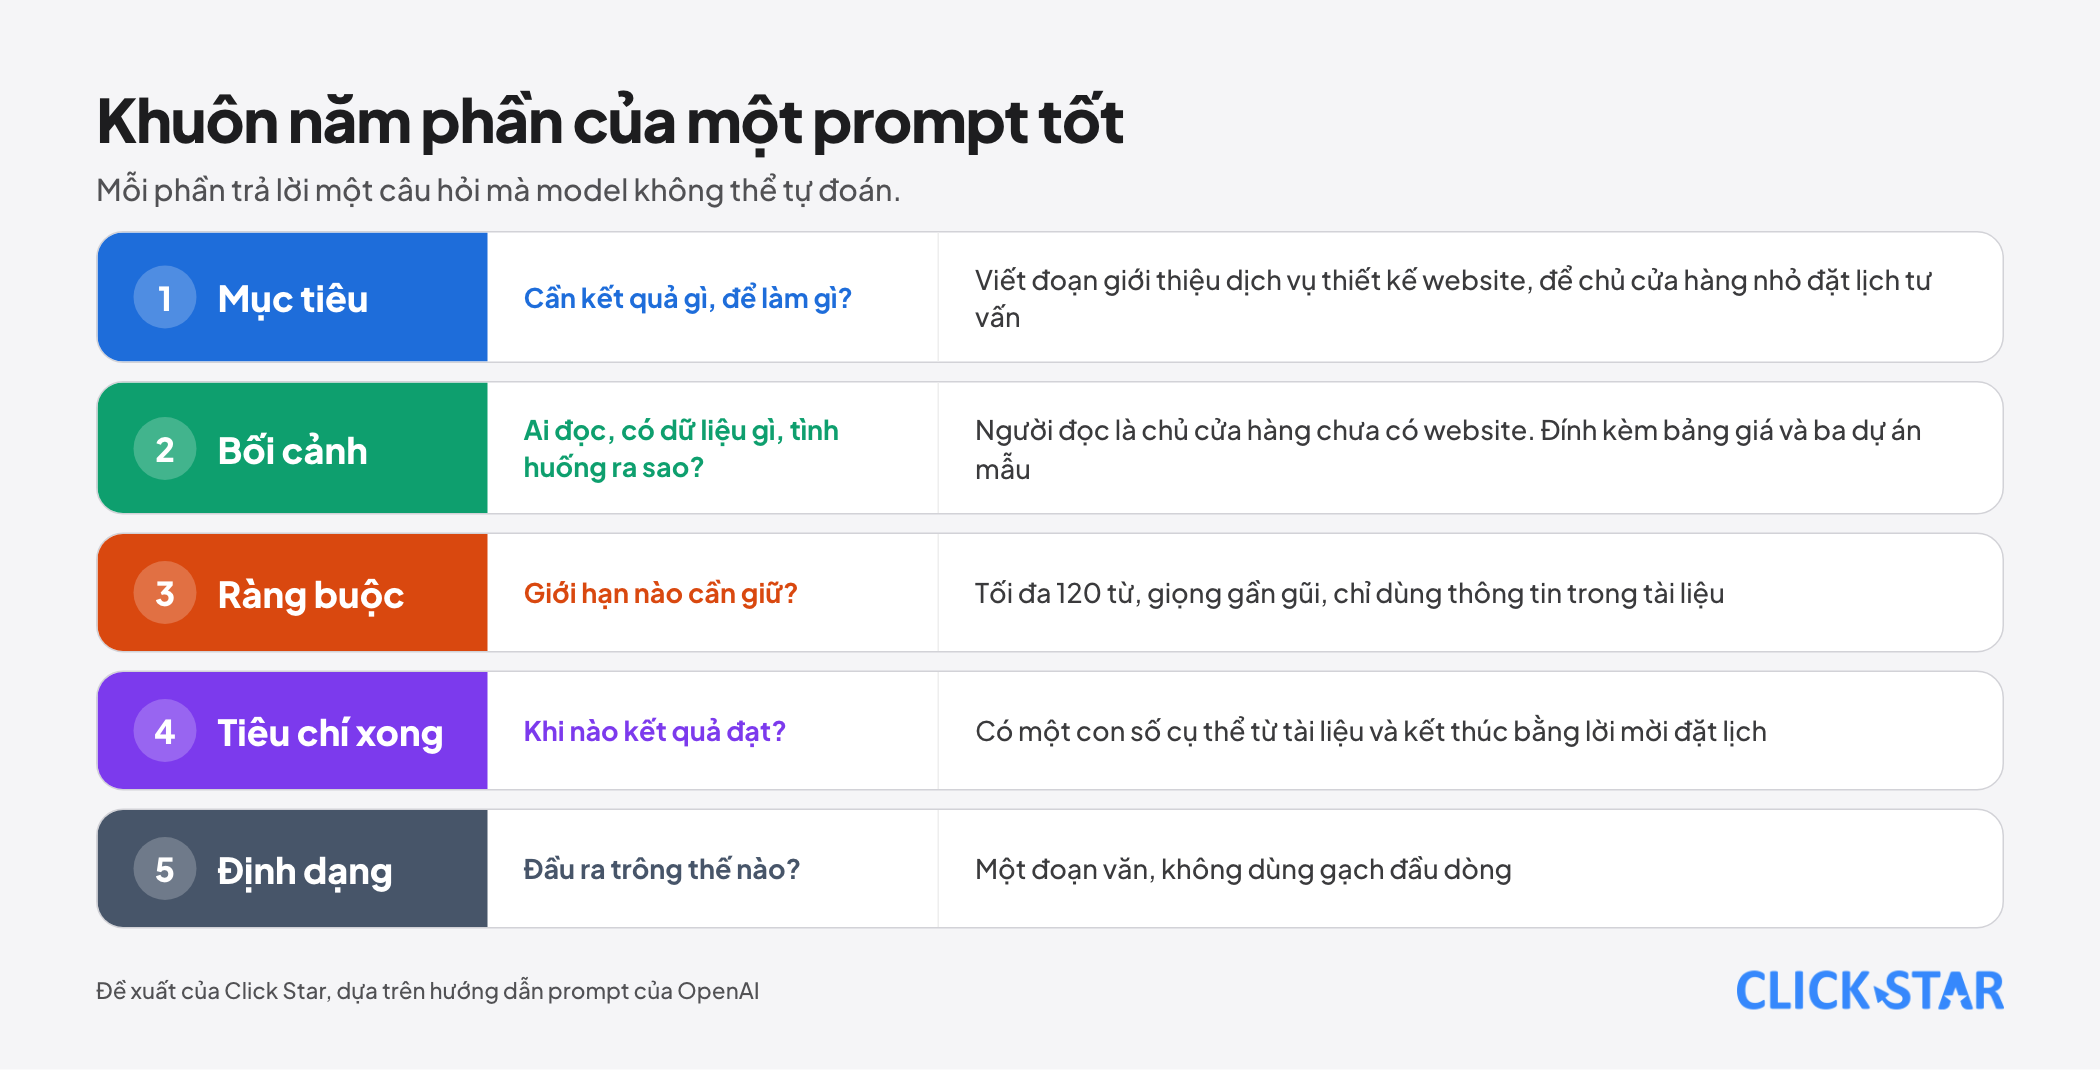
Khuôn dưới đây là cách Click Star dùng cho hầu hết yêu cầu công việc, từ soạn email đến phân tích số liệu:
MỤC TIÊU: Tôi cần [kết quả cụ thể], để [mục đích].
BỐI CẢNH: Người đọc là [ai]. Dữ liệu đính kèm: [mô tả]. Tình huống: [tóm tắt].
RÀNG BUỘC: Tối đa [n] từ. Giọng [lịch sự, trực tiếp]. Không dùng [điều cấm]. Chỉ dùng thông tin trong tài liệu.
TIÊU CHÍ XONG: Kết quả đạt khi [điều kiện kiểm tra được].
ĐỊNH DẠNG: [danh sách 5 ý | email 3 đoạn | bảng JSON theo mẫu].
So sánh 2 cách yêu cầu: "viết cho tôi bài giới thiệu dịch vụ" cho ra một bài chung chung. Còn "Viết đoạn giới thiệu dịch vụ thiết kế website cho chủ cửa hàng nhỏ, tối đa 120 từ, giọng gần gũi, nêu một con số cụ thể từ tài liệu đính kèm và kết thúc bằng một lời mời gọi đặt lịch tư vấn" cho kết quả dùng được ngay và dễ kiểm tra.
Khi cần model bắt chước một mẫu đầu ra, đưa 2 đến 3 ví dụ đầu vào và đầu ra khác nhau (few-shot) thay vì mô tả bằng lời. Với API, OpenAI hướng dẫn đặt các ví dụ này trong tin nhắn của nhà phát triển (developer message).
Mức suy luận, độ dài và các tham số
Theo tài liệu, Sol có các mức suy luận low, medium (mặc định), high, xhigh và max. Astra và 6.1 Sol không hỗ trợ none, nên nếu trước đây bạn dùng none hoặc minimal, hãy bắt đầu bằng low rồi so kết quả. Khi mức suy luận khác none, hãy bỏ các tham số temperature, top_p và top_logprobs, vì chúng không còn áp dụng.
Muốn đổi mức suy luận giữa các lượt trong một cuộc hội thoại, thêm mục configuration_update vào đầu vào và giữ nguyên reasoning.effort ở cấp yêu cầu để không làm mất bộ nhớ đệm prompt.
Quy tắc chung của Click Star: để mức suy luận ở thấp hoặc vừa cho việc hằng ngày, và chỉ nâng khi bộ kiểm tra cho thấy chất lượng cải thiện đủ để bù cho thời gian chờ và chi phí tăng thêm. Mức cao nhất không phải lúc nào cũng cho kết quả tốt hơn, nhưng luôn chậm và đắt hơn.
Ngữ cảnh: đưa đúng thông tin, đúng chỗ
Model chỉ biết điều bạn đưa vào. 3 nguyên tắc:
- Đưa tài liệu thật thay vì mô tả lại: dán nội dung hoặc đính kèm tệp, và nói rõ "chỉ dùng thông tin trong tài liệu này". Bảo model chỉ ra đoạn nào làm căn cứ cho từng kết luận để bạn kiểm tra nhanh.
- Đặt phần ổn định lên trước, phần thay đổi xuống sau. OpenAI khuyên đặt nội dung dùng lại ở đầu prompt để giảm chi phí và độ trễ nhờ bộ nhớ đệm.
- Đừng nhồi mọi thứ vào. Ngữ cảnh dài không thay cho ngữ cảnh đúng: chọn các đoạn liên quan nhất, ghi nhãn rõ từng nguồn.
Kiểm chứng: vòng lặp 4 bước
Đầu ra trôi chảy không có nghĩa là đúng. Quy trình Click Star dùng cho công việc có hậu quả:
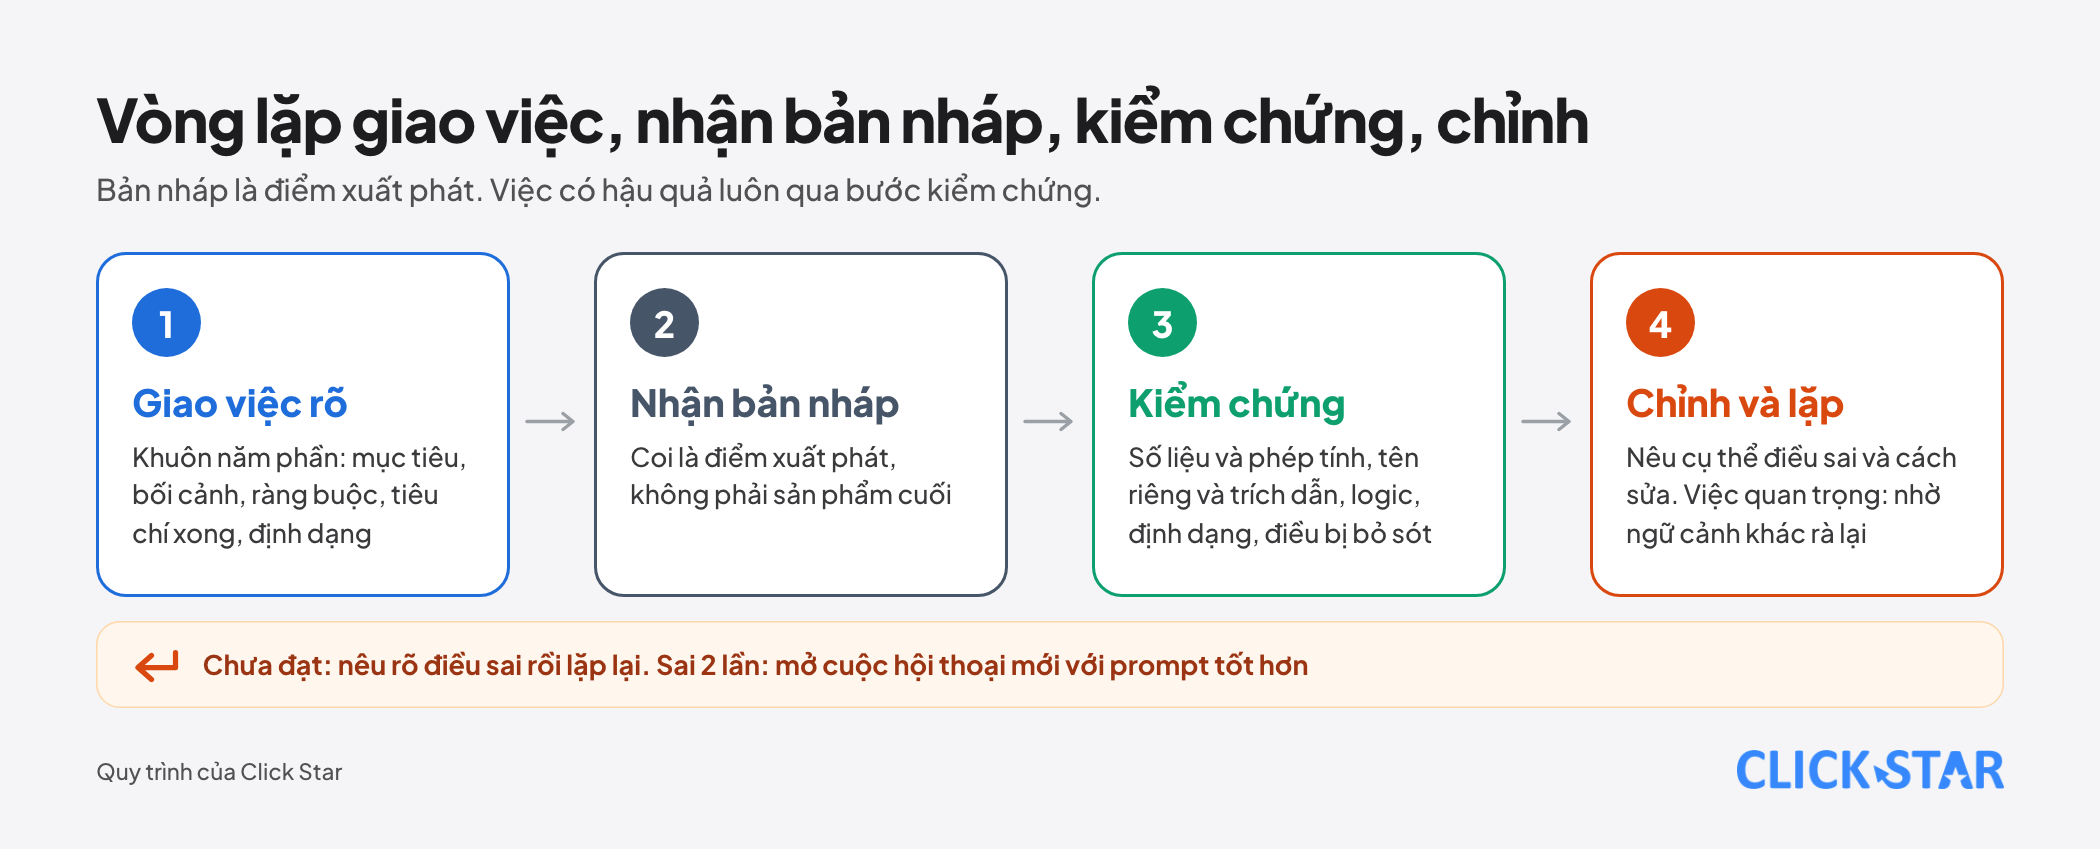
- Giao việc rõ, bằng khuôn năm phần ở trên.
- Nhận bản nháp và coi đó là điểm xuất phát, không phải sản phẩm cuối.
- Kiểm chứng: số liệu và phép tính (dùng công cụ tính, đừng tin phép tính nhẩm), tên riêng và trích dẫn (tra lại nguồn), logic, định dạng, và các điều bị bỏ sót. Có thể bảo model liệt kê giả định và chỗ nó không chắc.
- Chỉnh và lặp: nêu cụ thể điều sai và cách sửa. Nếu đã sửa 2 lần mà vẫn lệch, mở cuộc hội thoại mới với prompt tốt hơn thay vì cố sửa tiếp trên một ngữ cảnh đã lộn xộn.
Với kết quả quan trọng, nhờ một model khác hoặc một người khác đọc lại: người viết và người rà soát nên là 2 ngữ cảnh riêng.
Dùng qua API: những thiết lập đáng làm ngay
Đội kỹ thuật có thể áp dụng ngay danh sách sau, tất cả lấy từ tài liệu hiện hành:
- Dùng Responses API. Theo tài liệu, Astra và 6.1 Sol yêu cầu API này khi gọi công cụ.
- Tách vai trò tin nhắn: tin nhắn của nhà phát triển đặt quy tắc và logic nghiệp vụ, tin nhắn của người dùng chứa dữ liệu đầu vào. Tham số
instructionschỉ áp dụng cho chính yêu cầu đó và không được mang sang khi bạn nối lượt bằngprevious_response_id. - Dùng Structured Outputs khi cần đầu ra cố định: ràng buộc phản hồi theo một JSON schema để máy đọc được.
- Tận dụng bộ nhớ đệm prompt: đặt nội dung dùng lại ở đầu. Nếu chuyển từ GPT-5.5 trở về trước, thay
prompt_cache_retentionbằngprompt_cache_options.ttlđặt"30m". - Ghim phiên bản (snapshot) model trong sản phẩm chạy thật để hành vi không đổi bất ngờ khi nâng cấp.
- Xây bộ kiểm tra (evals) trước và sau mỗi lần đổi prompt hoặc model.
- Lưu prompt trong mã nguồn. OpenAI đang bỏ dần đối tượng prompt dùng lại: việc tạo prompt kiểu này bị giảm ưu tiên từ 3/6/2026 và
v1/promptsngừng hoạt động vào 30/11/2026. Nếu bạn đang dùng, hãy chuyển prompt vào mã nguồn, có kiểu dữ liệu cho đầu vào, qua rà soát mã và triển khai như mọi thay đổi khác.
Ví dụ gọi tối giản bằng SDK JavaScript:
import OpenAI from 'openai'
const client = new OpenAI()

const response = await client.responses.create({
  model: 'gpt-6-astra',          // đổi sang Sol hoặc Luna cho việc nhẹ hơn
  reasoning: { effort: 'low' },  // tăng khi bộ kiểm tra cho thấy đáng
  instructions:
    'Bạn là trợ lý chăm sóc khách hàng của cửa hàng. Trả lời tối đa 120 từ, giọng lịch sự, chỉ dùng thông tin trong tài liệu được cung cấp.',
  input: 'Khách hỏi: cửa hàng có giao hàng ngoài tỉnh không?',
})

console.log(response.output_text)
Tên model và tên trường có thể đổi theo phiên bản SDK, hãy đối chiếu tài liệu của OpenAI khi chạy thật.
Dùng trong doanh nghiệp: dữ liệu và quy trình
- Phân mức dữ liệu trước khi dùng: công khai, nội bộ, nhạy cảm. Dữ liệu nhạy cảm như hồ sơ khách hàng, hợp đồng, thông tin y tế hoặc tài chính cá nhân không nên đưa vào nếu chưa rà điều khoản lưu trữ và sử dụng dữ liệu của dịch vụ.
- Với dữ liệu cá nhân của người Việt, cần đối chiếu Luật Bảo vệ dữ liệu cá nhân (Luật số 91/2025/QH15, hiệu lực từ 1/1/2026) và các nghị định hướng dẫn.
- Nội dung gửi ra ngoài cho khách hàng nên có người duyệt trước khi gửi.
- Ghi lại prompt và phiên bản model đã dùng cho các quy trình lặp lại, để tái hiện và gỡ lỗi khi kết quả đổi.
- Đặt ngân sách theo tháng và theo dõi chi phí theo từng quy trình, không chỉ theo tổng.
7 sai lầm thường gặp
- Chép nguyên prompt dài của model cũ sang model mới, kể cả các quy tắc mâu thuẫn hoặc lặp ý.
- Chọn model mạnh nhất cho mọi việc, rồi phàn nàn về chi phí và tốc độ.
- Không nêu tiêu chí hoàn thành, nên không ai biết khi nào kết quả đạt.
- Tin kết quả vì nó nghe hợp lý, không kiểm số liệu và nguồn.
- Giữ
temperaturevàtop_pkhi đã bật suy luận, hoặc dùng mức suy luận cũ không còn được hỗ trợ. - Để prompt chỉ nằm trong bảng điều khiển, không có lịch sử thay đổi và không qua rà soát.
- Không có bộ kiểm tra, nên mỗi lần đổi prompt hay model đều là cược.
Kế hoạch 7 ngày để dùng tốt hơn
- Ngày 1: liệt kê năm việc bạn dùng GPT nhiều nhất và gán dữ liệu của từng việc vào một mức phân loại.
- Ngày 2: viết lại một prompt thật theo khuôn năm phần, so với bản cũ.
- Ngày 3: chọn 20 ví dụ thật, chạy trên 2 model, chấm điểm theo cùng tiêu chí.
- Ngày 4: thử hạ mức suy luận một bậc và ghi lại chất lượng, thời gian, chi phí.
- Ngày 5: thêm bước kiểm chứng và danh sách kiểm tra cho việc quan trọng nhất.
- Ngày 6: nếu dùng API, chuyển prompt vào mã nguồn, ghim phiên bản và thêm bộ kiểm tra.
- Ngày 7: ghi lại điều đã học thành một trang quy ước chung cho đội.
Bài liên quan


Cần tư vấn cụ thể cho doanh nghiệp?
Click Star giúp anh/chị xây dựng giải pháp phù hợp ngành nghề và quy mô. Trả lời mọi câu hỏi trong giờ làm việc.